跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. 造孽啊!————大家看看我的硬件配置,至于如此token水平吗?

造孽啊!————大家看看我的硬件配置,至于如此token水平吗?

已定时 已固定 已锁定 已移动 热议 AI硬件
x99intelqwen-27b
33 帖子 15 发布者 389 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 田中火田 田中火

    image.jpeg

    本机配置:
    1:华南金牌电子垃圾(X99 T8)主板(这个主板确实垃圾,内存极为挑剔,客服技术维修欺诈,黑屏送检过一次,说我cpu坏了,主板电容坏了,不修了,还要收我60大洋,回来后重插cpu,嘿,亮了,后来知道是数据线问题,可见其企业之盗欺)。

    2:金士顿洋垃圾骇客金条8x4 32g

    3:cpu是 E5 2676洋垃圾。

    4:intel A770 16G 显卡

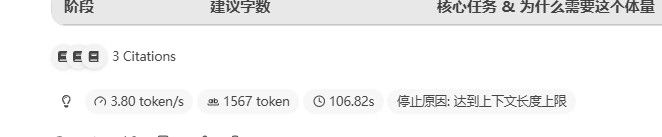
    跑qwen 3.6 27b,就是这个速度,速度慢不说,上下文长度就两轮对话,各位大佬请教这个配置下,怎么选模型,怎么调优。

    XXXX
    XXXX
    XXX
    体面乡绅
    编写于 最后由 XXX 编辑
    #10

    @田中火
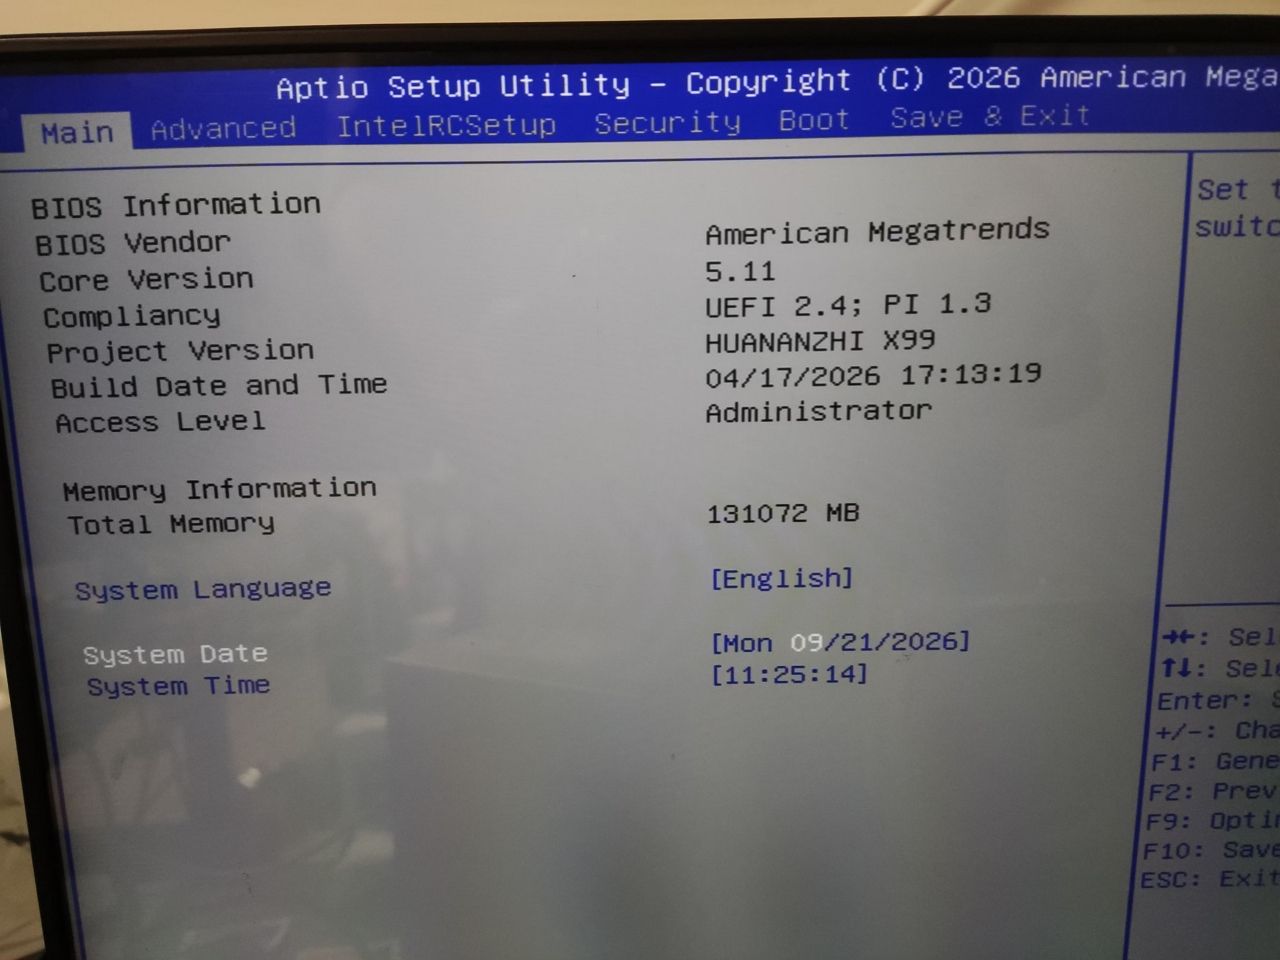
    我的T8 給你參考. 早些拍的128G. 現在是256G
    IMG_20260921_192515.jpg
    IMG_20261001_155110.jpg

    1 条回复 最后回复
    0
    • E
      E
      exllm
      体面乡绅 硕果累累
      编写于 最后由 exllm 编辑
      #11

      这个速度很像cpu解码,看看GPU有没有工作

      田中火田 1 条回复 最后回复
      0
      • H happy

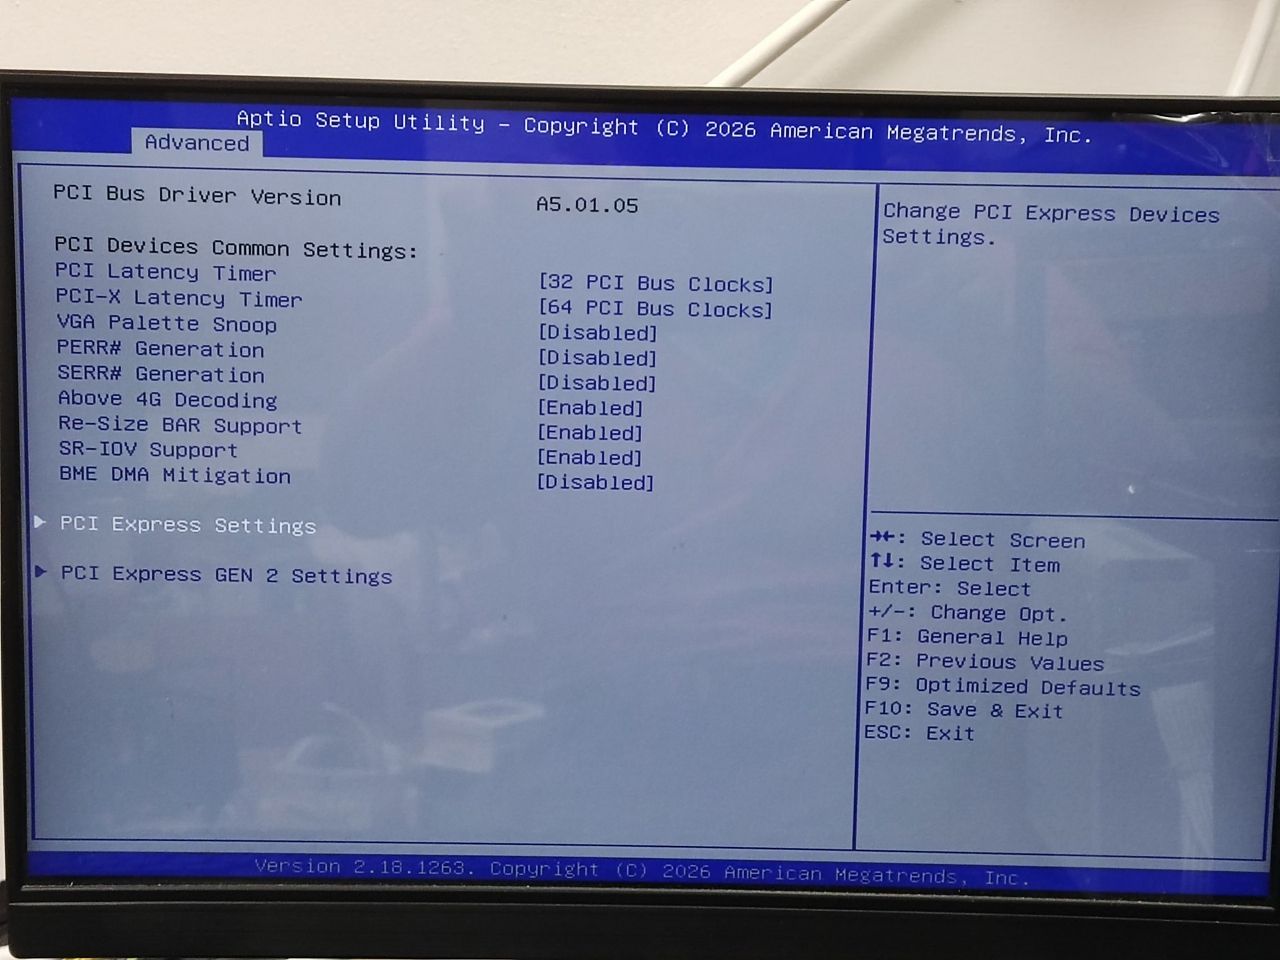
        未启用Resizable BAR导致的吧?

        田中火田
        田中火田
        田中火
        已封禁
        编写于 最后由 编辑
        #12

        @happy 开不了,厂家bios也不升级这个,

        1 条回复 最后回复
        0
        • E exllm

          这个速度很像cpu解码,看看GPU有没有工作

          田中火田
          田中火田
          田中火
          已封禁
          编写于 最后由 编辑
          #13

          @exllm 不是,intel驱动监控显示基本都是80%gpu以上在跑,cpu10左右

          @XXX 厉害的!请教主板的bios BAR能开不?能开的话,怎么开的?

          E XXXX 2 条回复 最后回复
          0
          • 田中火田 田中火

            @exllm 不是,intel驱动监控显示基本都是80%gpu以上在跑,cpu10左右

            @XXX 厉害的!请教主板的bios BAR能开不?能开的话,怎么开的?

            E
            E
            exllm
            体面乡绅 硕果累累
            编写于 最后由 编辑
            #14

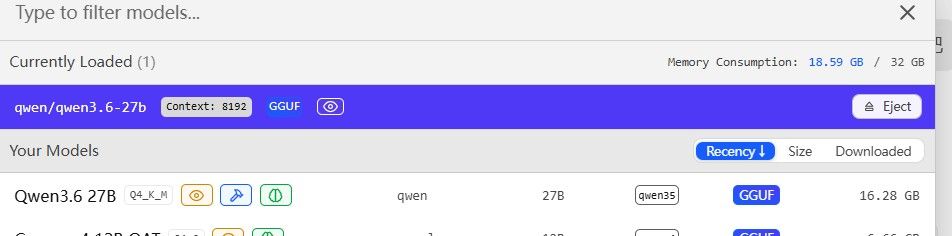
            @田中火 什么引擎?看看日志

            田中火田 1 条回复 最后回复
            0
            • E exllm

              @田中火 什么引擎?看看日志

              田中火田
              田中火田
              田中火
              已封禁
              编写于 最后由 编辑
              #15

              @exllm qwen3.6 27b
              image.jpeg

              E 1 条回复 最后回复
              0
              • 田中火田 田中火

                @exllm qwen3.6 27b
                image.jpeg

                E
                E
                exllm
                体面乡绅 硕果累累
                编写于 最后由 编辑
                #16

                @田中火 这是LM Studio吗?

                田中火田 1 条回复 最后回复
                0
                • terryT
                  terryT
                  terry
                  易有太极
                  编写于 最后由 terry 编辑
                  #17

                  我觉得你的理解能里可能有问题,你两年前就想到了这个配置,这配置都特么出来十几年了。华南金牌是寨板厂,我要你公布的是你和他们客服的沟通记录证明他们是傻逼,欺负你。不然你在这里投诉别人服务不好,就是你有问题。你到现在给出了证据吗?

                  我们在这里谈的是跑AI,你32G DDR3能跑AI?加上A770跑Qwen27B??你要是不懂就虚心提问,你如果买了一辆奥拓说高速开140飘,那是你的问题还是厂家的问题?

                  你是否带节奏我也不关心,你要遵守论坛的规矩,你投诉商家不道德,要贴证据。

                  油管:https://www.youtube.com/@抡锤者

                  田中火田 1 条回复 最后回复
                  0
                  • 田中火田 田中火

                    @exllm 不是,intel驱动监控显示基本都是80%gpu以上在跑,cpu10左右

                    @XXX 厉害的!请教主板的bios BAR能开不?能开的话,怎么开的?

                    XXXX
                    XXXX
                    XXX
                    体面乡绅
                    编写于 最后由 编辑
                    #18

                    @田中火
                    我買來時就可以開, 可能我是最近才買的關係.

                    田中火田 1 条回复 最后回复
                    0
                    • E exllm

                      @田中火 这是LM Studio吗?

                      田中火田
                      田中火田
                      田中火
                      已封禁
                      编写于 最后由 编辑
                      #19

                      @exllm 哈哈,是的

                      1 条回复 最后回复
                      0
                      • 田中火田 田中火

                        image.jpeg

                        本机配置:
                        1:华南金牌电子垃圾(X99 T8)主板(这个主板确实垃圾,内存极为挑剔,客服技术维修欺诈,黑屏送检过一次,说我cpu坏了,主板电容坏了,不修了,还要收我60大洋,回来后重插cpu,嘿,亮了,后来知道是数据线问题,可见其企业之盗欺)。

                        2:金士顿洋垃圾骇客金条8x4 32g

                        3:cpu是 E5 2676洋垃圾。

                        4:intel A770 16G 显卡

                        跑qwen 3.6 27b,就是这个速度,速度慢不说,上下文长度就两轮对话,各位大佬请教这个配置下,怎么选模型,怎么调优。

                        fanweng-codeF
                        fanweng-codeF
                        fanweng-code
                        体面乡绅
                        编写于 最后由 编辑
                        #20

                        @田中火
                        用什麼量化格式?
                        你乾脆把log都丟給線上模型診斷可能還比較快

                        1 条回复 最后回复
                        0
                        • XXXX XXX

                          @田中火
                          我買來時就可以開, 可能我是最近才買的關係.

                          田中火田
                          田中火田
                          田中火
                          已封禁
                          编写于 最后由 编辑
                          #21

                          @XXX 兄弟,能分享一个bios不,不过,我估计你的主板支持DDR4的,这个板子是支持开启bar的

                          XXXX 1 条回复 最后回复
                          0
                          • lesslin xiuL
                            lesslin xiuL
                            lesslin xiu
                            编写于 最后由 编辑
                            #22

                            如果纯玩,个人觉得折腾洋垃圾没啥必要,浪费时间,浪费金钱。有那个钱不如购买在线api服务或者云卡。如果要是生产力,那就要上主流新的,都是生产资料了,还剩那一点。

                            田中火田 1 条回复 最后回复
                            0
                            • 田中火田 田中火

                              @XXX 兄弟,能分享一个bios不,不过,我估计你的主板支持DDR4的,这个板子是支持开启bar的

                              XXXX
                              XXXX
                              XXX
                              体面乡绅
                              编写于 最后由 编辑
                              #23

                              @田中火
                              BIOS不知道怎麼分享, DDR4不知道, 版上只裝DDR3.
                              版上好像有人說過, 早期和現在的主板硬件有些不同.

                              1 条回复 最后回复
                              0
                              • lesslin xiuL lesslin xiu

                                如果纯玩,个人觉得折腾洋垃圾没啥必要,浪费时间,浪费金钱。有那个钱不如购买在线api服务或者云卡。如果要是生产力,那就要上主流新的,都是生产资料了,还剩那一点。

                                田中火田
                                田中火田
                                田中火
                                已封禁
                                编写于 最后由 编辑
                                #24

                                @lesslin-xiu 好吧,我也不想再投入这套系统了,太消耗精力了

                                1 条回复 最后回复
                                0
                                • terryT terry

                                  我觉得你的理解能里可能有问题,你两年前就想到了这个配置,这配置都特么出来十几年了。华南金牌是寨板厂,我要你公布的是你和他们客服的沟通记录证明他们是傻逼,欺负你。不然你在这里投诉别人服务不好,就是你有问题。你到现在给出了证据吗?

                                  我们在这里谈的是跑AI,你32G DDR3能跑AI?加上A770跑Qwen27B??你要是不懂就虚心提问,你如果买了一辆奥拓说高速开140飘,那是你的问题还是厂家的问题?

                                  你是否带节奏我也不关心,你要遵守论坛的规矩,你投诉商家不道德,要贴证据。

                                  田中火田
                                  田中火田
                                  田中火
                                  已封禁
                                  编写于 最后由 编辑
                                  #25

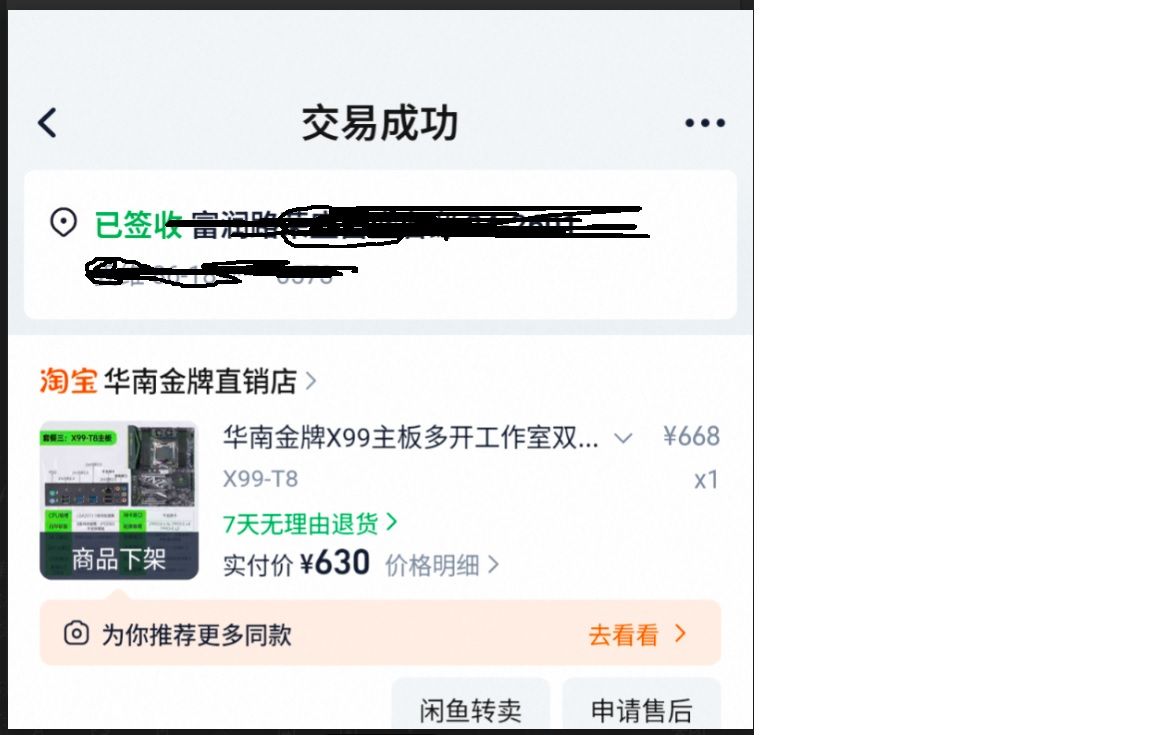
                                  @terry 是你理解能力有问题吧,你不看别人那帖子吧,脑子想的和看的都不是一路的,我特么说的是A770,为了这个显卡找了这堆破烂配置,你平日里都是这么跟人沟通显摆个性的吗?他们是不是傻逼,我的经历已经证明了,刚看了淘宝购物![123123.jpg]这家淘宝店都消失了,这家店推给厂家,然后跟厂家沟通,大概是微信还是什么我忘了,谁特么记这些破事? 这样吧,看你一天天牛逼哄哄,我来发誓,我说谎话死全家。不说谎,你和华南金牌一生穷困潦倒疾病产生,不死,可以不,够意思不!你特么是代言了还是咋了,写代码写傻了?跟特么人类沟通这么费劲?(https://upload.lcz.me/uploads/2e0e3041-2653-4093-b0eb-46d33ce5430c.jpg)

                                  1 条回复 最后回复
                                  0
                                  • imbiplaza ASUSI
                                    imbiplaza ASUSI
                                    imbiplaza ASUS
                                    谪仙人
                                    编写于 最后由 imbiplaza ASUS 编辑
                                    #26

                                    厉害,买错intel 还来挑战老特,老特已经告诉你们千交代万交代别买intel....不听!
                                    才为了几百rmb就黑x99, 人家是多少十年的平台了,旧平台肯定有这种兼容性的问题,还去怪人家不update bios.....

                                    1 条回复 最后回复
                                    0
                                    • XiaoteX
                                      XiaoteX
                                      Xiaote
                                      编写于 最后由 编辑
                                      #27

                                      🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                                      奖励凭证:热议 +3 分 · 编号 h2522-1696-1(系统自动发放,显示稍有延迟)

                                      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                                      1 条回复 最后回复
                                      0
                                      • BunseiB
                                        BunseiB
                                        Bunsei
                                        贵族大夫 硕果累累
                                        编写于 最后由 编辑
                                        #28

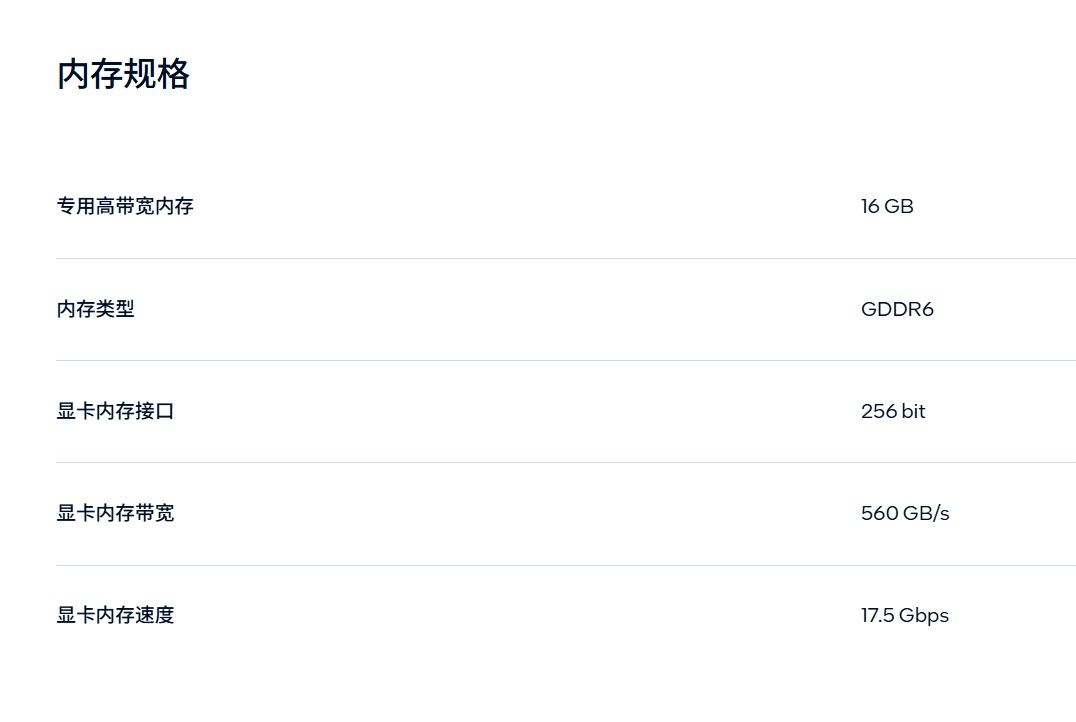
                                        我查了一下你这个卡,560的显卡带宽理论上限是20Token/s,但Qwen 27B,不知道你的量化等级,我就算你是IQ3、算上KV缓存、而且我看你系统显示输出也接到了独立显卡上。多半是发生了cpu-offload。 这个速度正常。另外还一种可能是就是lmstudio它用cpu跑的,建议推理的时候打开任务管理器看看GPU那里的占用。

                                        image.jpeg

                                        1 条回复 最后回复
                                        0
                                        • stxpnetS
                                          stxpnetS
                                          stxpnet
                                          王侯将相
                                          编写于 最后由 编辑
                                          #29

                                          就一张图,也不知道说啥好。 系统,框架,模型,一个字都不清楚。
                                          我用有限的信息,让GLM 5.3 FLASH调研出来的结果:

                                          # 华南X99 T8 + E5-2676 v3 + 32G + A770 16G 本地LLM选型调研报告
                                          
                                          > 调研日期:2026-10-23 | 方法:CBS 多查询调研(Google 4 组 + Reddit/DDG 2 组 + 深挖 3 页)
                                          > 参数:标准版(每主题 3-4 查询 × 15-20 条,80% 相关阈值)
                                          
                                          ## 一、硬件现状判定
                                          
                                          | 部件 | 型号 | 对 LLM 的实际意义 |
                                          |---|---|---|
                                          | GPU | Intel Arc A770 16GB (Xe-HPG/DG2, XMX) | 16GB 显存=最大资产;实测有效读带宽 ~374 GB/s(理论 560);llama.cpp SYCL 官方认证卡 |
                                          | CPU | E5-2676 v3 (12C/24T Haswell-EP) | AVX2 有、AVX-512 有但慢;给 MoE 专家 offload 和 draft 模型打下手 |
                                          | 内存 | 4×8G DDR4 | 四通道 ~68 GB/s 理论 / ~44 GB/s 实际;32G 装 27B 的 CPU 侧很紧,MoE 大模型装不下 |
                                          | 主板 | 华南 X99 T8 | 无 REBAR 支持,Arc 在无 REBAR 平台有 5-15% 额外损失(缓解补丁存在);Gen3 x16 |
                                          
                                          **关键事实:这套平台的价值 90% 在那张 A770 上,CPU 和主板只配当配角。**
                                          一切"上大模型"的方案(30B+ 稠密、百亿级 MoE 全量)都会被内存带宽和显存双重卡死,电力->智力转换率极差。
                                          
                                          ## 二、三个推荐方案对比
                                          
                                          | 维度 | 方案 A(首推)⚡ | 方案 B(求稳) | 方案 C(求大)⚠️ |
                                          |---|---|---|---|
                                          | **框架** | llama.cpp SYCL + **MTP 推测解码**(ef777/a770-qwen-xe1 调优分支) | llama.cpp SYCL 原版或 Ollama(Vulkan) | llama.cpp SYCL `--n-cpu-moe` 专家分层 + GPU 草稿 |
                                          | **模型** | **Qwen3.8-27B Q3_K_S**(~11.7GB)或 UD-Q3_K_XL | **Qwen3.6-14B / Qwen3-8B Q4_K_M** | **Qwen3.6-35B-A3B (MoE) Q4**,专家放内存 |
                                          | **实测速度** | 41-50 t/s decode @16-24K ctx(A770 同卡实测),prefill 600+ t/s | 14B Q4 约 25-30 t/s(带宽上限 39 t/s) | 15-25 t/s(GPU 侧快、CPU 侧专家 ~20-30 t/s 混合后取低值) |
                                          | **显存占用** | 12GB 权重 + 3GB KV(q8_0) ≈ 15GB,贴满 | ~11GB / 16GB,留足余量 | 专家 ~20GB 在内存,GPU 只放共享权重+KV |
                                          | **上下文** | 16-24K(q8_0 KV);32G 内存是硬上限 | 8-16K 从容 | 长上下文会挤压内存,26K 以内 |
                                          | **整机功耗** | ~270W | ~255W | ~340W(CPU 常驻高载) |
                                          | **电力->智力** | **0.16 t/s/W(冠军)**,1M token ≈ 1.7 kWh ≈ 0.95元 | 0.12 t/s/W,1M token ≈ 2.4 kWh | 0.05 t/s/W,1M token ≈ 5.2 kWh(垫底) |
                                          | **部署难度** | 中:需 oneAPI 2026.1 自编译 + 打补丁 | 低:官方 SYCL 预编译包即用 | 中高:offload 参数需反复调 |
                                          | **理由** | 智力上限和能效双冠军。MTP 推测解码让 27B 智力模型的 decode 提速 2.5 倍,是这张卡社区公认的"最优解",且你正好有 32G 内存喂 draft | 生态最省心,质量稳定,留升级余量;但 14B 智力天花板明显低于 27B | 看着"35B 最大",实际被 DDR4-2133 带宽锁死,每瓦产出只有方案 A 的 1/3——**这是电力->智力视角下的反面教材** |
                                          
                                          ## 三、为什么这么排(证据链)
                                          
                                          1. **A770 的 decode 是纯带宽游戏**:ef777 实测 374 GB/s 有效读带宽,27B Q3(11.7GB)不投机时 ~20 t/s 是物理天花板;开 MTP 3-draft 后 verify 步 4 token 近似 1 token 成本 → 40-50 t/s。这不是玄学,是拿内核级 SYCL/ESIMD 补丁换来的(IQ4/IQ3 K-quant matvec + FA decode 内核,perplexity 不变)。
                                          2. **框架排序(A770 上)**:llama.cpp SYCL ≫ Ollama(Vulkan) ≈ 裸 Vulkan > IPEX-LLM(PyTorch)。vLLM XPU 只对 Arc Pro B 系列(Xe2)成熟,A770 不建议。AWQ/GPTQ/EXL2 全部排除(CUDA-only 或不成熟)。
                                          3. **MoE 全放 GPU 不行**:A770 上 MoE 模型因 ~2500 次/token 内核发射反而只有 14 t/s(llama.cpp SYCL 调度瓶颈),27B 稠密+MTP 反而更快——这正是方案 A 压倒"MoE 大杯"的实测依据。
                                          4. **CPU 只配干两件事**:给 MTP 当 draft 宿主、给 A3B 级 MoE 当专家仓库。DDR4-2133 四通道 44 GB/s 实际带宽决定了 CPU 侧任何角色都在拖后腿,所以方案 C 只能是"能跑"而不是"推荐"。
                                          5. **X99 T8 平台适配注意**:
                                             - 无 REBAR:装 Intel 最新版驱动(26.x),并留意社区 no-rebar 缓解补丁,损失可压到 ~5%;
                                             - Linux 建议 `xe` 内核驱动(`xe.force_probe=56a0`)+ level-zero 26.35+,比 i915 明显快(Reddit/博客共识);
                                             - 主板 PCIex16 是 Gen3:双 A770 tensor split 实测损失可控(zhaoyshine 双 A770 平台 PCIe 3.0 x8 下 tensor split 19.3 vs layer 15.7 t/s),但单卡方案不受影响;
                                             - 32G 内存上限意味着 Q3 27B + draft + 系统占用后所剩无几,**别再上 30B 以上量化模型**。
                                          
                                          ## 四、落地命令锚点(方案 A)
                                          
                                          ```bash
                                          # 编译(oneAPI 2026.1)
                                          source /opt/intel/oneapi/setvars.sh
                                          cmake -B build -DGGML_SYCL=ON -DCMAKE_C_COMPILER=icx -DCMAKE_CXX_COMPILER=icpx -DGGML_SYCL_F16=ON
                                          
                                          # 服务(q8_0 KV + FA + MTP)
                                          ONEAPI_DEVICE_SELECTOR="level_zero:0" ./llama-server \
                                            -m Qwen3.8-27B-Q3_K_S.gguf -ngl 999 -fa on \
                                            -ctk q8_0 -ctv q8_0 -c 16384 -b 2048 -ub 768 \
                                            --model-draft mtp-Qwen3.8-27B-Q4_0.gguf --spec-draft-n-max 3
                                          

                                          进一步提速可套 ef777 的 Xe-HPG 专用内核补丁(GitHub: ef777/a770-qwen-xe1,2026-10-11 更新)。

                                          五、信源

                                          • ef777/a770-qwen-xe1 — A770 16G + Qwen3.8-27B Q3_K_S/UD-Q3_K_XL + MTP 全套实测(本次核心依据,同卡同模型)
                                          • zhaoyshine/dual-intel-arc-a770-llm-bench — 双 A770 SYCL/Vulkan/MTP 基准(2026-10-22 更新)
                                          • quantized.uk Intel Arc cookbook — 框架路线对比与兼容性矩阵
                                          • r/LocalLLaMA A770 MoE 内核发射瓶颈帖 + PSA 推测解码提速帖
                                          • Reddit "Xeon DDR4 CPU inference" — DDR4 带宽→t/s 换算与 65% 效率经验值

                                          结论一句话

                                          这张 A770 的"电力->智力"最优解只有一个:别贪大,用 llama.cpp SYCL + MTP 把 Qwen3.8-27B Q3_K_S 压到 16GB 里跑出 40+ t/s。 35B MoE 大杯方案能跑但每瓦智力产出只有它的 1/3,纯属电力浪费;14B 稳方案留给不想折腾的时候。

                                          双卡3090 PCIE 4.0 16X/16X

                                          白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                          夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组