
【折騰紀錄】AM5 + RTX 3080 打造 PVE 全能神機:Win11 遊戲直通 + 飛牛OS 整合 4 盤位舊 NAS + AI 助攻排錯記錄
-
我一直不太理解NAS的点到底在哪里,就是为什么那么多人愿意折腾这玩意,它到底有什么意义?备份?
-
-
-
-
-
一直在看版主的影片,為自己公司開發了一套POS+處方。想在自己的伺服器做一些數據庫的長期工作,所以組了這台PC。
升級了 AM5 平台的電腦(Ryzen 9 7900X + 64GB DDR5 + RTX 3080)後,一直希望能達成「一套硬體,同時搞定 3D 遊戲、舊 NAS 磁碟整合與本地 AI 推理」的終極目標。最終我選擇了 Proxmox VE (PVE) 虛擬化平台。經過一番折騰,成功實現了 Win11 VM 獨佔 RTX 3080 爽玩 3D 大作,同時掛載 飛牛OS (fnOS) 直通 4 顆大容量 HDD 整合舊 NAS,背景還能跑 Ubuntu VM 進行QWEN 3.8 27b 大模型推理!
這篇文章將完整紀錄這套架構的組態、AI 排錯心得,以及最關鍵的「PCIe 顯卡直通與硬碟整合指南」。
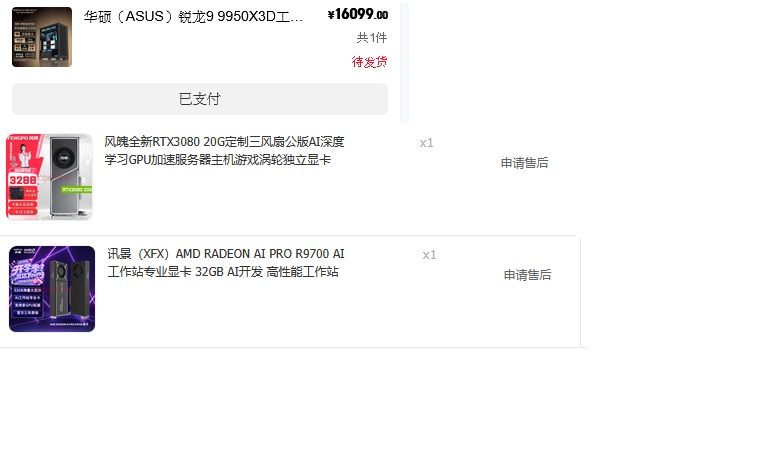
一、 硬體配置與虛擬化架構CPU:AMD Ryzen 9 7900X (AM5 平台) RAM:64GB DDR5 (32gX2 ) GPU:NVIDIA GeForce RTX 3080 20GB 京東魔改卡! Storage:系統 NVMe SSD + 4 顆大容量 3.5 吋 HDD(來自舊 NAS 汰換與整合) Host OS:Proxmox VE 8.x虛擬機架構劃分:
VM 101 (Windows 11):直通 RTX 3080,專門用於玩《絕地潛兵 2 (Helldivers 2)》等 3D 遊戲與日常娛樂。

VM 102 (飛牛OS / fnOS):直通 4 顆 HDD,作為全家人的多媒體影音中心與資料儲存庫,完美接管並集中管理舊 NAS 的所有硬碟。

VM 100 (Ubuntu):作為 AI 與自動化服務節點,部署 Qwen2.5-27B 大語言模型 (搭配 SGLang + HiCache)。
二、 AI 助攻!PVE 架構與複雜設定的「神隊友」
在搭建這套系統的過程中,遇到了無數傳統 論壇/Google 搜尋很難一眼找到答案的邊角料問題(例如 PCIe Reset Bug、ZFS ARC 記憶體爭搶、虛擬化中斷號衝突等)。
這次最大的不同,是全程導入 AI 進行協同排錯與指令生成:
精準撰寫自動化指令:不管是複雜的 /etc/fstab 掛載、ZFS 記憶體上限計算,還是 PVE 的 Shell 指令,直接請 AI 根據目前的硬體狀態寫出客製化指令,完全不用怕打錯參數。

即時診斷系統死鎖:當遇到 VM 卡死 lock-101.conf 或是 SSH 斷連時,把 PVE 日誌(journalctl)貼給 AI,能立刻精準定位出是 NVIDIA 驅動 PCIe 重置失敗還是 ASPM 電源管理在作怪。

架構優化建議:包含記憶體分流、直通硬碟的 /dev/disk/by-id/ 綁定邏輯等,AI 都能提供最直接的解答,節省了 80% 漫無目的爬文的時間。
三、 飛牛OS (fnOS) 整合 4 顆舊 NAS 硬碟
為了把舊 NAS 的資料與 4 顆 3.5 吋硬碟完全合併進這台 AM5 神機,我選擇了近期口碑極佳的 飛牛OS (fnOS)。
硬碟直通 (Disk Passthrough) 技巧在 PVE 中,為了讓 fnOS 能夠直接讀取硬碟的 S.M.A.R.T. 狀態並發揮最佳休眠與 I/O 效能,建議使用 by-id 方式將 4 顆硬碟逐一直通給 fnOS VM:
查詢硬碟序列號:
在 PVE Shell 執行:
Bash

ls /dev/disk/by-id/

將硬碟綁定至 fnOS (VM 102):
Bash

qm set 102 -scsi1 /dev/disk/by-id/ata-STxxxxxxx_XXXXX1
qm set 102 -scsi2 /dev/disk/by-id/ata-STxxxxxxx_XXXXX2
qm set 102 -scsi3 /dev/disk/by-id/ata-STxxxxxxx_XXXXX3
qm set 102 -scsi4 /dev/disk/by-id/ata-STxxxxxxx_XXXXX4
直通完成後,開機進入 fnOS 即可直接建立 RAID 陣列或獨立儲存空間,舊 NAS 的檔案也能透過網路備份或直接掛載搬移,成功達成「淘汰舊機器,縮減設備體積」的目的。
四、 Win11 VM 顯卡直通(Passthrough)與地獄級避坑指南將 RTX 3080 直通給 Win11 VM 是這套系統最香、但也最容易踩坑的部分。以下是無痛直通與解決卡死的關鍵技巧:
-
PVE 顯卡直通最佳設定
BIOS / PCIe:開啟 ROM-bar 與 PCIe 標記。
主顯卡關閉:在 PVE VM 的 Hardware 設定中,取消勾選 Primary GPU (x-vga=1)。這個設定如果開啟,常會引發 NV 驅動重置失敗。
顯示器:預設介面設定為 none 或 VirtIO-GPU(搭配 Looking Glass 或 Sunshine/Moonlight 串流)。
-
解決關機卡死與 lock-101.conf 逾時問題
直通環境下,Windows 關機時常因為 RTX 3080 的 PCIe Bus Reset 失敗,導致 VM 卡在背景,PVE 拋出 can't lock file /var/lock/qemu-server/lock-101.conf - got timeout。
根本解法(必做設定):
關閉 Win11 快速啟動 (Fast Startup):
Windows 的快速啟動底層是休眠機制,會導致 PCIe 顯卡狀態無法乾淨釋放。在 PowerShell 以管理員執行:
PowerShell

powercfg /h off

關閉 PCIe 電源管理 (ASPM):
在 Windows 電源計劃的進階設定中,將 PCI Express ➔ 連結狀態電源管理 設定為 「關閉」;USB 選擇性暫停 設定為 「已停用」。防止顯卡在閒置或關機時進入低功耗休眠,徹底擺脫死鎖。

緊急解鎖指令:
若不幸遭遇鎖定卡死,可透過 PVE SSH 執行以下命令強制解鎖(不會影響其他運行中的 VM):
Bash

fuser -k /var/lock/qemu-server/lock-101.conf
rm -f /var/lock/qemu-server/lock-101.conf
sed -i '/^lock:/d' /etc/pve/qemu-server/101.conf
systemctl restart pvedaemon pveproxy
五、 PVE 宿主機記憶體與 ZFS 輕量化調優
由於配置了 64GB DDR5 記憶體,且同時運行 Win11、fnOS 與 Ubuntu VM,為了避免 PVE 預設的 ZFS ARC 快取吃掉太多 RAM 導致分配給虛擬機的記憶體不足,需要對 ZFS ARC 進行限制:
在 /etc/modprobe.d/zfs.conf 中限制 ARC 最大使用量(例如限制在 8GB):
Plaintextoptions zfs zfs_arc_max=8589934592
修改後執行 update-initramfs -u 並重啟 PVE,即可讓系統記憶體調配達到極佳的平衡,確保 64GB 記憶體能精準分給各個核心服務。
結語經過這一套完整的優化,這台 AM5 主機實現了真正意義上的「一機多用」:
遊戲娛樂:開啟 Win11 VM,RTX 3080 原生效能全開,順暢運行各類 3D 遊戲。

資料中心:飛牛OS 接管 4 顆 3.5 吋 HDD,提供超順暢的影音串流與檔案備份,完美淘汰舊 NAS。

智能後台:Ubuntu VM 穩定提供 AI 模型推理解算環境,搭配 AI 助手輔助維運,省心又高效。
如果你手邊也有高效能主機與舊硬碟,不妨也嘗試看看這套 Proxmox VE 雙系統直通 + fnOS 的全能組合!
@ricekong 嗯嗯. AMD reset bug, 去年我折腾的时候还没有用上 AI, 也是搞了好久. PVE 把 iGPU 直通给windows, 一鱼两吃. https://github.com/xiongyw/docs/blob/master/pve-8.4-1_minisforum-um880pro/pve-8.4-1_minisforum-um880pro.md
-
-
-
RTX 3080 20GB 解鎖全紀錄:FP16 +85%、BF16 +68%,然後我拿它去跑了 125B MoE
TL;DR —
gpu-unlock在 Ampere 上確實有效,我的 3080 20GB 魔改卡 FP16 從 57.31 → 105~106 TFLOPS(+85%)、BF16 64.37 → 106.63~109.41(+68%)、TF32 +70%,FP32 完全不變(這正是它有效的證據)。但對大型 MoE 的推理速度一點幫助都沒有 —— 記憶體頻寬才是瓶頸。真正有用的是算力密集、不吃頻寬的工作。
一、為什麼要解鎖
手上有一張 RTX 3080 20GB 魔改卡(GA102、68 SM、compute capability 8.6、320W power limit),跑在 KVM 虛擬機裡、PCI passthrough 直通給 guest。
20GB 在 2026 年仍然是很好用的容量 —— 夠放 27B Q4、夠放 Qwen3-Coder-Next 的量化版、夠跑 FLUX。但 GA102 的 FP16/BF16 吞吐是被硬體保險絲鎖住的:消費級 GeForce 的 FP16/BF16 FMA issue rate 只有專業卡的一半。
gpu-unlock這個專案(github.com/Zagitta/gpu-unlock,C 語言,約 300 星)做的事就是繞過那道鎖。二、原理(看懂這段才知道為什麼 FP32 不會變快)
這個專案源自 CMP 礦卡的解鎖器(CMP-unlocker V67 / PLM),用的是 UEFI pre-boot 時序:在
nvidia驅動綁定顯卡之前,搶先寫入 GPU 的 fuse shadow 暫存器:- SS0 ←
0x88888888:把 FP16/BF16 的 issue rate 拉回 full-speed BF16 - SS1 ←
0x8:打開 IMLA4 指令
關鍵在於它只改 FP16/BF16 的 FMA 吞吐,不動 FP32 的 CUDA core 數量。所以:
- FP16 / BF16 / TF32 → 大幅提升(它們走 tensor core 路徑)
- FP32 → 完全沒變(走一般 FP32 管線,本來就沒被鎖)
如果你的 FP32 數字也變快了,那才是可疑的 —— 那代表你量到的不是真實增益,而是時脈或散熱狀態的變化。我特別把 FP32 當作對照組。
三、環境
項目 值 GPU RTX 3080 20GB(GA102、68 SM、CC 8.6、320W) 驅動 595.99.02 系統 Ubuntu(Linux 7.0.0-38-generic) 虛擬化 KVM guest,PCI passthrough Secure Boot 開啟 initramfs dracut(不是 initramfs-tools) 注意最後兩項 —— 這是後面兩個坑的來源。
四、正確的安裝方式
專案 README 的做法:
git clone https://github.com/Zagitta/gpu-unlock cd gpu-unlock make sudo make install # 或 make install-deb然後必須加 kernel cmdline 指定要解鎖的 PCI 位址:
gpu_unlock.targets=0000:02:00.0(
lspci -nn | grep NVIDIA找到你的位址,格式是DDDD:BB:DD.F)接著重建 initramfs、重開機。
 ️ 網路上常見的錯誤做法
sudo insmod gpu_unlock.ko # ← 沒用專案 README 明講:對已經被
nvidia驅動綁定的卡手動載入模組沒有作用。解鎖必須發生在驅動綁定之前,也就是 initramfs 階段。另外,編出來的產物名字是
gpu_unlock,不是gpu-unlock.ko。用insmod找錯檔名的人會卡很久。五、三個實戰坑
坑 1:dracut vs initramfs-tools(最容易漏)
make install-deb只會裝這一個檔案:/usr/share/initramfs-tools/modules.d/gpu-unlock.conf但 Ubuntu 現在預設用 dracut。 如果你
ls /etc/initramfs-tools/發現根本沒在用,那這個 conf 永遠不會被讀到,模組不會進 initramfs,重開機後什麼都不會發生(也不報錯,最陰險)。要自己補一個:
sudo tee /usr/lib/dracut/dracut.conf.d/gpu-unlock.conf <<'EOF'
force_drivers+=" gpu_unlock "
EOF
然後重建。怎麼確認真的進去了:
lsinitramfs /boot/initrd.img-$(uname -r) | grep gpu_unlock
# 應該看到:
# usr/lib/modules/7.0.0-38-generic/updates/dkms/gpu_unlock.ko.zst
# usr/lib/firmware/... (nvidia firmware)
我的 initrd 從 38 MB 長到 110,239,486 bytes,這就是模組和 firmware 真的被打包進去的證據。
坑 2:Secure Boot 擋下未登記的金鑰
重開機後
dmesg出現:Kernel is locked down from EFI Secure Boot mode Loading of module with unavailable key is rejectednvidia模組有 Canonical 簽章,所以沒問題;gpu_unlock是 DKMS 現場編譯的,用的是你機器自己的 MOK 金鑰 —— 而它還沒被登記。解法:
sudo mokutil --import /var/lib/shim-signed/mok/MOK.der
sudo reboot
重開機會進 MOK 管理畫面(藍底),選 Enroll MOK → Continue → 輸入密碼。這個畫面只停留約 10 秒,錯過就要重來一次。
坑 3:驅動版本與 firmware 不符
專案附的 firmware 是給 610.43.03 的,我的是 595.99.02。屬於「未支援組合」。
實測結果:能跑,而且數字完全正常。專案做的是改 fuse shadow,與驅動版本相關性不高。但這是你自己要承擔的風險 —— 如果哪天驅動更新到 610 之後反而出現異常,記得回來懷疑這個組合。
六、成功長什麼樣
開機
dmesg會有一長串 ROM 解析日誌,最後一行是關鍵:gpu_unlock: loading out-of-tree module taints kernel. ROM chain: pos=0x0 data=0x52494350 bytes=65024 type=0x0 ... FWSEC geometry: image_off=0x4239c size=0xde00 imem=0xd600 dmem=0x800 ... FWSEC signature selection: versions=0x7 fuse_version=2 sig_bytes=384 pci 0000:02:00.0: gpu_unlock: unlocked ← 這一行才是成功注意:沒有這一行就代表沒解鎖,即使模組載入成功也一樣。很多人
lsmod | grep gpu_unlock看到模組在就以為成功了 —— 那不代表 fuse 被改到。(順帶一提:解鎖是 per-boot 的,每次重開機都要重新跑一次這個流程,這也是為什麼它必須在 initramfs 裡。)
七、實測數據
方法:PyTorch
torch.matmul,8192³ 方陣,每個 dtype 跑 5 次取中位數,解鎖前後各測一輪(解鎖後跑兩次確認可重現)。dtype 解鎖前 解鎖後(兩次) 增益 FP16 57.31 105.25 / 106.11 +85% BF16 64.37 106.63 / 109.41 +68% TF32 31.61 53.90 / 53.42 +70% FP32 21.47 21.43 / 21.24 ±0% ← 對照組,正確 兩次獨立測量誤差 < 2.5%,所以這不是雜訊。
對照作者在 3090 Ti 上的數據
dtype 3090 Ti 前 3090 Ti 後 我的 3080 前 我的 3080 後 FP16 87.46 118.39 57.31 105~106 BF16 87.50 157.41 64.37 106~109 TF32 42.58 82.61 31.61 53.90 兩點觀察:
- 我的 3080 解鎖後 BF16 只有 106~109,作者的 3090 Ti 到 157。差距來自 SM 數(68 vs 84)與功耗上限(320W vs 450W),完全符合預期。
- 相對增益我也是略低(BF16 +68% vs +80%)。沒有黑魔法 —— 這張卡該有的表現就是這樣。
八、證明這不是時脈幻覺
最容易被質疑的一點:「你是不是只是 GPU 跑到更高頻?」
測試期間用背景
nvidia-smi每 0.5 秒採樣:指標 實測最高 上限 功耗 251 W 320 W 核心時脈 1950 MHz — 溫度 52 °C — 251W / 320W —— 沒撞功耗牆。 52°C 也遠遠不到降頻溫度。
所以增益全部來自 instruction issue rate 加倍,不是頻率或散熱。
九、然後我拿它去跑 125B MoE —— 幻滅
解鎖之後第一件事,當然是把手上最大的模型丟上去:Qwen3.8-Flash-Next 125B MoE(IQ2_XS 量化)。
結果:
指標 RTX 3080 20GB(解鎖後) R9700 32GB 解碼速度 50~62 tok/s 70~88 tok/s 專家槽數量 7,941 16,862 VRAM 19,896 / 20,480 MiB(滿) 31.5 / 31.9 GiB prefill(27k tokens) 1,090 tok/s 1,363 tok/s 系統可用 RAM 8.8 GiB(危險) 正常 解鎖後仍然輸。 原因很簡單:
大型 MoE 的 decode 是 記憶體頻寬 + VRAM 容量 的競賽,不是算力的競賽。
3080 的 320-bit GDDR6X 頻寬約 760 GB/s,而 125B MoE 每一顆 token 都要把大量專家權重搬一次。你把 FMA 吞吐加倍,只是讓「計算」變快 —— 但計算本來就不是瓶頸,等資料才是。
而且 20GB VRAM 只放得下 7,941 個專家槽(R9700 有 16,862),命中率 95.5% vs 98.5%,其餘全部要走系統 RAM,把 42GB 主機記憶體吃到只剩 8.8GB —— 這是隨時會 OOM 的狀態。
結論:解鎖不能讓一張 20GB 卡變成 32GB 卡。容量和頻寬是買不到的(至少這個專案買不到)。
十、它真正有用的地方
於是我改變策略:大模型留在 R9700,3080 專門做「算力密集但不吃頻寬」的工作。
這才是解鎖的甜蜜點 —— 這些工作全是矩陣乘法,而且模型小、資料在 VRAM 裡跑得動。
我實際做的:把多模態模型的 vision encoder 移到 3080。
編碼一張 960×1280 的照片:
  CPU(6 執行緒)  1.50 s
  RTX 3080(CUDA) 0.07 s     ← 21 倍
️ 誠實說明:這 21 倍是 CPU → GPU 的差距,不是解鎖的功勞。我沒有單獨量測「解鎖前 vs 解鎖後」的 vision 編碼速度,所以不能把這個數字算在解鎖頭上。解鎖在理論上應該有幫助(vision encoder 是純 FP16 矩陣運算),但我沒有證據。其他明顯受益的方向(同樣是算力密集、模型小):
- Embedding / rerank(bge-m3、Qwen3-Embedding-8B)—— 批次吞吐直接翻倍
- Whisper 語音轉錄
- FLUX / SDXL 影像生成 —— 這是最大的受益者,diffusion 每一步都是大矩陣乘法,而且完全不吃頻寬
- 小型 dense 模型(8B~14B)的 prefill
反過來,不要在這張卡上跑:
- 30B-A3B 以上的 MoE(會拉爆系統 RAM,我就因此當機過一次)
- 任何需要 >40K context 的工作(20GB 扣掉權重後 KV cache 不夠)
十一、回滾
完全移除:
sudo apt-get remove -y gpu-unlock-dkms

# 移除 kernel cmdline
sudo sed -i 's|gpu_unlock.targets=[^ ]* ||' /etc/default/grub
sudo update-grub

sudo dracut -f
sudo reboot
回滾後 FP16/BF16 會回到原本的一半吞吐,其他一切正常。
十二、風險提醒
- 這是修改 GPU firmware 行為的工具,不是官方支援的功能。理論上有變磚風險(雖然社群回報中極少)。
- Secure Boot 需要登記自簽 MOK —— 等於在開機鏈上開了一個口子。安全性要求高的機器請三思。
- 驅動更新後行為未知 —— 特別是你的驅動版本與專案 firmware 不符時。
- 每次開機都會重新套用,任何 initramfs 相關的變更(核心更新、dracut 重建)都可能讓它靜默失效。建議在
dmesg裡留一行檢查,或寫個開機腳本檢查gpu_unlock: unlocked是否存在。
結語
gpu-unlock是真的有效 —— 數據乾淨、FP32 對照組不動、功耗溫度都正常,不是玄學。但它不會把你的消費級卡變成專業卡。它只是把被鎖住的 issue rate 還給你,而這個世界大部分的 AI 推理瓶頸是記憶體,不是算力。
在我的機器上,它的價值是:讓一張 20GB 的 3080 從「跑不動大模型、跑小模型也慢」變成「專門處理算力密集的小模型工作」,而且做得非常好。
如果你的工作負載是 diffusion、embedding、vision —— 值得一試。
如果你期待它讓你的 70B 模型變快 —— 省下來吧。
硬體:RTX 3080 20GB(GA102/68SM/320W)、驅動 595.99.02、Ubuntu 7.0.0-38-generic、KVM PCI passthrough
測試工具:PyTorch cuBLAS,8192³ GEMM,5 次中位數 - SS0 ←
-
,
R ricekong 引用了 此主题
-
-





 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!