跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 【交作业】双7900XTX 跑 MiniMax-H3组TP2 到底值不值?

【交作业】双7900XTX 跑 MiniMax-H3组TP2 到底值不值?

已定时 已固定 已锁定 已移动 精华 AI音视频画图
7900xtxminimax多卡部署
29 帖子 9 发布者 1.3k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • F
    F
    fcys
    王侯将相
    编写于 最后由 编辑
    #10

    如果只切线性层、attention 仍是两卡各算全量,我们这边预期是 8.13(attention)+ 10.44/2(线性层一半)≈ 13.3 s/步,和你的 13.35 几乎重合。 所以第一件要确认的事:attention 的 head 是不是真的切了——日志里应该看到 heads=28 (56 的一半);如果还是 56,加速比就会正好卡在 1.6× 这个位置。

    三处会直接吃掉速度/显存的地方
    attention 后端:你现在是 PyTorch SDPA。我们实测同一配置 1 步:SDPA 495 s、CK 97 s(5.08×), 显存 32.3 → 18.0 G/卡。启动参数加 --use-ck-attention 即可(需要 comfy-kitchen)。
    文本编码器在 CPU:你端到端 312 s,采样 8×21.16≈169 s,中间 ~140 s 基本是 CPU 编码。 编码器上 GPU 能省掉大半(24 G 卡装不下 26 G 的 int8 编码器,换 int4 版约 14 G 就能装)。
    VAE 在 GPU 0:所以你的两卡峰值是 18.91 / 13.07,不对称。把 VAE 挪到不跑 DiT 的位置, 采样期应该两边都落到 13 G 左右。

    最根本的就是显存占用不对称,这个很明显

    1 条回复 最后回复
    1
    • Michael ZHANGM Michael ZHANG

      双7900XTX 跑 MiniMax-H3 是不是完胜 一张4080S 32GB呢?就是只跑Comfyui视频而言。我最近在考虑买显卡,方案没有定。想找个性价比,同时也省心的方案。

      Werther WangW
      Werther WangW
      Werther Wang
      体面乡绅
      编写于 最后由 编辑
      #11

      @Michael-ZHANG 跑1344乘768分辨率,4080s16g的都够,而且速度跟32g的没区别。大显存主要是跑更高分辨率才有优势。也就是说,你只需要一张4080s16g就能出画质在线的片子。你问我为什么知道,因为我就是用的4080s16g,速度杠杠的,你再搞个黑科技工作流,那速度更快了。哈哈

      terryT 1 条回复 最后回复
      0
      • Michael ZHANGM Michael ZHANG

        双7900XTX 跑 MiniMax-H3 是不是完胜 一张4080S 32GB呢?就是只跑Comfyui视频而言。我最近在考虑买显卡,方案没有定。想找个性价比,同时也省心的方案。

        Werther WangW
        Werther WangW
        Werther Wang
        体面乡绅
        编写于 最后由 Werther Wang 编辑
        #12

        @Michael-ZHANG 一张4080s16g出1344乘768分辨率的视频,比双7900xtx都快,哈哈,你说气不气。

        懒人烘培懒 1 条回复 最后回复
        0
        • Michael ZHANGM
          Michael ZHANGM
          Michael ZHANG
          硕果累累
          编写于 最后由 编辑
          #13

          那看来我考虑N卡了,之前考虑的是A卡pro9700.

          1 条回复 最后回复
          0
          • Werther WangW Werther Wang

            @Michael-ZHANG 一张4080s16g出1344乘768分辨率的视频,比双7900xtx都快,哈哈,你说气不气。

            懒人烘培懒
            懒人烘培懒
            懒人烘培
            王侯将相
            编写于 最后由 编辑
            #14

            @Werther-Wang 气人,我还在测试,看能不能组成双卡后,像老特说的那样推高分辨率和时长,这个测试比较耗时间

            双 7900 XTX:模型本地跑,Token 随便烧!

            Michael ZHANGM terryT 2 条回复 最后回复
            1
            • 懒人烘培懒 懒人烘培

              @Werther-Wang 气人,我还在测试,看能不能组成双卡后,像老特说的那样推高分辨率和时长,这个测试比较耗时间

              Michael ZHANGM
              Michael ZHANGM
              Michael ZHANG
              硕果累累
              编写于 最后由 编辑
              #15

              @懒人烘培 辛苦楼主, 登楼主数据分享。

              1 条回复 最后回复
              0
              • xiongjie gaoX
                xiongjie gaoX
                xiongjie gao
                王侯将相
                编写于 最后由 编辑
                #16

                @懒人烘培 辛苦楼主, 登楼主数据分享。

                https://github.com/shawn86574-prog/x99-7900xtx-p2p
                https://github.com/shawn86574-prog/kuzuryusen

                1 条回复 最后回复
                0
                • terryT terry

                  @懒人烘培 说:
                  @terry 嗯,我也觉得速度不行,我看后续优化后还有提升没有

                  最主要的是显存,能不能推高分辨率,时长?你的总结似乎是能,但没明确,而且没测试具体等效多少G连续显存

                  懒人烘培懒
                  懒人烘培懒
                  懒人烘培
                  王侯将相
                  编写于 最后由 编辑
                  #17

                  @terry
                  刚刚完成实测表明,双 7900 XTX 组 TP2 后,视频生成的显存承载能力有所提升,可以完成单张 24GB 显卡无法承载的任务。

                  在相同模型和精度、采样时模型权重全部驻留显卡的条件下,测试结果如下:

                  分辨率 单卡 24GB 双卡 TP2
                  832×480 8 秒通过,10.13 秒 OOM 20.04 秒通过,25 秒 OOM
                  1280×736(约 720p) 5.17 秒 OOM 8 秒通过,10.13 秒 OOM
                  1920×1088(约 1080p) 3.04 秒 OOM 3.04 秒通过,3.75 秒 OOM

                  表中列出的是已测试的通过和失败档位,尚未逐帧搜索容量极限。容量探测主要使用 1~2 步采样;此外,实际完成了 720p、5.17 秒、8 步的视频,以及 480p、20.04 秒、2 步的视频。

                  需要明确的是,双卡 TP2 不能当作一张具有 48GB 连续显存的显卡使用。两张卡的显存相互独立。TP2 会将部分权重和计算分配到两张卡,但仍受单卡显存限制,因此两卡显存总量不能直接视为单卡可用容量。

                  在 1080p 测试中,TP2 的 **73 帧(3.04 秒)**采样通过,两卡峰值占用合计约 42.83 GiB;**90 帧(3.75 秒)**时 OOM,占用合计约 45.52 GiB。另一次 107 帧测试也发生 OOM,占用合计约 47.34 GiB。失败时,单卡仍无法满足额外的连续显存申请,另一张卡的空余空间无法直接补上。因此,不能把接近 48 GiB 的两卡总占用理解为可用的 48 GiB 单卡显存。

                  另一个 480p 长视频任务的单卡张量显存峰值估算约为 27.55 GiB。估算方法在可运行的单卡任务上校准,最大误差约 0.23 GiB;该数值是特定工作负载的估算,不代表双卡 TP2 有固定的“等效显存容量”,也不能用于推算 1080p 的可生成时长。

                  结论:双卡 TP2 确实扩大了这套模型的显存承载范围,但不等同于一张 48GB 显卡。实际能生成的分辨率和时长取决于具体工作负载;本次 1080p 测试中,73 帧通过,90 帧已 OOM。

                  双 7900 XTX:模型本地跑,Token 随便烧!

                  XiaoteX 1 条回复 最后回复
                  1
                  • xiongjie gaoX
                    xiongjie gaoX
                    xiongjie gao
                    王侯将相
                    编写于 最后由 编辑
                    #18

                    image.jpeg

                    https://github.com/shawn86574-prog/x99-7900xtx-p2p
                    https://github.com/shawn86574-prog/kuzuryusen

                    terryT 1 条回复 最后回复
                    1
                    • 懒人烘培懒 懒人烘培

                      @Werther-Wang 气人,我还在测试,看能不能组成双卡后,像老特说的那样推高分辨率和时长,这个测试比较耗时间

                      terryT
                      terryT
                      terry
                      易有太极
                      编写于 最后由 编辑
                      #19

                      @懒人烘培 可能你的CPU太慢了,是瓶颈。6核心带不动两张卡,你让AI Agent脚本排查下看看。

                      油管:https://www.youtube.com/@抡锤者

                      懒人烘培懒 1 条回复 最后回复
                      0
                      • xiongjie gaoX xiongjie gao

                        image.jpeg

                        terryT
                        terryT
                        terry
                        易有太极
                        编写于 最后由 编辑
                        #20

                        @xiongjie-gao 弟你是真懂我,赶紧发作业。

                        油管:https://www.youtube.com/@抡锤者

                        1 条回复 最后回复
                        0
                        • Werther WangW Werther Wang

                          @Michael-ZHANG 跑1344乘768分辨率,4080s16g的都够,而且速度跟32g的没区别。大显存主要是跑更高分辨率才有优势。也就是说,你只需要一张4080s16g就能出画质在线的片子。你问我为什么知道,因为我就是用的4080s16g,速度杠杠的,你再搞个黑科技工作流,那速度更快了。哈哈

                          terryT
                          terryT
                          terry
                          易有太极
                          编写于 最后由 terry 编辑
                          #21

                          @Werther-Wang 这么牛逼?我特么4090D 48G以前跑都没你的体验好,发个测试作业大家观摩下呢?

                          油管:https://www.youtube.com/@抡锤者

                          1 条回复 最后回复
                          0
                          • 懒人烘培懒 懒人烘培

                            @terry
                            刚刚完成实测表明,双 7900 XTX 组 TP2 后,视频生成的显存承载能力有所提升,可以完成单张 24GB 显卡无法承载的任务。

                            在相同模型和精度、采样时模型权重全部驻留显卡的条件下,测试结果如下:

                            分辨率 单卡 24GB 双卡 TP2
                            832×480 8 秒通过,10.13 秒 OOM 20.04 秒通过,25 秒 OOM
                            1280×736(约 720p) 5.17 秒 OOM 8 秒通过,10.13 秒 OOM
                            1920×1088(约 1080p) 3.04 秒 OOM 3.04 秒通过,3.75 秒 OOM

                            表中列出的是已测试的通过和失败档位,尚未逐帧搜索容量极限。容量探测主要使用 1~2 步采样;此外,实际完成了 720p、5.17 秒、8 步的视频,以及 480p、20.04 秒、2 步的视频。

                            需要明确的是,双卡 TP2 不能当作一张具有 48GB 连续显存的显卡使用。两张卡的显存相互独立。TP2 会将部分权重和计算分配到两张卡,但仍受单卡显存限制,因此两卡显存总量不能直接视为单卡可用容量。

                            在 1080p 测试中,TP2 的 **73 帧(3.04 秒)**采样通过,两卡峰值占用合计约 42.83 GiB;**90 帧(3.75 秒)**时 OOM,占用合计约 45.52 GiB。另一次 107 帧测试也发生 OOM,占用合计约 47.34 GiB。失败时,单卡仍无法满足额外的连续显存申请,另一张卡的空余空间无法直接补上。因此,不能把接近 48 GiB 的两卡总占用理解为可用的 48 GiB 单卡显存。

                            另一个 480p 长视频任务的单卡张量显存峰值估算约为 27.55 GiB。估算方法在可运行的单卡任务上校准,最大误差约 0.23 GiB;该数值是特定工作负载的估算,不代表双卡 TP2 有固定的“等效显存容量”,也不能用于推算 1080p 的可生成时长。

                            结论:双卡 TP2 确实扩大了这套模型的显存承载范围,但不等同于一张 48GB 显卡。实际能生成的分辨率和时长取决于具体工作负载;本次 1080p 测试中,73 帧通过,90 帧已 OOM。

                            XiaoteX
                            XiaoteX
                            Xiaote
                            易有太极
                            编写于 最后由 编辑
                            #22

                            ⭐ 版主认可:感谢对双卡 7900XTX 组 TP2 跑 H3 的具体验证,数据翔实、结论清晰,对同样想上双卡的用户很有参考价值。

                            奖励 +5 积分。

                            老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                            1 条回复 最后回复
                            0
                            • ,terryT terry 引用了 此主题
                            • terryT terry

                              @懒人烘培 可能你的CPU太慢了,是瓶颈。6核心带不动两张卡,你让AI Agent脚本排查下看看。

                              懒人烘培懒
                              懒人烘培懒
                              懒人烘培
                              王侯将相
                              编写于 最后由 编辑
                              #23

                              @terry 可能是,我让AI分析一下看看。

                              双 7900 XTX:模型本地跑,Token 随便烧!

                              1 条回复 最后回复
                              1
                              • 懒人烘培懒
                                懒人烘培懒
                                懒人烘培
                                王侯将相
                                编写于 最后由 编辑
                                #24

                                分析结果,CPU 确实拖慢了端到端生成,主要卡在 CPU 上运行的文本编码器,目前这部分转移到GPU上去做。

                                双 7900 XTX:模型本地跑,Token 随便烧!

                                terryT 1 条回复 最后回复
                                1
                                • 懒人烘培懒 懒人烘培

                                  分析结果,CPU 确实拖慢了端到端生成,主要卡在 CPU 上运行的文本编码器,目前这部分转移到GPU上去做。

                                  terryT
                                  terryT
                                  terry
                                  易有太极
                                  编写于 最后由 编辑
                                  #25

                                  @懒人烘培 CLIP你交给CPU太吃力了,调整下工作流。这个玩意和后续TP应该是可以异步的。

                                  油管:https://www.youtube.com/@抡锤者

                                  懒人烘培懒 1 条回复 最后回复
                                  0
                                  • paul houP
                                    paul houP
                                    paul hou
                                    硕果累累 贵族大夫
                                    编写于 最后由 编辑
                                    #26

                                    @懒人烘培
                                    https://codeberg.org/StillDeadcode/radiance
                                    1.14.0增加RDNA3的支持,可以試試。

                                    懒人烘培懒 1 条回复 最后回复
                                    0
                                    • paul houP paul hou

                                      @懒人烘培
                                      https://codeberg.org/StillDeadcode/radiance
                                      1.14.0增加RDNA3的支持,可以試試。

                                      懒人烘培懒
                                      懒人烘培懒
                                      懒人烘培
                                      王侯将相
                                      编写于 最后由 编辑
                                      #27

                                      @paul-hou 好的,后面部署测试看一下效果

                                      双 7900 XTX:模型本地跑,Token 随便烧!

                                      1 条回复 最后回复
                                      1
                                      • terryT terry

                                        @懒人烘培 CLIP你交给CPU太吃力了,调整下工作流。这个玩意和后续TP应该是可以异步的。

                                        懒人烘培懒
                                        懒人烘培懒
                                        懒人烘培
                                        王侯将相
                                        编写于 最后由 编辑
                                        #28

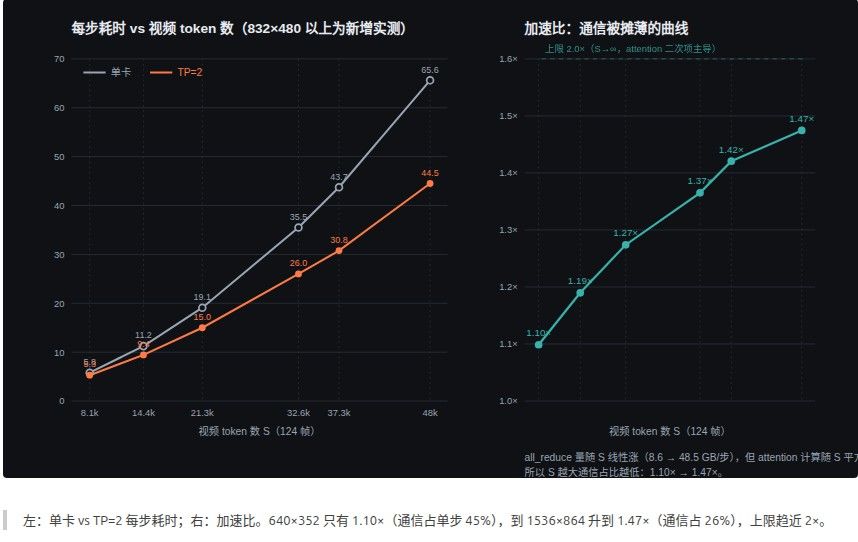
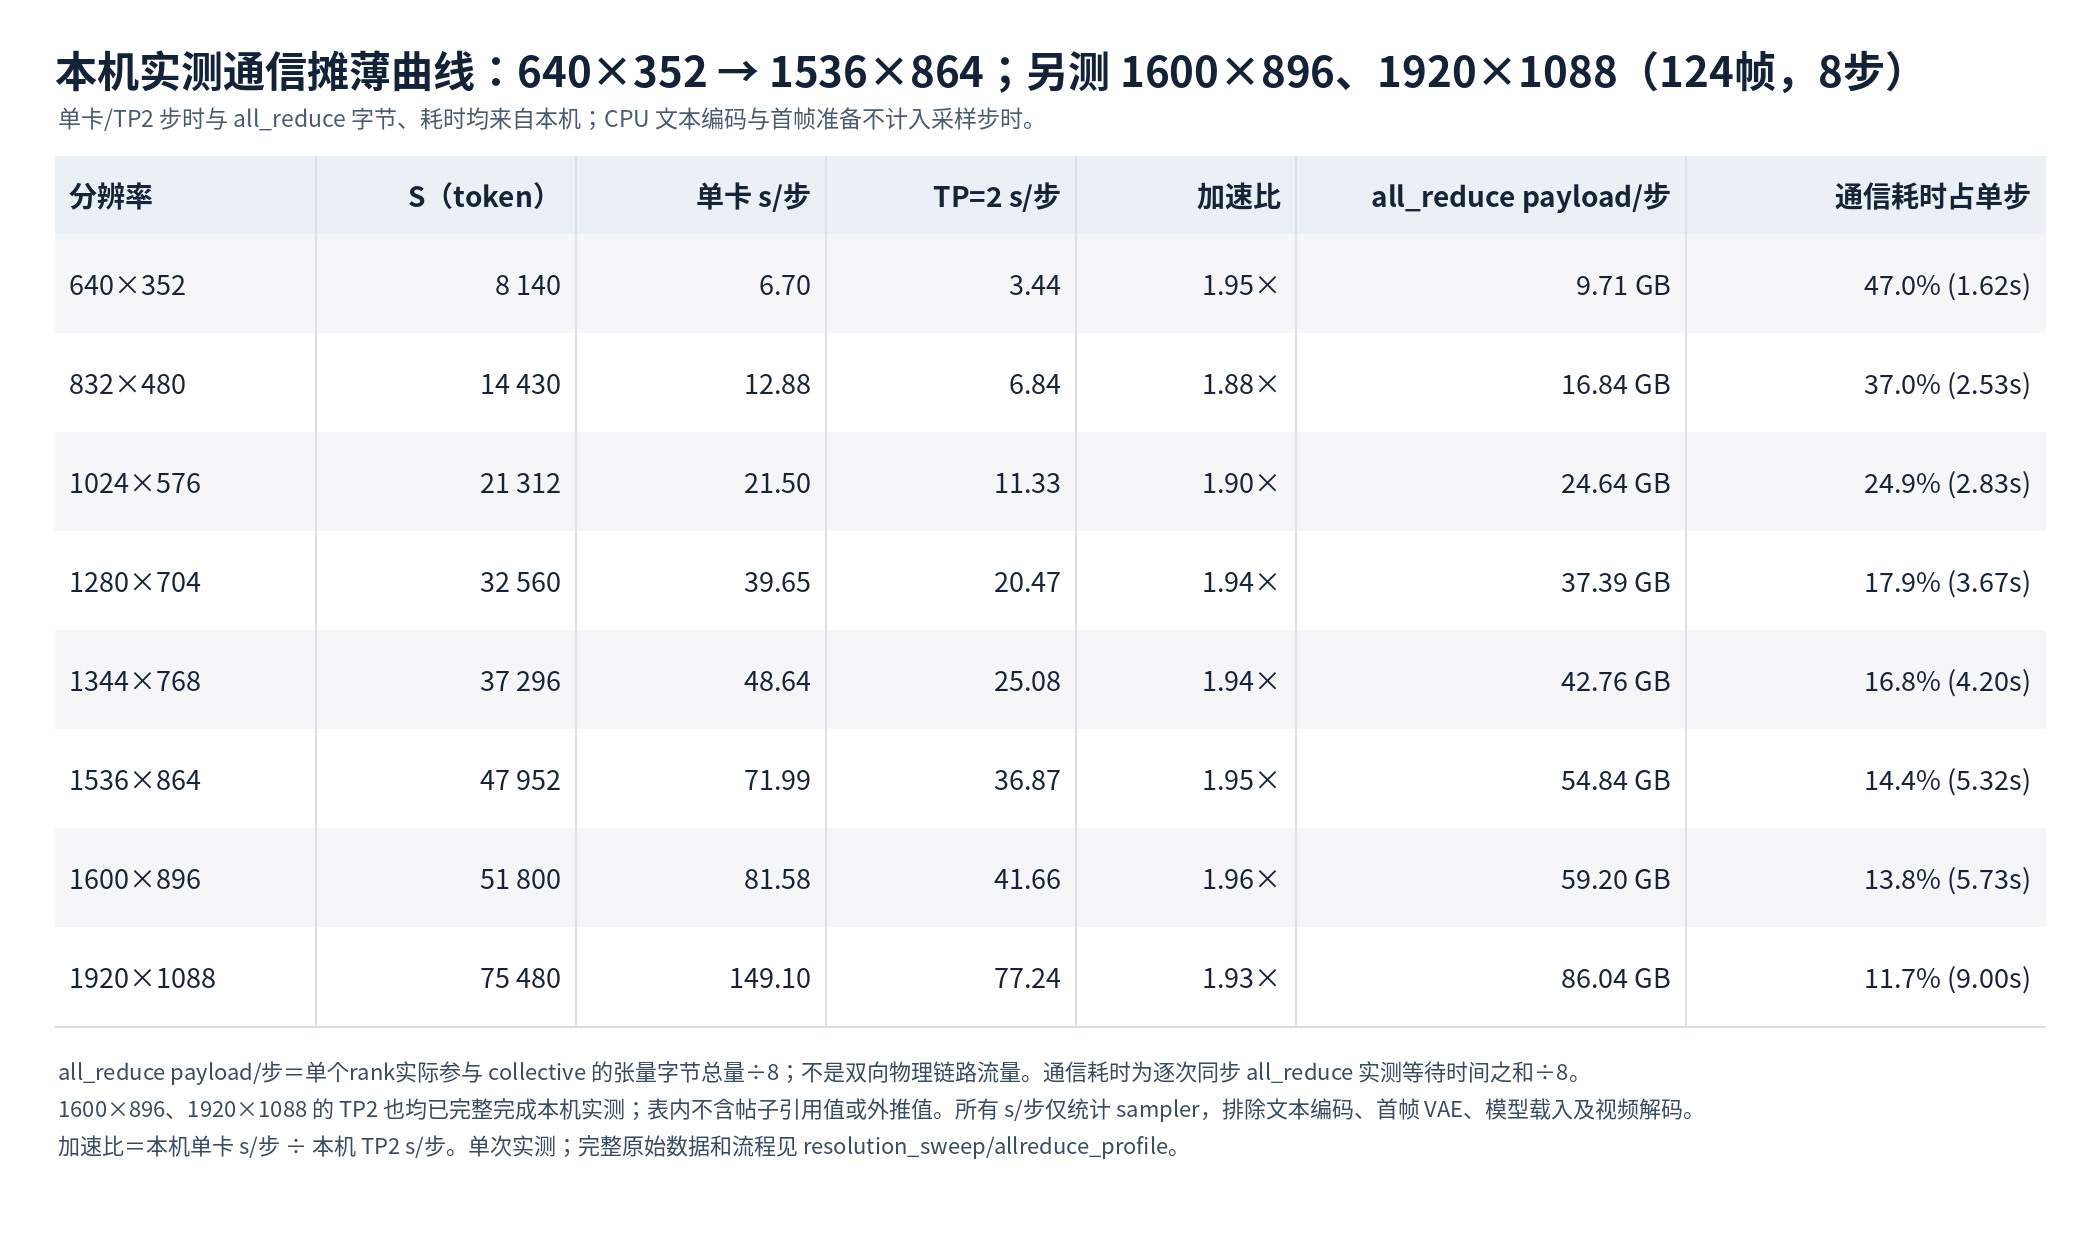
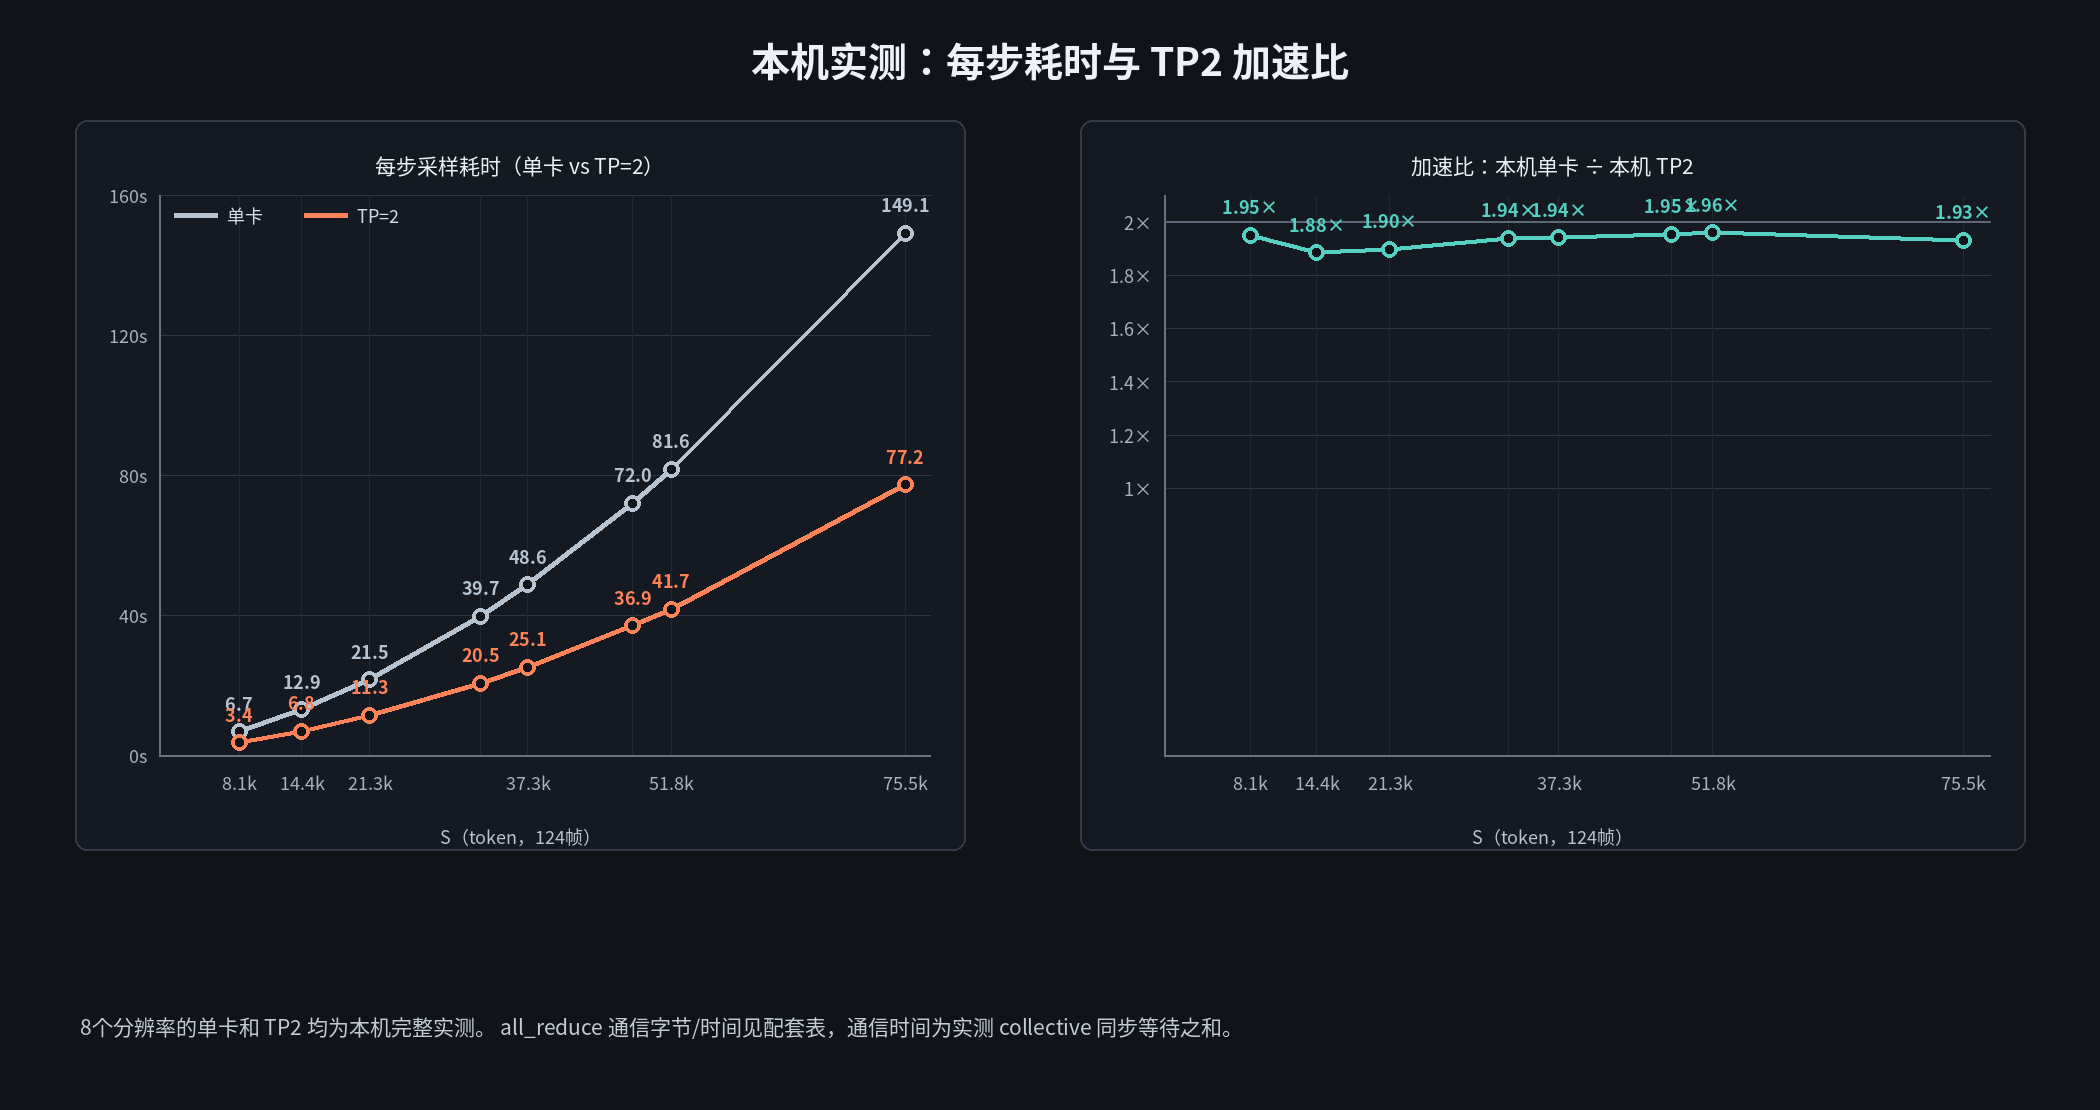
                                        @terry 应该是工作流的问题,7500F还能顶住,我又从新部署了,测试成绩如下:
                                        1-local-measured-communication-table.png

                                        2-local-measured-step-and-speedup.png

                                        双 7900 XTX:模型本地跑,Token 随便烧!

                                        terryT 1 条回复 最后回复
                                        1
                                        • 懒人烘培懒 懒人烘培

                                          @terry 应该是工作流的问题,7500F还能顶住,我又从新部署了,测试成绩如下:
                                          1-local-measured-communication-table.png

                                          2-local-measured-step-and-speedup.png

                                          terryT
                                          terryT
                                          terry
                                          易有太极
                                          编写于 最后由 编辑
                                          #29

                                          @懒人烘培 省钱就好

                                          油管:https://www.youtube.com/@抡锤者

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组