
本地4卡 deepseek折腾日记 新人发帖
-
26 万 token 长提示 Prefill 约 2.57K tok/s,已经拿来做真实项目。四路也试了,最后还是先回到单路。
最近这段时间一直在折腾本地大模型,现在主力基本定在 DeepSeek-V4.1-Flash-1017 了。
我是做网络安全的,日常主要让 Agent 写脚本、读项目、做代码审计和逆向分析。对我来说,模型能不能把一个长任务做下去,比聊两句话时吐字有多快更重要。
这套机器也不是一步到位买齐的。一路换主板、加卡、折腾 PCIe switch、驱动、P2P,再到引擎和监控,前前后后踩了不少坑。现在终于到了一个我愿意每天拿它干活的状态,整理出来给大家参考。
先放一张刚才真实任务的截图。
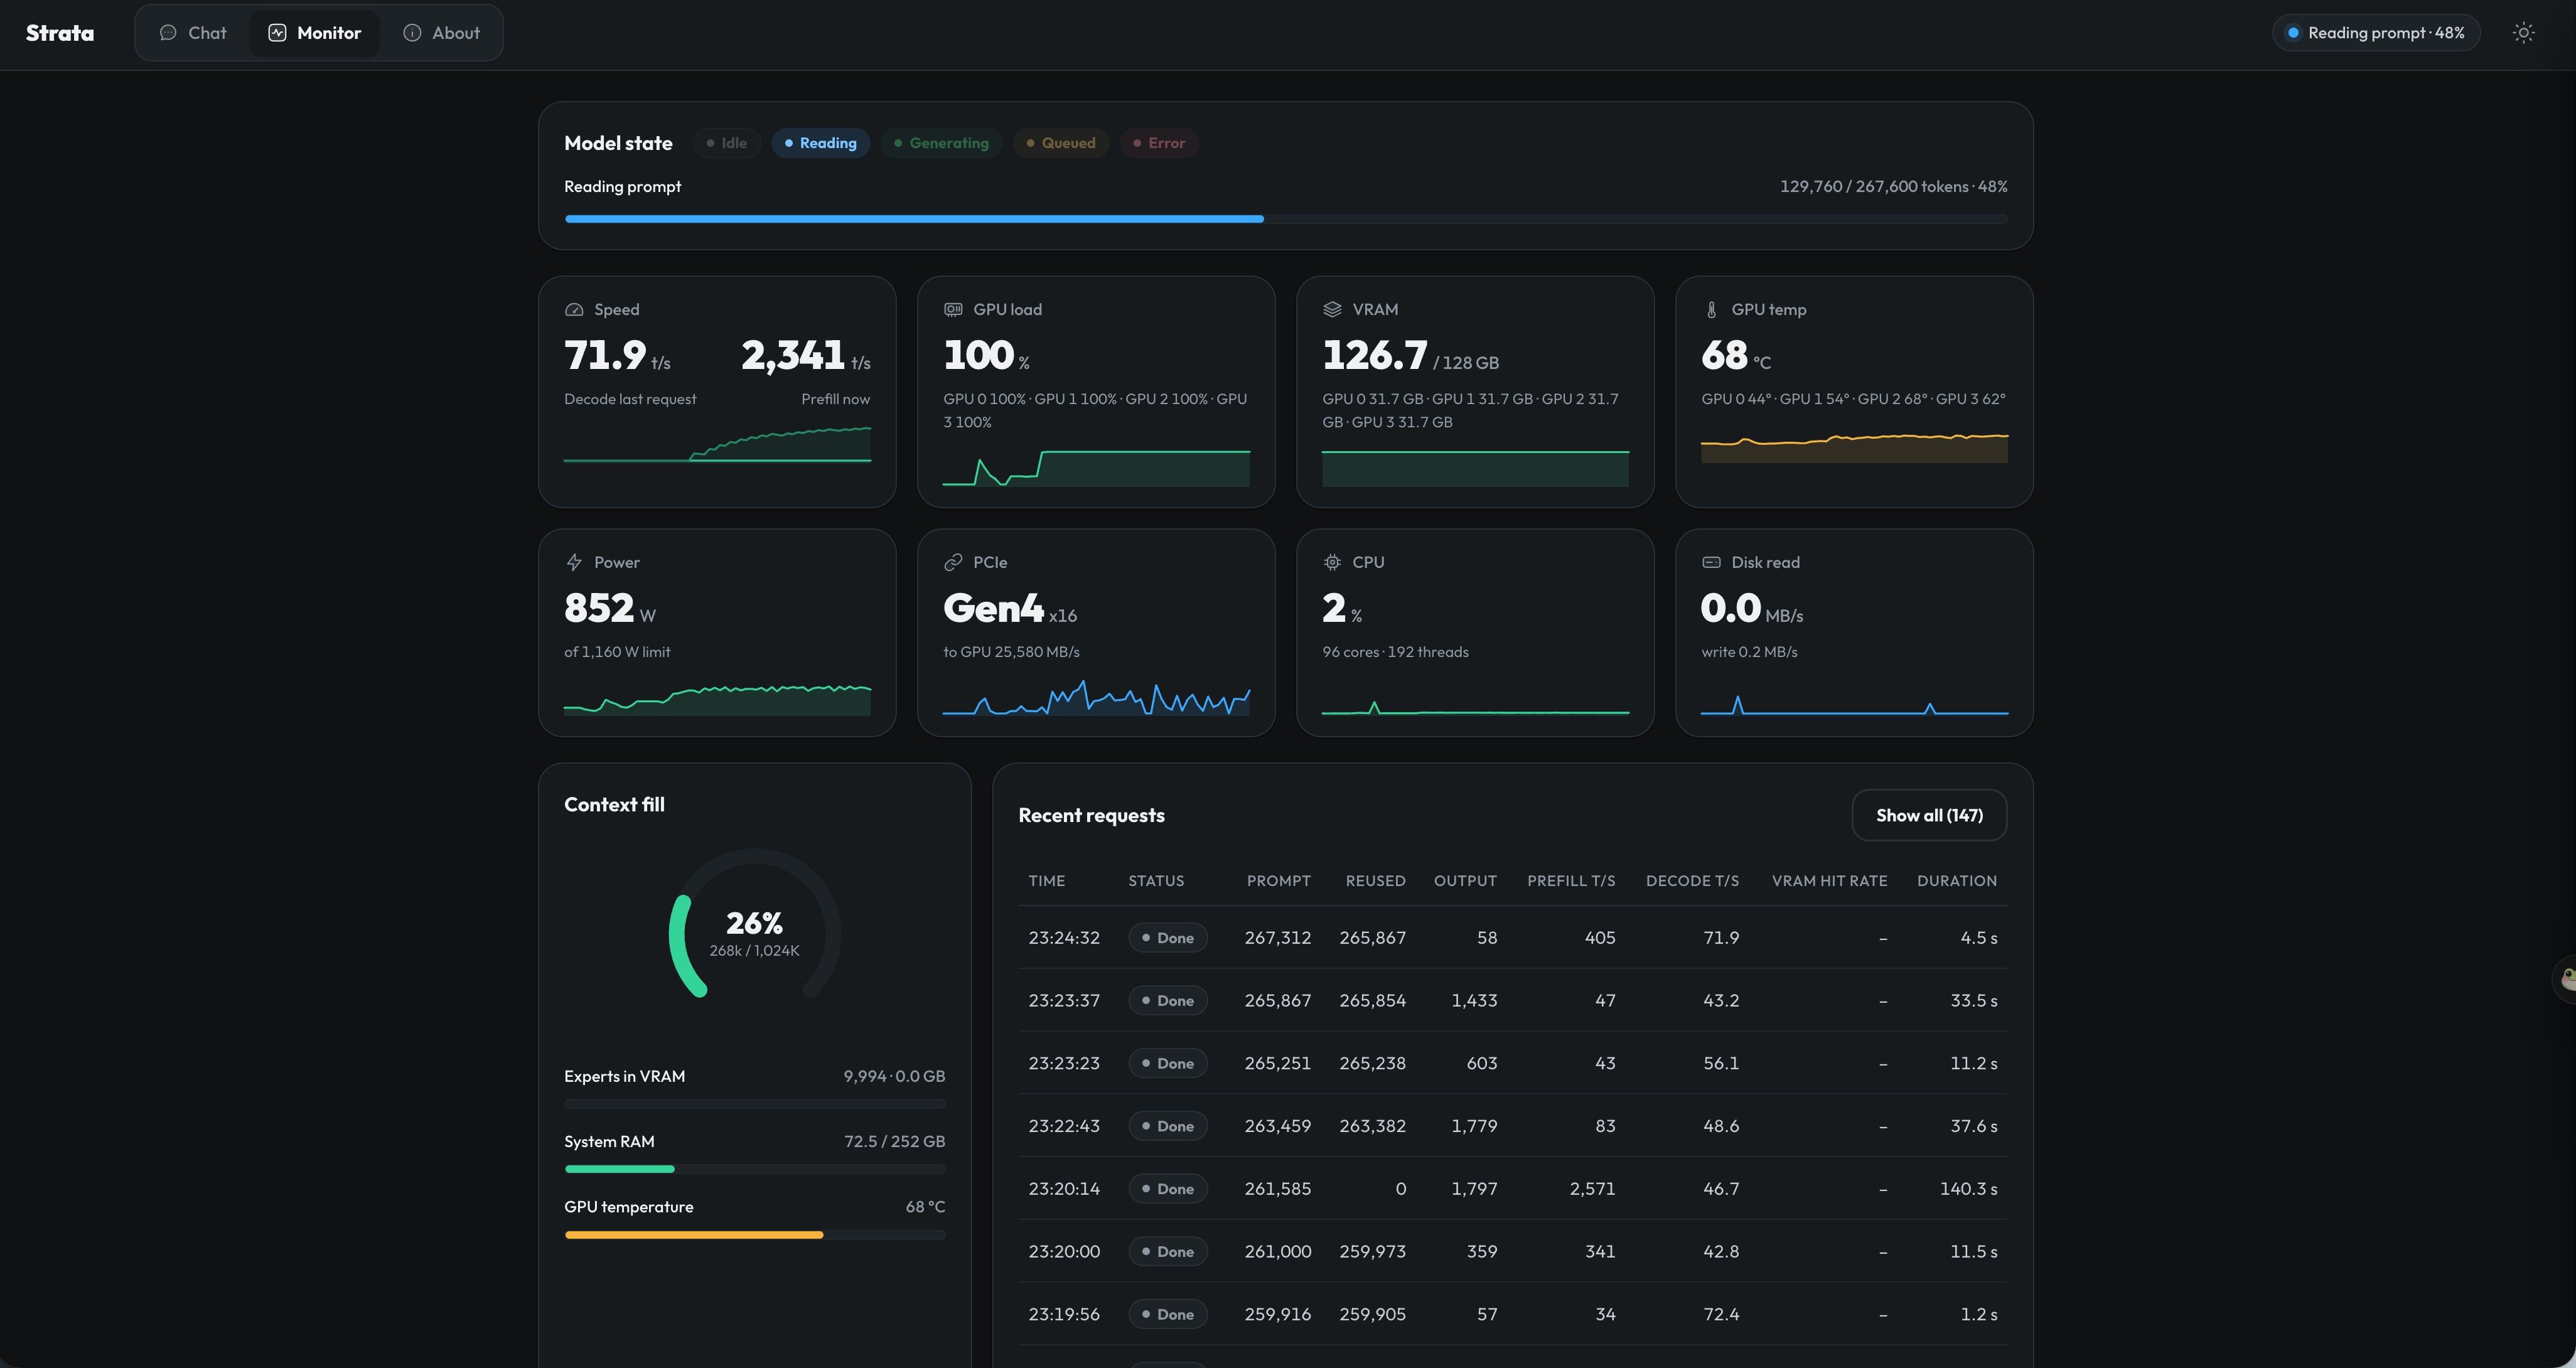
图 1:2026 年 10 月 28 日的真实 Agent 任务。顶部当前 Prefill 为 2,341 tok/s;下方还有一条 261,585 tokens、复用为 0 的已完成请求,Prefill 为 2,571 tok/s。顶部 71.9 tok/s 是上一条请求的 Decode,不能和当前 Prefill 拼成同一条请求的成绩。
先交代硬件和模型
项目 我的配置 CPU 双路 AMD EPYC 7K62,共 96 核 192 线程 主板 GIGABYTE MZ72-HB0 内存 256 GB,系统可见约 251.7 GiB 显卡 两张 RTX 4080 32G,加两张 RTX 4080 SUPER 32G,都是改显存卡 总显存 128 GiB 多卡连接 PCIe switch;目前四张卡的设备链路均显示 PCIe 4.0 ×16 系统 Ubuntu 24.04.4 LTS 主模型 DeepSeek-V4.1-Flash-1017,ISTA-DASLab GSQ-RCO IQ2_XS 配套文件 Engram IQ4_NL、DSpark Q8_0,另加视觉权重 引擎 Strata 本地修改版,选择性合入 Maya 和后续 Strata 的改进 客户端 主要是 DeepSeek Harness,也通过兼容 API 接其他 Agent 当前运行方式 四卡共同跑一个模型,单路服务,配置上下文上限 1,048,576 这里的单路是指同时处理一条生成请求,四张卡都参与模型运行。它不是只开一张显卡。
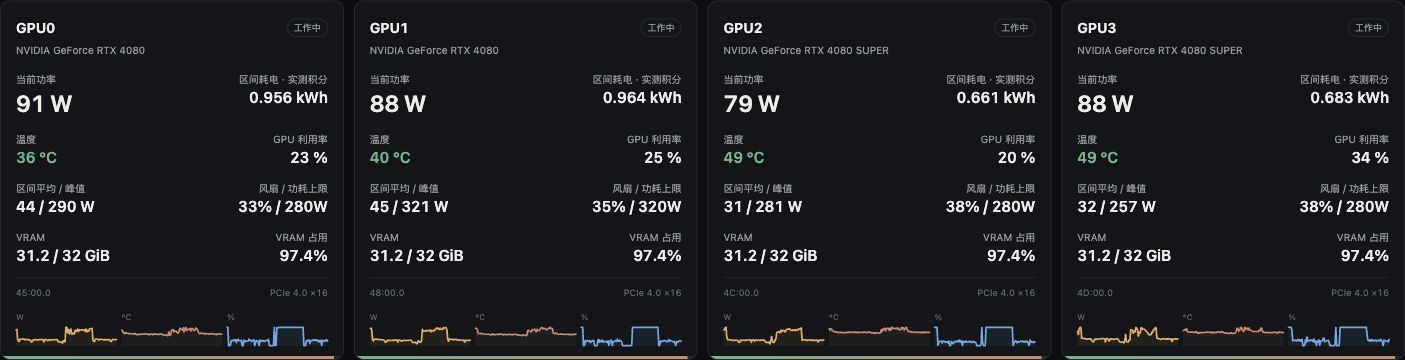
图 2:写帖时截取的四卡监控,每卡显存约 31.2 GiB。截图处于 Decode 阶段,所以功率明显低于前一张长提示读入时;两张图不是同一时刻。设备显示 ×16 也不代表四张卡各自独占一条通向 CPU 的 ×16 上联。
另外,IQ2_XS 不等于整套文件都是 2 bit,更不等于所有权重都在显存里。 我的下载记录大致是:
文件组成 大小,十进制 GB 四个 IQ2_XS 主权重分片 155.23 GB Engram IQ4_NL 110.60 GB DSpark Q8_0 7.98 GB 文本模型及配套文件合计 约 273.8 GB,不含后来增加的视觉文件 所以这套方案要一起用显存、主机内存和 SSD。GPU 放一部分专家及计算所需的数据,主机内存承担显存外专家等工作,Engram 有 SSD 文件及缓存路径。并不是把 273GB 文件全部搬进 128GB 显存。
现在真实干活是什么速度
上面那张图里,最有参考价值的是这条已完成请求:
指标 真实任务记录 输入 261,585 tokens 输入复用 0 Prefill 2,571 tok/s 输出 1,797 tokens Decode 46.7 tok/s,监控的请求计时口径 首 token 约 101.9 秒,自建监控记录 总耗时 约 140.3 秒 26 万 token 全量重读,首 token 还是要等一分多钟。 但读完之后,这条请求的生成速度是能正常工作的水平。相比只看一句话测试,我更关心这种情况,因为 Agent 做长项目时确实会碰到。
写帖期间,我又截了一张自己的监控:
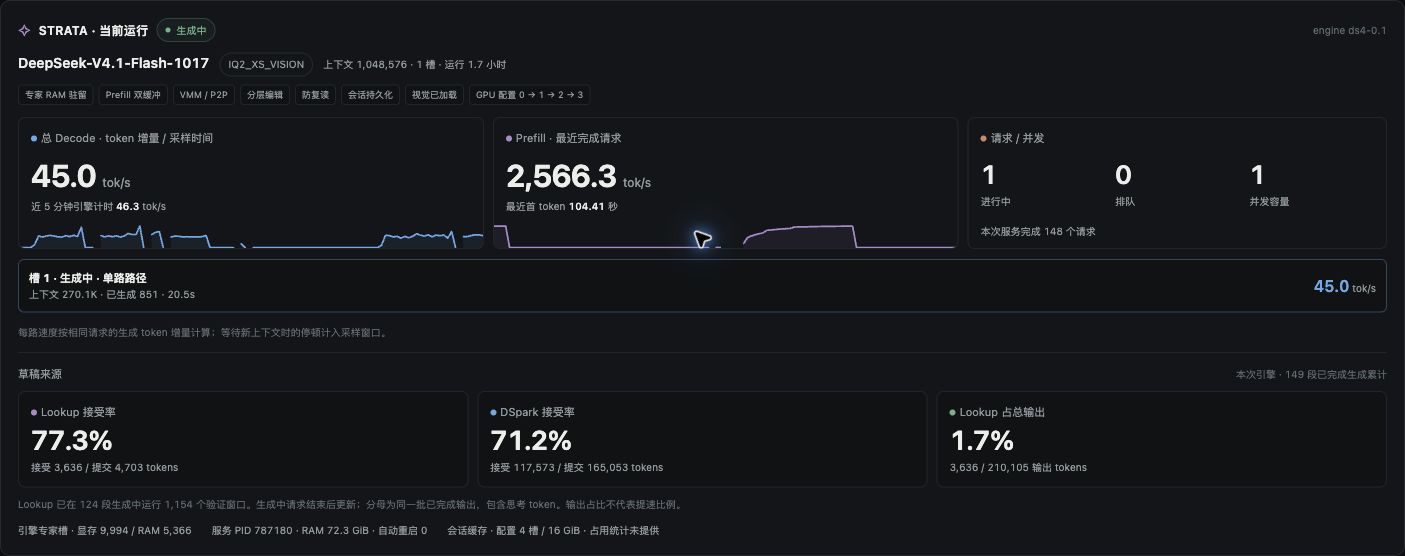
图 3:当前生成的采样速度约 45 tok/s;最近完成请求的 Prefill 约 2,566 tok/s、首 token 约 104 秒。面板明确分开了实时 Decode、最近请求 Prefill 和累计草稿统计。
日常不同请求的速度会有波动。小输出偶尔显示七十多,我也见过更高的短时读数,但不拿它们当整段长回复的稳定成绩。对眼前这些长任务,写成 Decode 四五十 tok/s、长输入 Prefill 两千多 tok/s 的实测例子,比较接近实际体感。
我现在把上下文上限设成了 1M。这次展示的真实任务在 26~27 万 token 左右,不能拿这张图推成“满 1M 也有完全一样的速度”。
主要折腾了哪些地方
先说清楚:这套已经有不少本地改动,不能把成绩直接算到一个官方版本头上。很多适配、排查和验证由 Codex 协助完成,四路实验也合入了 Opus 帮忙做的改动。核心技术和实现仍然来自开源项目的作者们。
目前比较重要的几块是这些。
专家驻留与 Prefill 搬运。 结合主机内存、NUMA 分布和 GPU 工作区,减少不必要的 CPU 暂存复制,调整长提示词读入时的专家传输路径。后来又合入了 Maya 的专家上传修复和锁页直传思路,以及 Strata 0.2.7 的部分 Prefill 优化。对我这台双路机器,这部分值得花时间。
动态 BAR1、VMM 和 P2P。 四张改显存卡之间的通信也单独折腾过,包括驱动补丁和引擎传输路径。中间最大的教训是:驱动显示支持 P2P,不代表当前模型引擎真的在走 P2P;把传输接上了,也不代表总速度就会翻倍。计算、专家驻留、CPU 工作和草稿接受情况仍然会影响速度。
GPU 解锁相关补丁。 我也适配过 gpu-unlock-ada,并保留与动态 BAR1/P2P 的兼容。不过几次历史对比还伴随引擎、缓存和参数变化,没法把最终速度提升全部归功于“解锁”。这部分算折腾记录,不写一个没有单独测出来的加速百分比。
DSpark 加提示词查找草稿。 除了 DSpark,还加了 lookup:从当前对话已经出现过的 token 片段里找可能的后续内容,再交给主模型验证。代码里重复结构多,确实有发挥空间。现在监控把两者分开,图 3 中 lookup 接受率约 77%,DSpark 约 71%,但 lookup 接受的 token 只占累计输出约 1.7%。接受率高,不代表整个任务就快了相同的百分比。
会话持久化、分层去审查和思考区防复读。 这些都是为实际 Agent 工作补的。保留对话状态,减少不必要的重算;思考区检测重复短句和长段落,避免一直烧 token。去审查也是我的使用需求,但这部分改动同样要观察对推理行为的影响。
视觉工作区复用。 后来把 Maya 的视觉显存借还机制也接进来了。图片编码期间借用已有的 Prefill 工作区,用完交还;文字阶段不用额外长期占一块独立视觉工作区。它仍然需要视觉权重和图片处理计算,并不是“视觉零成本”。本地已经试过 OCR、形状颜色识别、多图和图片后继续文字对话。
完整的 6 个路由专家计算保留,没有靠跳过专家来换这里的速度。
四路并发也测了 最后先退回单路
这段是最新踩坑,写出来可能比只贴最高速度更有用。
我们把 Maya 风格的
--parallel 4合进了独立版本,也补了每路监控。四路能同时生成,测试的 8 个请求都正常完成,但实际效果和我想要的有差距。条件是四个独立请求同时发起,分别测试每路约 8K 和 32K 输入,
max思考、temperature=1.0、top_p=1.0,每路输出上限 1024 tokens,无前缀缓存命中。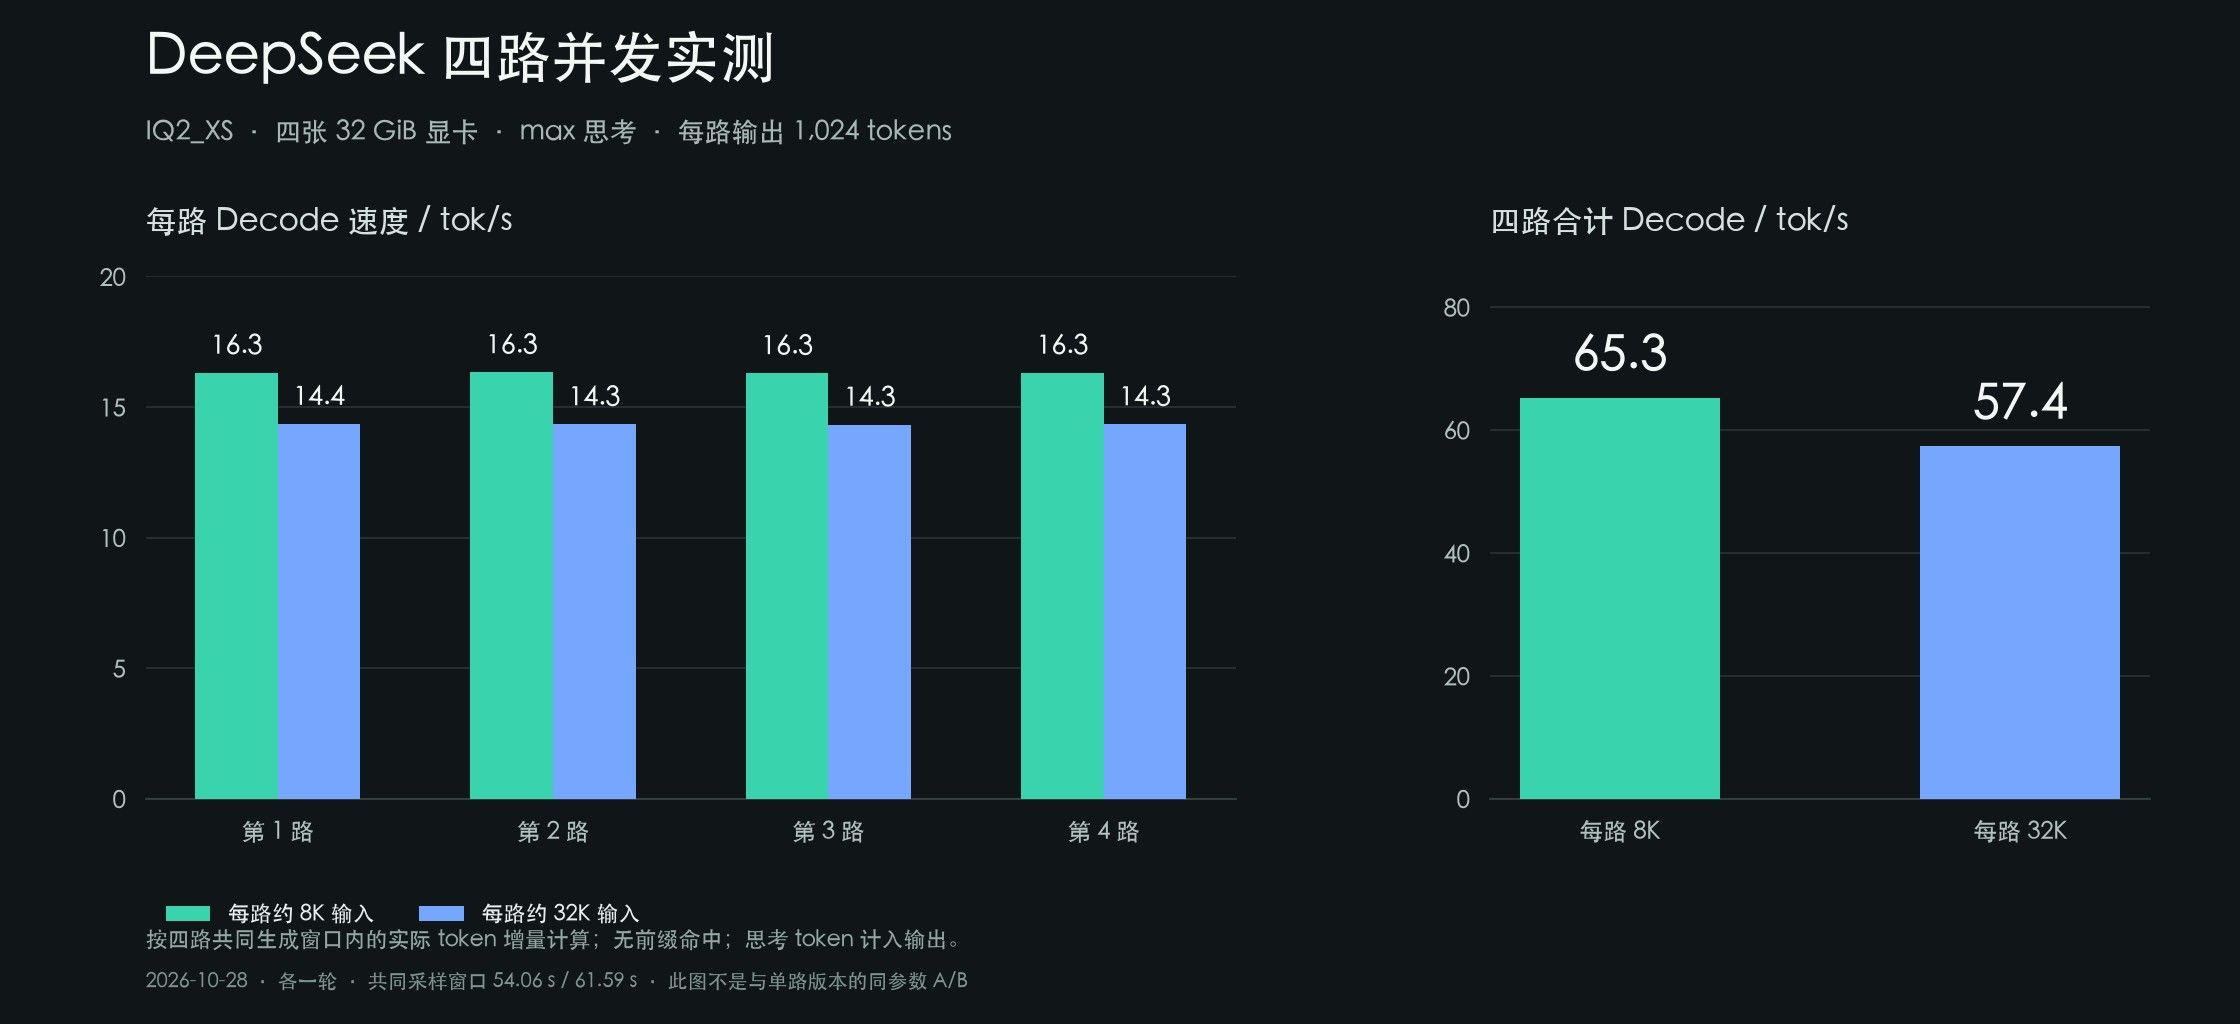
图 4:每路速度来自四路共同生成时间窗口内的实际 token 增量,合计为四路之和。图是测试数据绘制的统计图,不是监控截图。输出计数包含思考 token。
每路输入 每路 Decode 四路合计 Decode 首 token 等待 约 8K 约 16.3 tok/s 65.3 tok/s 13.6~33.7 秒 约 32K 约 14.3 tok/s 57.4 tok/s 19.3~59.0 秒 更影响体感的是新请求进来时的停顿。8K 那组,第一路出了首 token 后,其他三路还没出首 token 的一段时间里,它也停了约 19.5 秒;32K 那组对应约 39 秒。全部进入 Decode 后,四路才比较均匀地一起生成。
单路版本此前同一组 8K/32K 测试分别记录过约 50.2、45.7 tok/s。不过当时是
high、温度 0、每路 512 输出,这次四路是max、温度 1、1024 输出,所以不把两组数字硬算成严格的性能损失比例。我的实际选择是:先切回四路改动前的单路版本,保留四路版继续研究。 我更需要一个主 Agent 顺畅地完成长任务,暂时接受排队,也不想让正在干活的主会话经常等其他请求读入。
这只是当前本地实现和这台机器的结果,不是说 DeepSeek 永远做不好并发。
缓存比我最开始想的更重要
刚开始只盯 Decode,后来发现,Agent 干活很多时候是同一个会话来回调用,旧上下文一次次带回来。能不能接上之前的状态,直接影响下一轮要等多久。
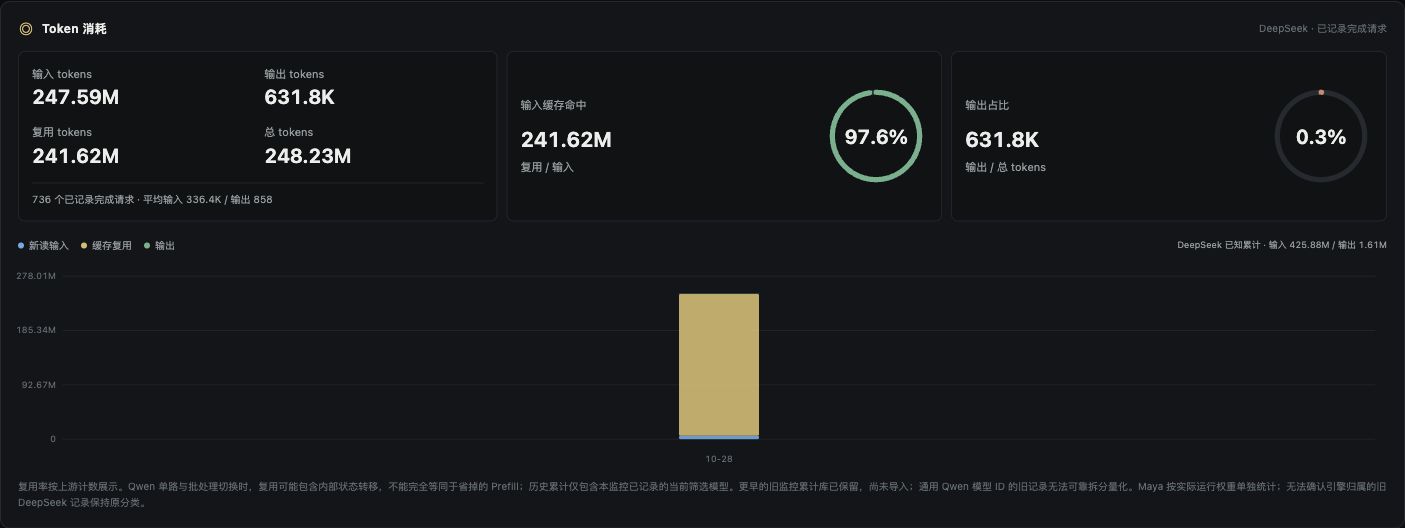
图 5:选中 2026 年 10 月 28 日、DeepSeek 分类的监控记录。截图时共记录 736 个完成请求,输入约 247.59M、复用约 241.62M、输出约 631.8K,输入复用率约 97.6%。这是该时间范围的累计,不能理解为单个会话有 2.47 亿上下文。
这里的复用是本地请求前缀或会话状态的复用,不是“别人问过相同问题,所以答案直接拿来用”。高命中主要意味着少算很多重复输入,已经存在的上下文仍然是模型上下文的一部分。
有意思的是,高缓存命中和刚才那条 26 万 token 全量重读可以同时发生。整体命中率看起来很好,并不代表每一条请求都能命中。会话切换、状态没有接上,仍然可能让首 token 等待突然变长。
现在我的自建监控会分开看实时 Decode、每条请求的 Prefill、首 token、lookup、DSpark、输入复用和硬件占用。只看一个大号 tok/s 数字,很容易看错。
还有几个不太光鲜的坑
开满显存不等于速度最大。 专家要占显存,Prefill 工作区、KV、临时缓冲也要占。把预留挤得很小,有时能多塞专家,也可能让工作区更紧张。我现在每卡预留 512 MiB,是这套本地版的配置记录,不是所有四卡机器都适合照抄。
写了 TP 参数不等于真的在张量并行。 我的 IQ2_XS 配置里曾经保留
--tp 2,但受量化分块限制,实际回落成按层分卡。专门适配的 TP=2/4 也试过,最终没留下来。当前这篇的单路成绩不能算成 TP=4 成绩。max 思考确实碰到过复读。 从重复 “I'll” 到反复规划同一件事,都遇到过。去审查方案、采样参数、客户端传参和引擎路径都排查过。我用官方服务时也见过类似情况,所以现在不会把所有复读都归因于量化或者某一个向量。分层编辑和防复读是当前的处理办法,仍然要看实际长任务表现。
新补丁不一定带来净收益。 有的方案数值验证没有过,就没有留下;有的 Prefill 快一点,但专家缓存少了,Decode 又慢一点。后来每次改动都会留独立版本、保存测速记录,当前版和上一版留着回退。
这套配置包含本地驱动和引擎适配,完整补丁还需要整理。下面的参数只是当前核心配置摘要,不是一个官方版复制过去就能复现全部功能的安装教程:
--max-context 1048576
--reserve-mib 512
--experts 6
--dspark auto
--dspark-conf 0.65
--suffix-draft 3
为什么我最后把它留作主力
真正让我决定留下 DeepSeek 的,是一次复杂 App 逆向任务。同样的任务和提示词,它把关键解密过程继续追了下去,拿到了后续分析需要的信息。那次结果对我工作有实际帮助,比我再看十张跑分表更有说服力。
这当然不能推出 IQ2_XS 等于 BF16,也不能推出它能包办所有项目。它仍会走弯路、会复读,需要人审结果。但在我自己的任务里,它已经能承担相当一部分工作。
所以现在的目标很实际:把这套单路继续用稳,保住长上下文缓存,再慢慢解决并发时 Prefill 对其他请求的影响。以后是否继续加卡,也要看这些真实任务能快多少,而不只是显存总数更好看。
折腾到现在,最满意的就是:家里这四张消费卡,确实跑起了一个我愿意每天交任务给它的 DeepSeek。
如果有同样用双路 EPYC、四卡或者 PCIe switch 跑 DeepSeek 的朋友,欢迎交流长提示 Prefill、会话复用和并发调度的实测。
项目和参考
- 推理引擎:Strata、Project Maya。
- 主权重:ISTA-DASLab DeepSeek-V4.1-Flash-1017 GSQ-RCO GGUF;配套文件:Unsloth GGUF 仓库。
- 本地适配参考了 Maya 的 #520 专家上传路径、#533 NUMA 上传修复、#540 lookup 草稿 和 #543 lookup 补充。
- 驱动方向也参考了 gpu-unlock-ada。
- 社区交流中参考过 7900 XTX 的 Strata 调优记录、消费级双卡的配置实测 和 DGX Spark 集群折腾记录。本文的硬件和性能数字均来自我自己的机器及记录,没有借用其他人的跑分。
记录日期:2026 年 10 月 28 日。
-
-
-

 ,先切450gb做網路磁碟機,剩下要試試看Kimi K3 Q4

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!
