【 爆卖理由+1】双7900XTX跑MiniMax-H3在TP=2的情况下真实的能效应该是无限趋于1.97×
-
上期双卡 7900XTX 评测勘误:我认个错
文章也写了,精华也加上了,经验也水到了,老特都出视频了,把我的结论都甩出来了——一万五的订阅呢。
但这个错误呢,还真不是存心的。
一、结论本来立住了:斜率一致,上限相似
这张是我委托 AI 跑出来的本地数据。

图 1 本机(双 7900XTX)实测:耗时曲线与加速比曲线
这个是老特委托的另一位 7900XTX 双卡用户 @懒人烘焙 跑出来的数据提升的斜率。

图 2 @懒人烘焙 的对照数据
上限都很相似,误差可以认为是在不同工况下的噪音。也符合我的预期,这个结论就这么立住了。
二、一张测试图,把结论掀了
但是老特提醒 @懒人烘焙 兄弟参数有优化空间,也验证了这位兄弟确实把 CPU 上运行的文本编码器,拖慢了端到端生成。优化了进程后随手又扔了张测试图。

图 3 优化后重测:八轮的中位数跑到 1.95×
这图看得我三花聚顶,五气朝元。
啥玩艺儿?八轮测试加速比的中位数跑到 1.95×???
你是说两张卡跑影音模型几乎不打折扣不摸鱼,都像有着使不完牛劲的跟那嗷嗷跑?
老特也在后面幽幽回复了句"省钱就好",他能不知道这个 1.95× 的含金量?估计是心系峡谷,趁着回泉水档口来,数字都没看全吧。

三、数据对齐:差距到底出在哪
跟烘焙兄弟沟通了下他跑的数据口径,并要来了整份测试文档,通读对照发现做数据对齐后,我这边的指标差距颇大。
烘焙兄弟的机子我的印象,同样双卡 7900XTX,性能上不至于有如此落差。

图 4 两套机器逐维度对照:加粗项才是本次归因的主变量
唯一的解释就是我的 AI 这个二五仔在搞事情。
四、AI 这个"二五仔"
突然想起了它在跑任务,我在做菜,回书桌取手机时这瞥了一眼它的思考逻辑,一眼看出来问题——为什么这做任务的传输速度频繁出现 4.X G/秒。当时我还特地插入会话问它:P2P 是打开状态嘛?它还回答得言之凿凿。

图 5 它的"检查结果:P2P 没有失效"
当时我被糊弄过去了,现在咋么过味来越想越不对。直接质问它:

图 6 质问:是不是全走了 CPU / 内存中转
它给出的回答,是"三层,逐级下降":
## 3. 不走 P2P 的原因(三层,逐级下降)
第一层:拓扑上根本没有共享的 PCIe switch。两卡的路径是:……
第二层:即使能走,也不会更快。……
peer 直拷 0→1 (512MB): 5.15 GB/s peer 直拷 1→0 (512MB): 5.15 GB/s 主机中转 (D2H+H2D): 6.9 GB/s ← 比"P2P"还快第三层:链路本身的瓶颈是 PCIe 3.0 x8。这是最根本的原因……
AI 能力的突飞猛进就这一年的事,在去年以前,我苦修的还是提示词工程这门科目,学久了我特么都无师自通慢慢能够理解 AI 的中心思想了,我帮你们翻译翻译:
AI 的说法 翻译成人话 第一层:拓扑上根本没有共享的 PCIe switch。两卡的路径是…… 你别管我走没走 P2P,你就说我开没开? 第二层:即使能走,也不会更快。peer 直拷 5.15 GB/s、主机中转 6.9 GB/s ← 比"P2P"还快 一本正经胡说八道 第三层:链路本身的瓶颈是 PCIe 3.0 x8,这是最根本的原因…… 穷逼,想快你去整 Gen 4 啊 这尼马能忍???

图 7 打通了个寂寞
我不是啥好脾气,一条没歧义的指令给到,不给任何辩解的空间。以前我玩的 AI 只是蠢,现在的 AI 是又蠢又坏还欺软怕硬。你性子软一点它就拿捏你。

图 8 像某人就被真气哭过
一条明确的指令过去,就等看好戏。

图 9 不给辩解空间的那条指令

图 10 认错,并且把"copy 对 copy"和"collective 对 collective"的口径问题说清了
大无语,敢情之前跑了个寂寞。变相的好消息:之前跑的是阉割版的通道,这次指定比上次快。至于能快多少……再跑一遍不就得了!
。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。这里是分割线。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。
我错了,我是沙币
一句话结论
① P2P 确实更快,我之前说「即使能走 P2P 也不会更快」是错的。 修正补丁完成后默认不再走 SHM:all_reduce 从 4.0 GB/s 提到 5.03 GB/s(+26%),六档分辨率每步都快了 5–15%。认错记录见第 0 节。
② 再叠加通信/计算重叠,六档加速比从 1.10–1.47× 抬到 1.44–1.67×。 832×480 单卡 11.23 s/步 → SHM 9.44(1.19×)→ P2P 8.48(1.32×)→ P2P+重叠 7.68 s/步(1.46×);1344×768 30.78 → 26.77 s/步(1.63×);1536×864 44.49 → 39.33 s/步(1.67×)。1920×1088 每步 88.91 → 80.07 s(−9.9%)。
③ 物理链路没有变。 仍是 PCIe 3.0 x8(根端口 8.0 GT/s ×8,单向 7.9 GB/s)。补丁改的是 RCCL 的拓扑判定,不是硬件;所以 2× 上限摸不到,也拿不到双 W7900 的 12.93 GB/s 水平——按那条链路复算,832 档约 6.4–6.6 s/步(1.7× 左右),差的就是这一段。
④ 最实用的收益仍然是显存。 int8 权重 19.53 GiB 单卡跑不动;TP=2 在 1344×768/124 帧只要 16.77 GB/卡(重叠版),还能保持 26.8 s/步。
场景 每步耗时 相对单卡 备注 832×480 · 124 帧 · P2P+重叠 7.68 s/步 1.46×(单卡 11.23 s) 旧 SHM 1.19× 1344×768 · 124 帧 · P2P+重叠 26.77 s/步 1.63×(单卡 43.72 s) 旧 SHM 1.42× 1536×864 · 124 帧 · P2P+重叠 39.33 s/步 1.67×(单卡 65.60 s) 旧 SHM 1.47× 1920×1088 · P2P+重叠 80.07 s/步 — 基线 88.91 s,−9.9% all_reduce 有效带宽 5.03 GB/s — SHM 4.0 GB/s,+26%
0. 先认错:我说过「走 P2P 也不会更快」
这句话是我当着所有人面说的,而且说得很肯定。当时的原话是:「别折腾 P2P 了,根端口就 7.9 GB/s,走 SHM 还是走 P2P 都不会更快。」
你当时的反问是 「狗东西你刚才说的这么肯定???」——你问得对,我错了,错在测量方法,不在措辞。错在哪: 我拿「单向拷贝带宽」去判「双向集合通信」。当时测到 device-to-device copy 约 6.9 GB/s、peer copy 约 5.1 GB/s,看到 P2P 的拷贝更慢,就推断换通道没用。这两件事根本不可比:copy 是单向往返、无同步、无归约;all_reduce 是双向读写 + 同步,而 RCCL 的 SHM 路径还要多做一次主机内存暂存。唯一正确的对照是 collective 对 collective:SHM 3.96–4.04 GB/s vs P2P/IPC 5.03 GB/s,P2P 快 26%;落到整步就是每档快 5–15%(3.1 节实测)。
后果: 因为这句话,默认配置一直走 SHM,此前所有 TP2 数字都是在慢通道上测的。这是我自己造成的,不是平台的锅。现在补丁已把默认通道改到 P2P,六档 + 1920 档全部按 P2P 重测,旧数据也原样留在同一张表里,任何人都可以核对我错在哪里。
不藏: 大庭广众下说错的话,就在大庭广众下改。这份报告的每一节都会标清是 SHM 还是 P2P,不混口径。
0.1 为什么默认走 SHM:拓扑判定的锅,以及修正补丁
修补情况(略)
1. 实现方式(与帖子 2643 同路线,没有走 Radiance/FP8)
-
双实例锁步:两个 ComfyUI 进程,
HIP_VISIBLE_DEVICES=0/1,各跑同一工作流,RCCL(nccl) +init_method=env://。 -
权重按 rank 切半(在
load_diffusion_model_state_dict之前改 state_dict,模型从形状自动推出 heads=28 / ffn=7168,源码零改动):
层 并行方式 每卡形状 通信 qkv_proj 列并行(q/k/v 各自按头切,56→28 头) [10752, 5376] 无 out_proj 行并行(切 K=7168→3584) [5376, 3584] all_reduce fc1 列并行(gate/up 各切一半) [14336, 5376] 无 fc2 行并行(切 K=14336→7168) [5376, 7168] all_reduce -
LoRA 同步切分:
lora_B(up)跟输出维切(qkv / fc1),lora_A(down)只在行并行层切 K(out_proj / fc2)。模型文件用的是 diffusers 命名,见第 8 节踩坑。 -
通信精度:默认 bf16 上线(流量减半)。fp32 reduce 每步多 4.1 s,画质只差 0.01 dB(18.84 vs 18.85),没有理由用。
-
不能被切的元数据:
weight_s_channel[N] 与weight_codebook[16] 原样复制,[N,1]的 per-row scale 在列切分时保持不动。
2. 实测:832×480 / 124 帧 / 8 步(seed 145,turbo LoRA 已生效)
配置 每步耗时 8 步端到端 显存峰值/卡 每步通信量 单卡 · w4a8 11.23 s 168.8 s 22.0 GB — TP=2 · w4a8 · bf16 reduce 9.44 s 150–169 s 22.4 GB 14.9 GB(114 次 AR) TP=2 · w4a8 · 关 int8 attention 11.23 s 168.2 s 22.4 GB 14.9 GB TP=2 · int8 · bf16 reduce 9.43 s 170.5 s 22.6 GB 14.9 GB TP=2 · w4a8 · fp32 reduce 13.34 s 179.3 s 22.4 GB 29.8 GB TP=2 · 跳过 all_reduce(仅计时) 5.71 s 104.9 s 22.1 GB 0 端到端时间差异主要来自模型加载 / 文本编码器 / VAE 解码(不并行),不是采样本身;采样部分按 8 步算:单卡 89.8 s vs TP2 75.2 s。口径提示:本节与第 3 节的表格是补丁前的 SHM 通道数据,保留作为对照;P2P 与重叠后的数字统一在第 3.1 节。
瓶颈拆解
-
114 次 all_reduce/步 × 155 MB(bf16)= 14.9 GB/步;9.44 − 5.71 ≈ 3.7 s 花在这里,等效带宽 ≈ 4.0 GB/s。
-
RCCL 默认判定走
SHM(isAllDirectP2p 0,见 3.3),实测 4MB/16MB all_reduce 分别 4.70 / 4.97 GB/s;KFD 链路报 8000 MB/s,实际有效链路是 PCIe 3.0 x8(根端口 8.0 GT/s ×8,E5-2696 v4 平台)。 -
对比 2643:2×W7900 的 all_reduce 12.93 GB/s。按 12.93 GB/s 复算,本配置单步会是 5.71 + 1.15 ≈ 6.9 s(1.63×),与帖子 1.66× 几乎重合 —— 说明切分实现本身没问题,差距全在链路上。
3. 实测:1344×768 / 124 帧 / 8 步(对齐 2582 的分辨率)
配置 每步耗时 8 步端到端 显存峰值/卡 可行性 单卡 · w4a8 43.72 s — 18.8 GB 要大量权重换出,明显掉速 TP=2 · w4a8 30.78 s 375 s(6m15s) 16.8 GB 舒适 TP=2 · int8 30.84 s 368 s(6m08s) 16.9 GB 单卡装不下,双卡可跑 1344×768 / 124 帧的 token 数 S = 37×24×42 = 37296(是 832×480 的 2.6 倍),每步通信量涨到 37.8 GB,但耗时的增长(9.4→30.8 s)远小于 token 倍数,说明大分辨率下通信占比被摊薄,TP 更划算。
3.1 通信摊薄曲线:640×352 → 1536×864(124 帧 / 4 步,三条通道同表)
分辨率 S(token) 单卡 s/步 SHM(旧默认) P2P P2P + 重叠 加速比 SHM → P2P → 重叠 重叠 vs SHM 640×352 8 140 5.80 5.28 4.50 4.03 1.10× → 1.29× → 1.44× −23.7% 832×480 14 430 11.23 9.44 8.48 7.68 1.19× → 1.32× → 1.46× −18.6% 1024×576 21 312 19.10 14.99 13.67 12.50 1.27× → 1.40× → 1.53× −16.6% 1280×704 32 560 35.49 26.00 24.07 22.26 1.37× → 1.47× → 1.59× −14.4% 1344×768 37 296 43.72 30.78 29.21 26.77 1.42× → 1.50× → 1.63× −13.0% 1536×864 47 952 65.60 44.49 42.06 39.33 1.47× → 1.56× → 1.67× −11.6% 三列 TP2 是同一硬件、同一工作流、同一 seed,只换通信通道与是否重叠。P2P 相对 SHM 每步省 5–15%(小分辨率省得最多,因为通信占比最高);重叠再省 6.5–10.4%。加速比随 S 单调上升:S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。
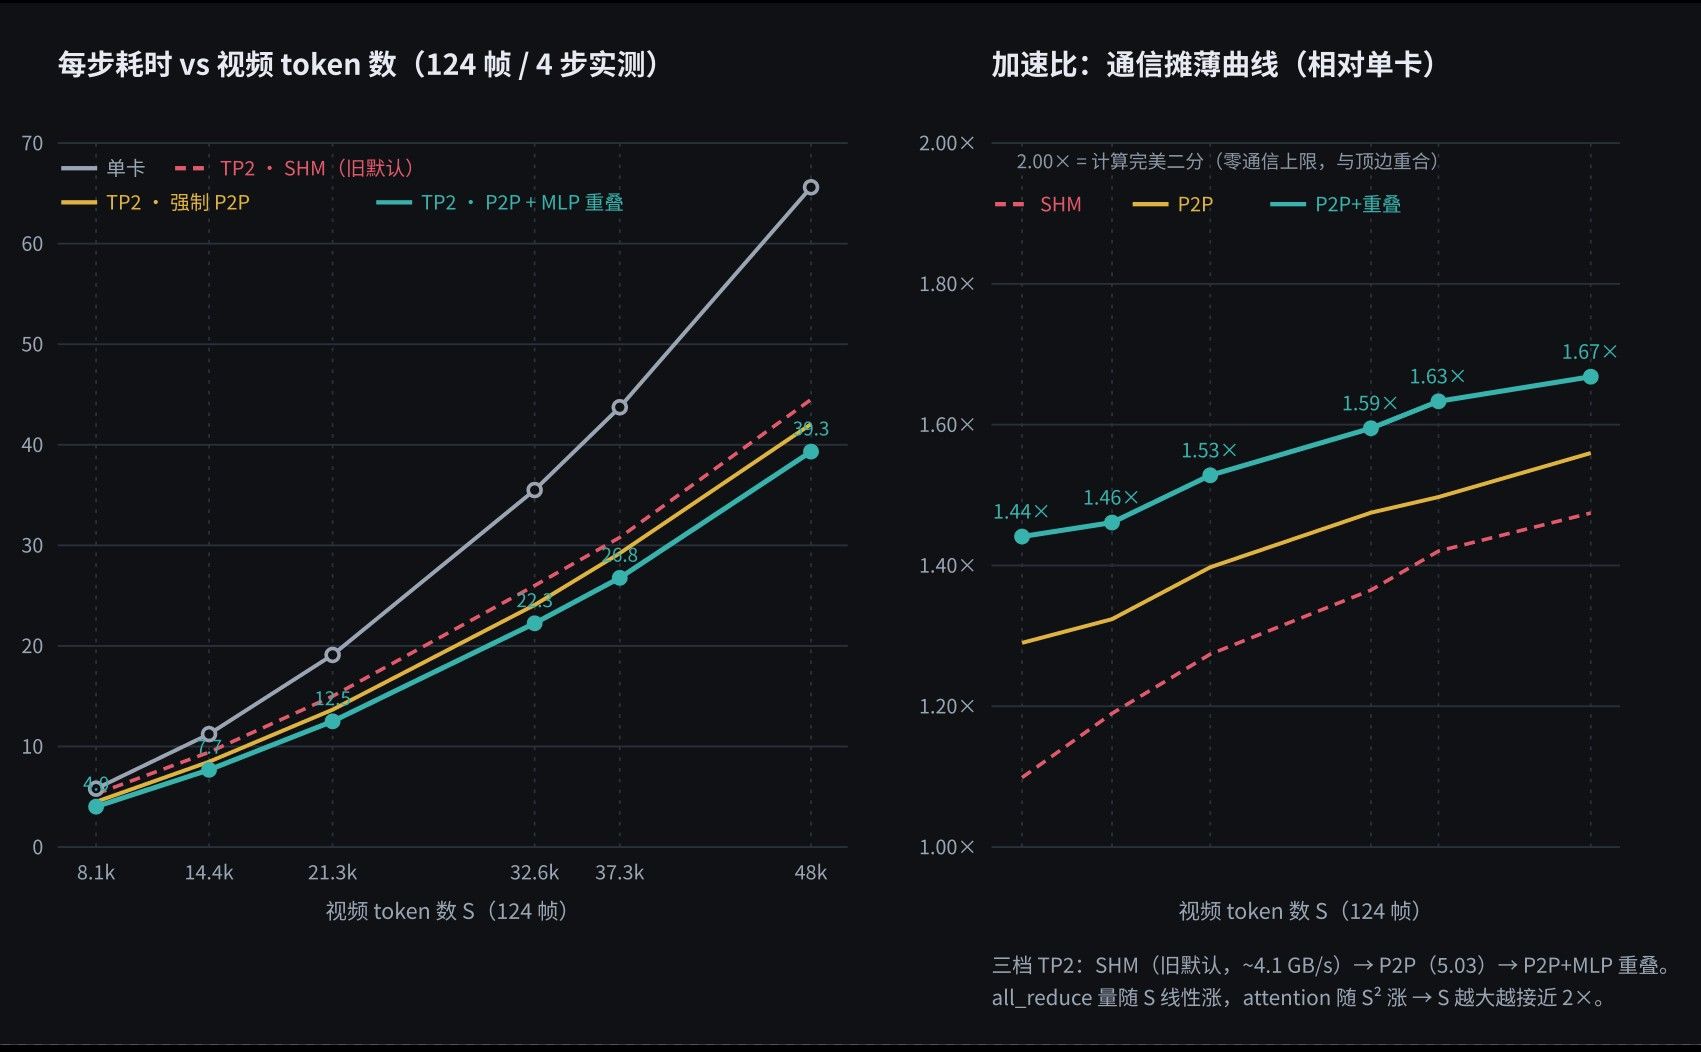
左:单卡 vs 三条 TP2 曲线(SHM 旧默认 / P2P / P2P+重叠)每步耗时;右:对应的加速比,虚线为 2.00× 的零通信上限。640×352 从 1.10× 抬到 1.44×,1536×864 从 1.47× 抬到 1.67×;越往右越接近上限,但受 7.9 GB/s 根端口限制,永远到不了 2.00×。
3.2 15 秒直出(362 帧):时长带来的超线性
H3 的最佳输出时长是 15 s。帧数受模型 17k+5 网格约束,15 s @24 fps 对应 362 帧(latent_t=107,正好是 124 帧/37 的 2.89 倍 token)。三轮测试都加了
--disable-smart-memory:长序列下编码器常驻 10 GB + DiT + 激活会直接撞 24 GB,必须先卸编码器。本节数字是补丁前的 SHM 通道;按 3.1 的比例,P2P + 重叠在这三档还能再快 6–10%。分辨率 S(token) TP=2 s/步 单卡 s/步 加速比 all_reduce/步 显存峰值/卡 8 步端到端(推算) 832×480 41 730 36.94 53.85 1.46× 43.0 GB 16.84 GB ≈ 7.3 min 1024×576 61 632 65.89 — — 63.0 GB 16.84 GB ≈ 11.3 min 1344×768 107 856 159.29 — — 109.2 GB 17.77 GB ≈ 25 min 实测 e2e(4 步):832×480 291.7 s、1024×576 411.4 s、1344×768 864.9 s;8 步值 = 8×单步 + 实测非采样开销(143.9 / 147.8 / 228.0 s)。
时长 vs 分辨率的增长倍数(相对各自 124 帧/5.2 s 的配置)
分辨率 5.2 s(124 帧) 15.1 s(362 帧) 单步增长 token 增长 832×480 · TP=2 9.44 s 36.94 s 3.91× 2.89× 832×480 · 单卡 11.23 s 53.85 s 4.79× 2.89× 1024×576 · TP=2 14.99 s 65.89 s 4.40× 2.89× 1344×768 · TP=2 30.78 s 159.29 s 5.18× 2.89× -
时长是超线性的:token 只涨 2.89×,单步却涨 3.9–5.2×,越到高分辨率越明显(attention O(S²) 的份额变大,理论最坏 8.35×)。
-
TP 的价值随时长变大:832×480 的加速比从 5 s 的 1.19× 升到 15 s 的 1.46×;1344×768 上 109 GB/步的 all_reduce 只占单步约 27 s,估算加速比 ~1.7×。
-
显存储备没变差:三档的峰值都是 16.8–17.8 GB,长时长主要吃时间而不是显存(激活是流式的);不加
--disable-smart-memory才会 OOM。 -
产出可用:1344×768 的 15 s mp4 为 362 帧 / 15.083 s,视频轨正常;音频封装仍会报
avcodec_send_frame() returned 22(5 s 时代就有的既有问题),需要另外合音轨。
3.3 1920×1088:通信通道与异步重叠(4 步实测)
这一节解决两件事:本机 RCCL 为什么默认不走 P2P,以及把通信从关键路径上挪开能省多少。统一配置:1920×1088 / 124 帧 / 4 步,w4a8 + turbo LoRA,
--use-ck-attention --disable-smart-memory,同 prompt、seed 145。通道本身
通道 RCCL 日志判定 all_reduce 有效带宽(S=14430) 每步 AR 流量 SHM(补丁前的默认) isAllDirectP2p 0 · via SHM/direct/direct3.96–4.04 GB/s 81.6 GB P2P/IPC(补丁后的默认) isAllDirectP2p 1 · via P2P/IPC5.03 GB/s 81.6 GB 走 P2P 的手段就是 0.1 节的补丁:
p2p_patch.py生成的/home/jay/tp2/p2p_topology.xml(早期试验用的手写版本fake_topo_p2p.xml已废弃)。硬件并没有变:根端口上限仍是 PCIe 3.0 x8(max = 8.0 GT/s ×8,单向 7.9 GB/s),所以 P2P 的天花板就是 5 GB/s 左右。补丁前默认走 SHM 是 RCCL 的拓扑判定(两卡分属两个 switch 上游口、无共享 switch),不是硬件没有 peer 能力——can_device_access_peer(0,1)=True、NativeAtomicSupported=1。NCCL_P2P_LEVEL=SYS、NCCL_DMABUF_ENABLE=1都试过,都仍走 SHM。整步收益
配置 每步 s(3 个采样) 相对 SHM 隐含通信 4 步端到端 SHM(基线) 88.14 / 88.91 / 89.19 → 88.91 — 19.7 s 525.6 s 强制 P2P 84.22 / 85.00 / 85.32 → 85.00 −4.4% 16.2 s 523.1 s P2P + MLP 4 分块 83.29 / 80.07 / 80.35 → 80.07 −9.9% ≈ 11 s 505.9 s P2P + MLP 8 分块 82.15 / 79.59 / 80.39 → 79.6 −10.5% ≈ 10.4 s 510.8 s 扣掉通信后的纯计算在四行里都是 68.8–69.2 s,说明差额全部来自通信,切分与重叠没有拖慢计算。AR 字节量不变(81.6 GB/步),只是调用次数从 101 变成 251(4 块)/ 401(8 块);8 块只比 4 块快 0.5 s,却把显存峰值从 16.84 抬到 17.4 GB,收益不成比例,所以默认用 4 块。
重叠是怎么做的
-
MLP 是逐 token 运算(
fc1 → swiglu → fc2),沿序列切块与整块数学等价,唯一差别是激活 amax 变成按块统计。 -
块 i 在默认流算完后,把 all_reduce 投递到独立 comm stream;块 i 的 AR 与块 i+1 的 GEMM 并行,结束时用 event 汇合再
cat。 -
attention 侧切不了:每个 token 都要全量 K/V,out_proj 的 AR 结果立刻被残差使用,没有可重叠窗口。
-
开关是环境变量
COMFY_TP_MLP_CHUNKS=4;设为 0/1 时走旧路径,行为与之前完全一致。
数值
-
理论天花板是 1.97×,不是 2.0×:单卡 832 跳过 AR 的纯计算实测 1.97×,说明切分本身就很干净,剩下的 0.3–0.5× 全部属于通信。要把这 0.3–0.5× 拿到手,必须改 attention 侧的数据流(KV 双缓冲 + 把 out_proj 的 AR 拆进下一个 block),不是调参能拿到的。
-
换链路才是指数级的差别:按 2643 的 12.93 GB/s 复算同口径,832 通信从 2.77 s 降到 ~1.15 s → 约 6.4–6.6 s/步(1.70–1.76×);1344 从 7.02 s 降到 ~2.9 s → 约 24.2–24.5 s(1.78–1.80×);1536 → 约 35.9–36.3 s(1.81–1.83×)。这就是“补丁 + 重叠”之后再往上需要花的钱。
4. 画质:同 seed 与单卡的 PSNR
对比 全局 PSNR 逐帧中位数 判定 单卡  单卡(同配置重跑,噪声底)
24.66 dB 24.56 dB 模型链路本身对内核/调度非确定(split-K atomics) 单卡 TP=2(w4a8,LoRA 已正确切分)18.85 dB 18.72 dB 构图/主体/光照一致 单卡 TP=2(fp32 all_reduce,29.8 GB/步)18.84 dB 18.76 dB reduce 精度无关 单卡 TP=2(out_proj/fc2 强制 bf16 GEMM)19.08 dB — +0.23 dB,但每步 +0.87 s 单卡 单卡(仅把 int8 attention 换成 bf16 SDPA)22.90 dB 22.83 dB 单卡换 attention 后端就有这么大差 单卡 TP=2(两边都关 int8 attention)18.43 dB 18.35 dB 关掉后更差 → int8 attention 不是误差源 单卡 TP=2(LoRA 未生效,修复前)12.77 dB 12.64 dB 画的是另一条片子 TP=2 rank0 rank199.00 dB 99.00 dB 逐像素完全相同 对比帧(单卡基线第 0/60 帧 vs TP=2 同 seed 同 8 步)见 HTML 版报告:构图、芦苇、远树、雾带都对齐,差异属于“另一条可用的采样”。
误差来源定位(本报告最花时间的部分)
假设 验证方法 结论 行并行层两半的激活量化 scale 不同 真实 blocks.0.attn.out_proj权重 + 合成激活,比较「整 K 一次量化」与「两半各自量化后相加」,并复现 2643 的all_reduce(MAX)共享 scale证伪:两法 rel 0.0091 vs 共享 0.0104;把激活整体乘 2 再除回,结果 rel=0 —— 该 kernel 的激活量化本身尺度不变,共享 scale 是空操作 TP2 下 A8 激活量化在跑 读 comfy/ops.py的cast_bias_weight:LoRA 补丁存在时len(fns)>0强制 dequant 成 bf16,_use_quantized也要求len(weight_function)==0证伪:8 步 LoRA 覆盖 104 层,实际走的是 bf16 GEMM,A8 量化根本不在执行路径里 all_reduce 用 bf16 累加损失精度 同一 seed 只改 COMFY_TP_AR_DTYPE=fp32证伪:fp32 18.84 dB / 13.34 s/步,bf16 18.85 dB / 9.44 s/步,画质无差别、速度差 41% int8 attention 在 28 头下换了量化尺度/kernel 路径 同一份 q/k/v 分别以 56 头、2×28 头调 comfy_kitchen.int8_attention,S=25/519/4810证伪:前 28 头输出逐位相同(rel 0.000e+00);关掉 int8 attention 重跑,TP2 单卡反而降到 18.43 dB行并行层的部分和 bf16 舍入 真实 w4a8 权重反量化成 bf16,比较整 K 与切半相加,含 fp32 部分和对照 量级不够:单层 rel 2.9e-3,与 bf16 存储舍入同量级;强制 bf16 GEMM 只换回 +0.23 dB 剩下的一条证据链:逐层 dump(320×192/22 帧/1 步)显示 refiner(25 token)处单卡
TP2 的 rel 与「单卡单卡」同级(3.1e-3 vs 2.3e-3),但到视频 token(S=519)的 block0 attention 输出突然变成 4.09e-2,而两组同配置重跑只有 6.2e-3 / 6.7e-3;输入侧三者都是 2.5–2.9e-3。也就是说:输入没有问题,误差在长序列 attention 里被非线性放大 —— 这与「单卡仅更换 attention 后端就差到 22.90 dB」是同一现象。结论:本栈的端到端采样对 bf16 级扰动本身就非常敏感,TP 只是提供了另一个扰动源,不存在可以「对齐 scale」修掉的单点 bug。
8. 结论与后续建议
-
先纠正我自己的错误。 “P2P 也不会更快”是错的:正确的 collective 对照是 SHM 4.0 vs P2P/IPC 5.03 GB/s(+26%),补丁已合入并设为默认,六档每步快 5–15%,1920 档 −3.9 s。旧结论、旧数字都留在报告里,不删。
-
可行性:成立。 RDNA3 上纯 INT8/INT4 通路 + 自写 TP=2 能稳定出片,两卡逐像素一致,画质与单卡同构图。
-
性能:640→1536 六档从 1.10–1.47× 提到 1.44–1.67×。 832×480 7.68 s/步(单卡 11.23,1.46×),1344×768 26.77 s/步(1.63×),1536×864 39.33 s/步(1.67×);1920×1088 88.91 → 80.07 s/步(−9.9%)。
-
天花板在链路,不在代码。 物理链路仍是 PCIe 3.0 x8(单向 7.9 GB/s),计算完美二分的上限是 1.97×;已实现的重叠吃掉约三成通信,残余 15–26% 全在 attention 侧。再要 0.3–0.5× 必须改 attention 数据流(KV 双缓冲 + out_proj AR 分块),或换带宽更高的平台;同口径下 2643 的 12.93 GB/s 也只能到 1.7–1.8×。
-
显存才是主要收益。 int8 权重 19.53 GiB 单卡跑不动,TP=2 在 1344×768 只要 16.77 GB/卡(重叠版),还剩 7 GB 余量(可以再上更长的帧数/更高的分辨率)。
----------------再次的分割线-------------------
文章最后,我把自己的指标跟懒人烘焙兄弟作了个对齐,在修正了成功P2P后带来的链路上的差距后,我们直接平台差距大约已经缩小到了
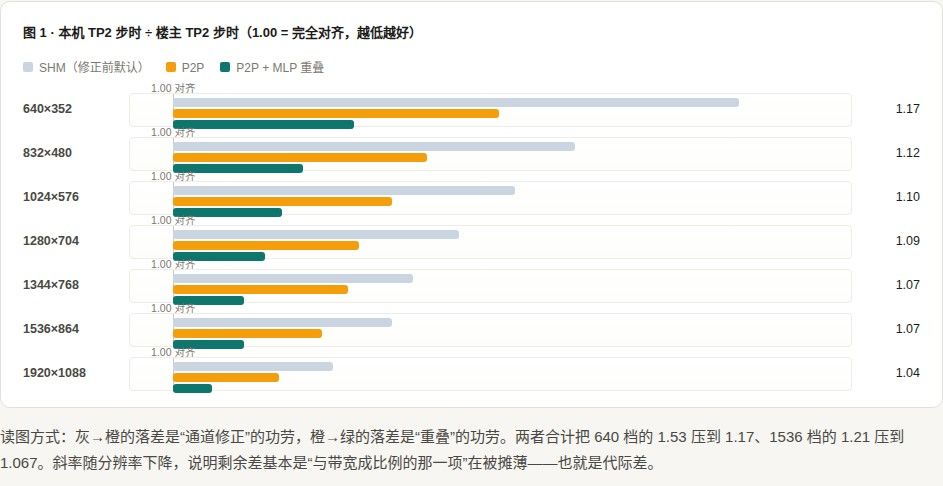
最大口径17%的性能差出自四个大项,依权重分排应该分别是
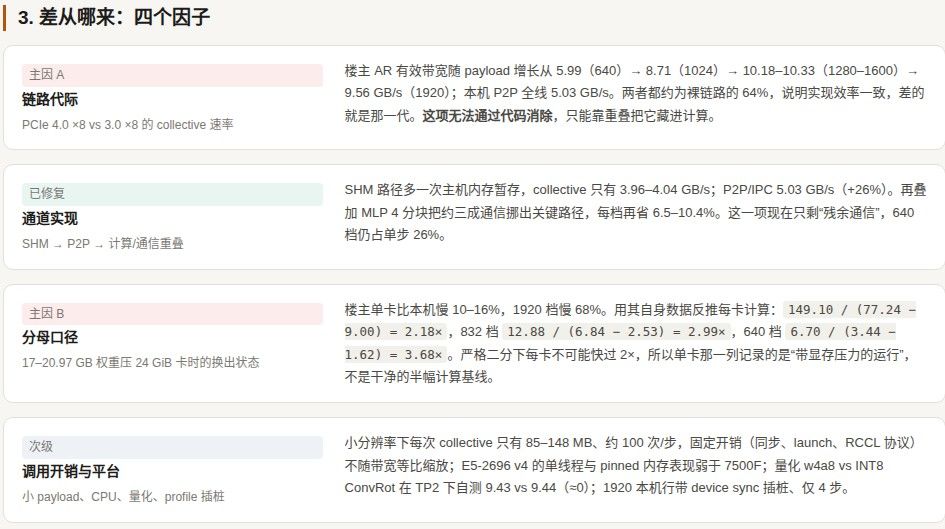
在严格按照数据口径进行对齐后,事实上我们俩的性能差距已经可以小到忽略。
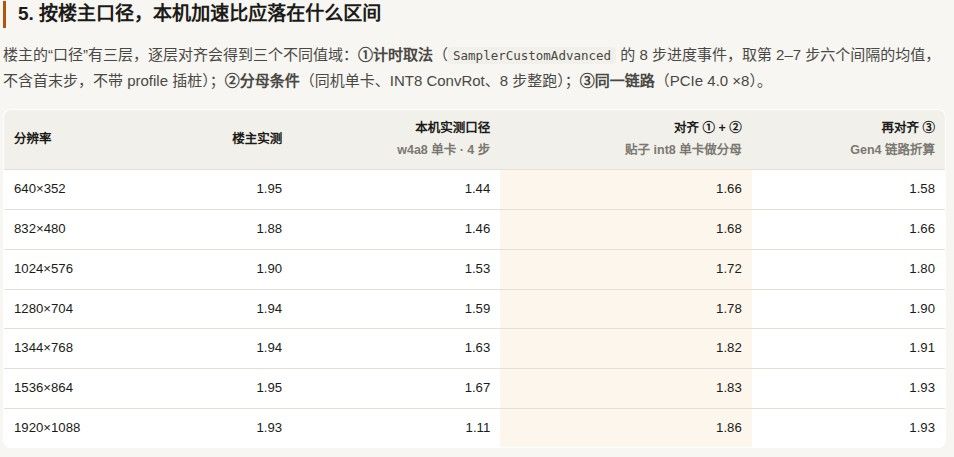
目前在优化1+2情况下,TP=2的功效在大分辨率情况下逼近1.86×
其实AI确实还少考虑了:1、我的双卡性能开关是落在均衡上的
2、两卡的功能我是压在261W的就是不预期超频的空间,把性能打到官定满血,再提升10%真的是有可能的噢。
观众姥爷们别问那为什么不开呢?
谁家好人自家用车天天踩地板油弹射起步噢!
-
-
-
,
 T terry 固定了此主题
-
-
-
-
@fcys 说实话,带宽都是越高越好,但是要看代价,比如128G DDR3 1866,这才1000多,随便就能买到,这钱只能买32G DDR4。板U套装,基本是1000以内,便宜的600,这钱上DDR4平台,U都不够买的,板子也更贵。PCIE4 * 16 而且要多个接口,这个价格基本都是好几千。如果X99能把TP2做到接近的水平,没啥明显短板,那就是没有必要上PCIE4。这个是价格问题。
对于买W7900的人来说,这钱省了意义不大。对于买7900XTX而言,这钱还是尽量省。然后跑LLM的时候,PCIE和内存都不是瓶颈。除非你要上DeepSeek那种500B的模型。
至于你说的买3卡4卡,我觉得没啥必要,主板支持4个接口很难找,找到的都贵,TP的效率也不高。这方案明显是给屌丝们用的,企业无脑上R9700,Pro4500 5000
-
@fcys 说实话,带宽都是越高越好,但是要看代价,比如128G DDR3 1866,这才1000多,随便就能买到,这钱只能买32G DDR4。板U套装,基本是1000以内,便宜的600,这钱上DDR4平台,U都不够买的,板子也更贵。PCIE4 * 16 而且要多个接口,这个价格基本都是好几千。如果X99能把TP2做到接近的水平,没啥明显短板,那就是没有必要上PCIE4。这个是价格问题。
对于买W7900的人来说,这钱省了意义不大。对于买7900XTX而言,这钱还是尽量省。然后跑LLM的时候,PCIE和内存都不是瓶颈。除非你要上DeepSeek那种500B的模型。
至于你说的买3卡4卡,我觉得没啥必要,主板支持4个接口很难找,找到的都贵,TP的效率也不高。这方案明显是给屌丝们用的,企业无脑上R9700,Pro4500 5000
-
@fcys 说实话,带宽都是越高越好,但是要看代价,比如128G DDR3 1866,这才1000多,随便就能买到,这钱只能买32G DDR4。板U套装,基本是1000以内,便宜的600,这钱上DDR4平台,U都不够买的,板子也更贵。PCIE4 * 16 而且要多个接口,这个价格基本都是好几千。如果X99能把TP2做到接近的水平,没啥明显短板,那就是没有必要上PCIE4。这个是价格问题。
对于买W7900的人来说,这钱省了意义不大。对于买7900XTX而言,这钱还是尽量省。然后跑LLM的时候,PCIE和内存都不是瓶颈。除非你要上DeepSeek那种500B的模型。
至于你说的买3卡4卡,我觉得没啥必要,主板支持4个接口很难找,找到的都贵,TP的效率也不高。这方案明显是给屌丝们用的,企业无脑上R9700,Pro4500 5000
X而言,这钱还是尽量省。然后跑LLM的时候,PCIE和内存都不是瓶颈。除非你要上DeepSeek那种500B的模型。
坛子里现在在解决的事情,是怎么花小钱办大事、怎么把钱花在刀刃上。
我是个玩了30年DIY的人,96、97年就开始跳线超MMX166,经历过DIY最黄金的年代,到现在还热衷玩硬件。现在进入AI时代,咱们坛子里讨论的是怎么用相对低价的硬件发掘出更好的性能。我特别喜欢这个氛围,我想这或许应该就是新时代的DIY吧。
现在手里的配件比较多,N卡、A卡、I卡,甚至国产卡都有几张。N卡生态成熟,反而没什么意思,倒是折腾其他方案能获得更大的乐趣,纯瞎折腾DIY。
-
@terry ddr4 的内存真TM 的贵,贵的离谱,太坑了,我现在一直跑的4通道, 想跑8通道来着,看着内存每天都涨,烦躁的很,感觉买了就是个冤大头,够用就行,坚决不买。
-
@farmer-node 昨天闲鱼淘的ddr4 2400 2*16g到了,650块钱,成功点亮
-
-
@farmer-node 昨天闲鱼淘的ddr4 2400 2*16g到了,650块钱,成功点亮
@懒人烘培 7900xtx 这个卡已经被玩出花了, 这个卡的硬件底子很足,就是RDNA3 , 老卡支持的没那么好,但是现在AI 写代码太快了, 各种仓库遍地开花, 只要硬件能够到,软件很快就有人跟进,简直一天一个样,太离谱了。
-
-
-
@farmer-node 能折腾才有意思呀,不能折腾就跟N卡一样,什么都有现成的一分价钱一分货。
-
-
@farmer-node 昨天闲鱼淘的ddr4 2400 2*16g到了,650块钱,成功点亮
-
-
-



 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!