
DeepSeek-V4.1-Flash-1017 在 RX 7900 XTX 上跑通:decode 23 tok/s、prefill 480 tok/s
-
-
-
-
-
-
-
strata的思路仍然可用,但实在太。。。大了
-
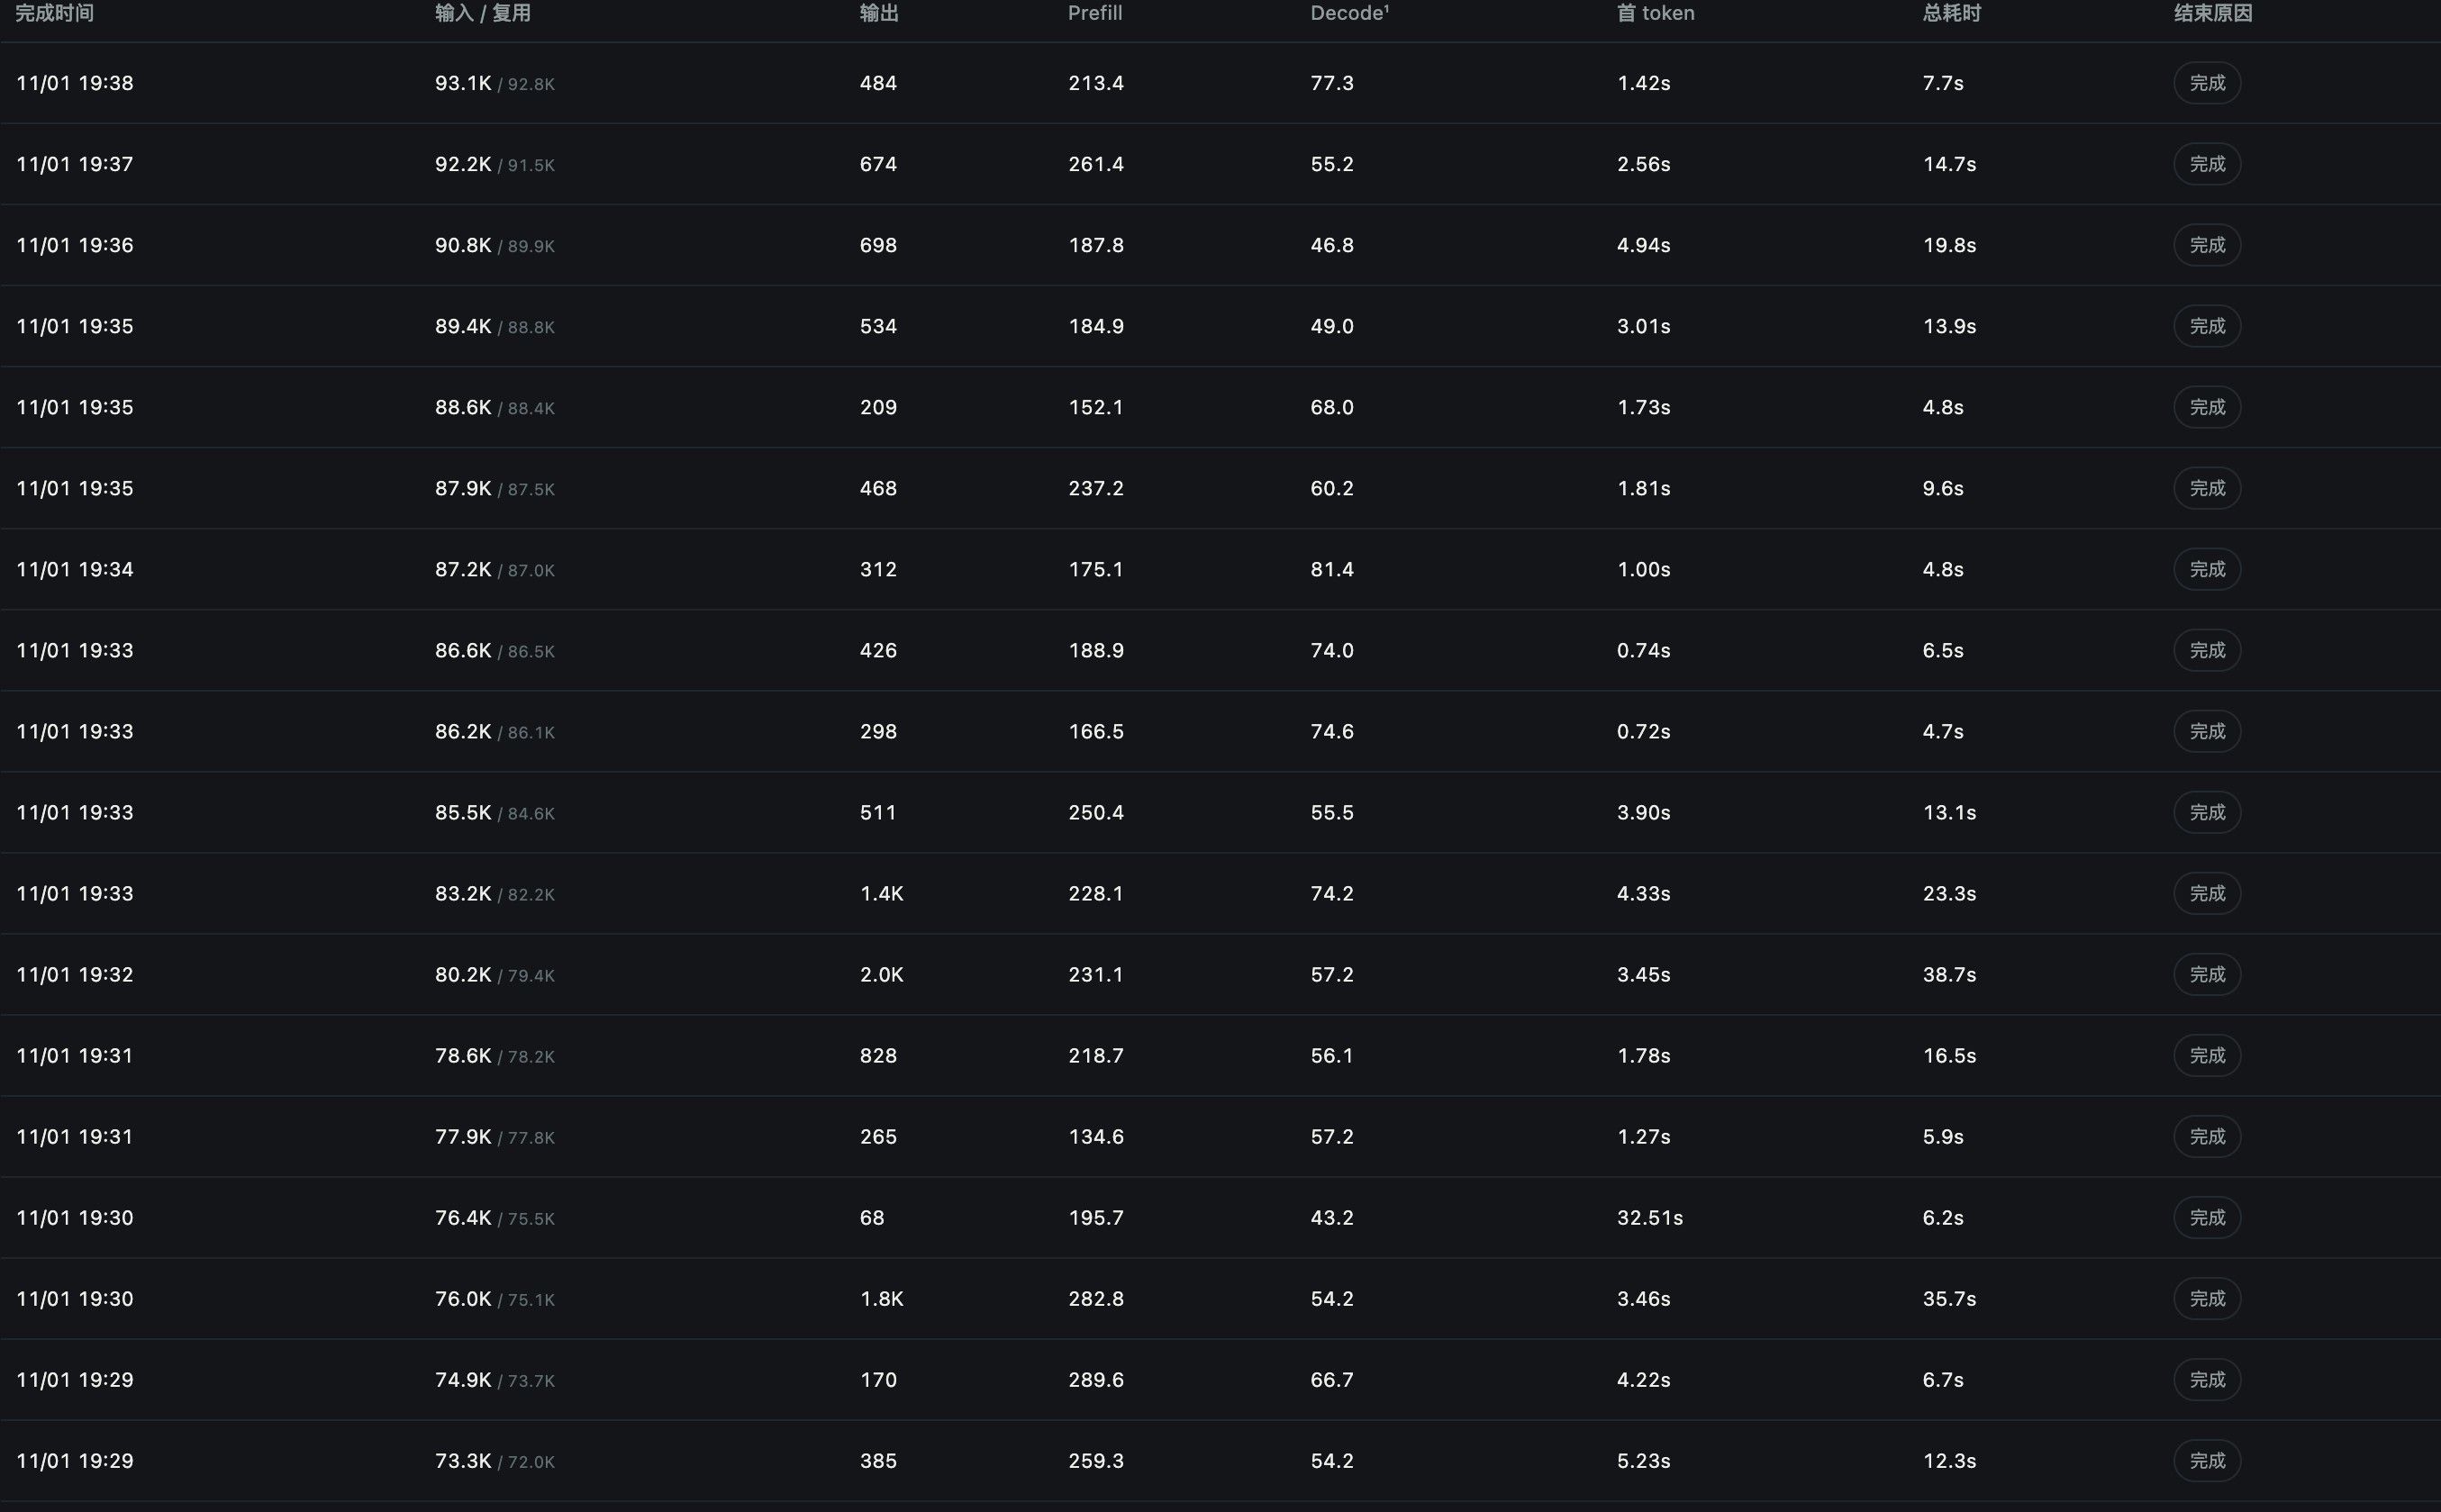
应该还有优化空间,可以让ai缝合maya的功能,我是iq2-xs 模型能力上来说看每个人的需求了,对我来说,qfn-unslot的q_80也用过,但是比对下来,iq2-xs的能力更符合我的预期,目前我decoed 峰值能到100+ t/s 平均稳定在60-70 Prefill 能到2500+ 很够用了
-
DeepSeek-V4.1-Flash-1017 在 RX 7900 XTX 上跑通:decode 23 tok/s、prefill 480 tok/s
DeepSeek-V4.1-Flash-1017(552B MoE + 196B Engram)已经在单张 / 两张 RX 7900 XTX(gfx1100,ROCm/HIP) 上跑通,引擎、配置和全部实测数字都公开在
vincalkr/Strata-DSV4.1(MIT)。这是目前看到的、在 RDNA3 上跑这个模型最完整的一份公开记录。方案本体(只列它自己的事实)
- 引擎:
ds41e,C++/HIP,自带 OpenAI / Anthropic 兼容 server、web chat 和 monitor - 模型:ISTA-DASLab 的 GSQ-RCO IQ2_XXS 包(IQ2_XXS / IQ2_XS / IQ1_M 专家,四分片共 138.2 GB)+ Engram IQ4_NL 111 GB
- 专家分三层放:卡0 显存 → 第二张卡 → 80 GiB 固定 RAM arena → NVMe 按需读
- 精确路由:路由到的专家无论落在哪一层都真算,不做 route bias、不丢专家
- 质量校验(Lucebox 8×1024 token):ppl 10.37(用 checkpoint 的 FP8 Engram 行)/ 10.33(用包内 iq4_nl 表),两者 KL 0.026;原版 FP8 checkpoint 自己是 8.56
实测成绩
测试平台:2×RX 7900 XTX、Ryzen 9 9900X、122 GiB RAM、PCIe 5.0 NVMe、ROCm 7.14,默认配置 + power-tune,一次性跑 3 次。
项目 结果 decode(300 token) 23.2–23.7 tok/s decode @ 17K 上下文(128 token) 18.4–19.2 tok/s prefill 8K / 17K / 25.5K(从零开始) 371–414 / 433–459 / 458–484 tok/s 编码 agent 会话(120–190K 上下文) 16–20 tok/s 同一会话续聊的恢复时间 0.6–10.5 s 仓库自己列的硬件门槛
项目 要求 内存 128 GB 级(80 GiB 做专家 arena,引擎常驻约 94 GB) 磁盘 约 350 GB NVMe(138 GB 包 + 111 GB Engram + 0.9 GiB 图像编码器) 显卡 gfx1100(7900 XT / XTX),第二张 24 GB 卡当专家层 软件 Linux + ROCm(hipcc)+ cmake >= 3.24同期其他路线(对照用)
lxe/dsx:552B MoE + 196B Engram 跑 2×3090 + 128 GB RAM,Rust + CUDA、T16 量化 + expert deferral + FP8 投影,报 40+ tok/s- llama.cpp fork:单张 5090(31.8 GiB)+ 125.7 GiB RAM 也能跑,HF 讨论区 #37 有完整报告和数字
- vLLM PR #56214 正在加这个模型的支持(但 gfx1100 没有 FP8 矩阵单元,官方 FP8 权重那条路在 RDNA3 上不成立)
链接
- 仓库:https://github.com/vincalkr/Strata-DSV4.1
- 量化包:https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
- 实测与配置:仓库内
docs/ds4/V41_EXACT_FAST.md;HIP 移植笔记docs/ds4/AMD_HIP_NOTES.md - 3090 路线:https://github.com/lxe/dsx
- 单卡 5090 + 大内存的 llama.cpp fork 报告:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/discussions/37
- 引擎:
-
-
@Enigma 其实我在3090上早就跑起来了, 也是 20多t/s ,但是 2比特量化, 还是个 XXs, 实在是不敢用啊, 有人做过测试, 连最基本的历史事实都会说错的。。。

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!




 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!