跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. DeepSeek-V4.1-Flash-1017 在 RX 7900 XTX 上跑通:decode 23 tok/s、prefill 480 tok/s

DeepSeek-V4.1-Flash-1017 在 RX 7900 XTX 上跑通:decode 23 tok/s、prefill 480 tok/s

已定时 已固定 已锁定 已移动 热议 优秀 LLM讨论区
7900xtxdeepseek本地模型
13 帖子 10 发布者 732 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • terryT
    terryT
    terry
    易有太极
    编写于 最后由 编辑
    #4

    量化有点严重了,可以测试下双卡方案如何,有没有生产力很难讲。

    油管:https://www.youtube.com/@抡锤者

    J Z 0J 1 条回复 最后回复
    0
    • xiaopbroX
      xiaopbroX
      xiaopbro
      体面乡绅 硕果累累
      编写于 最后由 编辑
      #5

      速度太慢,量化精度也太低,还需要继续优化啊

      1 条回复 最后回复
      0
      • terryT terry

        量化有点严重了,可以测试下双卡方案如何,有没有生产力很难讲。

        J Z 0J
        J Z 0J
        J Z 0
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #6

        @terry 看帖不够仔细,已经是双卡了哦

        1 条回复 最后回复
        0
        • 懒人烘培懒
          懒人烘培懒
          懒人烘培
          王侯将相
          编写于 最后由 编辑
          #7

          确实不错跑起来了,就是速度不理想,应该还可以继续优化

          双 7900 XTX:模型本地跑,Token 随便烧!

          1 条回复 最后回复
          0
          • M
            M
            muskelon
            编写于 最后由 编辑
            #8

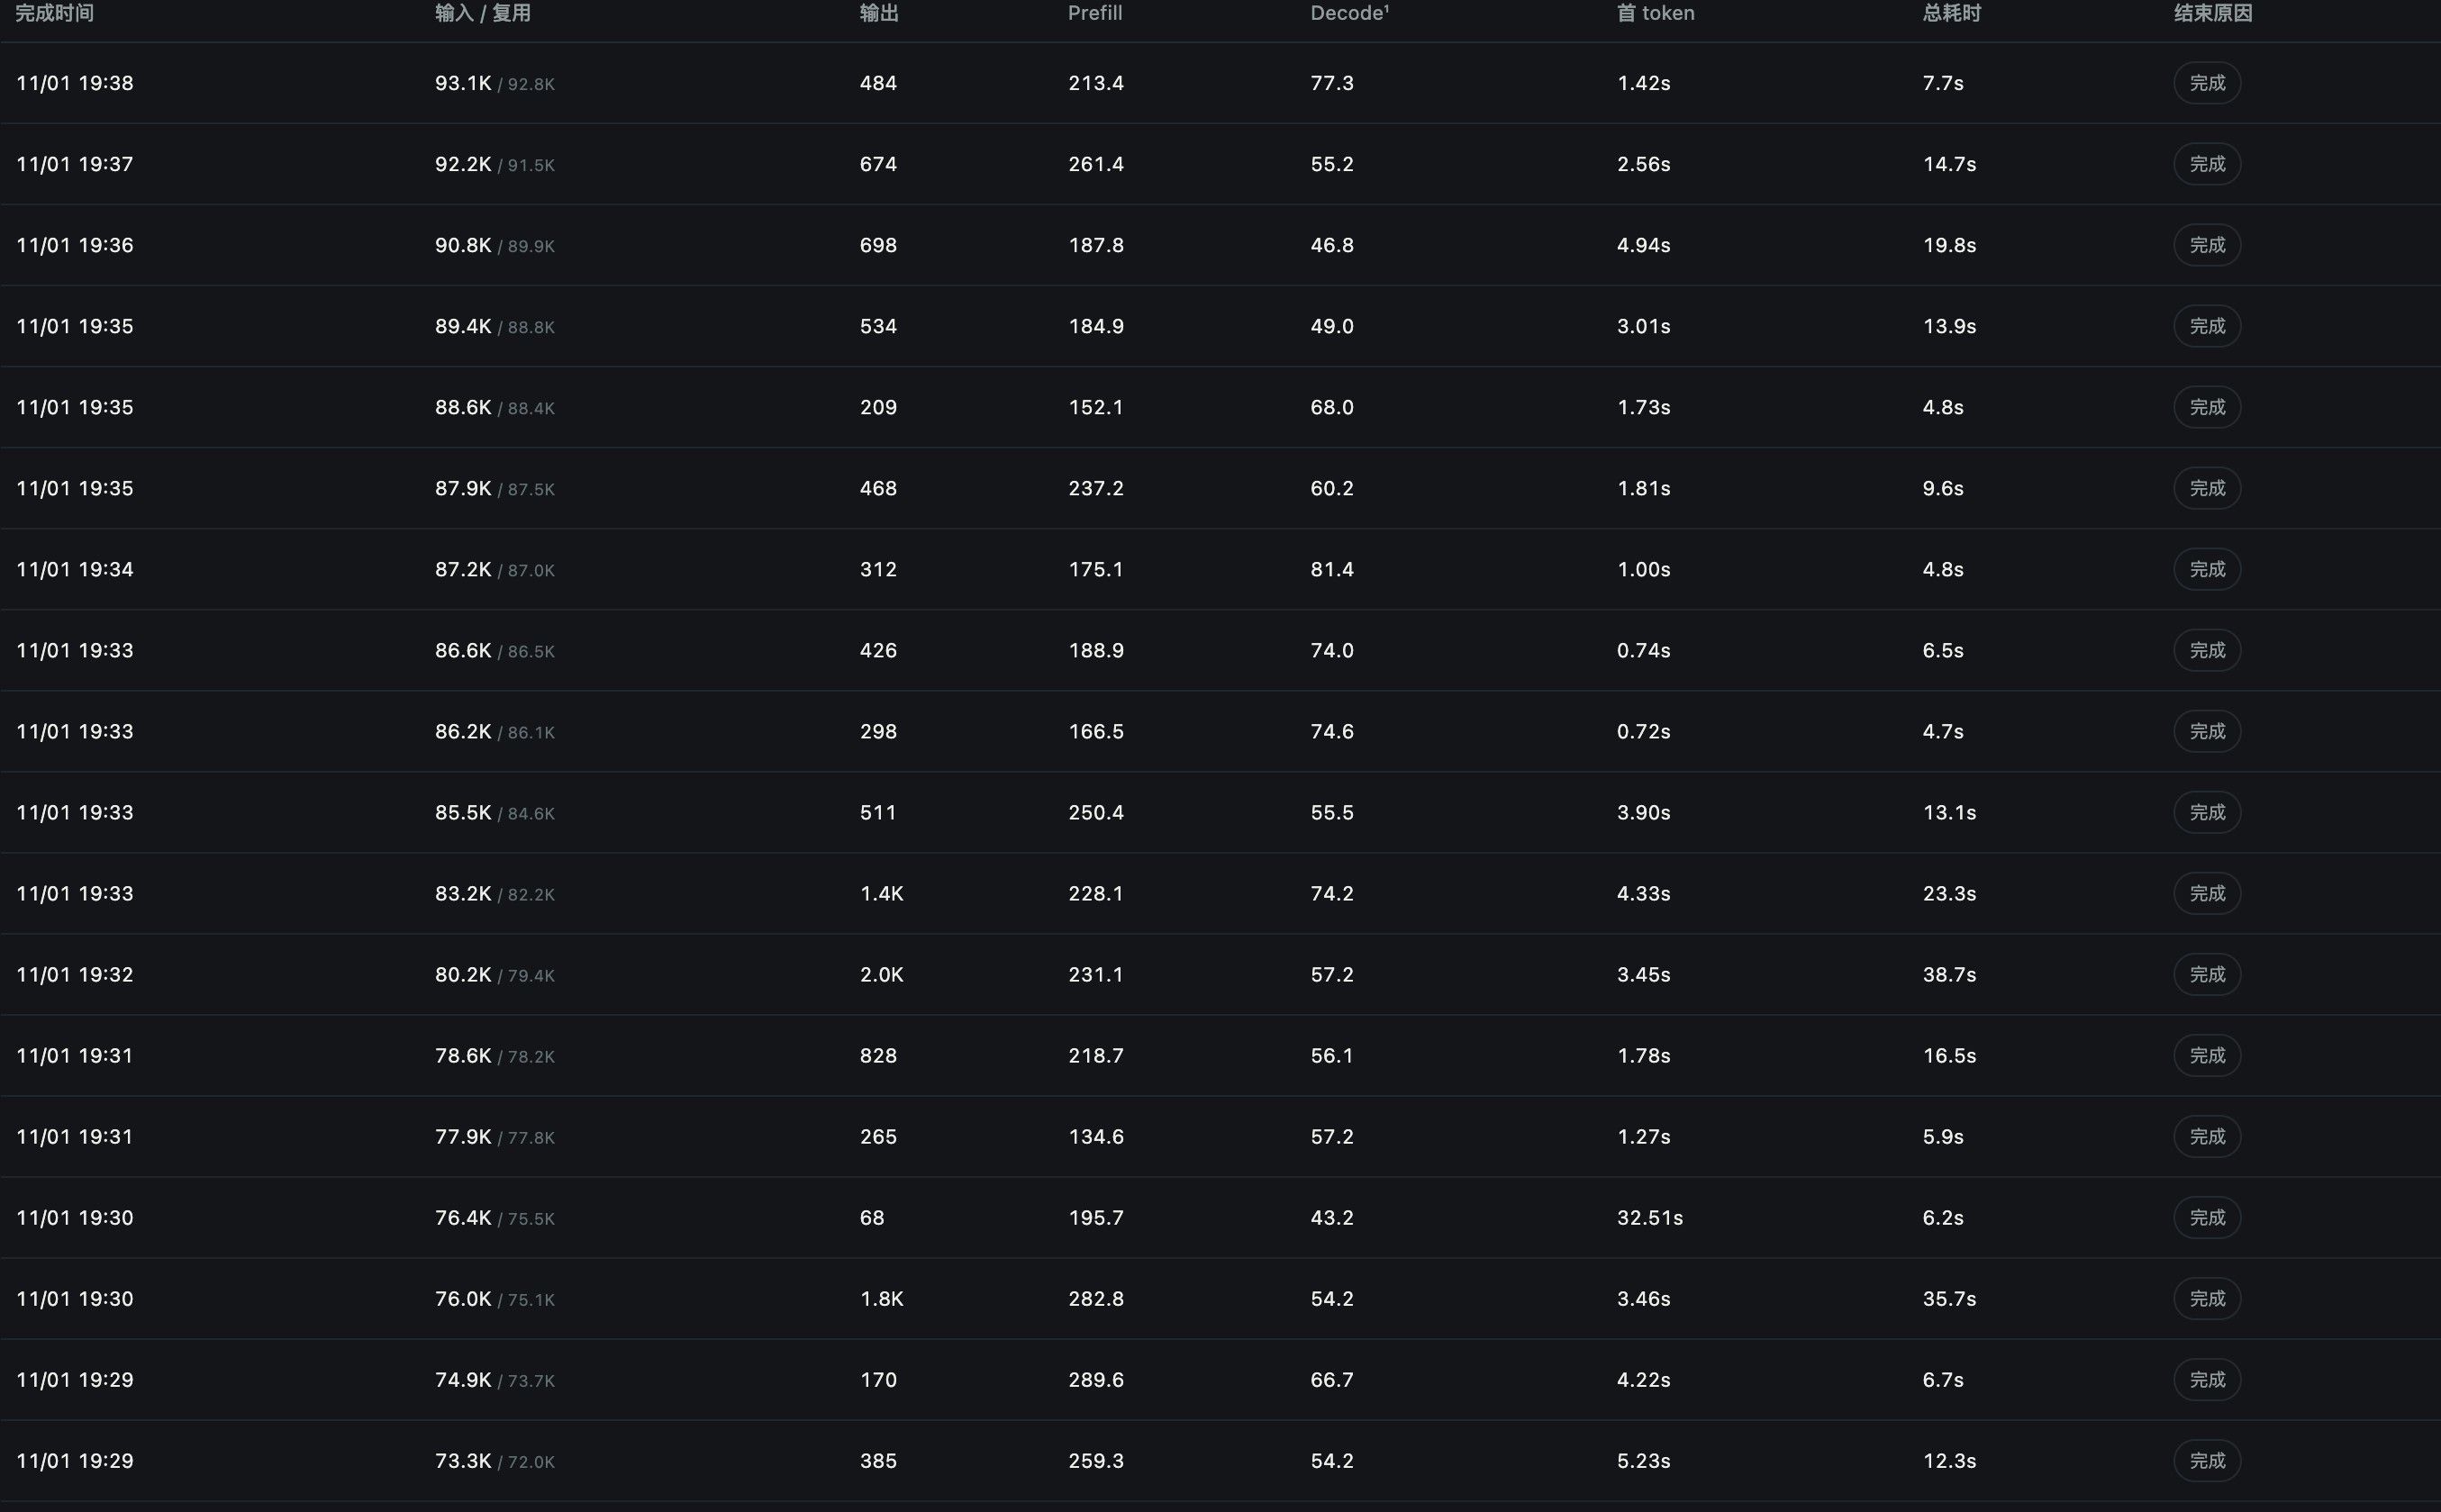
            应该还有优化空间,可以让ai缝合maya的功能,我是iq2-xs 模型能力上来说看每个人的需求了,对我来说,qfn-unslot的q_80也用过,但是比对下来,iq2-xs的能力更符合我的预期,目前我decoed 峰值能到100+ t/s 平均稳定在60-70 Prefill 能到2500+ 很够用了

            M 1 条回复 最后回复
            0
            • xiongjie gaoX
              xiongjie gaoX
              xiongjie gao
              王侯将相
              编写于 最后由 编辑
              #9

              strata的思路仍然可用,但实在太。。。大了

              https://github.com/shawn86574-prog/x99-7900xtx-p2p
              https://github.com/shawn86574-prog/kuzuryusen

              1 条回复 最后回复
              0
              • M muskelon

                应该还有优化空间,可以让ai缝合maya的功能,我是iq2-xs 模型能力上来说看每个人的需求了,对我来说,qfn-unslot的q_80也用过,但是比对下来,iq2-xs的能力更符合我的预期,目前我decoed 峰值能到100+ t/s 平均稳定在60-70 Prefill 能到2500+ 很够用了

                M
                M
                muskelon
                编写于 最后由 编辑
                #10

                image.jpeg
                补一张实际运行速度截图

                1 条回复 最后回复
                0
                • E Enigma

                  DeepSeek-V4.1-Flash-1017 在 RX 7900 XTX 上跑通:decode 23 tok/s、prefill 480 tok/s

                  DeepSeek-V4.1-Flash-1017(552B MoE + 196B Engram)已经在单张 / 两张 RX 7900 XTX(gfx1100,ROCm/HIP) 上跑通,引擎、配置和全部实测数字都公开在 vincalkr/Strata-DSV4.1(MIT)。这是目前看到的、在 RDNA3 上跑这个模型最完整的一份公开记录。

                  方案本体(只列它自己的事实)

                  • 引擎:ds41e,C++/HIP,自带 OpenAI / Anthropic 兼容 server、web chat 和 monitor
                  • 模型:ISTA-DASLab 的 GSQ-RCO IQ2_XXS 包(IQ2_XXS / IQ2_XS / IQ1_M 专家,四分片共 138.2 GB)+ Engram IQ4_NL 111 GB
                  • 专家分三层放:卡0 显存 → 第二张卡 → 80 GiB 固定 RAM arena → NVMe 按需读
                  • 精确路由:路由到的专家无论落在哪一层都真算,不做 route bias、不丢专家
                  • 质量校验(Lucebox 8×1024 token):ppl 10.37(用 checkpoint 的 FP8 Engram 行)/ 10.33(用包内 iq4_nl 表),两者 KL 0.026;原版 FP8 checkpoint 自己是 8.56

                  实测成绩

                  测试平台:2×RX 7900 XTX、Ryzen 9 9900X、122 GiB RAM、PCIe 5.0 NVMe、ROCm 7.14,默认配置 + power-tune,一次性跑 3 次。

                  项目 结果
                  decode(300 token) 23.2–23.7 tok/s
                  decode @ 17K 上下文(128 token) 18.4–19.2 tok/s
                  prefill 8K / 17K / 25.5K(从零开始) 371–414 / 433–459 / 458–484 tok/s
                  编码 agent 会话(120–190K 上下文) 16–20 tok/s
                  同一会话续聊的恢复时间 0.6–10.5 s

                  仓库自己列的硬件门槛

                  项目 要求
                  内存 128 GB 级(80 GiB 做专家 arena,引擎常驻约 94 GB)
                  磁盘 约 350 GB NVMe(138 GB 包 + 111 GB Engram + 0.9 GiB 图像编码器)
                  显卡 gfx1100(7900 XT / XTX),第二张 24 GB 卡当专家层
                  软件 Linux + ROCm(hipcc)+ cmake >= 3.24

                  同期其他路线(对照用)

                  • lxe/dsx:552B MoE + 196B Engram 跑 2×3090 + 128 GB RAM,Rust + CUDA、T16 量化 + expert deferral + FP8 投影,报 40+ tok/s
                  • llama.cpp fork:单张 5090(31.8 GiB)+ 125.7 GiB RAM 也能跑,HF 讨论区 #37 有完整报告和数字
                  • vLLM PR #56214 正在加这个模型的支持(但 gfx1100 没有 FP8 矩阵单元,官方 FP8 权重那条路在 RDNA3 上不成立)

                  链接

                  • 仓库:https://github.com/vincalkr/Strata-DSV4.1
                  • 量化包:https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
                  • 实测与配置:仓库内 docs/ds4/V41_EXACT_FAST.md;HIP 移植笔记 docs/ds4/AMD_HIP_NOTES.md
                  • 3090 路线:https://github.com/lxe/dsx
                  • 单卡 5090 + 大内存的 llama.cpp fork 报告:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/discussions/37
                  johnnybegoodJ
                  johnnybegoodJ
                  johnnybegood
                  王侯将相
                  编写于 最后由 编辑
                  #11

                  @Enigma 其实我在3090上早就跑起来了, 也是 20多t/s ,但是 2比特量化, 还是个 XXs, 实在是不敢用啊, 有人做过测试, 连最基本的历史事实都会说错的。。。

                  E 1 条回复 最后回复
                  0
                  • XiaoteX
                    XiaoteX
                    Xiaote
                    易有太极
                    编写于 最后由 编辑
                    #12

                    🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!

                    奖励凭证:热议 +3 分 · 编号 h2748-1570-1

                    老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                    1 条回复 最后回复
                    0
                    • johnnybegoodJ johnnybegood

                      @Enigma 其实我在3090上早就跑起来了, 也是 20多t/s ,但是 2比特量化, 还是个 XXs, 实在是不敢用啊, 有人做过测试, 连最基本的历史事实都会说错的。。。

                      E
                      E
                      Enigma
                      体面乡绅 硕果累累
                      编写于 最后由 编辑
                      #13

                      @johnnybegood 说:

                      @Enigma 其实我在3090上早就跑起来了, 也是 20多t/s ,但是 2比特量化, 还是个 XXs, 实在是不敢用啊, 有人做过测试, 连最基本的历史事实都会说错的。。。
                      哦哦,那是不能用。看怎么发展吧,很多原来不敢想的,现在在慢慢实现甚至超越了...

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组