【硬核实测】M5 Ultra 本地 AI 视频生成与大模型推理评测:ComfyUI 翻车 · H3.C 救场 · MLX-Serve 留下
-
【硬核实测】M5 Ultra 本地 AI 视频生成与大模型推理巅峰评测:ComfyUI 翻车 · H3.C 救场 · MLX-Serve 留下
 导读与实测背景
一台 256GB 统一内存 的 Mac Studio M5 Ultra,三天,三个视频生成引擎,两套主流大模型推理服务,全部真机高压实测。
在 Apple Silicon 统一内存架构的极端压力场景下(尤其是 100GB+ 级百亿大模型推理与去噪计算并行),系统底层内存调度与引擎架构 直接决定了成败:
- ComfyUI 为什么在 256GB 统一内存下仍难逃连续爆内存被杀的命运?
- 原生 Metal 的 H3.C 纯去噪 15 秒/步冠绝全场,为何端到端反而输给了 8bit 档?
- 作为全能生产力核心的 MLX-Serve 是如何在 8bit 视频生成与大语言模型代码/长任务交付中双双成为最终主力的?
本文完整汇总全部一手测试数据、踩坑清单与生产级选型指南。
一、 测试平台与环境规格(精准校对)
项目 核心参数与精确配置 测试硬件 Apple Mac Studio M5 Ultra · 36 核 CPU · 80 核 GPU · 256GB 统一内存 · 统一显存架构 操作系统 macOS 27.2 文生视频测试模型 ddalcu/MiniMax-H3-FL2VA-MLX-Serve-8bit(以及官方原生 BF16 权重对比)视频生成统一任务 文生视频 10.8 秒 · 960×544 · 260 帧 · 原生音轨(seed 42 · 16 步 · 同 prompt 逐字复用) 智能体客户端 (Agent) DeepSeek Harness ( dsh) 命令行智能体工作流框架常驻文本推理环境 mlx-serve v26.10.3** 运行 **ddalcu/Qwen3.8-Flash-Next-MLX-Serve-iQ-MLX-4.7bpwvsoMLX v0.7.3 稳定版运行mlx/Qwen3.8-Flash-Next-oQ4e-mtp
二、 视频生成三引擎探索路线与深度实测
探索路线复盘
-
① ComfyUI —— 翻车
第一反应是生态最全、节点最丰富的 ComfyUI。但在实测中,连续三次跑到 8/20 步时,进程无声消失。- 去噪步速雪崩:从 110 s/it 一路持续恶化到 177 s/it;
- 致命根因:MPS 驻留内存在去噪步数推进中持续累积,且系统后台常驻有大模型推理服务,两者在统一内存中产生激烈互抢,直接触发系统 OOM(内存超限)被强行 SIGKILL 终止。即便拥有 256GB 物理统一内存也彻底扛不住。
-
② H3.C(h3-metal)—— 惊艳但贵
开源原生 Metal 引擎,纯 C 语言编写配合 Apple MPSGraph 硬件加速图,直吃官方 bf16 原生权重。- 纯去噪速度全场最快:~15 s/步,比 MLX 纯去噪速度快一倍以上!
- 痛点与瓶颈:端到端耗时却长达 11 分 48 秒。瓶颈严重卡在 62GB 文本编码器加载、AdaLN 预计算以及最终的 VAE 解码。此外,官方立场坚定“BF16 不转换不量化”,没有 8bit 档位,启动门槛高达 124GB 权重起步。
-
③ MLX-Serve —— 最终留下的日常主力
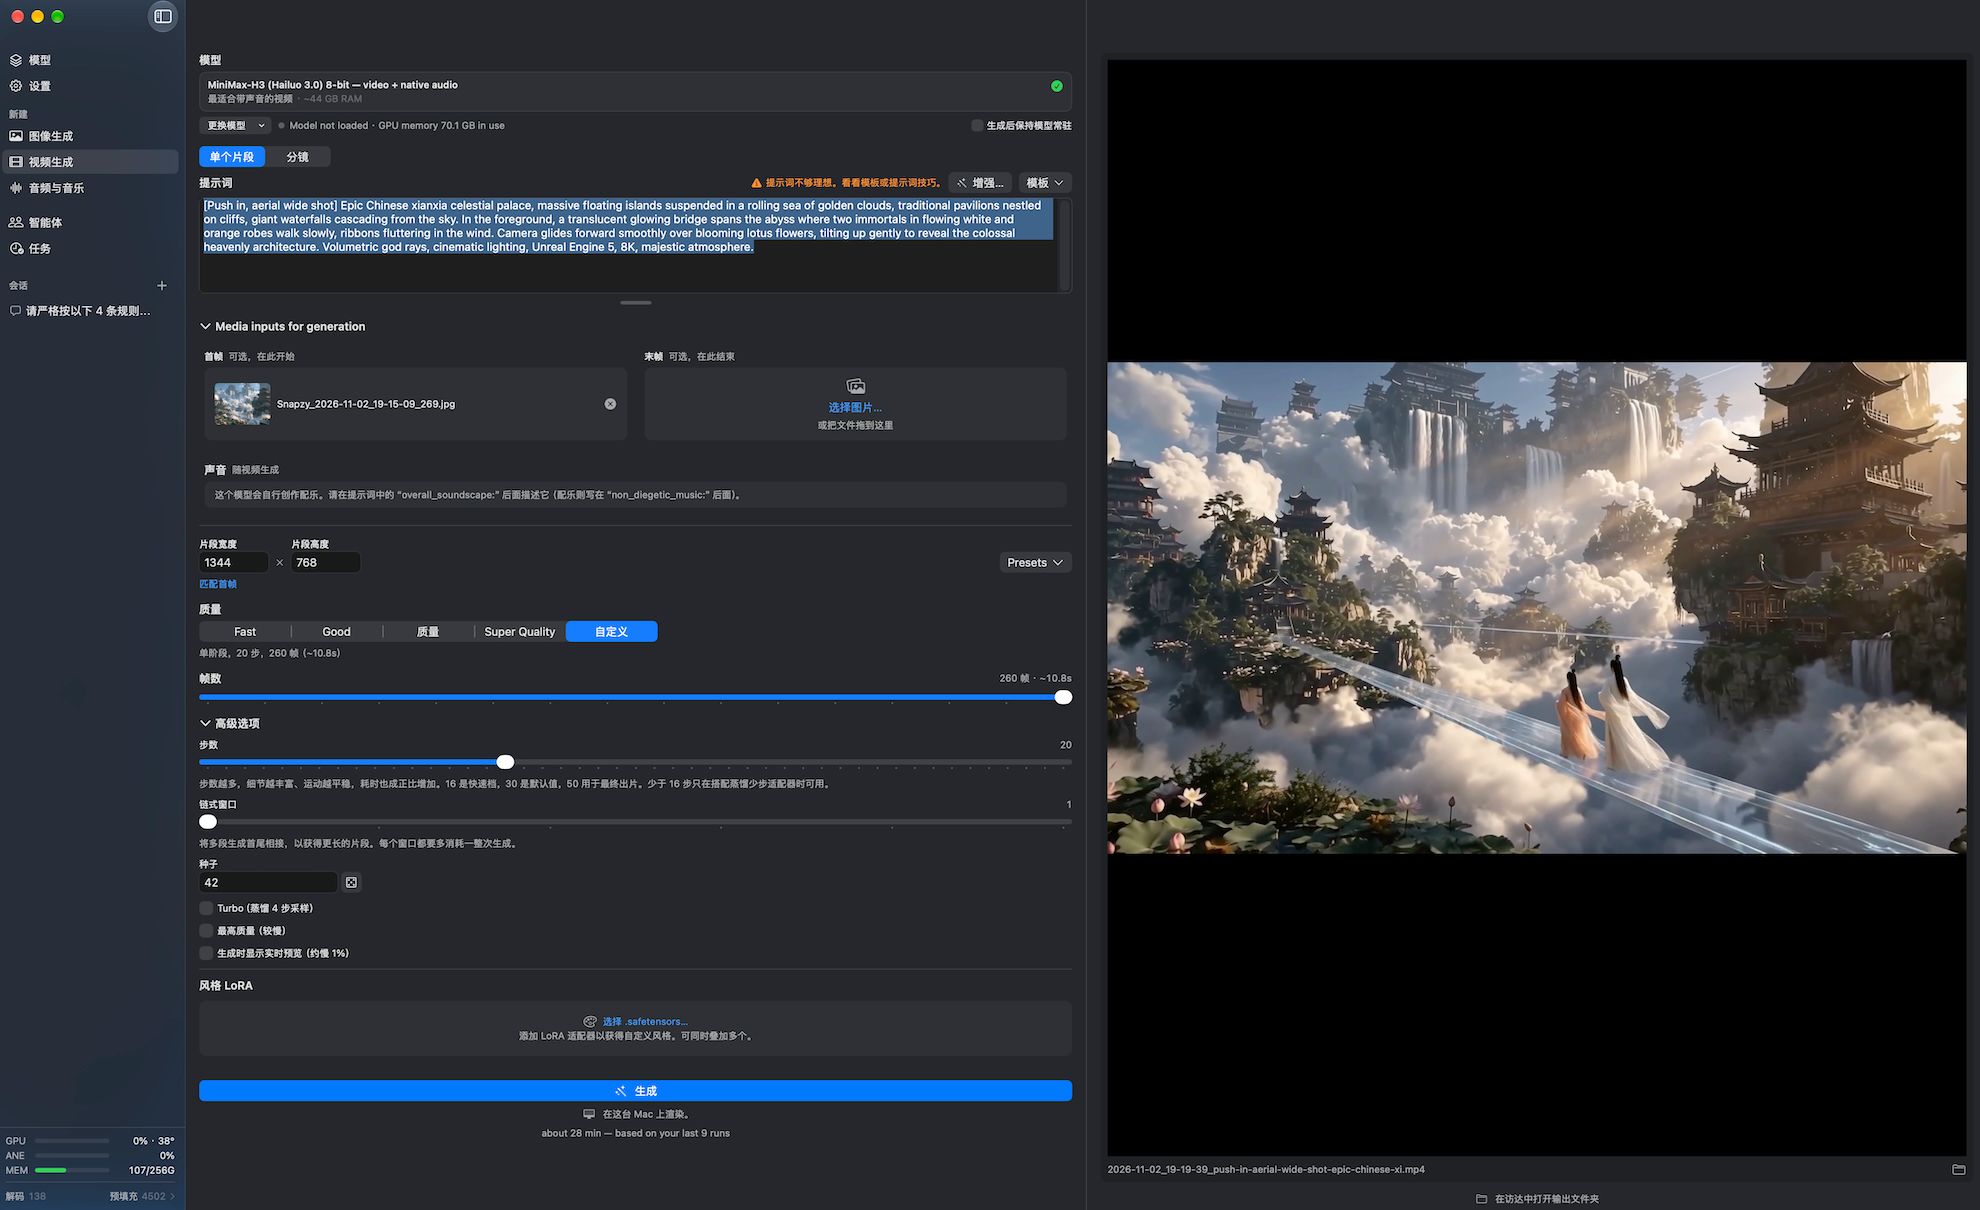
加载ddalcu/MiniMax-H3-FL2VA-MLX-Serve-8bit,GUI 界面一键触发,7 分 54 秒光速出片,同参数下端到端全场最快!- 原生音轨合流、首尾帧控制、链式长片拼接一应俱全;
- 同时兼顾生图管线(Qwen-Image-2.1),实现本地文生图、文生视频一站式闭环。
速度对比汇总横评
通道 / 引擎 采用模型与权重规格 端到端总用时 纯去噪步速 运行状态与稳定性 MLX-Serve GUI MiniMax-H3-FL2VA-MLX-Serve-8bit(70GB) 7 分 54 秒
~33 s/步 生产级稳定,开箱即用 MLX-Serve API MiniMax-H3-FL2VA-MLX-Serve-8bit(70GB)8 分 50 秒 ~33 s/步 适合自动化流水线集成 H3.C (h3-metal) MiniMax-H3 原生官方 bf16 (124GB) 11 分 48 秒 ~15 s/步纯去噪登顶,但编码/解码段严重拖累 ComfyUI MiniMax-H3 int8 量化  进程崩溃
持续恶化 (110 $\rightarrow$ 177 s/it) 三次爆内存被系统强制杀死 关键工程洞见:去噪快 $\neq$ 出片快!
H3.C 展现了原生 Metal 算力极限(去噪 15s/步),但端到端整体体验受限于编码和解码管线;MLX-Serve 通过高效的全链路管线整合,在 8bit 档位下斩获综合出片冠军。
三、 视频交付产物质量多维审计
对三条通道成功生成的 10.8 秒完整成片进行多维度像素级验证:
- 封装与音画一致性:三条成片结构均标准完整(H.264 编码 · 260 帧 · AAC 音频轨 · 10.83 秒时长);
- 清晰度与伪影检测:拉普拉斯方差清晰度检测指标一致,均无噪点损坏与闪烁割裂;
- GUI vs API 等价性:同帧像素差异仅 3.3 / 255,验证了底层为同引擎同管线等价执行,
seed: 42种子完全锁死生效; - H3.C (bf16) vs MLX-Serve (8bit) 画质对比:镜头构图基本完全一致,微观细节与风格略有质感差异,二者画质均达到工业可用级标准。
 产物实机截图对比区
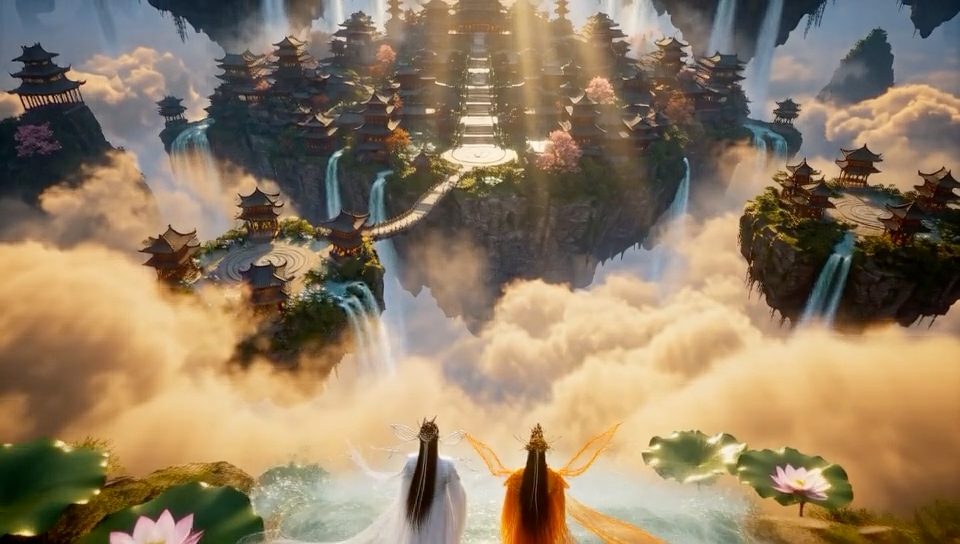
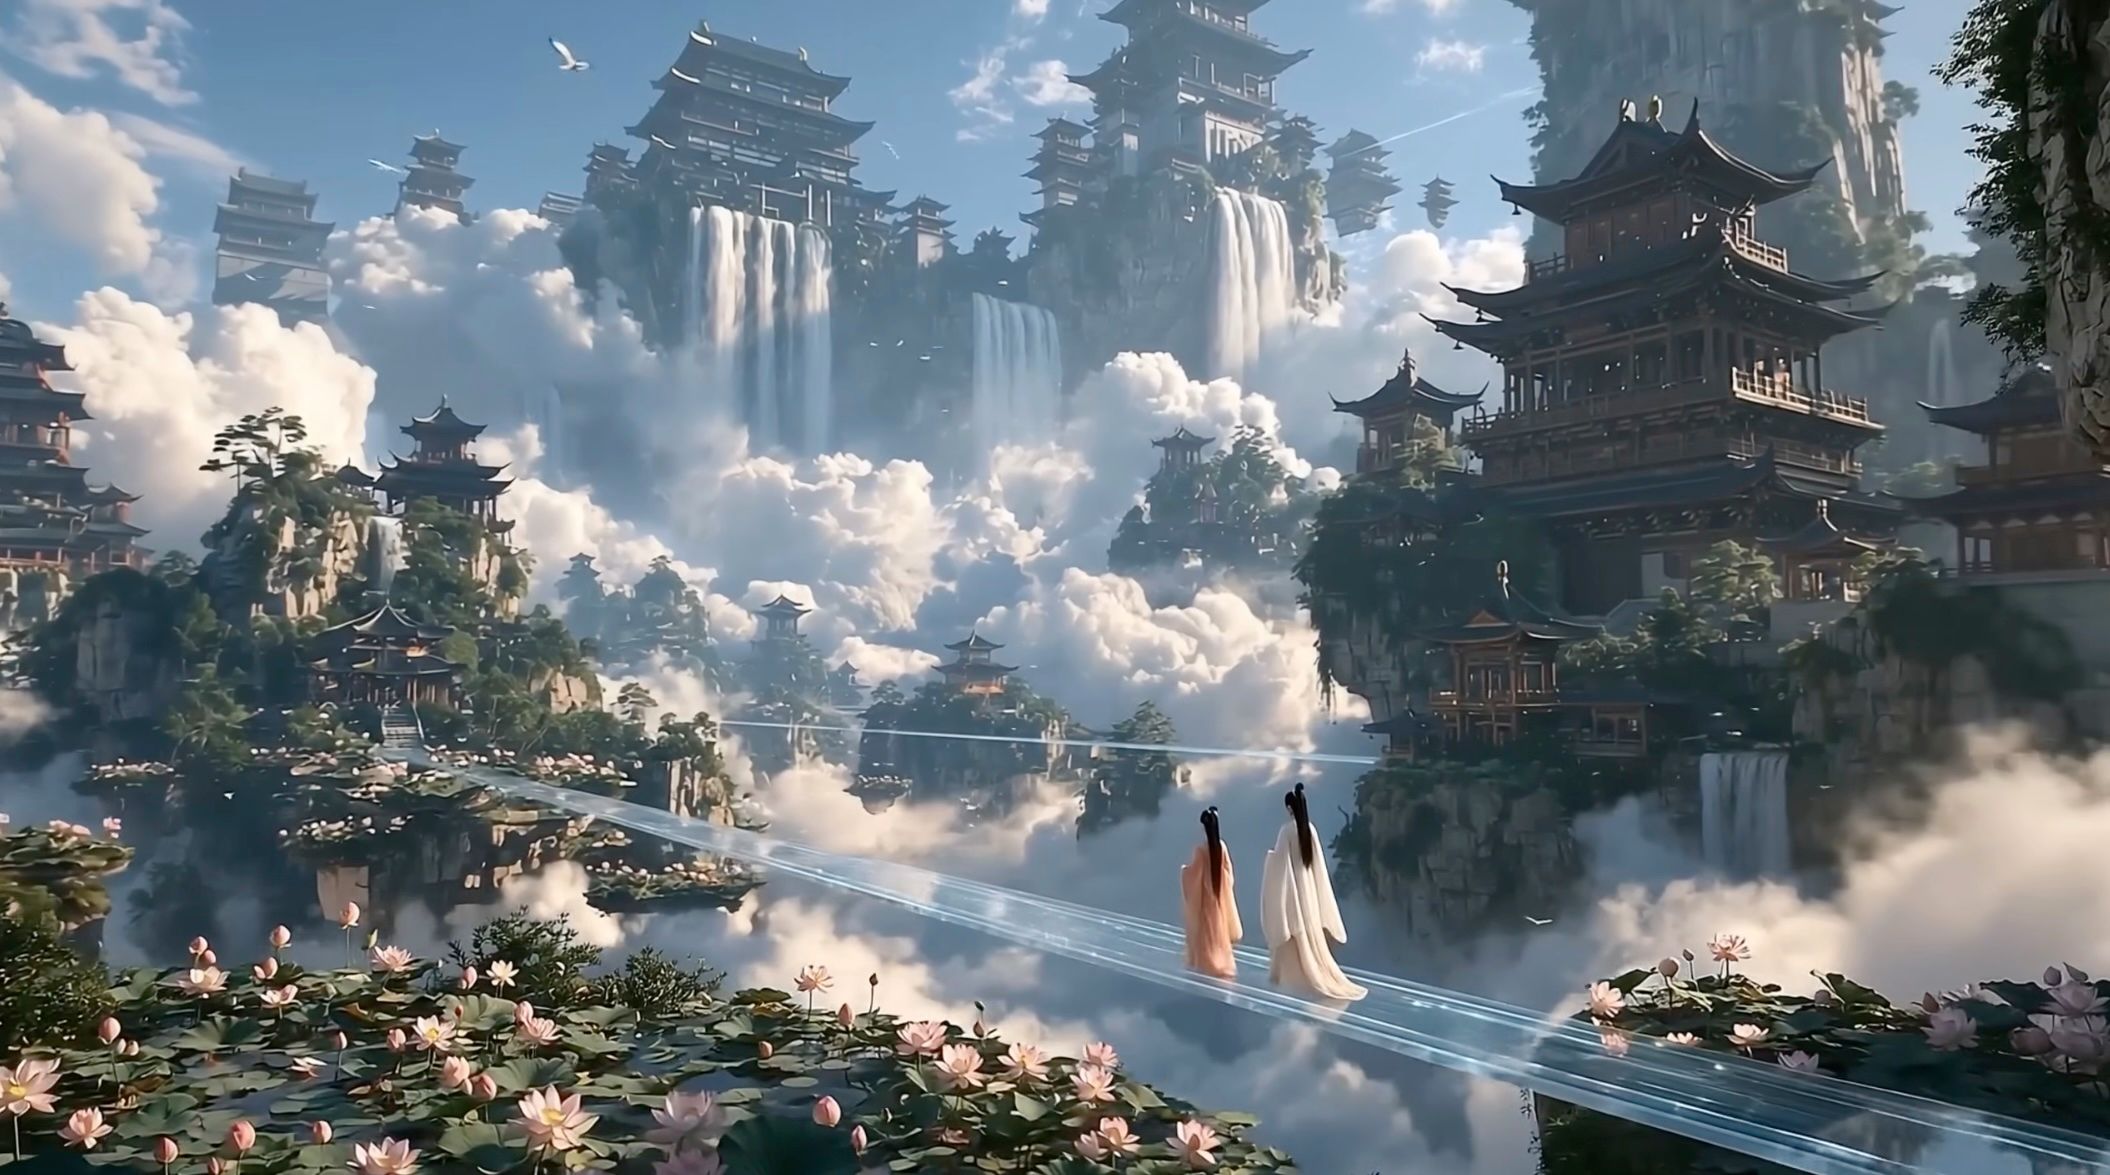
1. H3.C (bf16 官方原生权重) 生成视频实机截图
特征说明:原生 124GB BF16 无量化损耗输出,光影过渡细腻,微观纹理与物理动态保持极高保真度。
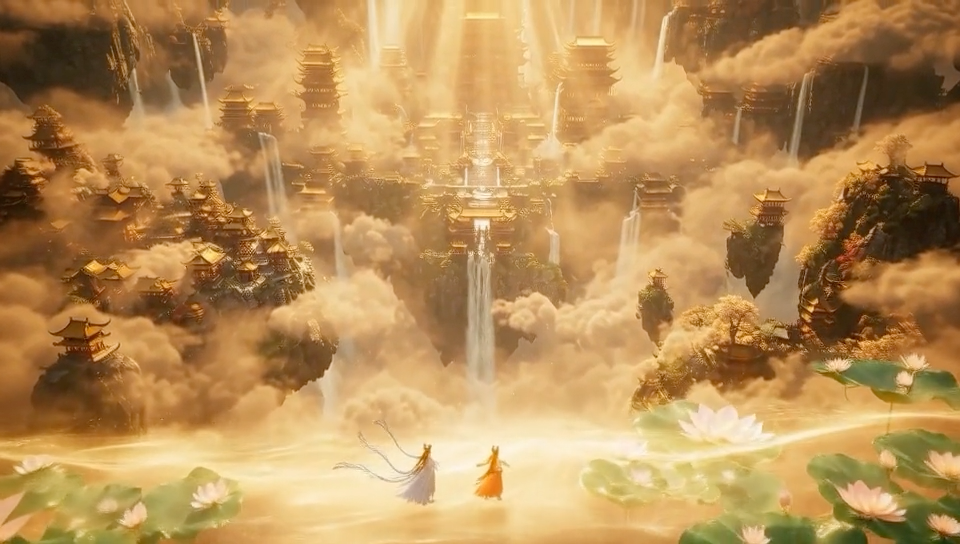
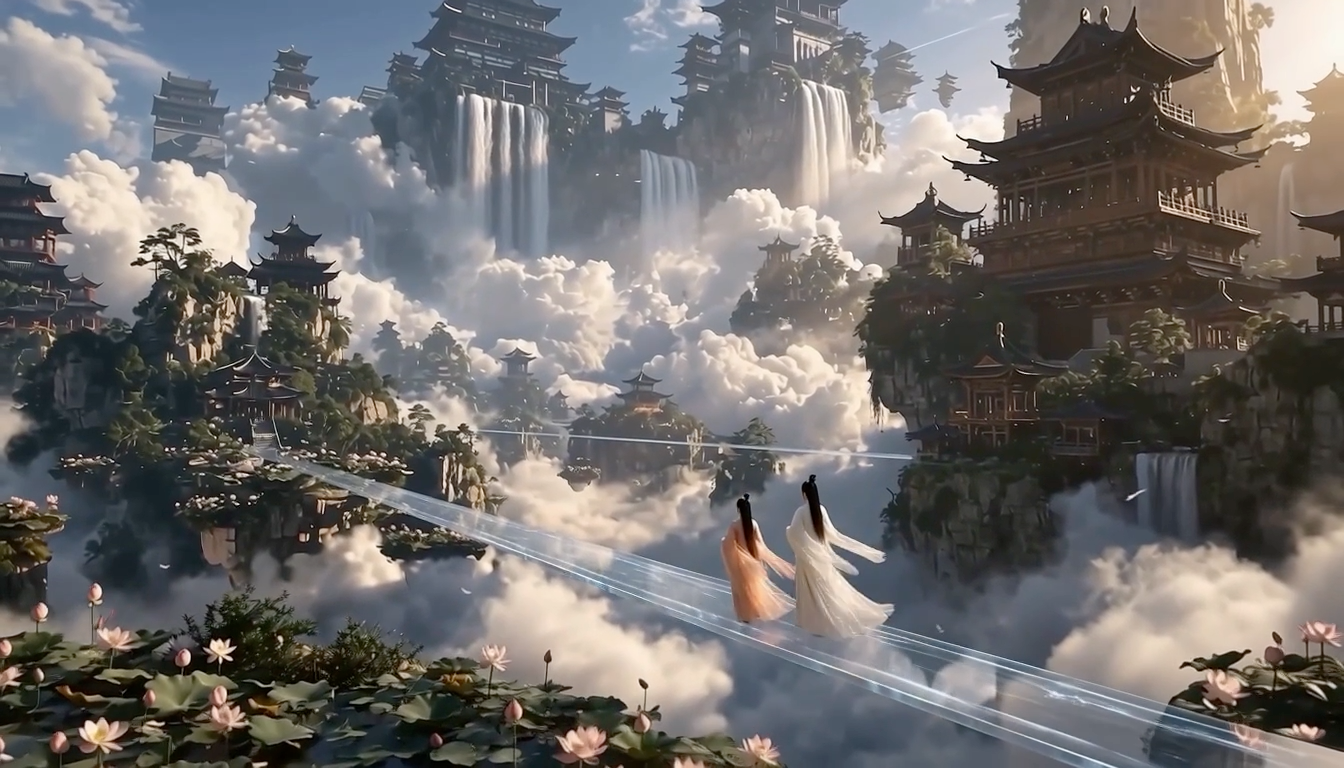
2. MLX-Serve (8bit 70GB 权重) 生成视频实机截图
特征说明:70GB 8bit 量化版本在 7m54s 极速出片,构图与动态与原生完全一致,像素级误差极低,生产实用性极强。
四、 本地常驻大模型推理全量测试联动横评
在 macOS 27.2 系统上,由 DeepSeek Harness (
dsh) 驱动的大模型推理引擎(mlx-serve v26.10.3vsoMLX v0.7.3 稳定版)同样经历了 4 轮严苛实测,奠定了其与视频任务共存的基石:评测维度与测试项 mlx-serve v26.10.3 ( Qwen3.8-Flash iQ 4.7bpw)oMLX v0.7.3 稳定版 ( Qwen3.8-Flash oQ4e-mtp)核心表现与共存影响 模型静态与显存开销 70.1 GB 静态(常驻峰值仅 74.1 GB) ~106 GB 静态(随上下文推升至 140GB+) mlx-serve 省出近 36GB 显存,为并行跑 70GB 视频模型保留了整整 162.5GB 缓冲安全空间。 长程工程开发大冲刺<br>(TaskFlow 架构+实时运维大屏)  26 分 07 秒 搞定全栈交付<br>TTFT: 0.7s · TPS: 96 tok/s<br>工具耗时: 5m38s
 ️ 3 小时 08 分 06 秒 漫长回溯<br>TTFT: 1.7s · TPS: 61 tok/s<br>工具耗时: 160m05s
mlx-serve 决策干脆无语法冗余,一次通过;oMLX 在连续多轮调用中深陷语法回溯与工具链卡顿。 DeepSeek-V4.1-Flash<br>(iQ 3.0bpw 巨无霸 427GB) 稳态解码 101 ~ 110 tok/s<br>16k 预填充飙至 2,038 tok/s — M5 Ultra 80 核 GPU 内存带宽被彻底榨干,打字响应几乎零延迟。
五、 踩坑清单(肝出来的经验,字字避坑)
- ComfyUI + 常驻推理服务 = 统一内存互杀
在统一内存架构下,即使内存高达 256GB,ComfyUI 的动态内存回收缺陷与常驻推理模型(70GB+)碰撞时,依然会瞬间触发系统 OOM 保护而直接闪退。 - API 步数字段静默回退的“22 分钟鬼故事”
在调用 API 时,步数字段严格定义为steps;如果传错名字,API 既不报错也不阻断,而是静默回退至默认的 30 步——这就是“为什么明明跑 16 步却耗时 22 分钟”的根本原因。务必通过服务端控制台日志核对真实步数! - 4bit 不是更快,而是更省
实测表明同管线下 4bit 与 8bit 速度仅差 6.6%,4bit 的核心价值是节省 29GB 内存,适合显存吃紧或需要多模型并发的场景。 - GUI 与 API 存在 12% 耗时差
MLX-Serve GUI(7m54s)比 API(8m50s)快了约 12%,主要差异在于常驻进程占用的 GPU 调度开销以及 HTTP Base64 编码反序列化耗时。日常使用两者皆可。 - H3.C 无 8bit 档位
官方秉持“BF16 不转换不量化”的纯粹态度,跑它就必须硬吃 124GB 显存,对硬件和权重加载开销极度挑剔。 - 下载器假成功陷阱
REST 接口提交任务有时“返回 OK 但不入库”,导致下载任务假死挂起整夜;改用 CLI 命令提交立即生效、稳定续传。
六、 最终选型指南
应用场景 推荐选型 核心依据 日常生图与文生视频主力  MLX-Serve
最快、最省心、端到端出片冠军。7m54s 完整交付,原生音轨支持,全包生图与生视频管线。 追逐原生极致算力 / 引擎折腾  H3.C
原生 Metal 性能怪兽。纯去噪 ~15s/步全场无敌,待后续前后处理与解码段优化后潜力巨大。 ComfyUI 生态  暂时放弃
架构缺陷导致其与本机后台常驻的大模型推理服务无法安全共存。  个人的结论:256GB 统一内存的真正价值
256GB 统一内存的底气,在于你可以在同一台 Mac Studio 上,一边常驻加载 70GB~106GB 级大语言模型 处理自动化工程与高并发推理,一边随时启动 124GB 级 bf16 原生视频大模型 本机本地出片——这在传统 PC 与 N 卡体系中,通常需要配备两张企业级 A100/H100 显卡才能做到。 -
-
请问支持参考生视频吗,如果跑1.0像素,也就是1376×768分辨率直出15s(也就是H3官方训练的最高值)要多长时间?另外我记得不用加速lora的话官方推荐是20步,为什么大佬只跑16步出片?
-
-
-
-
-
谢谢大佬,虽然时间长点,这个效果真是不错。感觉现在m5 ultra的生视频调用原生神经元加速的能力还没有完全挖掘出来,否则应该更快。另外还有一个draw things据说对mac的硬件支持较好,大佬也可以试下。
-
-
-
楼主,我确认一下没看错吧:
DeepSeek-V4.1-Flash(iQ 3.0bpw 巨无霸 427GB)模型,在你这mac M5 ultra 256G内存的机器上,跑出了稳态解码 101 ~ 110 tok/s,16k 预填充飙至 2,038 tok/s
400多G的模型,在256G统一内存上还有100token每秒的速度,这已经很生产力了啊


 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!