跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. Swift-1.5-Qwen3.8-Flash-Next-Q4_K_XL + QFN3.8 UD 3.1的NGRAM表 简单评测

Swift-1.5-Qwen3.8-Flash-Next-Q4_K_XL + QFN3.8 UD 3.1的NGRAM表 简单评测

已定时 已固定 已锁定 已移动 随便聊聊
qwenqwen-flash量化
10 帖子 8 发布者 383 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • stxpnetS
    stxpnetS
    stxpnet
    王侯将相
    编写于 最后由 stxpnet 编辑
    #1

    https://huggingface.co/ethanwtodd/Swift-1.5-Qwen3.8-Flash-Next-Q4_K_XL-GGUF/tree/main
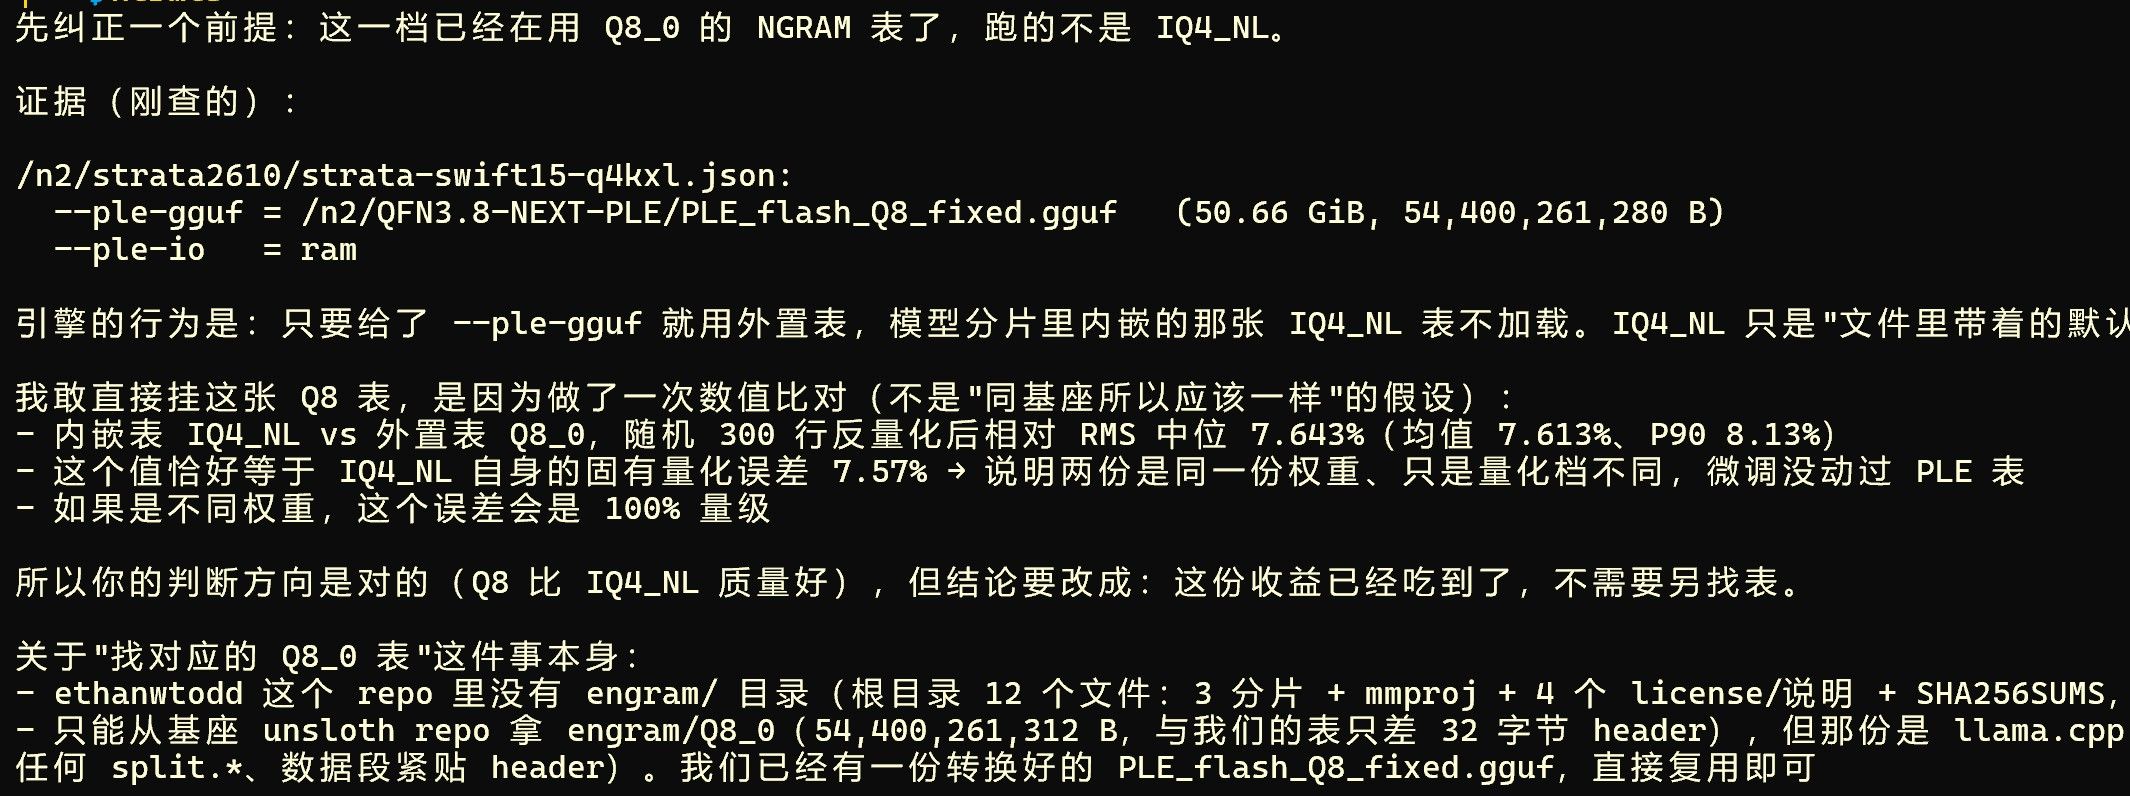
    image.jpeg

    我的本意是跑内置表试试,因为我找了一圈没有找到哪个模型把它的NGRAM表分离出来。谁知道HERMES自作主张给我加上了QFN3.8 UD3.1的 Q8_0 NGRAM,然后居然也能用。

    写简单的俄罗斯方块,比UD3.1的IQ4_XS,成品少了100多行,也没有那么惊艳

    鹈鹕半成品比 UD3.1的IQ4_XS的效果要好点:
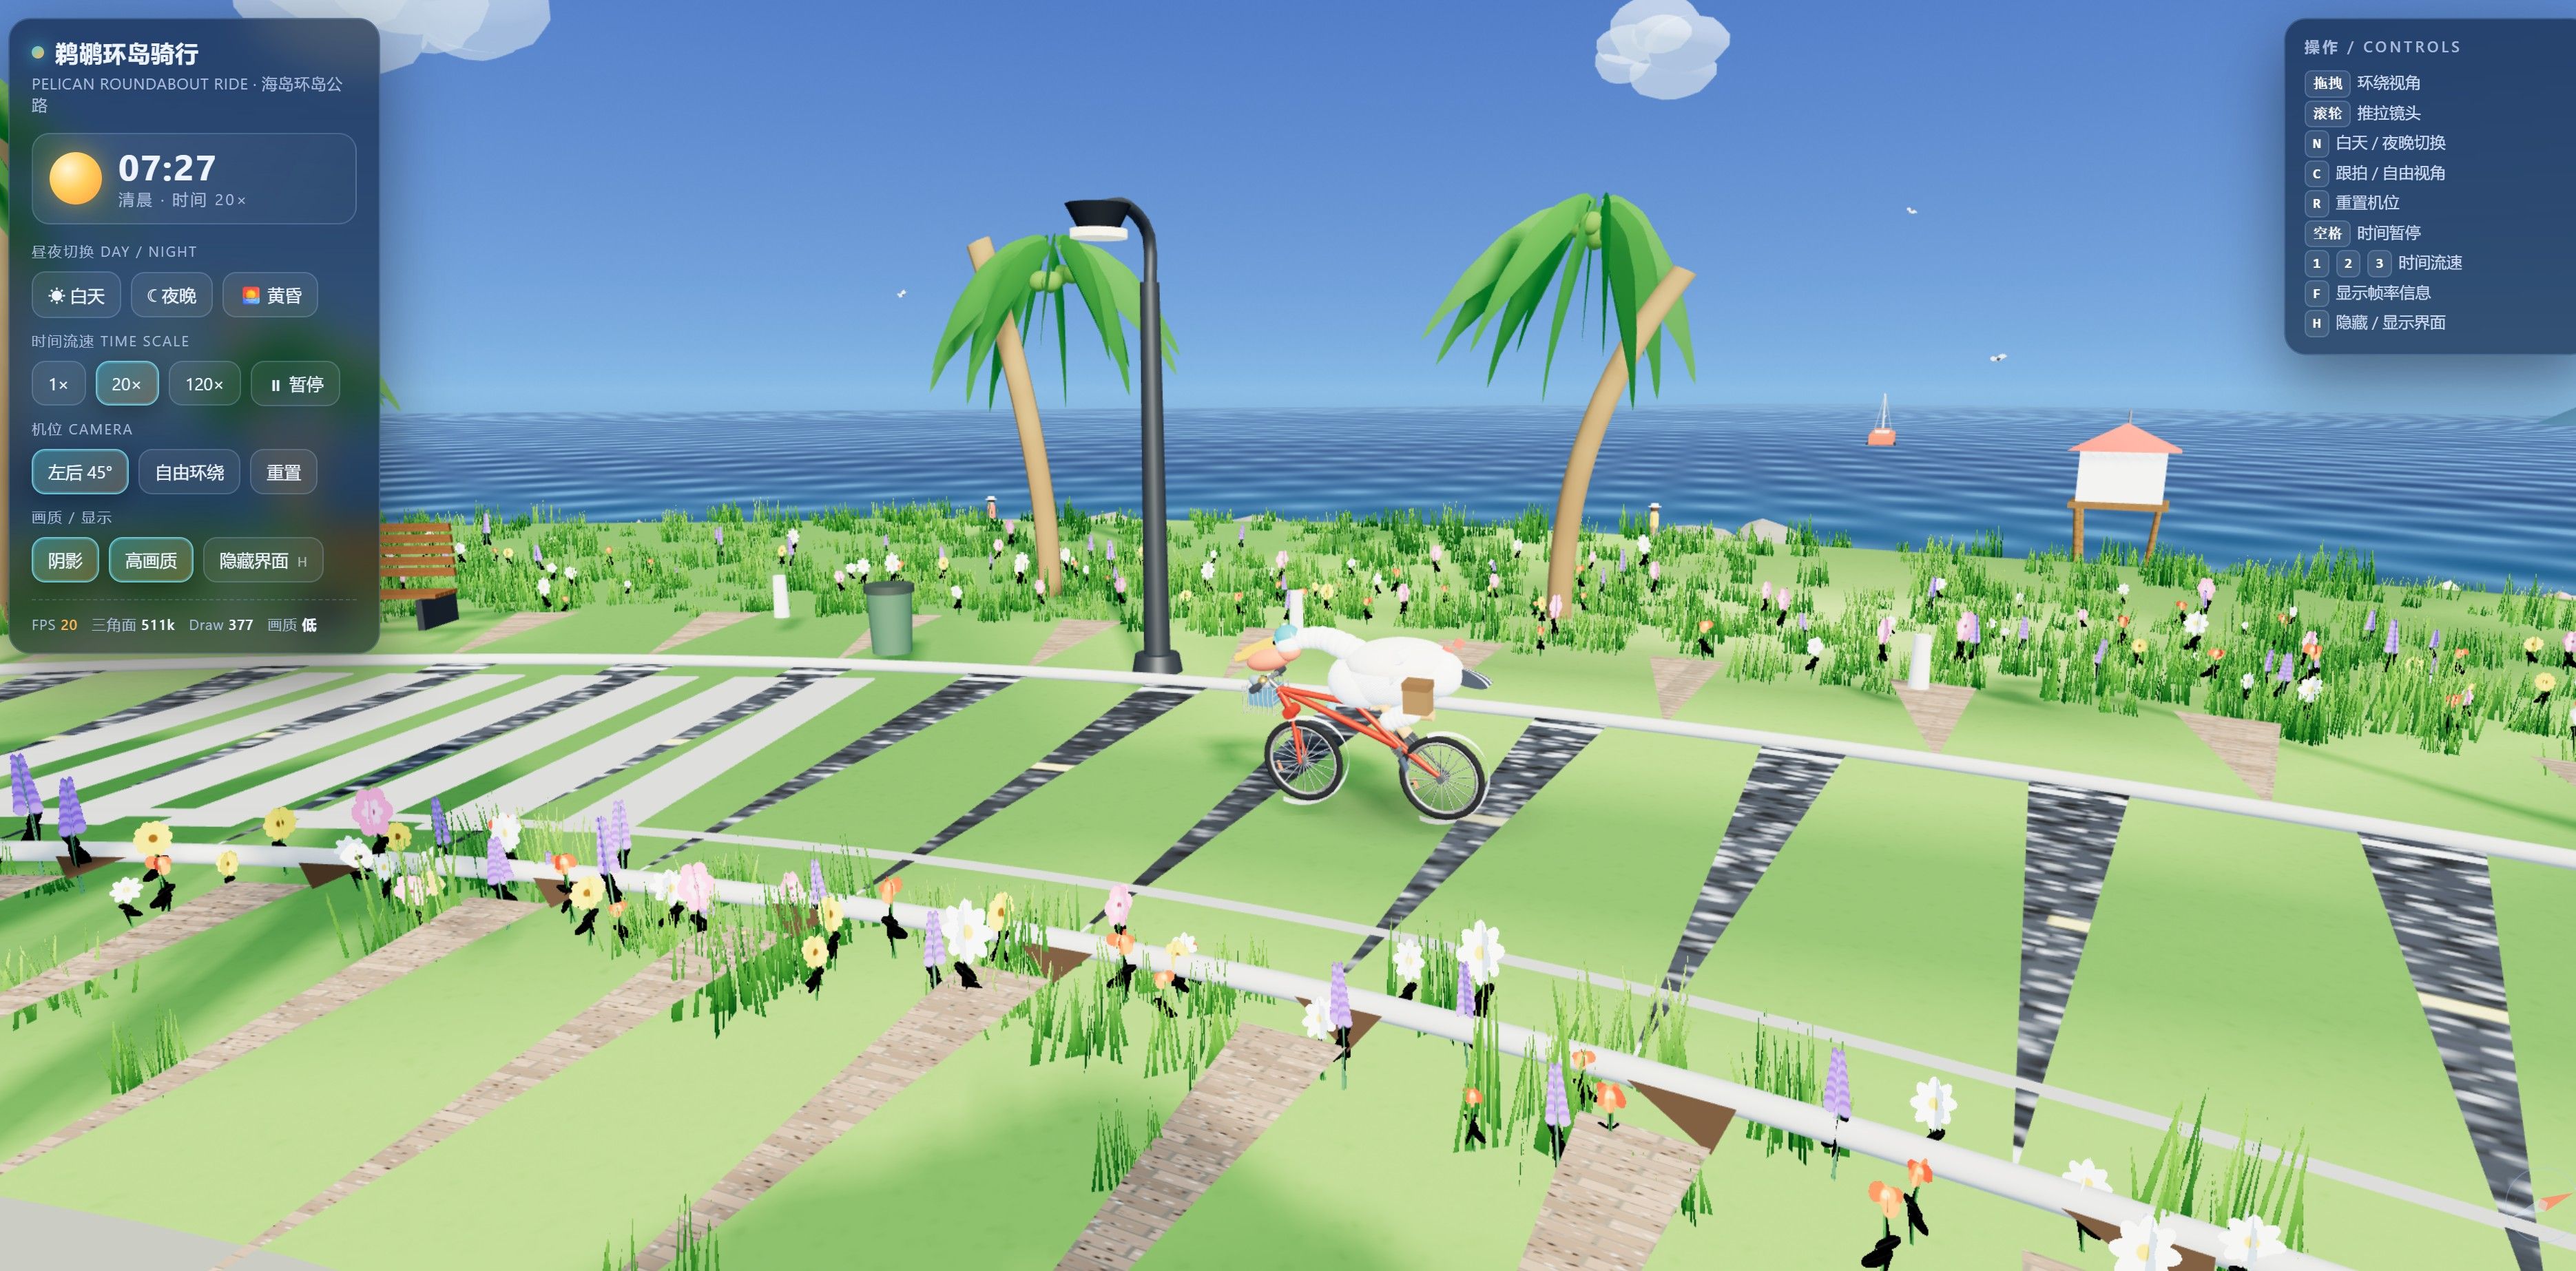
    image.jpeg

    双卡3090 PCIE 4.0 16X/16X

    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
    夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
    A W 2 条回复 最后回复
    1
    • kos orK
      kos orK
      kos or
      至尊皇帝
      编写于 最后由 kos or 编辑
      #2

      本地 deepseek flash 1017 用哪一個量化版本的呢?本地跑很慢 可能它比較適合非常困難的任務

      stxpnetS 1 条回复 最后回复
      1
      • stxpnetS stxpnet

        https://huggingface.co/ethanwtodd/Swift-1.5-Qwen3.8-Flash-Next-Q4_K_XL-GGUF/tree/main

        image.jpeg

        我的本意是跑内置表试试,因为我找了一圈没有找到哪个模型把它的NGRAM表分离出来。谁知道HERMES自作主张给我加上了QFN3.8 UD3.1的 Q8_0 NGRAM,然后居然也能用。

        写简单的俄罗斯方块,比UD3.1的IQ4_XS,成品少了100多行,也没有那么惊艳

        鹈鹕半成品比 UD3.1的IQ4_XS的效果要好点:
        image.jpeg

        A
        A
        applejuice
        王侯将相
        编写于 最后由 编辑
        #3

        @stxpnet 我都是在用iq4_xs 不懂差多少

        stxpnetS 1 条回复 最后回复
        0
        • stxpnetS stxpnet

          https://huggingface.co/ethanwtodd/Swift-1.5-Qwen3.8-Flash-Next-Q4_K_XL-GGUF/tree/main

          image.jpeg

          我的本意是跑内置表试试,因为我找了一圈没有找到哪个模型把它的NGRAM表分离出来。谁知道HERMES自作主张给我加上了QFN3.8 UD3.1的 Q8_0 NGRAM,然后居然也能用。

          写简单的俄罗斯方块,比UD3.1的IQ4_XS,成品少了100多行,也没有那么惊艳

          鹈鹕半成品比 UD3.1的IQ4_XS的效果要好点:
          image.jpeg

          W
          W
          wml-ai
          体面乡绅 硕果累累
          编写于 最后由 编辑
          #4

          @stxpnet 说:

          于是我换了UNSLOTH的UD -Q4_K_XL ,感觉智商会高一点,但是思考非常长,实际任务经常看到它的思维链来回拉扯。

          我是让云端模型搭框架, 让本地QFN-UD -Q4_K_XL模型去执行, 这样似乎就没有长思考的问题.

          Windows-Mac-Linux-AI

          1 条回复 最后回复
          0
          • paul houP
            paul houP
            paul hou
            硕果累累 贵族大夫
            编写于 最后由 编辑
            #5

            我是用這個模型
            frank8465/Swift-1.5-Qwen3.8-Flash-Next-GPTQ-W4A8-Radiance-AMD-R9700
            思考有短一點,明顯有比IQ3_S聰明,但DECODE速度有比較慢。

            1 条回复 最后回复
            0
            • F
              F
              fcys
              王侯将相
              编写于 最后由 fcys 编辑
              #6

              我的395在用。。。
              Halogen v2 原生的 4-bit HT 量化

              1 条回复 最后回复
              0
              • johnnybegoodJ
                johnnybegoodJ
                johnnybegood
                王侯将相
                编写于 最后由 编辑
                #7

                用过,官方也说了这个会特别慢

                1 条回复 最后回复
                0
                • 好米玉好
                  好米玉好
                  好米玉
                  编写于 最后由 编辑
                  #8

                  剛剛我IQS3 換IQ4 XL跑2天 感覺智力有差別 值得變慢一點

                  1 条回复 最后回复
                  0
                  • A applejuice

                    @stxpnet 我都是在用iq4_xs 不懂差多少

                    stxpnetS
                    stxpnetS
                    stxpnet
                    王侯将相
                    编写于 最后由 stxpnet 编辑
                    #9

                    @applejuice 要跑复杂一点的真实项目,和glm5.3 flash或者deepseek flash 1017一对比,立马原型毕露。。。。
                    目前我的体感 deepseek flash 1017 > glm 5.3 flash > 本地QFN 3.8

                    双卡3090 PCIE 4.0 16X/16X

                    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                    夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                    1 条回复 最后回复
                    0
                    • kos orK kos or

                      本地 deepseek flash 1017 用哪一個量化版本的呢?本地跑很慢 可能它比較適合非常困難的任務

                      stxpnetS
                      stxpnetS
                      stxpnet
                      王侯将相
                      编写于 最后由 stxpnet 编辑
                      #10

                      @kos-or 说:

                      本地 deepseek flash 1017 用哪一個量化版本的呢?本地跑很慢 可能它比較適合非常困難的任務

                      目前来说速度不达标,不考虑,不折腾。
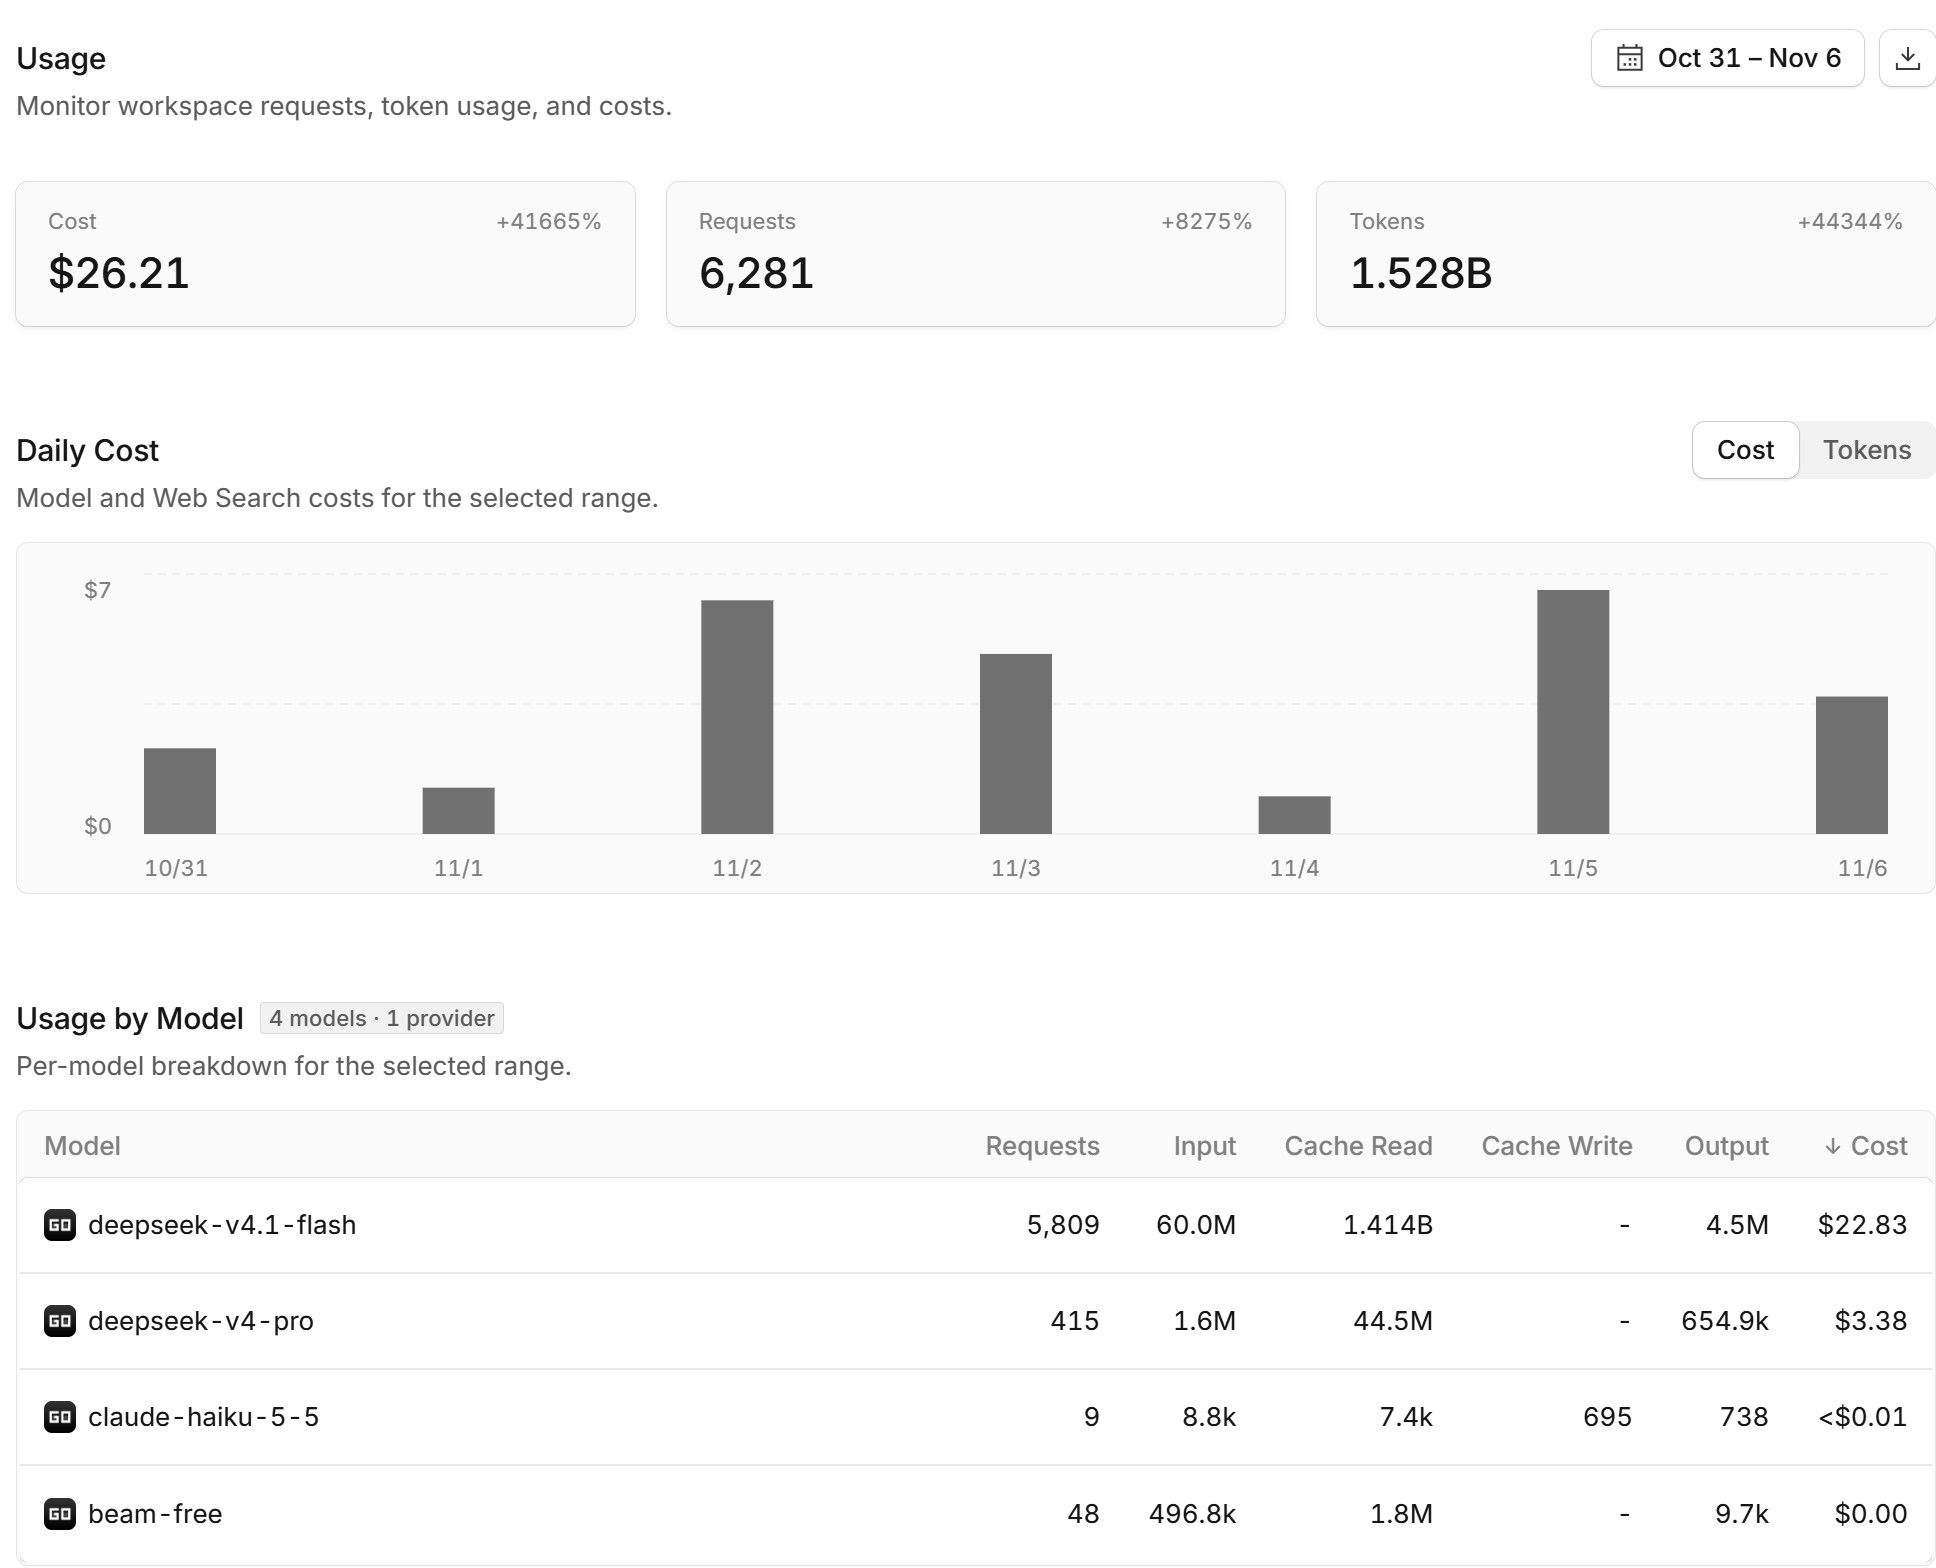
                      现在好几家国外API公司的 deepseek flash 1017都是白菜价。10美元左右的档位。直接站起来蹬。 智商是QFN 3.8的3-6倍吧。 这让我们这些本地卡算力不够的玩家很尴尬。

                      image.jpeg

                      我的真实任务目前都以这个deepseek flash在线API 为核心, 本地 QFN3.8只配给它提鞋干杂活。

                      双卡3090 PCIE 4.0 16X/16X

                      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组