
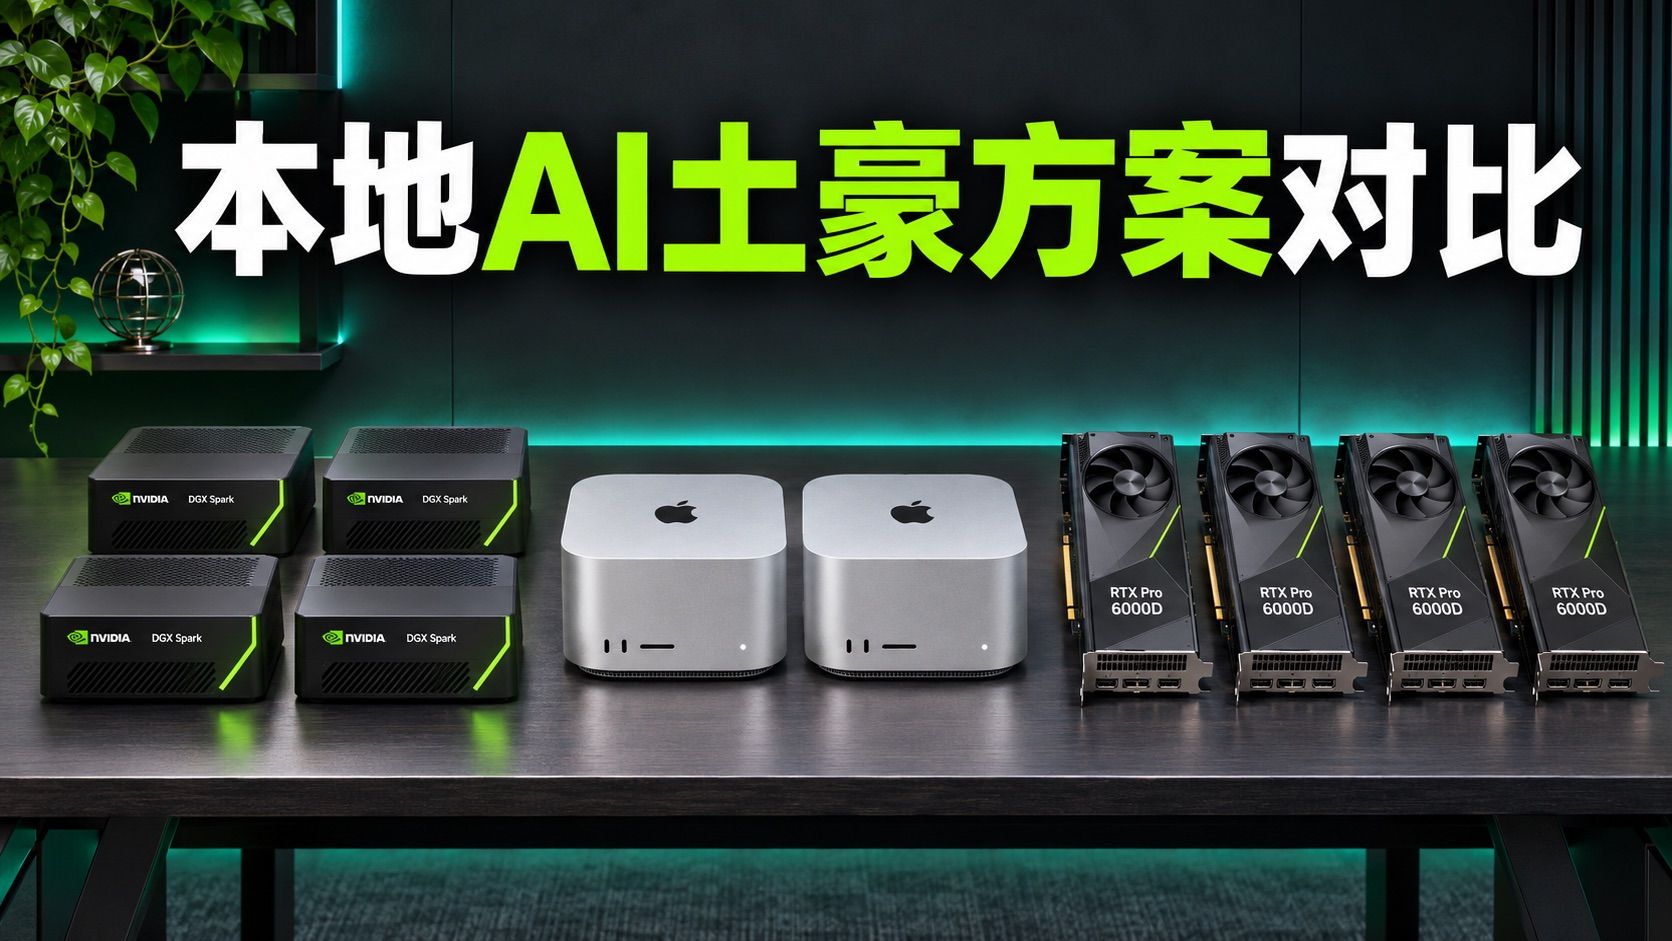
M5 Ultra vs RTX Pro 6000D vs DGX Spark,本地AI土豪方案对比,各有什么玩法,到底谁更有性价比?
-
本期视频呢,我们讲一讲几个比较贵的硬件跑AI的体验。我之前不是说了吗?我说Strata搭配独立显卡,比如7900 XTX、5080、5090、4090,或者一些老旧的像V100,它能够把你个人单会话、长上下文的体验做到非常不错,把这个门槛大大降低了。但是呢,你要说多并发,甚至不要说多并发了,多会话其实体验都不是很好。
那么你要想在本地有个比较好的体验,要么就是跑千问27B。像我用4090 48G,或者用7900 XTX双卡,那跑起来体验可能还不错,上下文也能拉得还可以。尤其是用4090 48G跑千问27B,加上DSpark这个技术,我认为体验跟在线的已经差别微乎其微了。它可能质量上面稍稍比DeepSeek落后一点,但是毕竟咱有云端的DeepSeek兜底。这个本地只是为了抗审查,只是为了防止数据泄露,防止自己的创意被云端大模型给剽窃,那我认为27B完全够用了。或者用7900 XTX跑一个单会话、长上下文的本地应用,其实也是够用的。就是多并发长上下文对于Strata来说,它确实现在体验不是太好。
那么有些比较牛逼的用户呢,他们就是花了比较多的钱,比如花了10万块钱到12万块钱左右,去买个M5 Ultra 256G。我们论坛的CC Tgo发了很多测试的帖子,论坛还有其他两个M5 Ultra 256G的用户,他们也发了MiniMax H3,也发了大模型的帖子,大家可以去找一下。然后这个CC Tgo老兄,他测试的就是图文并茂,每次他测试报告发完之后,我让他补一些图片,他基本上都会去补,就非常不容易。
他这次测试的是M5 Ultra 256G加上MLX-Serve这个新的推理框架,据他的反应好像比OLMX好用,驱动的模型是千问3.8 Flash Next。具体的配置过程我就不讲了,大家直接复制帖子编号2029,把这个编号复制下来,交给你的agent去抄作业就行了,如果你有相同的硬件。然后他的测试上下文从100K到200K,prefill速度是在4,000到5,000之间,然后解码速度从140到170左右。并发呢,它是跑8路并发,他认为是比较甜点的。
就是千问3.8家族,我不知道4.0怎么样,因为4.0可能最近还处于卡壳的状态。就是你设置128K,也就是帖子中经常说的131K,其实就是128K,1K是1024,所以128K会显示成131几几几。千问家族我觉得超过128K其实就不太好用了,极限你把它拉到190K、192K,基本上我认为再高它就基本上变成智障了。就是你甜点的用法,还是用128K来搞它。然后你大部分的agent,包括Codex、Hermes、DeepSeek Harness,你用128K跑,把它规划好了,体验是非常不错的。当然了,你不能跟DeepSeek动不动就500K、一兆去比,是吧?但是确实128K已经足够你干活了,这是一个甜点的上下文长度。
然后他给出来的数据相当不错,总之体验很好,首token延迟也可以接受。冷启动大概是20到40秒,然后如果已经有缓存了,那么TTFT数据也会相当好看,总之体验不错。然后呢我也必须感谢论坛的兄弟们,大家毕竟拿着自己十多万块钱的装备,免费帮我测数据。我在论坛中打开一个帖子就能嫖一个视频。在我家里事情比较多、抽不开身的时候,我要维持这个频道的更新,其实我自己偶尔测一测一些新的模型或者新的玩法,然后从论坛剽窃一些真实的测试数据。
那么下面我们对比一下另外一个兄弟,这个新来的Edmund Tang。我靠,这个不太好读啊,埃德蒙德吗?这老兄发了三个RTX Pro 6000D加一个RTX Pro 6000,跑官方版本、原生版本的DeepSeek V4.1 Flash 1017。这个Pro 6000D是中国特供版的阉割版,既限制功耗、限制功率,又阉割性能。它比RTX Pro的Max-Q版本阉割要严重得多。Max-Q是功耗限制在了一半,但是它实际上的性能实测,大部分情况下比标准版的RTX Pro 6000大概差百分之二三十,差不多是这个区间。这个RTX Pro 6000D显存也是从96G砍到了84G,它的算力可以说是砍到了膝盖以下。但是毕竟显存没有砍太多,它算力和带宽严格了,在很多情况下还是有用的。
因为我们用大显存显卡,并不是一直处于算力、显存、带宽全部拉满的状态,大部分时候不需要这样。它的阉割并没有让干活的能力像数据一样被砍到膝盖以下。它的价格确实比较便宜,好像是五六万块钱一张,六万块钱左右吧,我没有去查,大家可以自己去查一下。然后它只有Pro 6000官方版本的一半左右,比Max-Q也便宜很多。
它这个三卡6000D加上标准的6000,我不知道是怎么样的并发机制,但是它最终只能处理三个会话,总的上下文大概就是300万,就3M吧。那么性能我认为就有点……我不知道是不是它部署的问题,可能有牛逼的朋友能够部署出比较好的方案。但是人家也是经过多次测试、多次尝试,并且也不是一个人搞的,人家是一个小团队,可能自己公司会用到这个东西。
在这个测试上怎么说呢,前两天我不是做了个视频嘛,就我们奔腾e,这位老哥发了4个DGX Spark,两个技嘉、两个华硕,总价13万出头买到的,但是现在可能值20万。它这四个DGX Spark没有连交换机,就是通过英伟达的高速互联,用英伟达专线去连的,是四个环形拓扑架构。它能够跑官方原版,支撑起8个完整并发,上下文长度好像设的是512。它8并发跑出来的数据非常好看,首token延迟、TTFT也都非常不错。体验可能跟官方在线版本几乎没有差距,TTFT大概是0.8秒。
也就是说,它这个4个DGX Spark跑出来的效果,已经完全超过了这位哥们的三个Pro 6000D加一个Pro 6000标准版,这个造价得30万了。大家可以自己详细计算一下,我没有详细计算,只是根据我的印象大概估值,它应该是30万左右的造价。那性价比的话,毫无疑问是4个DGX Spark更合适。当然了,如果多卡方案这位老哥把上下文长度砍一砍,搞不好搞个5个、6个并发也是没啥问题的。但是性价比肯定还是4个DGX Spark更加合适。
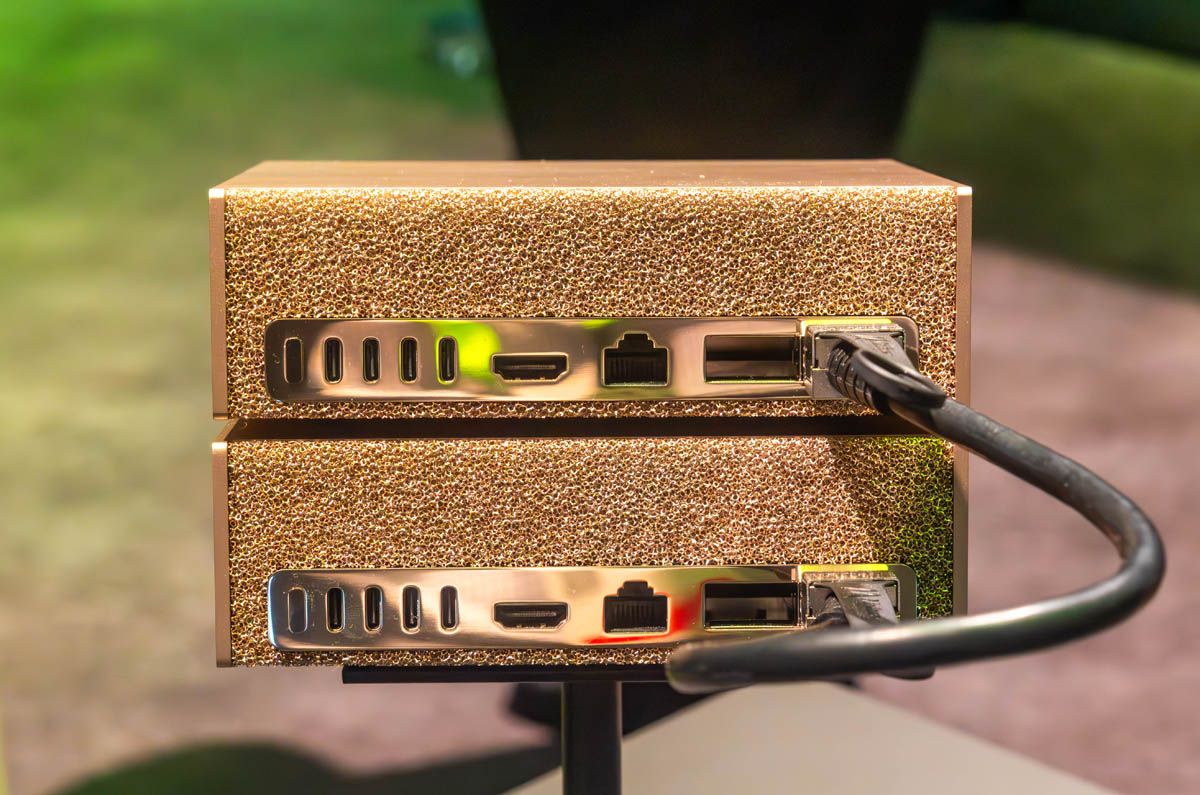
那有哥们说,我买两个256G的M5 Ultra,总价格比单个M5 Ultra 512G要便宜。但是我只能说,苹果双机互联带宽虽然也不错,大概是五六十G吧,应该不会超过70G每秒,它只有英伟达互联带宽的三分之一。英伟达专线带宽好像是200G每秒,它的互联效率理想情况下也不能跟英伟达比。两个小盒子的算力加起来也没有4个DGX Spark更强,再加上生态方面的劣势,因为苹果不是专门为了跑大模型设计的。虽然M5 Ultra由于规格太过变态、舍得下血本,导致它跑MiniMax H3、DeepSeek或者千问Flash Next的速度都还不错,并发也不错,但是它毕竟是一个全能的机器,不是像英伟达小盒子那样专为大模型设计,所以性价比很难跟4个DGX Spark相比。
那么它会不会比单个512G的M5 Ultra更好呢?我个人觉得如果跑MoE模型,大多数情况下应该是比它更好的。虽然它的互联带宽有残疾,但是相比一般的PCIe方案,带宽还是更好一点。如果后期软件优化一下,我认为买两个小盒子比较值得,因为毕竟两个小盒子你有兜底。就算DeepSeek将来跑起来数据可能不是那么如意,没有单个M5 Ultra 512G来得那么简单轻松,甚至效果也不一定比它好什么的,但是你毕竟买到了它两倍的算力。并且在本地跑千问3.8 Flash Next,已经可以满足你绝大部分需求了。马上4.0再更新,它比DeepSeek差一些,但是我认为在本地如果你仅仅是为了数据保密、应对审查,抗审查,那我觉得都够了。单个M5 Ultra 512G,除非你有什么特别的需求,不然我觉得还是没有两个256G的M5 Ultra有性价比。
我是讲实话啊,我也是非常想买一个M5 Ultra 256G的,只是因为最近我花钱太多了。贫穷让我安分守己,反正看一看吧,我相信硬件总会往下走的,它不会一直这么贵。搞不好晚一点买,到时候就捡各位大佬的二手,是吧?你们10万块钱买的,我们3万5接盘,这个还是可以畅想一下的。好吧,本期视频就到这里,欢迎大家到论坛来分享自己的硬件和测试数据,我们互通有无。好吧,我也能水一些视频。感谢大家的支持,我们下期视频再见。
相关帖子:
https://lcz.me/topic/2952
https://lcz.me/topic/2929
https://lcz.me/topic/2946 -
