
MiniMax H3 视频三卡实测:RTX PRO 5000 / R9700 / Arc Pro B70,Pika 六步 + 各自官方加速
-
今天翻出来B70,对比一下R9700和pro5000做了个对比。我没有4080(S) 32G的魔改卡,否则三款价格差不多的32G卡对比起来更直观,有的兄弟可以试试。
结果有点出乎预料,比想象中要好不少,大家有B70了可以帮忙复测一下。
同一素材、同一 Pika 六步、同一 seed,在 NVIDIA RTX PRO 5000(48G)、AMD Radeon AI PRO R9700(32G)、Intel Arc Pro B70(32G)上各跑一轮,并且每张卡都启用各自官方的加速手段:SageAttention / CK flash attention / SOL Attentio。
一句话结论:同一个 MiniMax H3 T2VA 工作流(同素材、同 Pika 六步、同 seed、124 帧 5.17s),1344×768 下三卡总耗时为 RTX PRO 5000(SageAttention)104.16s / Arc Pro B70 126.1s / R9700 234.1s;864×480 下为 30.0s / 44.0s / 64–66s。三张卡都启用了各自官方推荐的加速路径,本文把配置、每步时间和总耗时都贴出来,供参考。
一、测试环境
项目 RTX PRO 5000 Radeon AI PRO R9700 Arc Pro B70 架构 / 显存 Blackwell · 48 GB RDNA4(gfx1201)· 32 GB Battlemage G31 · 32 GB 驱动 / 运行时 CUDA 13.0 ROCm 10.1.0(TheRock pip 运行时) xe 驱动 + Level-Zero PyTorch 2.9.1+cu130 2.14.0+rocm10.1.0 2.14.0+xpu ComfyUI 0.43.0(venv) 0.43.0(venv,py3.14) 0.43.0(镜像 llm-scaler-omni:0.2.0-b3-comfyui-bmg) 加速路径 SageAttention 2.2.0(已装,实测收益 <2%) CK flash attention(torch SDPA 在 gfx1201 默认走 CK 的 attn_fwd) SOL Attention(BlockSparseAttention 稀疏节点) 环境备忘:R9700 侧机器上接了 Radeon 540X(gfx803)做显示,系统 ROCm 的 HSA 会因 “deprecated doorbell type” 让整个 ROCm 初始化失败,换 TheRock 的
rocm-sdk-core 10.1.0后可跳过;ComfyUI 动态显存(VBAR)在 R9700 上分配失败,只能--disable-dynamic-vram走 legacy 加载。B70 侧容器必须挂-v /dev/dri/by-path:/dev/dri/by-path:ro,否则 oneCCL 拓扑发现失败起不来。
二、素材与视频参数(三卡完全一致)
项 设置 素材 / 提示词 T2VA 官方模板的 prompt.txt(action movie trailer 风格),三卡原文照输 工作流 MiniMax H3 FL2VA(文本 → 视频 + 原生音频) 分辨率 864×480(0.4MP)与 1344×768(0.98MP,官方 768p),multiple=32 帧数 / 时长 124 帧 · 24fps · 5.17s(length 按 17k+5 网格对齐) 采样 lcm · 六步 · 七值 sigma 1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0加速 LoRA pika_h3_flex_fl2va_v1_bf16(strength 1.0),不叠加 DMAD/turbo/SLA/VSACFG 1.0(BasicGuider),不加 SigmaShift DiT minimax_h3_fl2va_pruned_int8_convrot(19.5 GB,int8 直出)文本编码器 qwen3vl_32b_minimax_h3_int8_convrot(27.1 GB)VAE video int8_convrot(2.6 GB)+ audiofp32(0.6 GB)seed 正式 12345,预热 7(预热轮不计入) 计时口径 提交 → 完成(文本编码 + 6 步采样 + VAE 解码 + 音频封装) 公平性:每卡先跑一轮
seed=7预热把模型加载/首编译预热掉,再用seed=12345测正式。两张 32GB 卡在 1344×768 下都要 offload 权重,搬运成本含在计时里。
三、每张卡的加速方式
三家的加速都落在 attention 层,但实现不同:NVIDIA 是量化注意力,AMD 是 CK 的高效全量实现,Intel 是按块稀疏跳过。
RTX PRO 5000 · SageAttention
- 四组对照:默认 SDPA /
--use-sage-attention× legacy / dynamic 加载 - 表格采用 SageAttention 版 104.16 s(每步 15.4 s/it);与默认 SDPA 的 104.23 s 相比差异 <2%,这条链路 attention 不是瓶颈
- 注:864×480 的 Sage 版未单独测试(该轮只做了 1344×768 的 Sage 对照,NVIDIA 卡后来已移出本机),表中 864 的 30.03 s 为默认 SDPA
Radeon AI PRO R9700 · CK flash attention(Composable Kernel)
- torch 的 SDPA 在 gfx1201 上默认就走 CK 的
attn_fwd内核(profiler 实测),即 AMD 官方的加速路径,无需额外开关 - 32GB 装不下 39GB 权重(DiT 19.5 + TE 27.1 + VAE 3.2),只能 legacy 加载做 CPU
 GPU 搬运
Arc Pro B70 · SOL Attention(稀疏注意力)
- 节点:
BlockSparseAttention(显示名 Model Sparse Attention) - 参数:
selection=sol-attn、selection.tau=1.3、start_percent=0.2、end_percent=1.0、min_tokens=12288、extra_tokens=256、sink_conditioning=exact_kv_and_rows、verbose=true - 链路:
UNETLoader → LoraLoaderModelOnly(Pika) → BlockSparseAttention(SOL) → BasicGuider → SamplerCustomAdvanced - 生效判据:启动日志
[OmniXPU] sparse_attention_adapter: applied、Found comfy_kitchen backend xpu: {'available': True, ...},采样日志BlockSparseAttention: sparse producer path: 15787 tokens(864×480)/38098 tokens(1344×768)
四、总耗时对比(预热后正式轮)
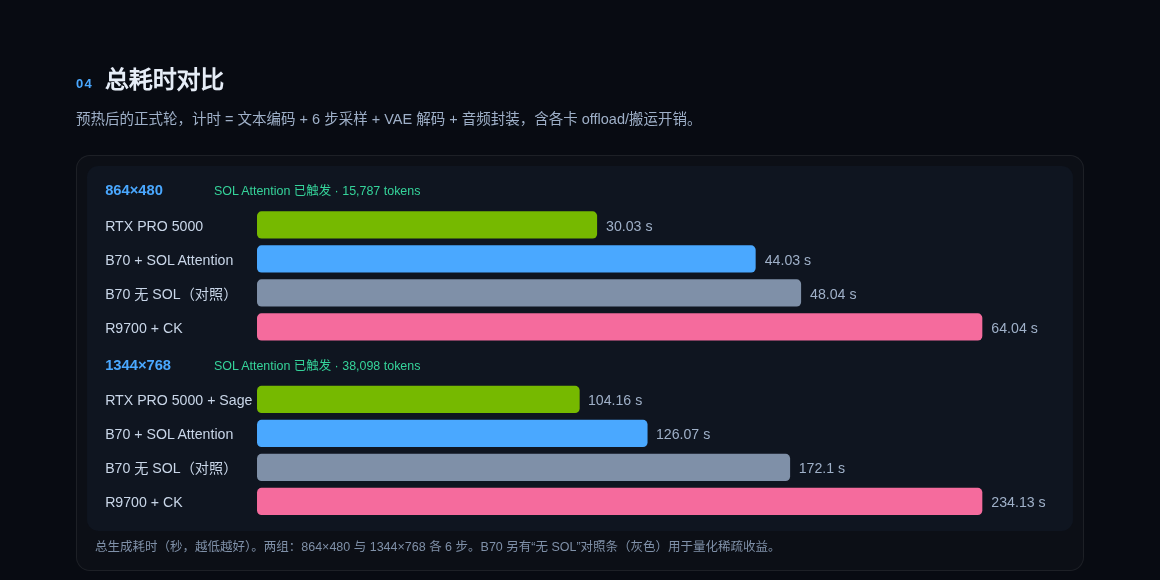
分辨率 显卡 加速 总耗时 每步 相对 RTX 864×480 RTX PRO 5000 SDPA 30.03 s 3.65 s/it 1.00× Arc Pro B70 SOL Attention 44.03 s 5.25 s/it 1.47× Arc Pro B70 无 SOL(对照) 48.04 s 5.89 s/it 1.60× R9700 CK flash 64.04–66.04 s 7.90 s/it 2.13–2.20× 1344×768 RTX PRO 5000 SageAttention 104.16 s 15.4 s/it 1.00× Arc Pro B70 SOL Attention 126.07 s 17.1 s/it 1.21× Arc Pro B70 无 SOL(对照) 172.1 s 24.8 s/it 1.65× R9700 CK flash 234.13 s 34.0 s/it 2.25×
五、每步时间对比(s/it)
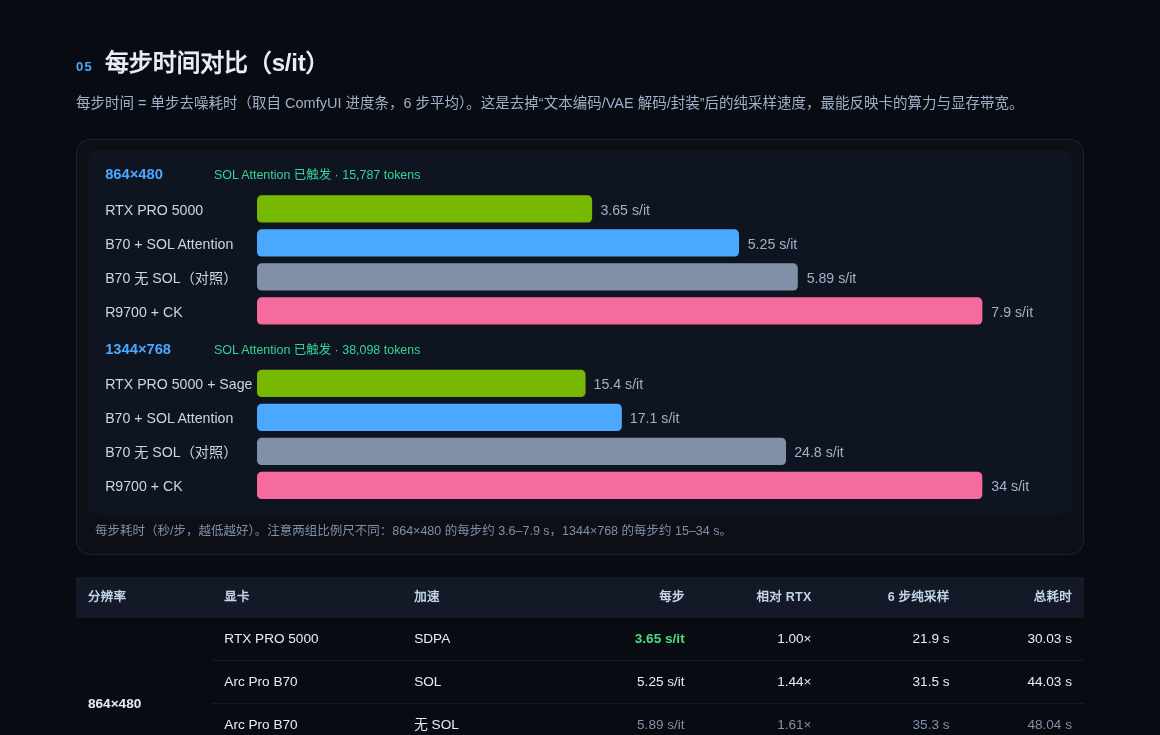
分辨率 显卡 每步 相对 RTX 6 步纯采样 864×480 RTX PRO 5000 3.65 s/it 1.00× 21.9 s B70 + SOL 5.25 s/it 1.44× 31.5 s B70 无 SOL 5.89 s/it 1.61× 35.3 s R9700 + CK 7.90 s/it 2.16× 47.4 s 1344×768 RTX PRO 5000 + Sage 15.4 s/it 1.00× 92.4 s B70 + SOL 17.1 s/it 1.11× 102.7 s B70 无 SOL 24.8 s/it 1.61× 148.8 s R9700 + CK 34.0 s/it 2.21× 204.0 s 864→1344,每步时间三卡分别涨 4.2× / 3.3× / 4.3×(RTX / B70 / R9700)——1344 下 token 数翻了约 2.4 倍,32GB 卡同时开始吃 offload。B70 的 SOL 让每步 864 从 5.89→5.25 s(-11%)、1344 从 24.8→17.1 s(-31%,首步 dense 后逐步加快)。
六、加速收益对照(同卡开关前后)
卡 加速方式 对照 加速后 收益 RTX PRO 5000 SageAttention 104.23 s(默认 SDPA,同加载组) 104.16 s ≈1.00×(<2%) R9700 CK flash attention —(默认路径,无额外开关) 234.1 s 无对照,已含在基线内 Arc Pro B70 SOL Attention 864:48.04 s / 1344:172.1 s 864:44.03 s / 1344:126.07 s 864 ≈1.09× / 1344 ≈1.37× SOL Attention 的稀疏两档都触发了(15,787 / 38,098 tokens 均高于
min_tokens=12288);608×352(8,535 tokens)才会全程 dense,本次未测该档。
七、几个值得记的发现
- 1344×768 下三卡排序:RTX PRO 5000(SageAttention)104.16s → B70 126.07s → R9700 234.13s;864×480 下比例相近(30.0 / 44.0 / 64–66s)
- 三卡的加速收益差别很大:SageAttention 在这条链路几乎没有收益;CK flash 是默认路径、无额外收益;SOL Attention 在 1344×768 上有 27% 收益、864×480 上只有 9%
- 编码器大小对速度零影响:B70 的 864 用 qwen3vl-32B(27.1GB)与 Molmo2-8B(9.29GB)都是 44.03s——编码器只跑一次,换小的省显存不省时间
- 32GB 卡都会被 offload 拖慢:R9700 与 B70 都要搬运权重;R9700 还额外受限于 ROCm 没有 CUDA 那样的缺页迁移(aimdo 动态显存不生效),停在 34 s/it
八、复现
# 统一基准脚本:/home/ly/t2va_bench/t2va_bench.py
# B70(1344×768 + SOL Attention)
python3 t2va_bench.py --port 8188 --w 1344 --h 768 --length 124 --seed 12345 --sol --tag b70_1344

# R9700(CK,SDPA 默认)
python3 t2va_bench.py --port 8192 --w 1344 --h 768 --length 124 --seed 12345 --tag amd_1344

# RTX PRO 5000
python3 t2va_bench.py --port 8194 --w 1344 --h 768 --length 124 --seed 12345 --tag nv_1344
# B70 容器启动(关键:by-path 挂载) sudo docker run -d --device=/dev/dri \ -v /dev/dri/by-path:/dev/dri/by-path:ro \ -v /home/ly/ComfyUI-h200/ComfyUI/models:/models/host:ro \ --network=host --shm-size=64g -v /home/ly/ComfyUI-b60/output:/data/output \ llm-scaler-omni:0.2.0-b3-comfyui-bmg \ python main.py --extra-model-paths-config /llm/configs/comfyui_host_models.yaml \ --output-directory /data/output --listen 127.0.0.1 --port 8188完整报告(暗色 HTML,含全部图表与表格):见配图3 整页长图,或本地
/home/ly/t2va_bench/report/三卡MiniMax-H3生成速度对比报告.html
测试日期:2026-11-12 · 平台:TRX40 · 三卡分别独立测试 · 计时来自 ComfyUI /history 与日志 Prompt executed,已排除预热轮
- 四组对照:默认 SDPA /
-
这么说,B70还是相当能打的罗
-
-
这么说,B70还是相当能打的罗
-
-
-
-
@jdfh089 来不及了
 能力已经反映在价格上,现在B70京东18999,r9700是17999,和楼主的测试结果完全吻合哈哈哈。intel的生态也是好起来了,硬件指标不占优的情况下还能压amd一头,官方优化真的有点东西
-
intel 其实不差的,我现在几个没显示卡的笔电,都是用着intel 的内置,能够加速premier pro, winxd converter, 安排试一试unreal engine, 其实intel只要不去攀比cuda生态,没有他办不了的事情毕竟是白送的。。
然后你要用amd 实现类似的效果?除了慢半拍的apu 之外,我还想不到还有什么好料
-
-
-
这么说,B70还是相当能打的罗
@xiongjie-gao 我是深入对比过Intel的生产成品的,当时 @sirwang 和我跑同一个工作流,它的速度快很多,但是画面不忍直视。联系Intel官方支持改了很久,最后不了了之,我就祛魅了。我当时A卡和N卡都跑了,4090 48G和7900XTX,所以那次之后,我再没发视频帮Intel“平反”,当时跑的是LTX2.3刘悦的工作流。
B70 那个成绩是 Intel 官方镜像 + 官方加速包调出来的,AMD 这边是自建 venv 还踩了一堆 ROCm 的坑,连动态显存都没跑通,这种环境下比出来的总耗时不能说明 Intel 硬件比 AMD 强。严格来讲,得把 AMD 也放到同等封装水平的环境里再跑。
英特尔的显卡在Sir Wang放弃之前,它还是要特卡特条,没办法进入通用生产。我说个最简单的问题:7900XTX你不用Docker,早期根本跑不了SG-Lang,但是你用Docker镜像,大神特调的,就是能跑。不过这样的镜像事实上限制很多,意义只是跑起来。
-
@hanber121 有一张卡价格便宜显存大,我想研究研究。双芯的B60pro,24Gx2,这卡得主板支持拆分x8+x8,理论上如果能TP的话会有点意思
-
@fcys 这是个思路,如果可以TP那效果会很不错,但是英特尔的生态地狱,大多数工作流都跑不起来。或许这几个月我没玩,资讯落后了。从纯硬件参数来讲,它也很垃圾。我早期被英特尔骗的太多了。我是不相信在硬件参数垃圾的情况下,它忽然之间咸鱼翻身的。
-
@terry 说实话,跑完之后我到现在都是感觉不太相信,但是反复对比生成的视频质量后,还真没看出来什么区别,所以希望有这个卡的朋友可以复测一下

双芯的那个B60pro 这几天也涨了,我靠了
-
新人报到!最近也是在做B70的测试,纠结要不要退掉。。。把贴主的测试复测了一下:
完全按帖子里 B70 的设置:主模型minimax_h3_fl2va_pruned_int8_convrot,文本编码器qwen3vl_32b_minimax_h3_int8_convrot,视频 VAE int8_convrot,音频 VAE fp32;LoRApika_h3_flex_fl2va_v1_bf16(强度 1.0);lcm6 步,sigma 设为 1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0;BasicGuider,CFG 1.0,不加 shift;124 帧,24 fps;提示词用官方 T2VA 模板自带的;先用 seed 7 预热一轮,再用 seed 12345 正式计时。计时从提交到完成,包含文本编码、采样、VAE 解码和音频封装。SOL 用 ComfyUI 自带的 BlockSparseAttention 节点:sol-attn,tau 1.3,start 0.2,end 1.0,min_tokens 12288,extra_tokens 256,exact_kv_and_rows。分辨率 配置 我的总耗时 我的每步 帖子总耗时 帖子每步 864×480 不开 SOL 48.07 s 6.16 s/it 48.04 s 5.89 s/it 864×480 SOL Attention 45.07 s 5.67 s/it 44.03 s 5.25 s/it 1344×768 不开 SOL 170.4 s 24.89 s/it 172.1 s 24.8 s/it 1344×768 SOL Attention 131.0 s 17.42 s/it 126.07 s 17.1 s/it - 和帖子的差距在 ±4% 以内。稀疏路径的 token 数也完全一样:864×480 是 15787,1344×768 是 38098。
- SOL 带来的提速:864×480 是 1.07 倍,1344×768 是 1.30 倍;帖子分别是 1.09 倍和 1.37 倍。
- 测试期间 B70 平均功耗 265 W,平均频率 2375 MHz,88% 的采样点处于 PL2 功耗墙;芯片最高 72 °C。
- 我的环境是原生 venv(ComfyUI 0.44、PyTorch 2.15),帖子用的是容器(ComfyUI 0.43、PyTorch 2.14),平台也不一样(13600K 对 TRX40),但结果基本一致。
目前自己的测试下来B70表现不错,就是跑高分辨率长流程会一直撞功耗墙,278 W、PL2 降频,频率只有 2183 MHz。之前测试的Wan 14B 1280×704会有一样的问题。不知道贴主有没有遇到功耗墙限制?
-
-
新人报到!最近也是在做B70的测试,纠结要不要退掉。。。把贴主的测试复测了一下:
完全按帖子里 B70 的设置:主模型minimax_h3_fl2va_pruned_int8_convrot,文本编码器qwen3vl_32b_minimax_h3_int8_convrot,视频 VAE int8_convrot,音频 VAE fp32;LoRApika_h3_flex_fl2va_v1_bf16(强度 1.0);lcm6 步,sigma 设为 1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0;BasicGuider,CFG 1.0,不加 shift;124 帧,24 fps;提示词用官方 T2VA 模板自带的;先用 seed 7 预热一轮,再用 seed 12345 正式计时。计时从提交到完成,包含文本编码、采样、VAE 解码和音频封装。SOL 用 ComfyUI 自带的 BlockSparseAttention 节点:sol-attn,tau 1.3,start 0.2,end 1.0,min_tokens 12288,extra_tokens 256,exact_kv_and_rows。分辨率 配置 我的总耗时 我的每步 帖子总耗时 帖子每步 864×480 不开 SOL 48.07 s 6.16 s/it 48.04 s 5.89 s/it 864×480 SOL Attention 45.07 s 5.67 s/it 44.03 s 5.25 s/it 1344×768 不开 SOL 170.4 s 24.89 s/it 172.1 s 24.8 s/it 1344×768 SOL Attention 131.0 s 17.42 s/it 126.07 s 17.1 s/it - 和帖子的差距在 ±4% 以内。稀疏路径的 token 数也完全一样:864×480 是 15787,1344×768 是 38098。
- SOL 带来的提速:864×480 是 1.07 倍,1344×768 是 1.30 倍;帖子分别是 1.09 倍和 1.37 倍。
- 测试期间 B70 平均功耗 265 W,平均频率 2375 MHz,88% 的采样点处于 PL2 功耗墙;芯片最高 72 °C。
- 我的环境是原生 venv(ComfyUI 0.44、PyTorch 2.15),帖子用的是容器(ComfyUI 0.43、PyTorch 2.14),平台也不一样(13600K 对 TRX40),但结果基本一致。
目前自己的测试下来B70表现不错,就是跑高分辨率长流程会一直撞功耗墙,278 W、PL2 降频,频率只有 2183 MHz。之前测试的Wan 14B 1280×704会有一样的问题。不知道贴主有没有遇到功耗墙限制?
@Max-Wang 这也就佐证了B70也算是步入生产力之列了。
-
@Max-Wang 这也就佐证了B70也算是步入生产力之列了。
-
新人报到!最近也是在做B70的测试,纠结要不要退掉。。。把贴主的测试复测了一下:
完全按帖子里 B70 的设置:主模型minimax_h3_fl2va_pruned_int8_convrot,文本编码器qwen3vl_32b_minimax_h3_int8_convrot,视频 VAE int8_convrot,音频 VAE fp32;LoRApika_h3_flex_fl2va_v1_bf16(强度 1.0);lcm6 步,sigma 设为 1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0;BasicGuider,CFG 1.0,不加 shift;124 帧,24 fps;提示词用官方 T2VA 模板自带的;先用 seed 7 预热一轮,再用 seed 12345 正式计时。计时从提交到完成,包含文本编码、采样、VAE 解码和音频封装。SOL 用 ComfyUI 自带的 BlockSparseAttention 节点:sol-attn,tau 1.3,start 0.2,end 1.0,min_tokens 12288,extra_tokens 256,exact_kv_and_rows。分辨率 配置 我的总耗时 我的每步 帖子总耗时 帖子每步 864×480 不开 SOL 48.07 s 6.16 s/it 48.04 s 5.89 s/it 864×480 SOL Attention 45.07 s 5.67 s/it 44.03 s 5.25 s/it 1344×768 不开 SOL 170.4 s 24.89 s/it 172.1 s 24.8 s/it 1344×768 SOL Attention 131.0 s 17.42 s/it 126.07 s 17.1 s/it - 和帖子的差距在 ±4% 以内。稀疏路径的 token 数也完全一样:864×480 是 15787,1344×768 是 38098。
- SOL 带来的提速:864×480 是 1.07 倍,1344×768 是 1.30 倍;帖子分别是 1.09 倍和 1.37 倍。
- 测试期间 B70 平均功耗 265 W,平均频率 2375 MHz,88% 的采样点处于 PL2 功耗墙;芯片最高 72 °C。
- 我的环境是原生 venv(ComfyUI 0.44、PyTorch 2.15),帖子用的是容器(ComfyUI 0.43、PyTorch 2.14),平台也不一样(13600K 对 TRX40),但结果基本一致。
目前自己的测试下来B70表现不错,就是跑高分辨率长流程会一直撞功耗墙,278 W、PL2 降频,频率只有 2183 MHz。之前测试的Wan 14B 1280×704会有一样的问题。不知道贴主有没有遇到功耗墙限制?


 ,我现在比较期待D270了。。。


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!