
7900 XTX 单卡 15 秒实测能跑
-
-
https://lcz.me/topic/2971
https://lcz.me/topic/2998@天知道 @xiongjie-gao @懒人烘培 @jingy-yi
能否统一一下,拿一个一样的工作流,大屌们帮助验证:
单卡5080, 5070Ti的速度,单卡XTX的速度,瓶颈在哪里,有无节点绕过,比如KJ或者其他AMD大神的节点,工作流?暂时我只能云下各位的结果,月底我才有时间折腾这事。 -
https://lcz.me/topic/2971
https://lcz.me/topic/2998@天知道 @xiongjie-gao @懒人烘培 @jingy-yi
能否统一一下,拿一个一样的工作流,大屌们帮助验证:
单卡5080, 5070Ti的速度,单卡XTX的速度,瓶颈在哪里,有无节点绕过,比如KJ或者其他AMD大神的节点,工作流?暂时我只能云下各位的结果,月底我才有时间折腾这事。 -
https://lcz.me/topic/2971
https://lcz.me/topic/2998@天知道 @xiongjie-gao @懒人烘培 @jingy-yi
能否统一一下,拿一个一样的工作流,大屌们帮助验证:
单卡5080, 5070Ti的速度,单卡XTX的速度,瓶颈在哪里,有无节点绕过,比如KJ或者其他AMD大神的节点,工作流?暂时我只能云下各位的结果,月底我才有时间折腾这事。 -
https://lcz.me/topic/2971
https://lcz.me/topic/2998@天知道 @xiongjie-gao @懒人烘培 @jingy-yi
能否统一一下,拿一个一样的工作流,大屌们帮助验证:
单卡5080, 5070Ti的速度,单卡XTX的速度,瓶颈在哪里,有无节点绕过,比如KJ或者其他AMD大神的节点,工作流?暂时我只能云下各位的结果,月底我才有时间折腾这事。@terry 我建议是测官方工作流,容易统一,以下是测试结果:
7900 XTX 跑官方 MiniMax-H3 参考生视频:为什么 OOM、为什么慢,以及怎么把 15 秒 1 MP 压到 23 分钟
平台:AMD Radeon RX 7900 XTX 24 GB(gfx1100),ROCm 7.2,ComfyUI 0.44.2
对象:官方模板video_minimax_h3_r2v.json(参考图生视频),1344×768 / 362 帧 / 15.08 s / 4 步
结论先说:官方图有两个坑——不带分块会在大分配上撞墙,不带注意力后端会慢 5.9 倍。修好这两点,23 分钟出片。
一、环境
项 值 GPU AMD Radeon RX 7900 XTX 24 GB(gfx1100) 系统 / 驱动 Ubuntu 24.04,ROCm 7.2.0 Python / PyTorch 3.12.3 / 2.14.1+rocm7.2 comfy-kitchen 0.2.40 Triton triton-rocm 3.8.0 ComfyUI 0.44.2( e6515b16),前端 1.57.6"原配置"指的就是这台机器原本的显存分配器设置:
PYTORCH_HIP_ALLOC_CONF=garbage_collection_threshold:0.8,max_split_size_mb:256关键在于
max_split_size_mb:256—— 它的含义是"大于 256 MB 的空闲块不再被切分",
也就是保护大块连续内存。这个参数是本帖后半段的主角。下文第 5~8 组实验会把它去掉(只留
gc 0.8)做对照,那是为了定位 OOM 的原因,不是推荐配置。模型:
组件 文件 大小 DiT minimax_h3_ref2va_pruned_int8_convrot.safetensors20.9 GB 文本编码器 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors15 GB 视频 VAE minimax_h3_video_vae_fp16.safetensors4.9 GB 音频 VAE minimax_h3_audio_vae_fp32.safetensors578 MB 加速 LoRA minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors1.0 生成参数(官方模板原样):
- 分辨率
1344×768(16:9,1 MP,multiple=32) - 帧数
362(15.083 s @ 24 fps,H3 训练范围上限) - 步数
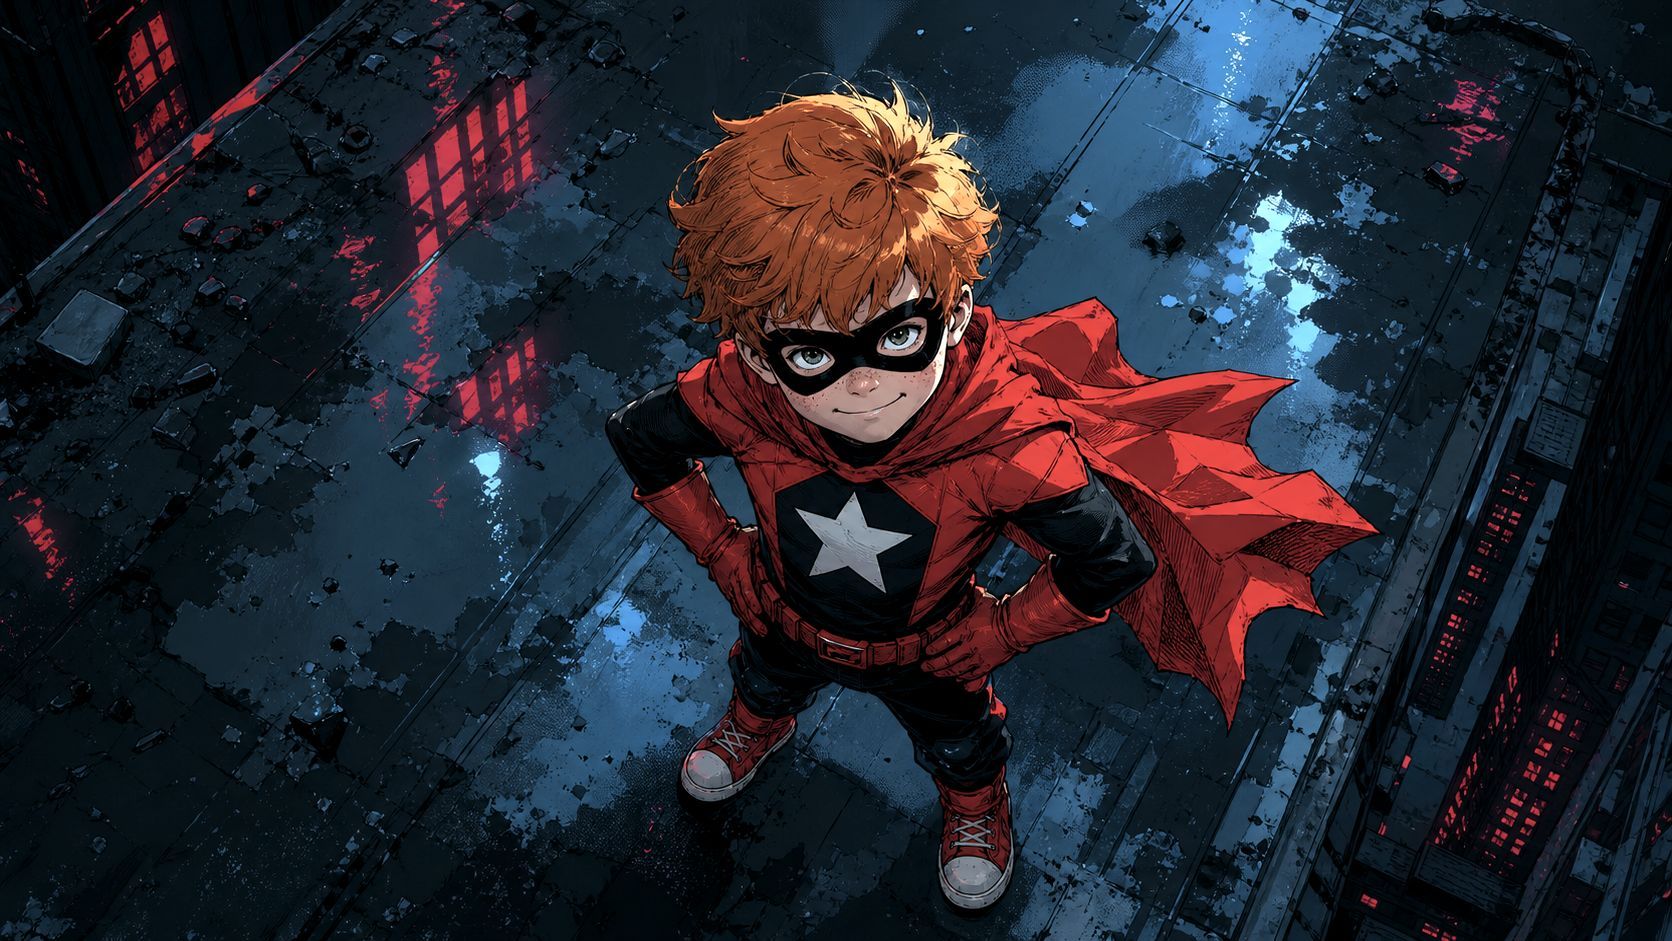
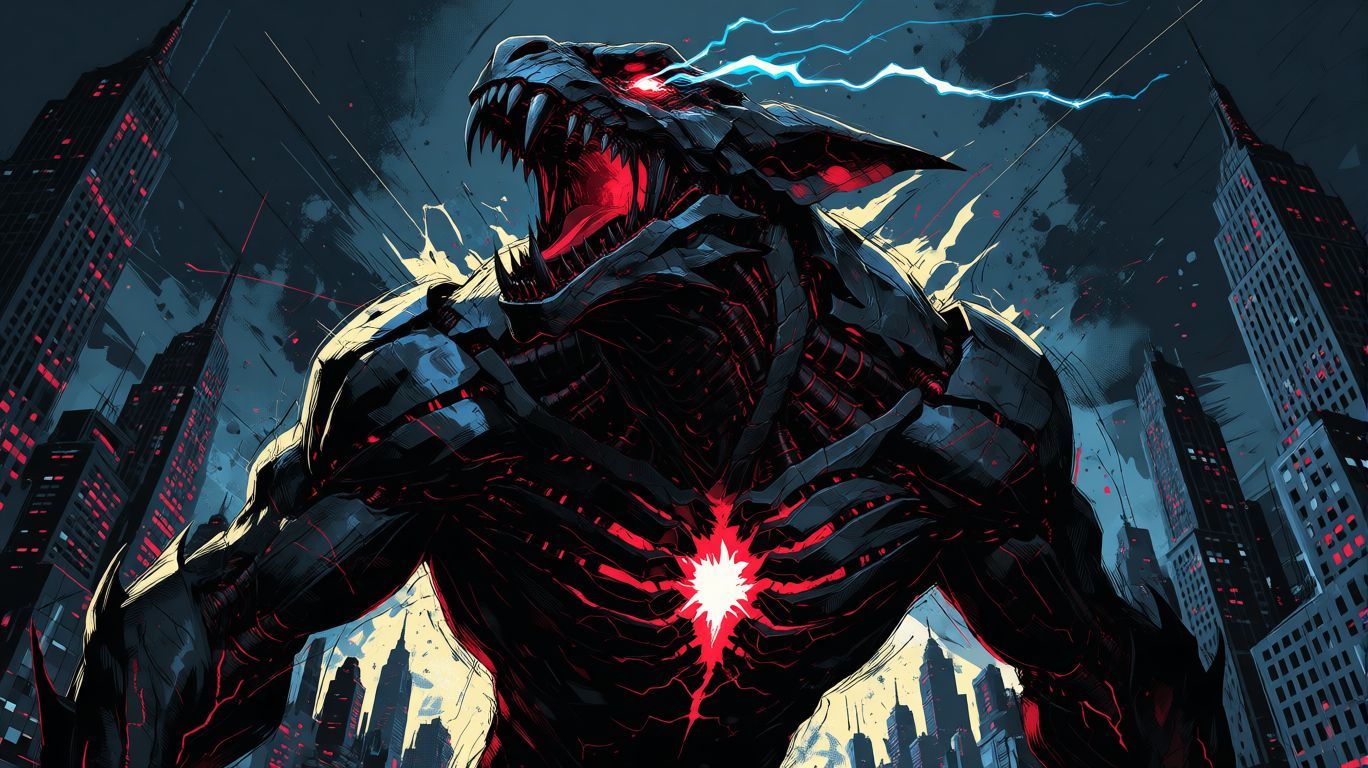
4(turbo LoRA),采样器res_multistep,调度simple,ref_image_size=match - 两张参考图:官方模板自带的
二、测了什么,结果如何
# 图 分配器 结果 1 官方原样(无分块、无注意力后端) 原配置 180 s 探针通过,峰值 23.55 GiB,0 次分配失败 2 官方 + comfy kitchen attention,无分块原配置 23:00 出片,峰值 23.87 GiB,310 s/步 3 同 #2,加一路参考音频(叶奈法.wav) 原配置 300 s 探针无崩、无 OOM,峰值 23.79 GiB 4 官方 + head_chunks=4+chunks=2,无注意力后端只 gc 0.82 步走了 1:00:52(约 30 分钟/步),中断 5 官方原样(无分块、无注意力后端) 只 gc 0.8OOM(约 130 s, Tried to allocate 1.14 GiB, free 344 MiB)6 官方 + ChunkFeedForward(chunks=2, seq=4096)只 gc 0.86 分钟探针通过,峰值 21.30 GiB 7 官方 + ChunkFeedForward(chunks=1, seq=4096)只 gc 0.8OOM(约 60–70 s,峰值 23.58 GiB) 8 官方 + comfy kitchen attention单独只 gc 0.810 秒 OOM: Tried to allocate 6.06 GiB每组都是同一张图、同一提示词、同一 seed,只改上表列的变量。
说明:#4 与 #2 之间除了注意力后端,还差了分块和分配器,不是严格的控制变量。
但分块对速度的影响在别处单独测过约 5~6%(15 s 档 310 s/步 vs 约 325 s/步),
量级远小于 5.9 倍,所以 #4 的"每步 30 分钟"主要归因于缺少注意力后端(推断,非严格隔离)。
三、提示词
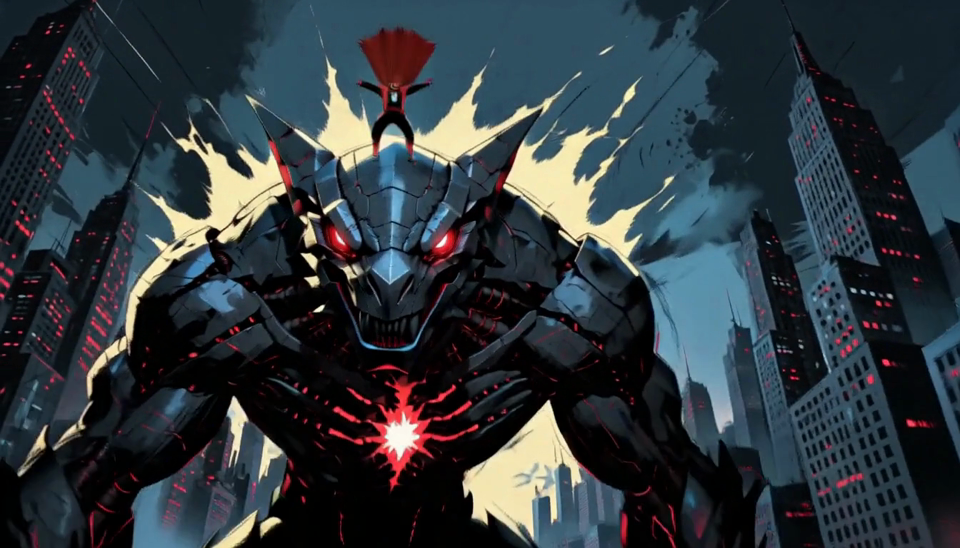
两张参考图分别是「楼顶上的红披风小英雄」和「城市中咆哮的黑金机械巨兽」,所以写成三幕对战:
Bold comic-book ink style, heavy linework, red and blue-black palette, night city rooftop
and skyline. Use <Picture 1> as the little boy superhero and <Picture 2> as the colossal
black mecha-kaiju; keep both designs exactly as drawn.

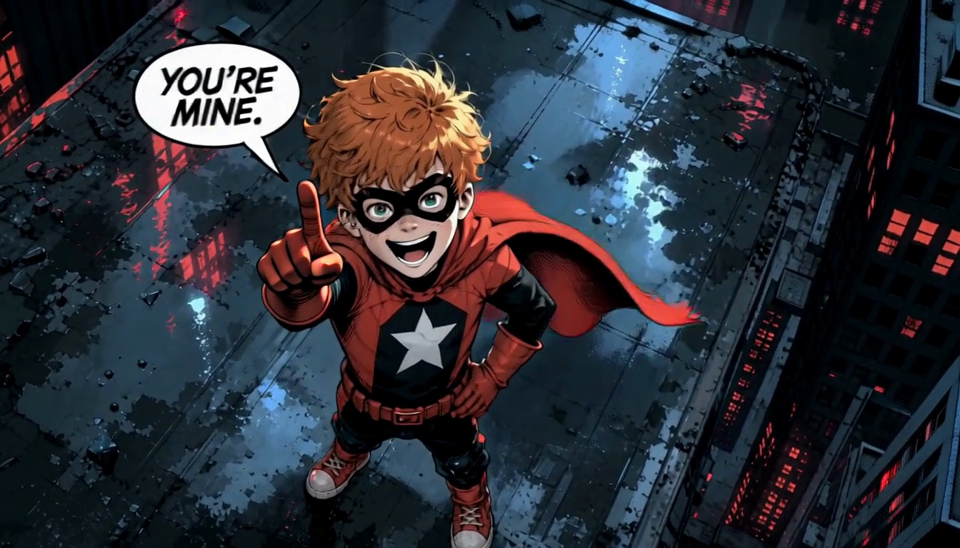
CUT 1: top-down view of the boy superhero on the rooftop, red cape fluttering, hands on
hips, cocky grin. He points straight up at the camera, comic speech bubble: "YOU'RE MINE."
He launches off the roof edge, leaving a red motion blur.
TRANSITION: violent whip pan through rain-streaked air, the skyline smearing past.
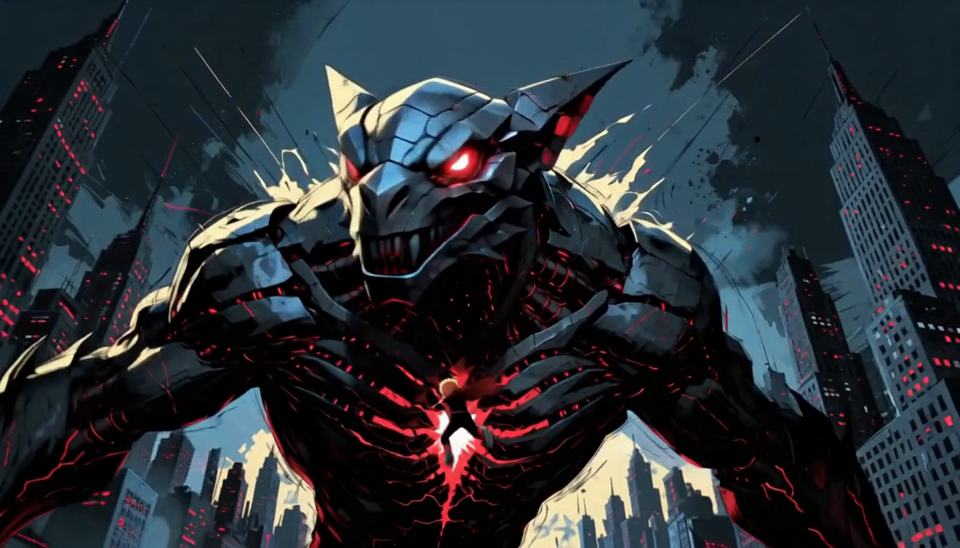
CUT 2: low hero angle as the black mecha-kaiju swings one arm through a skyscraper; the
whole facade explodes outward in a shower of blue-white glass. The boy dodges mid-air in a
tight spin and drives a punch into the kaiju's glowing chest core — a shockwave ring of
white ink bursts outward, jagged speed lines, deafening metal impact and a ground-shaking
roar.
CUT 3: the kaiju rears back and snaps its jaws down; the boy catches the lower jaw with
both hands, boots braced on its teeth, straining as red lightning crawls across the chrome
and its eyes flare blinding red. He flips up onto its head as the camera pulls back to a
wide shot of the ruined street.

SOUND: deep metallic roars, concrete crumbling, rushing wind, heavy impacts, crackling
electricity.
效果:三个 CUT 基本都落地了——第一帧出 "YOU'RE MINE." 的漫画气泡,
中段孩子在巨兽胸口出拳,
结尾站在它头顶。
四、官方工作流为什么会 OOM
官方图在 15 秒 / 1 MP / 双参考下会炸,原因不是总量不够,是单次分配拿不到连续内存。它有两个独立的坑。
坑 1:没有分块节点,大张量要"一整块"内存
H3 是音视频联合模型,362 帧这一档的激活张量很大。官方图里没有
MiniMaxChunkFeedForward/MiniMaxLowVRAMAttention,所以这些张量是「一次要一整块」。而
max_split_size_mb的语义是:大于该尺寸的空闲块不再被切分,它保护大块连续内存。
把它去掉(只留gc 0.8)之后,空闲块会被切碎——总占用变低了,但大分配反而失败:#5:Tried to allocate 1.14 GiB,GPU 总 23.98 GiB,只剩 344 MiB (此时 20.79 GiB 已分配 + 2.22 GiB 保留,总量是够的,但拿不到一段连续的)坑 2:kitchen attention 自己也要一块大 workspace
comfy kitchen attention是融合内核,快,但它会申请 6 GiB 级的一次性 workspace。
没有分块切片时:#8:Requested to allocate 6.06 GiB → 10 秒内 OOM两个坑叠在一起就是大家在论坛上看到的"15 秒必炸"。
我们怎么绕过的
两条,按场景选:
- 日常首选:保留
max_split_size_mb:256,不加分块。
大块连续内存被保护,官方图原样(加注意力后端)就能跑完,峰值 23.87 GiB。 - 重活才加分块:
head_chunks=4+chunks=2。
分块的意义不是"省总显存",而是把每次分配切小——kitchen 的 6 GiB 请求被head_chunks
拆成 4 份,FFN 的序列按chunks拆开。
实测:10 秒视频参考、二采(latent upscale 二次采样)这几类,只有加了 4/2 才过。
单独加chunks=2也能救活 1 MP/15 s(#6,峰值 21.30 GiB)。
 ️ 注意分块的代价:它只降峰值、不改计算量,15 s 这档加
4/2大约慢 5~6%,只省 0.17 GiB。
所以不要默认加,留给真正需要余量的图。
五、官方工作流为什么慢
官方图里没有
ModelAttentionBackend节点,H3 走 ComfyUI 默认的 pytorch attention。
在 362 帧这种长序列上,它比comfy kitchen attention差一个数量级:同一张官方图 每步 四步采样 默认 pytorch attention(#4,另带 4/2 分块、只 gc) 1823–1842 s 约 2 小时 comfy kitchen attention(#2,无分块、原配置)310 s 20 分 40 秒 差约 5.9 倍。 注意这两组还差了分块与分配器:分块实测只影响 5~6%,所以主导因素是注意力后端
(这是归因推断,没做"只换注意力后端、其余完全相同"的隔离实验)。为什么差这么多:注意力耗时随 token 数超线性增长,而 362 帧的 token 数是 124 帧的近 3 倍。
小片段里这一个节点只占几秒,长片段里它变成主要成本。怎么提速
在官方图里插一个节点:
UNETLoader → LoraLoaderModelOnly → ModelAttentionBackend(attention="comfy kitchen attention") → BasicGuider其他全部保持官方原样。结果:
- 采样 4 步 20:40(310 s/步)
- 总耗时 23:00(含编码、解码、封装)
- 峰值 23.87 GiB / 24 GiB
顺带澄清一个旧结论:小片段(5 秒 / 124 帧)下 kitchen attention 几乎没有加速(448 s vs 440 s)。
那时每步只要 56 s,注意力占比小。15 秒这一档完全是另一回事,别拿 5 秒的数据外推。
六、其他试过、确认没用的
尝试 结果 4-bit 权重模型( w4a8,11 GB,体积砍半)不提速(表面 4% 是条件缓存的口径假象)、显存只省 0.44 GiB、画质明显掉(机械臂细节糊掉)。继续用 int8 --enable-triton-backend(int8 GEMM 换 Triton 内核)慢 10%,第二次运行段错误( segfault at 100000001),靠看门狗重启expandable_segments:True5~10 秒直接 hipErrorOutOfMemory换更小的文本编码器 不存在。32B VLM,nvfp4 15 GB 已是 4bit 极限;GGUF Q4 反而 18.4 GB 让编码器不驻留( device=cpu)没必要。124 帧档实测:编码器加载 vs 不加载,峰值完全相同(22.74 GiB),只差 80 秒编码时间
七、还有哪些不确定
- 单次运行、单 seed、单提示词,没有跑多次取中位。23:00 这个数可能有两三分钟波动。
- 显存是 0.5 秒采样一次,可能漏掉瞬时尖峰,23.87 GiB 是采样到的最大值,真实峰值可能更高。
- 带参考音频只跑了 300 秒探针,没有完整出片。300 秒里过了编码和第一步的大部分,但没验证全片。
- kitchen attention 的稳定性:https://lcz.me/topic/2920有一例 int8 + kitchen 在满尺寸崩
hipErrorIllegalAddress
(崩在音频 VAE 解码),本次没复现。但也无法证明它不会偶发。 - "6 GiB workspace"是从 OOM 报错反推的,没有 profiler 佐证;机制解释成立,具体数值是推断。
- 为什么 5 秒没加速、15 秒快 5.9 倍:只有两个数据点。"注意力占比随序列长度平方增长"是合理推断,
但没有中间档(8 秒、10 秒)的实测。 res_multistepvseuler、是否加MiniMaxH3SigmaShift没有做控制变量对比,都是官方参数照用。max_split_size_mb与分块的组合只测了少数几格(0/1/2 块 × 两种分配器),
中间值(例如 512、1024)没试。- 结论只对 7900 XTX + ROCm 7.2 + 这一版 ComfyUI 成立,其他卡/其他 ROCm 版本需要重测。
- 官方模板里
<Audio 1>是占位符(原图并没有接音频),所以我们测音频参考时是手动补的LoadAudio。
八、复现
- 用官方模板
video_minimax_h3_r2v.json,两张参考图用模板自带的。 - 分配器保持原样:
garbage_collection_threshold:0.8,max_split_size_mb:256。
(后面实验里"只 gc"指的就是把max_split_size_mb去掉,只为对照,不是推荐配置。) - 在
LoraLoaderModelOnly和BasicGuider之间插ModelAttentionBackend,选comfy kitchen attention。 - 分辨率 1344×768、帧数 362、4 步、
res_multistep+simple。 - 重活(视频参考 / 二采)再插
MiniMaxLowVRAMAttention(head_chunks=4)和
MiniMaxChunkFeedForward(chunks=2, seq_threshold=4096)。
预期:15 秒 1 MP 双参考,23 分钟左右出片,峰值约 23.8 GiB(余量只剩 100 多 MiB,跑的时候别占显卡)。
本文所有数字都是本机实测;标注为"推断"的部分没有实测支撑。
- 分辨率
-
-
-
@terry 我建议是测官方工作流,容易统一,以下是测试结果:
7900 XTX 跑官方 MiniMax-H3 参考生视频:为什么 OOM、为什么慢,以及怎么把 15 秒 1 MP 压到 23 分钟
平台:AMD Radeon RX 7900 XTX 24 GB(gfx1100),ROCm 7.2,ComfyUI 0.44.2
对象:官方模板video_minimax_h3_r2v.json(参考图生视频),1344×768 / 362 帧 / 15.08 s / 4 步
结论先说:官方图有两个坑——不带分块会在大分配上撞墙,不带注意力后端会慢 5.9 倍。修好这两点,23 分钟出片。
一、环境
项 值 GPU AMD Radeon RX 7900 XTX 24 GB(gfx1100) 系统 / 驱动 Ubuntu 24.04,ROCm 7.2.0 Python / PyTorch 3.12.3 / 2.14.1+rocm7.2 comfy-kitchen 0.2.40 Triton triton-rocm 3.8.0 ComfyUI 0.44.2( e6515b16),前端 1.57.6"原配置"指的就是这台机器原本的显存分配器设置:
PYTORCH_HIP_ALLOC_CONF=garbage_collection_threshold:0.8,max_split_size_mb:256关键在于
max_split_size_mb:256—— 它的含义是"大于 256 MB 的空闲块不再被切分",
也就是保护大块连续内存。这个参数是本帖后半段的主角。下文第 5~8 组实验会把它去掉(只留
gc 0.8)做对照,那是为了定位 OOM 的原因,不是推荐配置。模型:
组件 文件 大小 DiT minimax_h3_ref2va_pruned_int8_convrot.safetensors20.9 GB 文本编码器 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors15 GB 视频 VAE minimax_h3_video_vae_fp16.safetensors4.9 GB 音频 VAE minimax_h3_audio_vae_fp32.safetensors578 MB 加速 LoRA minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors1.0 生成参数(官方模板原样):
- 分辨率
1344×768(16:9,1 MP,multiple=32) - 帧数
362(15.083 s @ 24 fps,H3 训练范围上限) - 步数
4(turbo LoRA),采样器res_multistep,调度simple,ref_image_size=match - 两张参考图:官方模板自带的
二、测了什么,结果如何
# 图 分配器 结果 1 官方原样(无分块、无注意力后端) 原配置 180 s 探针通过,峰值 23.55 GiB,0 次分配失败 2 官方 + comfy kitchen attention,无分块原配置 23:00 出片,峰值 23.87 GiB,310 s/步 3 同 #2,加一路参考音频(叶奈法.wav) 原配置 300 s 探针无崩、无 OOM,峰值 23.79 GiB 4 官方 + head_chunks=4+chunks=2,无注意力后端只 gc 0.82 步走了 1:00:52(约 30 分钟/步),中断 5 官方原样(无分块、无注意力后端) 只 gc 0.8OOM(约 130 s, Tried to allocate 1.14 GiB, free 344 MiB)6 官方 + ChunkFeedForward(chunks=2, seq=4096)只 gc 0.86 分钟探针通过,峰值 21.30 GiB 7 官方 + ChunkFeedForward(chunks=1, seq=4096)只 gc 0.8OOM(约 60–70 s,峰值 23.58 GiB) 8 官方 + comfy kitchen attention单独只 gc 0.810 秒 OOM: Tried to allocate 6.06 GiB每组都是同一张图、同一提示词、同一 seed,只改上表列的变量。
说明:#4 与 #2 之间除了注意力后端,还差了分块和分配器,不是严格的控制变量。
但分块对速度的影响在别处单独测过约 5~6%(15 s 档 310 s/步 vs 约 325 s/步),
量级远小于 5.9 倍,所以 #4 的"每步 30 分钟"主要归因于缺少注意力后端(推断,非严格隔离)。
三、提示词
两张参考图分别是「楼顶上的红披风小英雄」和「城市中咆哮的黑金机械巨兽」,所以写成三幕对战:
Bold comic-book ink style, heavy linework, red and blue-black palette, night city rooftop
and skyline. Use <Picture 1> as the little boy superhero and <Picture 2> as the colossal
black mecha-kaiju; keep both designs exactly as drawn.

CUT 1: top-down view of the boy superhero on the rooftop, red cape fluttering, hands on
hips, cocky grin. He points straight up at the camera, comic speech bubble: "YOU'RE MINE."
He launches off the roof edge, leaving a red motion blur.
TRANSITION: violent whip pan through rain-streaked air, the skyline smearing past.
CUT 2: low hero angle as the black mecha-kaiju swings one arm through a skyscraper; the
whole facade explodes outward in a shower of blue-white glass. The boy dodges mid-air in a
tight spin and drives a punch into the kaiju's glowing chest core — a shockwave ring of
white ink bursts outward, jagged speed lines, deafening metal impact and a ground-shaking
roar.
CUT 3: the kaiju rears back and snaps its jaws down; the boy catches the lower jaw with
both hands, boots braced on its teeth, straining as red lightning crawls across the chrome
and its eyes flare blinding red. He flips up onto its head as the camera pulls back to a
wide shot of the ruined street.

SOUND: deep metallic roars, concrete crumbling, rushing wind, heavy impacts, crackling
electricity.
效果:三个 CUT 基本都落地了——第一帧出 "YOU'RE MINE." 的漫画气泡,
中段孩子在巨兽胸口出拳,
结尾站在它头顶。
四、官方工作流为什么会 OOM
官方图在 15 秒 / 1 MP / 双参考下会炸,原因不是总量不够,是单次分配拿不到连续内存。它有两个独立的坑。
坑 1:没有分块节点,大张量要"一整块"内存
H3 是音视频联合模型,362 帧这一档的激活张量很大。官方图里没有
MiniMaxChunkFeedForward/MiniMaxLowVRAMAttention,所以这些张量是「一次要一整块」。而
max_split_size_mb的语义是:大于该尺寸的空闲块不再被切分,它保护大块连续内存。
把它去掉(只留gc 0.8)之后,空闲块会被切碎——总占用变低了,但大分配反而失败:#5:Tried to allocate 1.14 GiB,GPU 总 23.98 GiB,只剩 344 MiB (此时 20.79 GiB 已分配 + 2.22 GiB 保留,总量是够的,但拿不到一段连续的)坑 2:kitchen attention 自己也要一块大 workspace
comfy kitchen attention是融合内核,快,但它会申请 6 GiB 级的一次性 workspace。
没有分块切片时:#8:Requested to allocate 6.06 GiB → 10 秒内 OOM两个坑叠在一起就是大家在论坛上看到的"15 秒必炸"。
我们怎么绕过的
两条,按场景选:
- 日常首选:保留
max_split_size_mb:256,不加分块。
大块连续内存被保护,官方图原样(加注意力后端)就能跑完,峰值 23.87 GiB。 - 重活才加分块:
head_chunks=4+chunks=2。
分块的意义不是"省总显存",而是把每次分配切小——kitchen 的 6 GiB 请求被head_chunks
拆成 4 份,FFN 的序列按chunks拆开。
实测:10 秒视频参考、二采(latent upscale 二次采样)这几类,只有加了 4/2 才过。
单独加chunks=2也能救活 1 MP/15 s(#6,峰值 21.30 GiB)。
️ 注意分块的代价:它只降峰值、不改计算量,15 s 这档加 4/2大约慢 5~6%,只省 0.17 GiB。
所以不要默认加,留给真正需要余量的图。
五、官方工作流为什么慢
官方图里没有
ModelAttentionBackend节点,H3 走 ComfyUI 默认的 pytorch attention。
在 362 帧这种长序列上,它比comfy kitchen attention差一个数量级:同一张官方图 每步 四步采样 默认 pytorch attention(#4,另带 4/2 分块、只 gc) 1823–1842 s 约 2 小时 comfy kitchen attention(#2,无分块、原配置)310 s 20 分 40 秒 差约 5.9 倍。 注意这两组还差了分块与分配器:分块实测只影响 5~6%,所以主导因素是注意力后端
(这是归因推断,没做"只换注意力后端、其余完全相同"的隔离实验)。为什么差这么多:注意力耗时随 token 数超线性增长,而 362 帧的 token 数是 124 帧的近 3 倍。
小片段里这一个节点只占几秒,长片段里它变成主要成本。怎么提速
在官方图里插一个节点:
UNETLoader → LoraLoaderModelOnly → ModelAttentionBackend(attention="comfy kitchen attention") → BasicGuider其他全部保持官方原样。结果:
- 采样 4 步 20:40(310 s/步)
- 总耗时 23:00(含编码、解码、封装)
- 峰值 23.87 GiB / 24 GiB
顺带澄清一个旧结论:小片段(5 秒 / 124 帧)下 kitchen attention 几乎没有加速(448 s vs 440 s)。
那时每步只要 56 s,注意力占比小。15 秒这一档完全是另一回事,别拿 5 秒的数据外推。
六、其他试过、确认没用的
尝试 结果 4-bit 权重模型( w4a8,11 GB,体积砍半)不提速(表面 4% 是条件缓存的口径假象)、显存只省 0.44 GiB、画质明显掉(机械臂细节糊掉)。继续用 int8 --enable-triton-backend(int8 GEMM 换 Triton 内核)慢 10%,第二次运行段错误( segfault at 100000001),靠看门狗重启expandable_segments:True5~10 秒直接 hipErrorOutOfMemory换更小的文本编码器 不存在。32B VLM,nvfp4 15 GB 已是 4bit 极限;GGUF Q4 反而 18.4 GB 让编码器不驻留( device=cpu)没必要。124 帧档实测:编码器加载 vs 不加载,峰值完全相同(22.74 GiB),只差 80 秒编码时间
七、还有哪些不确定
- 单次运行、单 seed、单提示词,没有跑多次取中位。23:00 这个数可能有两三分钟波动。
- 显存是 0.5 秒采样一次,可能漏掉瞬时尖峰,23.87 GiB 是采样到的最大值,真实峰值可能更高。
- 带参考音频只跑了 300 秒探针,没有完整出片。300 秒里过了编码和第一步的大部分,但没验证全片。
- kitchen attention 的稳定性:https://lcz.me/topic/2920有一例 int8 + kitchen 在满尺寸崩
hipErrorIllegalAddress
(崩在音频 VAE 解码),本次没复现。但也无法证明它不会偶发。 - "6 GiB workspace"是从 OOM 报错反推的,没有 profiler 佐证;机制解释成立,具体数值是推断。
- 为什么 5 秒没加速、15 秒快 5.9 倍:只有两个数据点。"注意力占比随序列长度平方增长"是合理推断,
但没有中间档(8 秒、10 秒)的实测。 res_multistepvseuler、是否加MiniMaxH3SigmaShift没有做控制变量对比,都是官方参数照用。max_split_size_mb与分块的组合只测了少数几格(0/1/2 块 × 两种分配器),
中间值(例如 512、1024)没试。- 结论只对 7900 XTX + ROCm 7.2 + 这一版 ComfyUI 成立,其他卡/其他 ROCm 版本需要重测。
- 官方模板里
<Audio 1>是占位符(原图并没有接音频),所以我们测音频参考时是手动补的LoadAudio。
八、复现
- 用官方模板
video_minimax_h3_r2v.json,两张参考图用模板自带的。 - 分配器保持原样:
garbage_collection_threshold:0.8,max_split_size_mb:256。
(后面实验里"只 gc"指的就是把max_split_size_mb去掉,只为对照,不是推荐配置。) - 在
LoraLoaderModelOnly和BasicGuider之间插ModelAttentionBackend,选comfy kitchen attention。 - 分辨率 1344×768、帧数 362、4 步、
res_multistep+simple。 - 重活(视频参考 / 二采)再插
MiniMaxLowVRAMAttention(head_chunks=4)和
MiniMaxChunkFeedForward(chunks=2, seq_threshold=4096)。
预期:15 秒 1 MP 双参考,23 分钟左右出片,峰值约 23.8 GiB(余量只剩 100 多 MiB,跑的时候别占显卡)。
本文所有数字都是本机实测;标注为"推断"的部分没有实测支撑。
- 分辨率
-
-
https://lcz.me/topic/2971
https://lcz.me/topic/2998@天知道 @xiongjie-gao @懒人烘培 @jingy-yi
能否统一一下,拿一个一样的工作流,大屌们帮助验证:
单卡5080, 5070Ti的速度,单卡XTX的速度,瓶颈在哪里,有无节点绕过,比如KJ或者其他AMD大神的节点,工作流?暂时我只能云下各位的结果,月底我才有时间折腾这事。@terry 5080也抽时间测试了,用得是统一工作流,结果如下:
RTX 5080 16GB 单卡实测 MiniMax H3 15 秒出片,对比 RX 7900 XTX
7900 XTX之前已测试,现在用单张 RTX 5080 16GB 跑了两组 MiniMax H3 Ref2VA 工作流,每组只启用一个 KJ 节点。
5080 两组都完整出片,未发生 OOM。两段 MP4 均经 FFmpeg 核验为 1344×768、24 fps、362 帧、15.08 秒,带非静音 AAC 音轨。两段音轨的解码峰值均为 −17.1 dBFS。
单卡耗时与显存
单独启用的节点 RTX 5080 工作流耗时 RTX 5080 整卡显存峰值 RX 7900 XTX 工作流耗时 RX 7900 XTX 整卡显存峰值 MiniMax H3 Low VRAM Attention,4 组 27 分 51 秒 14.46 GiB 36 分 52 秒 12.75 GiB MiniMax H3 Chunk FeedForward,4 块 28 分 54 秒 13.37 GiB 36 分 33 秒 10.81 GiB 5080 的显存峰值由
nvidia-smi每秒采样一次,包含桌面等其他进程的显存占用。7900 XTX 数据引用之前的测试数据(https://lcz.me/topic/2920/16)。- 速度 相对帖子里的 7900 XTX 数据,5080 的 Attention 组少用 9 分 01 秒(24.5%),FeedForward 组少用 7 分 39 秒(20.9%)。
- 显存 两张卡上都是 FeedForward 组峰值更低。5080 低 1.09 GiB,7900 XTX 低 1.94 GiB。5080 上 Attention 组快 1 分 03 秒,7900 XTX 上 FeedForward 组快 19 秒。
测试配置
两边均为单卡、每组只启用一个 KJ 节点,使用
--novram --disable-async-offload、Euler / beta 8 步,均未加载 LoRA。5080 两组共用同一份本地权重、提示词、随机种子和参考音频。配置 RTX 5080 RX 7900 XTX Attention 后端 PyTorch CUDA Attention CK Attention( --use-ck-attention)文本编码器 Q2_K GGUF INT8 最终音频解码 GPU CPU,帖子记录 GPU 探针触发 HIP 非法内存访问 跨卡的耗时和显存差包含 Attention 后端、文本编码器和音频解码路径的影响,暂时无法把差异单独归因于显卡。
瓶颈在哪里,有没有节点绕过?
5080 的主要耗时在采样。 Attention 组 8 步采样用 23 分 04 秒,FeedForward 组用 24 分 13 秒,分别约占工作流总耗时的 83% 和 84%。采样期间 GPU 利用率多次达到 100%,日志也有权重卸载和锁页内存警告。现有日志能定位到采样阶段,算子计算与权重传输各占多少还需要分段测量。
7900 XTX 早期复现的瓶颈出现在首步采样。 帖子里
--lowvram出现约 5.89 GiB 的分配失败警告,--novram的一次运行超过 21 分钟仍未完成首步。分别接入两个 KJ 节点后均能完整出片。帖子里的真实 H3 权重单层对照也显示,约 10.8 万 token 时,FeedForward 四分块把该层的额外显存峰值从 8.36 GiB 降到 3.23 GiB,抽样输出一致。两条 KJ 路径都已验证可用。 在这次 5080 实测里,Attention 四组总耗时更短,FeedForward 四块显存峰值更低。7900 XTX 帖子还验证了另一条 H3 Streamed Blocks 路径,约 50 分 36 秒出片,整卡峰值约 6.98 GiB。两边目前都缺少相同公共配置下关闭两个 KJ 节点的完整出片基线。
补充:RTX 5080 的两组测试均未加载加速 LoRA,均使用 Euler / beta 跑满 8 步。对照的 RX 7900 XTX 两组也未加载加速 LoRA。
-
@天知道 @懒人烘培
杰杰的最新帖子:https://lcz.me/topic/3035
看看单卡方案有无帮助,有什么提升。 -
@天知道 @懒人烘培
杰杰的最新帖子:https://lcz.me/topic/3035
看看单卡方案有无帮助,有什么提升。 -
在自己帖子补一个,方便同涡轮卡参考(话说我是不是应该改一下帖子标题,注明涡轮卡?)
我是蓝宝石的涡轮卡(不是常见的零售三风扇版)。照着自己的机器做了三组对照,把能抄的和抄不了的都写一下。
一、先说我这张卡:蓝宝石涡轮版
- 品牌型号:蓝宝石 7900 XTX 涡轮版
- 功耗上限默认 257 W(可调范围 231~350 W)
- 一般零售 7900 XTX 是 339~355 W、boost 约 2500 MHz(说明一下:楼主和下面复测的朋友用的具体型号帖子里没写,这里只是按零售版推测,没有核实)
- 实测:257 W 时约 2200 MHz;提到 350 W 后在 2200~2480 MHz 之间来回跳
所以楼主的 TP2 那部分(1 MP 时 2.30×)单卡抄不了;能抄的是环境自查和注意力那一段。
二、DynamicVRAM 在我这儿开不了
按帖子参数试的:
--enable-dynamic-vram --use-ck-attention --mmap-torch-files。aimdo 本身能起来(
comfy-aimdo 0.6.0,识别到 24560 MB),但第一个 VAE 编码触发的部分卸载就崩:aimdo: model-vbar.c:269 ERROR: Could not reserve Virtual Address space for VBAR MemoryError: VBAR allocation failed10 秒结束,一步都没跑。系统限制我都排除了:
vm.overcommit_memory=0、vm.max_map_count=1048576、服务LimitAS/DATA=infinity,都正常。差别在版本:我用的是 ROCm 7.2.0(发行版包),楼主环境是 7.2.26015(更新的构建)。结论就是 VBAR 这套虚拟地址预留机制在我这个构建上用不了,要开 DV 得升级 ROCm 且 torch 同源,风险太大,暂时不开。三、试着提功耗:只有 6%,撞的是温度墙
同一配置:832×480 / 362 帧 / 4 步 / res_multistep,int8 20.9 GB + nvfp4 编码器 + kitchen attention,无分块。
功耗上限 s/it 采样 端到端 峰值显存 257 W(默认) 65.14 4:20 390.4 s 23.96 GiB 350 W 61.06 4:04 380.5 s 23.93 GiB 只快了 6.3%。350 W 那轮的温度:edge 79 °C、junction(热点)104 °C、显存 84 °C,而 junction 限值是 110 °C。
关键在功耗数字:平均只有 243 W,离 350 W 上限还差 30%。所以不是撞功耗墙,是撞温度墙——热点到 104 °C 后 SMU 自己压频,功耗自然上不去。结论:不固化 350 W,已还原 257 W。为 6% 常年 95~104 °C 不值得。
四、单卡校准:确实慢,但不是降级路径
和帖子里 @6cccccc 的单卡复测对照:
- 832×480 / 362 帧 / 4 步:我 65.14 s/it,他 50.58,慢 29%
- 1 MP / 362 帧 / 4 步:我 310 s/步,他 245.67,慢 26%
两档差距一致,说明我不是踩到了降级路径(真降级是 259 s/it 那种量级),而是硬件/配置整体差一截;顺带也验证了 kitchen attention 在我这儿是通的。差距里有一部分大概率的来源是卡:涡轮版的功耗和频率上限都比零售版低,但对方到底是哪张卡我并不确定,只能说是推测。
当前极限:0.4 MP / 362 帧 = 65 s/it;1 MP / 362 帧 = 310 s/步。
后面还没试的方向:undervolt(同频降温,也许能让 350 W 站得住)、ROCm 升级后开 DV、以及算法层的 3 步 LoRA / 时间维切段 / 降分辨率。暂时到这儿,有新招再来更新。
-
在自己帖子补一个,方便同涡轮卡参考(话说我是不是应该改一下帖子标题,注明涡轮卡?)
我是蓝宝石的涡轮卡(不是常见的零售三风扇版)。照着自己的机器做了三组对照,把能抄的和抄不了的都写一下。
一、先说我这张卡:蓝宝石涡轮版
- 品牌型号:蓝宝石 7900 XTX 涡轮版
- 功耗上限默认 257 W(可调范围 231~350 W)
- 一般零售 7900 XTX 是 339~355 W、boost 约 2500 MHz(说明一下:楼主和下面复测的朋友用的具体型号帖子里没写,这里只是按零售版推测,没有核实)
- 实测:257 W 时约 2200 MHz;提到 350 W 后在 2200~2480 MHz 之间来回跳
所以楼主的 TP2 那部分(1 MP 时 2.30×)单卡抄不了;能抄的是环境自查和注意力那一段。
二、DynamicVRAM 在我这儿开不了
按帖子参数试的:
--enable-dynamic-vram --use-ck-attention --mmap-torch-files。aimdo 本身能起来(
comfy-aimdo 0.6.0,识别到 24560 MB),但第一个 VAE 编码触发的部分卸载就崩:aimdo: model-vbar.c:269 ERROR: Could not reserve Virtual Address space for VBAR MemoryError: VBAR allocation failed10 秒结束,一步都没跑。系统限制我都排除了:
vm.overcommit_memory=0、vm.max_map_count=1048576、服务LimitAS/DATA=infinity,都正常。差别在版本:我用的是 ROCm 7.2.0(发行版包),楼主环境是 7.2.26015(更新的构建)。结论就是 VBAR 这套虚拟地址预留机制在我这个构建上用不了,要开 DV 得升级 ROCm 且 torch 同源,风险太大,暂时不开。三、试着提功耗:只有 6%,撞的是温度墙
同一配置:832×480 / 362 帧 / 4 步 / res_multistep,int8 20.9 GB + nvfp4 编码器 + kitchen attention,无分块。
功耗上限 s/it 采样 端到端 峰值显存 257 W(默认) 65.14 4:20 390.4 s 23.96 GiB 350 W 61.06 4:04 380.5 s 23.93 GiB 只快了 6.3%。350 W 那轮的温度:edge 79 °C、junction(热点)104 °C、显存 84 °C,而 junction 限值是 110 °C。
关键在功耗数字:平均只有 243 W,离 350 W 上限还差 30%。所以不是撞功耗墙,是撞温度墙——热点到 104 °C 后 SMU 自己压频,功耗自然上不去。结论:不固化 350 W,已还原 257 W。为 6% 常年 95~104 °C 不值得。
四、单卡校准:确实慢,但不是降级路径
和帖子里 @6cccccc 的单卡复测对照:
- 832×480 / 362 帧 / 4 步:我 65.14 s/it,他 50.58,慢 29%
- 1 MP / 362 帧 / 4 步:我 310 s/步,他 245.67,慢 26%
两档差距一致,说明我不是踩到了降级路径(真降级是 259 s/it 那种量级),而是硬件/配置整体差一截;顺带也验证了 kitchen attention 在我这儿是通的。差距里有一部分大概率的来源是卡:涡轮版的功耗和频率上限都比零售版低,但对方到底是哪张卡我并不确定,只能说是推测。
当前极限:0.4 MP / 362 帧 = 65 s/it;1 MP / 362 帧 = 310 s/步。
后面还没试的方向:undervolt(同频降温,也许能让 350 W 站得住)、ROCm 升级后开 DV、以及算法层的 3 步 LoRA / 时间维切段 / 降分辨率。暂时到这儿,有新招再来更新。
两档差距一致,说明我不是踩到了降级路径(真降级是 259 s/it 那种量级),而是硬件/配置整体差一截;顺带也验证了 kitchen attention 在我这儿是通的。差距里有一部分大概率的来源是卡:涡轮版的功耗和频率上限都比零售版低,但对方到底是哪张卡我并不确定,只能说是推测。
这个判断应该是正确的,结温过高导致降频。
这问题就有点麻爪了,涡轮卡的温度上限这么低?还是你的新卡导热没做好。要不要换张相变片? -
-
-
没想到情况这么复杂,还和散热有关,关于散热,我以前测试的时候蓝宝石的白金版,就是丐版在很多时候表现确实好于讯景的卡,当时很多人反应显卡过热,噪音过大,我都没遇到过。我的卡是系统默认303w,噪音最大的时候也能忍受。不过我很久没玩ComfyUI了,就之前测试过ltx2.3和H3刚发布的时候玩过。4090D的功耗如果打墙了,也会慢很多。




