寻找QFN长上下文的甜点位测试
-
结论
保守可用512K,考虑到一般agent 0.8的压缩阈值,高一点可用640K。
测试环境
模型:Qwen3.8-Flash-Next IQ3_S GGUF
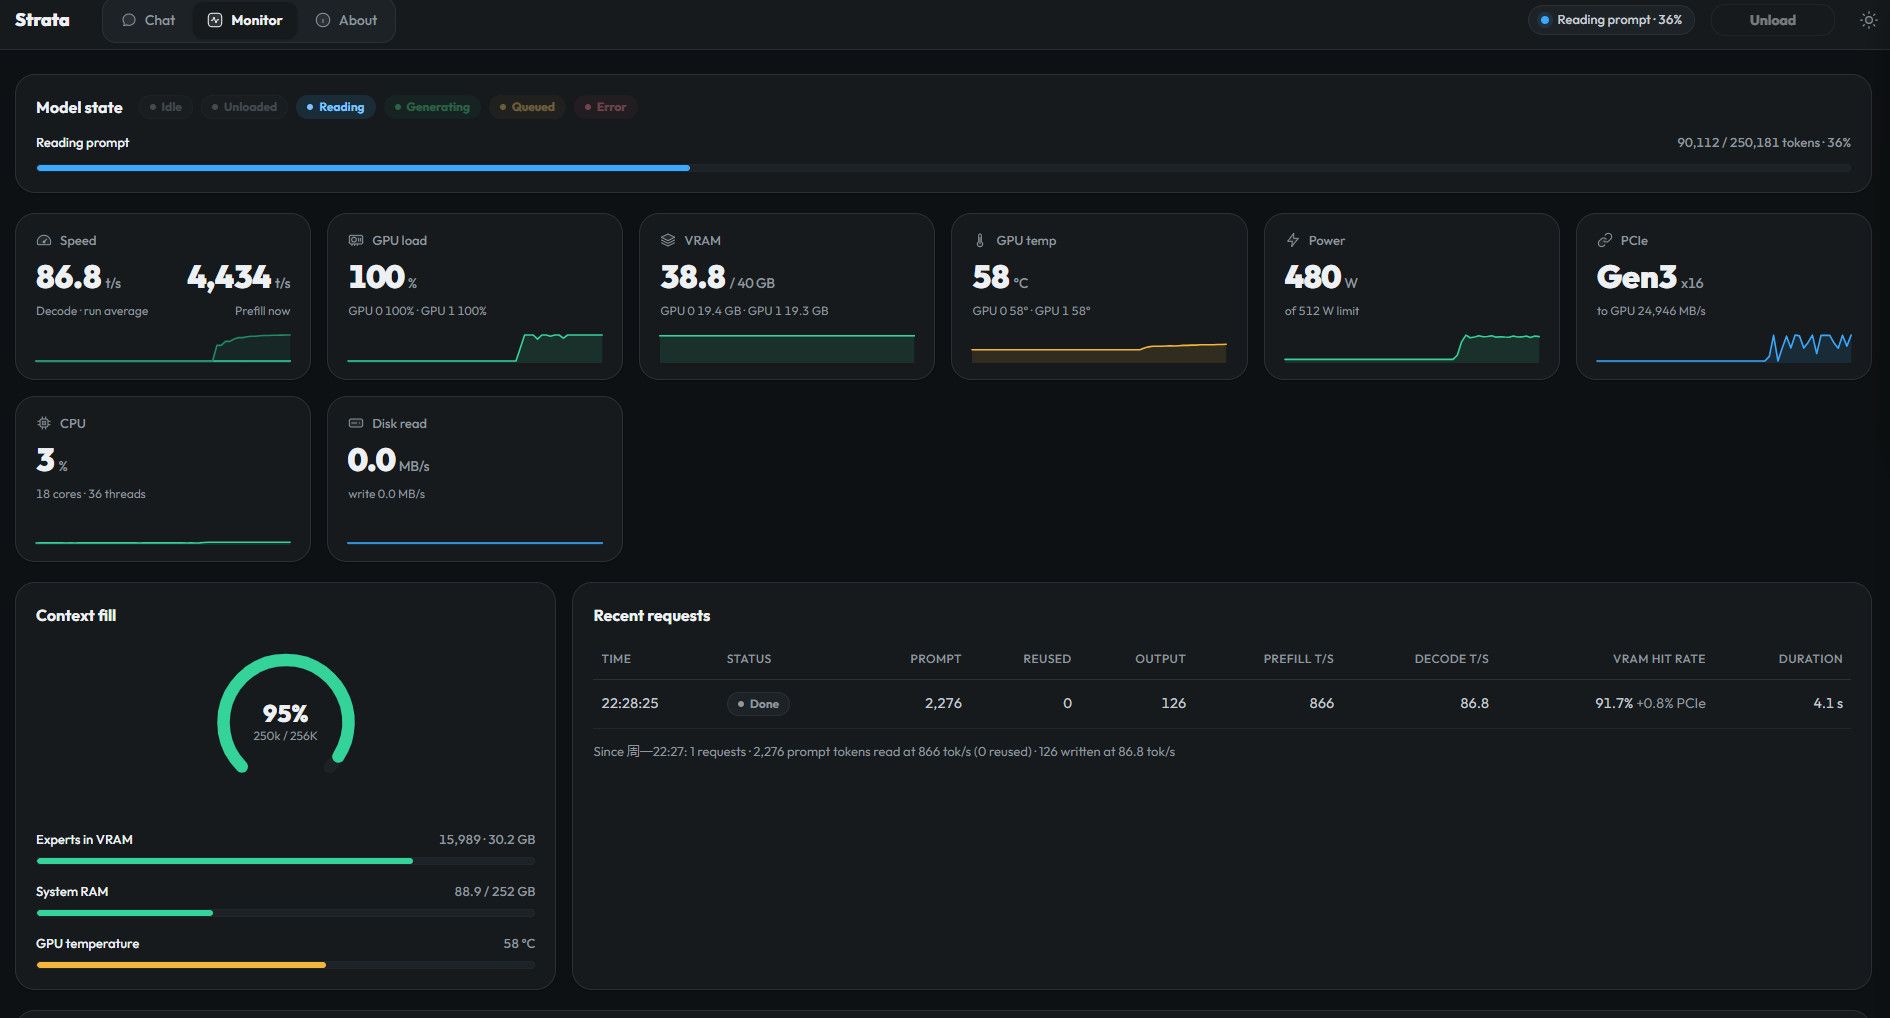
推理引擎:Strata 0.2.14
GPU:2× RTX 3080 20GB
平台:X99-T8/E5-2686v4/D3-256G
KV Cache:INT8
推理模式:temperature=0,thinking off,单实例串行
256K 使用原生 RoPE;512K~1M 使用 YaRN
测试方法
构造运营台账、值班日志和会议纪要组成的长文档,包含数千条同构记录。
在文档 2%~98% 的随机位置插入 8 条目标记录,每条目标均配有近似干扰记录,包括批次号相近、客户相同、日期相同等情况。
每份文档进行单独提问和联合提取测试,分别考察单针检索与多针召回能力。
主要结果
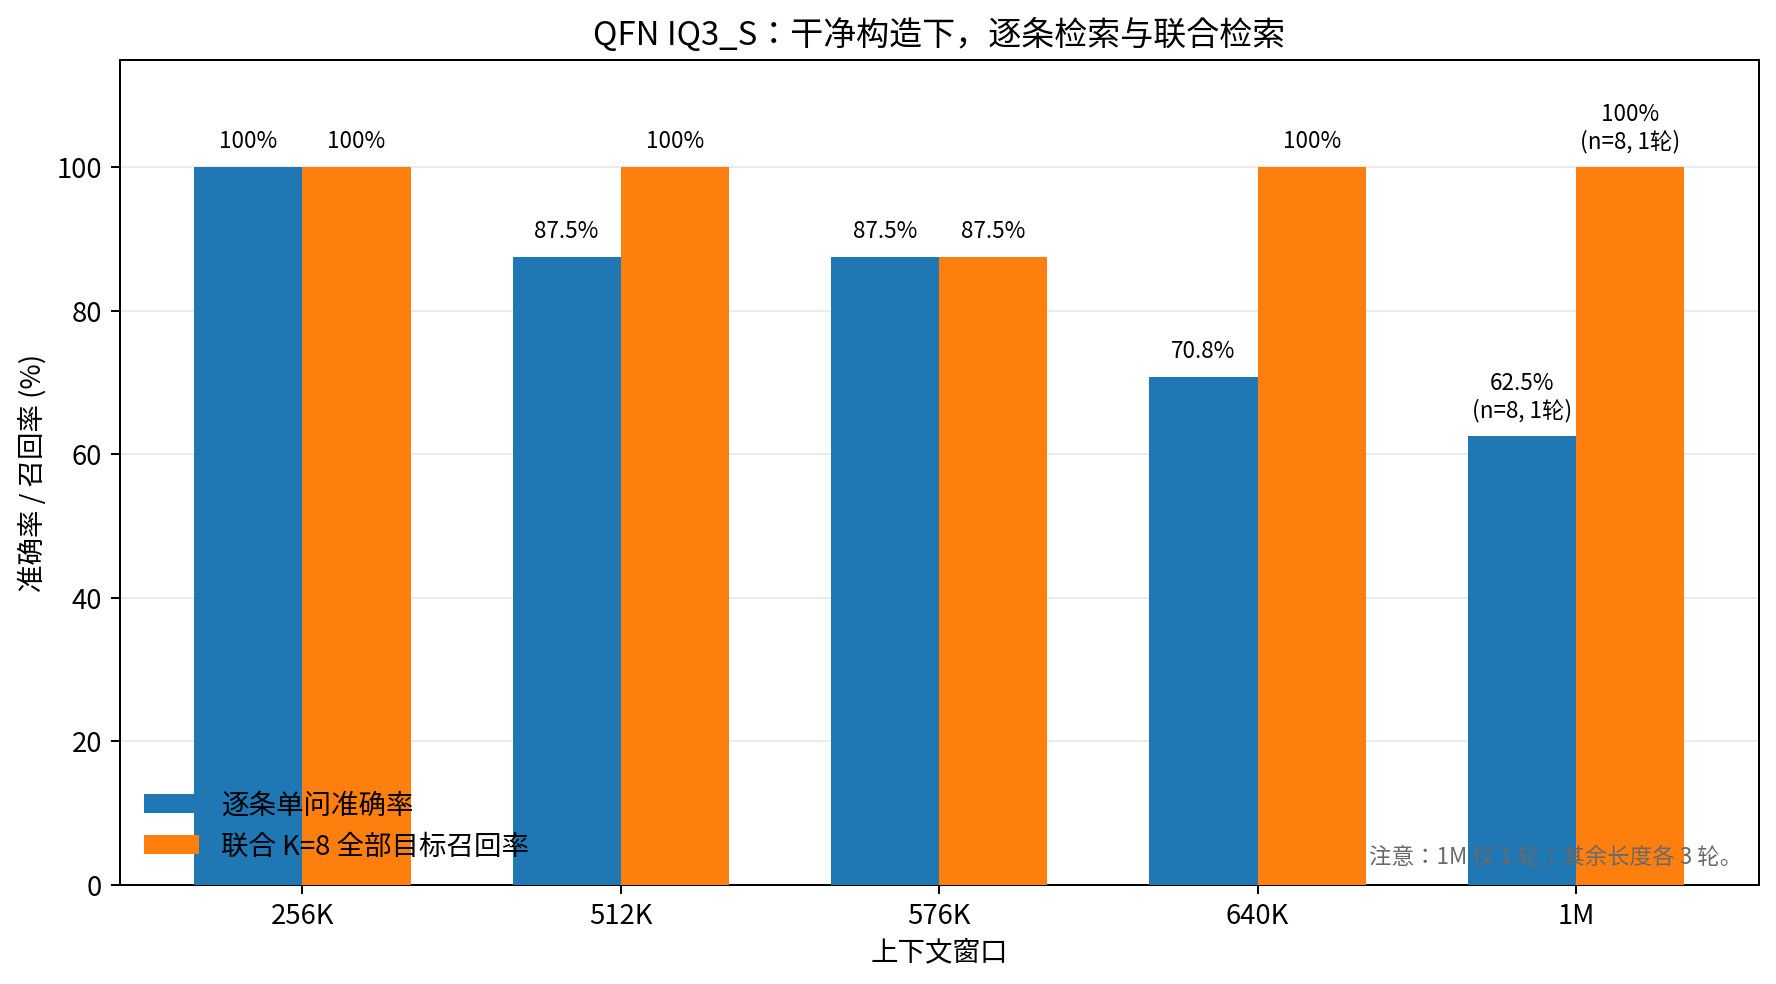
在干净构造(目标记录唯一)下:
上下文 逐条单问 联合 K=8 256K 100% 100% 512K 87.5% 100% 576K 87.5% 87.5% 640K 70.8% 100% 1M 62.5% 100% 一个有趣的现象是:联合提取 8 条信息,有时反而比逐条询问更准确。640K 下,逐条单问为 70.8%,而联合 K=8 达到 100%。
近似干扰测试
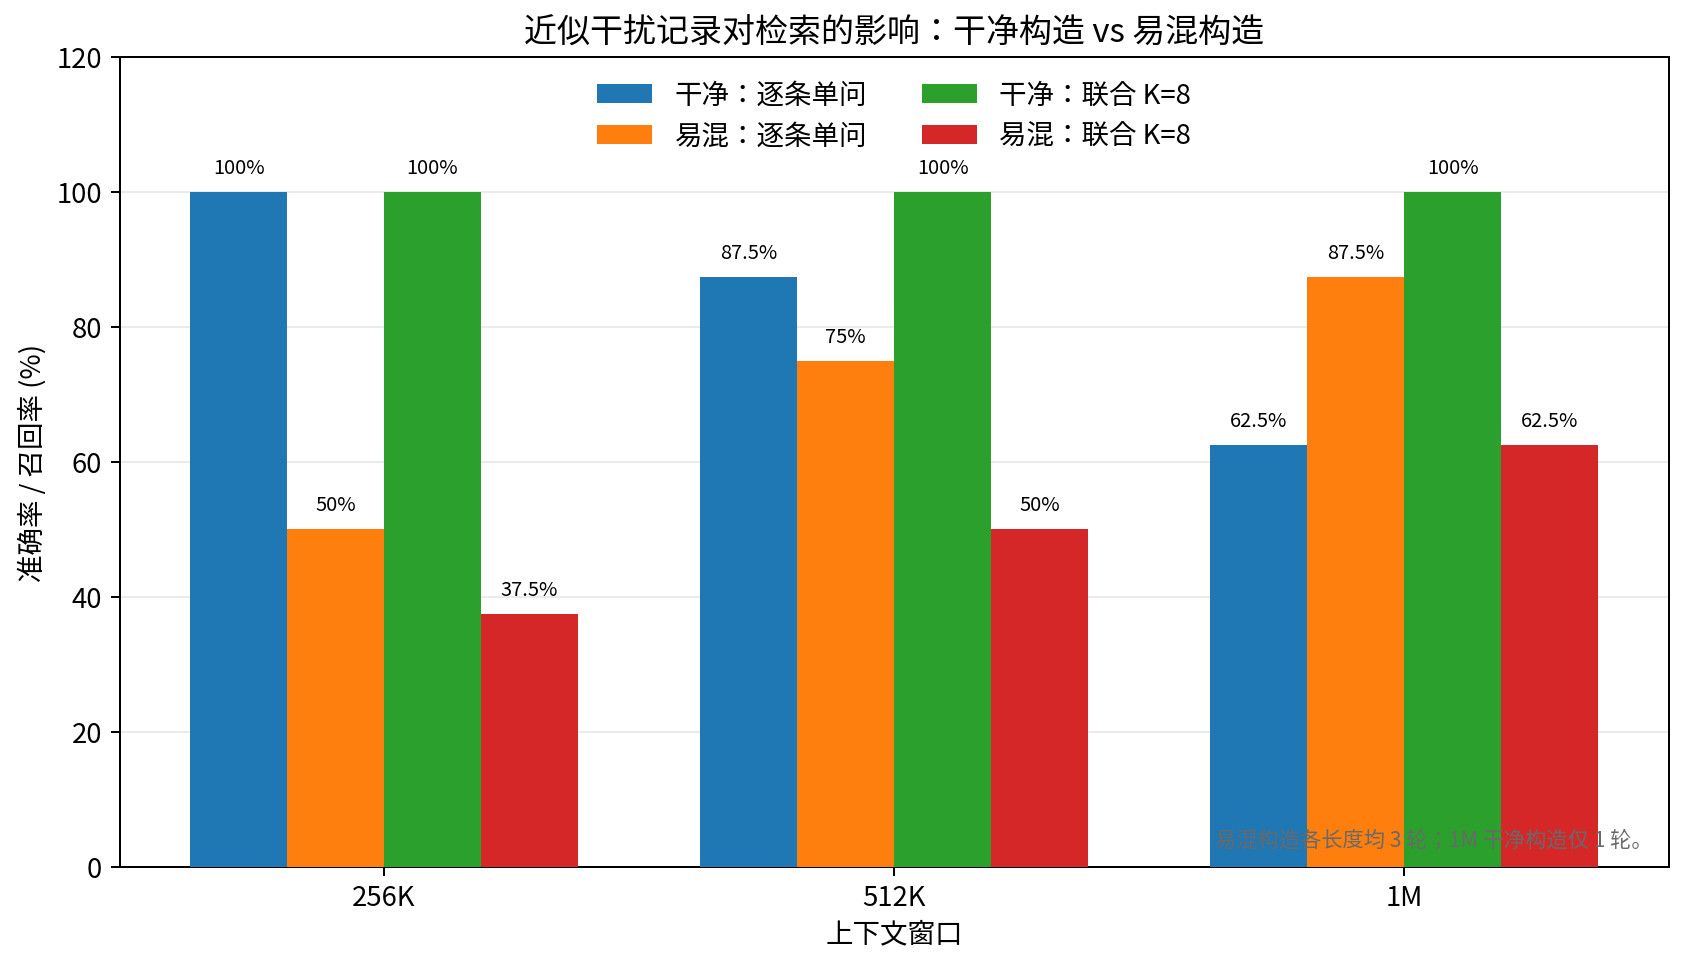
当目标记录存在同批次、相似日期和邻近批次号等干扰时,准确率明显下降:
上下文 易混单问 易混联合 K=8 256K 50% 37.5% 512K 75% 50% 1M 87.5% 62.5% 这表明,模型面临的挑战不仅是能否找到远距离信息,更重要的是能否区分高度相似的记录,并确保多个字段来自同一条记录。
Prefill 性能
文档长度 冷读时间 冷读吞吐 缓存后单问 250K 60.6s 4,166 tok/s 0.9s 500K 136.5s 3,692 tok/s 1.3s 576K 161.8s 3,584 tok/s 1.4s 640K 184.8s 3,487 tok/s 1.4s 980K 325.0s 3,033 tok/s 2.2s 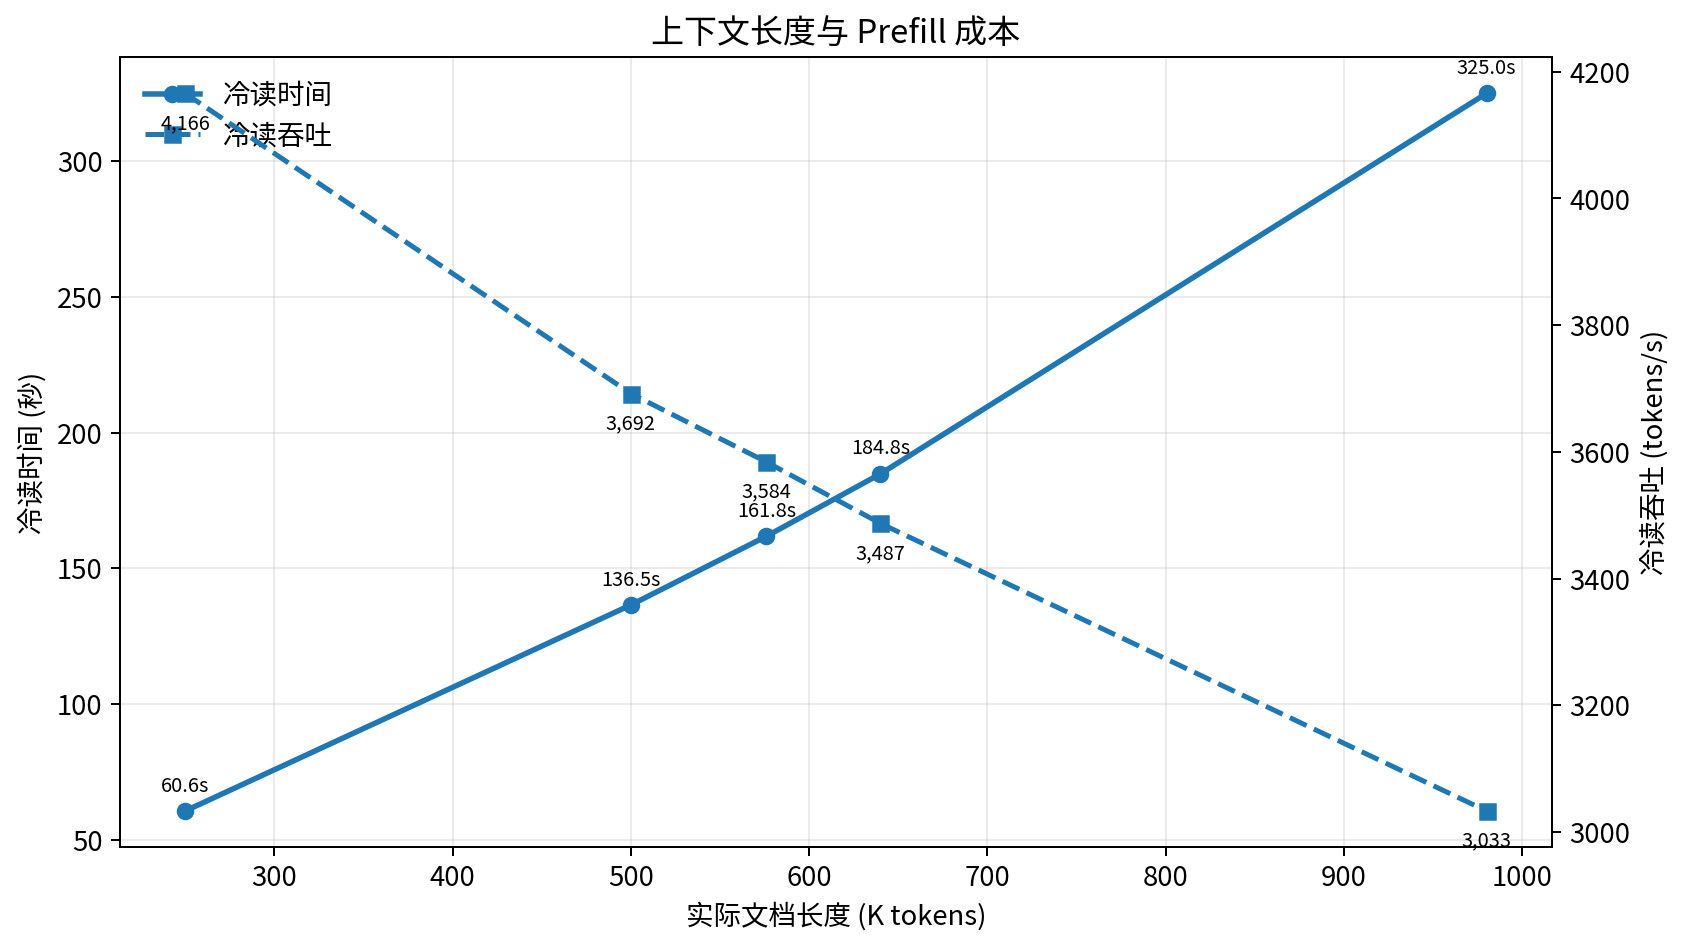
-
-
-