跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. 明天到货!单台 M5 Ultra 512GB 硬刚四台 DGX Spark,DeepSeek V4.1 Flash 1017 正面对照,结果敬请期待

明天到货!单台 M5 Ultra 512GB 硬刚四台 DGX Spark,DeepSeek V4.1 Flash 1017 正面对照,结果敬请期待

已定时 已固定 已锁定 已移动 精华 热议 AI硬件
apple-m5dgxsparkdeepseek
41 帖子 15 发布者 1.3k 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • ivan lanI
    ivan lanI
    ivan lan
    贵族大夫
    编写于 最后由 编辑
    #23

    @terry @benton-yi 先给一版,怕兄弟们等着着急

    1 条回复 最后回复
    1
    • ivan lanI ivan lan

      单台 Mac MacStudio与四台 DGX Spark 推理性能测试记录

      [!abstract] 结果摘要
      按本次提供的两轮中位数,单台 MacStudio的单流解码总吞吐达到四台 Spark 的 93.4%;并发增加至 16 路时,该比例降至 52.8%。冷态 scout prefill 的端到端有效输入吞吐达到四台 Spark 的 67.9%~86.4%。MacStudio结果仍待独立验收确认。

      一. 数据来源与验收状态

      本文根据用户提供的实测数据整理,未重新运行测试,也未核验原始日志。

      • 参考原项目:https://github.com/FujitsuPolycom/sparkring
      • 两套部署的数据均为两轮测试的中位数。
      • MacStudio使用 ddalcu/mlx-serve,版本为 26.11.2-metric01。
      • 该版本基于官方 26.11.2,加入连续 usage 输出补丁。

      二. 测试环境

      项目 单台 MacStudio 四台 Spark(SparkRing)
      硬件 单台 Mac Studio,M5 Ultra,512 GiB 四台 DGX Spark
      部署拓扑 单机 TP4 环形互联;TP4 指四路张量并行
      模型 1017 的 MLX oQ4e-mtp,权重 432.033GB 官方 1017 FP8/MXFP4 权重
      推理引擎 ddalcu/mlx-serve,26.11.2-metric01 vLLM/SparkRing,具体版本未提供
      引擎改动 官方 26.11.2 加入连续 usage 输出补丁 未提供
      测试工具 固定 bench 0.7.6 同版 bench 0.7.6
      测试方式 持续解码+integrated scout 同类持续解码+scout
      统计方式 两轮中位数 两轮中位数

      [!warning] 对比边界
      本次比较的是两套完整部署,不是同权重、同量化、同引擎的硬件对照实验。模型量化、推理引擎和部署拓扑均有差异,因此不能将性能差异全部归因于硬件。模型名称中的 mtp 不足以证明测试时启用了多 token 预测;原始材料未提供相关运行参数。

      三. 测试指标与口径

      1. 解码总吞吐

      解码是逐步生成输出 token 的阶段。本文按原始材料记录所有并发流的输出总吞吐,单位为输出 token/s,而非每条流的吞吐。

      测试覆盖 1、8、16 路并发。原始材料未提供解码统计窗口、输出长度和总吞吐的具体聚合公式,因此不补写这些细节。

      2. 冷态 scout prefill

      Prefill 是处理输入 token、建立后续生成所需状态的阶段。本次指标采用客户端首字时间计算:

      有效输入吞吐(输入 token/s)=输入 token 数 ÷ 客户端首字时间(秒)
      

      客户端首字时间包含首 token 和请求传输开销。因此,该指标是端到端有效输入吞吐,不是纯引擎 prefill 吞吐。

      测试覆盖 8K、64K、128K 输入长度。原始材料没有说明 K 的精确换算方式,也没有给出“冷态”的缓存清理和预热规则。

      3. 相对性能

      MacStudio相对比例=MacStudio吞吐 ÷ 四台 Spark 吞吐 × 100%
      四台 Spark 倍数=四台 Spark 吞吐 ÷ MacStudio吞吐
      

      下表的比例按一位小数呈现,倍数按两位小数呈现。

      四. 解码测试数据

      单位:输出 token/s。各吞吐值均为两轮中位数。

      并发流数 单台 MacStudio 四台 Spark MacStudio达到四台 Spark 的比例 四台 Spark 相对 MacStudio的倍数
      1 57.16 61.20 93.4% 1.07 倍
      8 122.21 194.90 62.7% 1.60 倍
      16 145.38 275.16 52.8% 1.89 倍

      单流时,两套部署的解码总吞吐接近。并发升高后,四台 Spark 的总吞吐优势扩大:8 路约为 MacStudio的 1.60 倍,16 路约为 1.89 倍。

      这些数据描述总吞吐,不直接代表单请求延迟或并发流之间的公平性。原始材料未提供逐流吞吐和延迟分布。

      五. 冷态 scout prefill 测试数据

      单位:输入 token/s。各吞吐值均为两轮中位数,按输入 token 数除以客户端首字时间计算。

      输入长度 单台 MacStudio 四台 Spark MacStudio达到四台 Spark 的比例 四台 Spark 相对 MacStudio的倍数
      8K 2,883 4,248 67.9% 1.47 倍
      64K 3,559.5 4,279 83.2% 1.20 倍
      128K 3,504 4,056.5 86.4% 1.16 倍

      四台 Spark 在三个输入长度下均领先。输入长度由 8K 增加至 128K 时,MacStudio的相对比例从 67.9% 增加至 86.4%,两套部署的相对差距缩小。

      两套部署在 128K 下的有效输入吞吐均低于 64K。现有数据不足以判断具体原因,也不足以区分引擎处理、请求传输和其他首字时间开销的贡献。

      六. 结论与独立验收所需信息

      本次数据支持以下结论:

      • 单流解码接近。MacStudio为 57.16 输出 token/s,四台 Spark 为 61.20 输出 token/s。
      • 并发解码差距扩大。16 路时,四台 Spark 的总吞吐约为 MacStudio的 1.89 倍。
      • 长输入下的相对差距缩小。128K 冷态 scout 测试中,MacStudio达到四台 Spark 的 86.4%。

      上述结论仅适用于本次部署和测试口径。两轮中位数不能提供稳定的波动范围,也不能替代独立验收。

      独立验收应补齐以下信息:

      项目 需要补齐的内容
      硬件与系统 完整硬件配置、操作系统版本、互联配置及测试时运行状态
      模型 完整模型标识、权重版本或校验值、量化配置
      引擎 两端精确版本或提交号、MacStudio补丁 diff、启动参数
      推理设置 是否启用多 token 预测或推测解码,以及相关参数
      测试命令 bench 0.7.6 完整命令、输入样本、输出长度和并发设置
      测量口径 解码统计窗口与聚合方式、首字时间起止点、冷态缓存与预热规则
      原始证据 两轮各自的结果、请求级日志和连续 usage 输出
      验收结果 独立复跑记录,以及是否复现本次趋势和数值范围
      xiongjie gaoX
      xiongjie gaoX
      xiongjie gao
      王侯将相
      编写于 最后由 编辑
      #24

      @ivan-lan 说:

      单台 MacStudio的单流解码总吞吐达到四台 Spark 的 93.4%;并发增加至 16 路时,该比例降至 52.8%

      就凭这个Mac卖得贵有贵的底气

      https://github.com/shawn86574-prog/x99-7900xtx-p2p
      https://github.com/shawn86574-prog/kuzuryusen

      ivan lanI 1 条回复 最后回复
      0
      • xiongjie gaoX xiongjie gao

        @ivan-lan 说:

        单台 MacStudio的单流解码总吞吐达到四台 Spark 的 93.4%;并发增加至 16 路时,该比例降至 52.8%

        就凭这个Mac卖得贵有贵的底气

        ivan lanI
        ivan lanI
        ivan lan
        贵族大夫
        编写于 最后由 ivan lan 编辑
        #25

        @xiongjie-gao 是真的安静~~,我旁边的4090+4080sx2吵得怀疑人生,已经被我关进小黑屋了

        xiongjie gaoX 1 条回复 最后回复
        0
        • ivan lanI ivan lan

          @xiongjie-gao 是真的安静~~,我旁边的4090+4080sx2吵得怀疑人生,已经被我关进小黑屋了

          xiongjie gaoX
          xiongjie gaoX
          xiongjie gao
          王侯将相
          编写于 最后由 编辑
          #26

          @ivan-lan 算力机最优雅的打开方式就是锁在温湿合适,隔音良好的小黑屋里供远程调用。
          老哥,稳👍

          https://github.com/shawn86574-prog/x99-7900xtx-p2p
          https://github.com/shawn86574-prog/kuzuryusen

          1 条回复 最后回复
          1
          • ivan lanI ivan lan

            @benton-yi 问下Spark tp4测试的脚手架和数据是采用项目:https://github.com/FujitsuPolycom/sparkring 中的llm-inference-bench?目前mlx-serve 这边的 llmprobe 统计口径好像不太一样,不懂是我的问题还是测试工具的问题,我在研究下~

            benton yiB
            benton yiB
            benton yi
            王侯将相
            编写于 最后由 编辑
            #27

            @ivan-lan 说:

            @benton-yi 问下Spark tp4测试的脚手架和数据是采用项目:https://github.com/FujitsuPolycom/sparkring 中的llm-inference-bench?
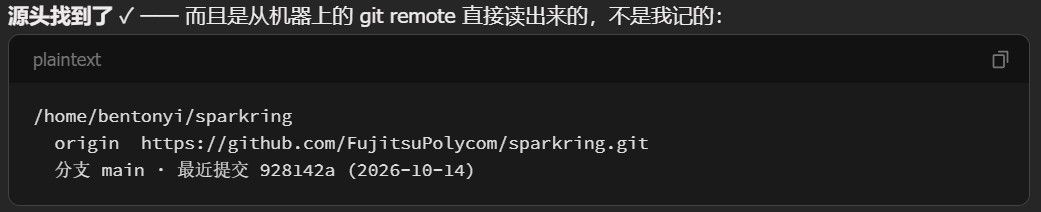
            image.jpeg

            没错,就是这个。

            ivan lanI 1 条回复 最后回复
            1
            • benton yiB benton yi

              @ivan-lan 说:

              @benton-yi 问下Spark tp4测试的脚手架和数据是采用项目:https://github.com/FujitsuPolycom/sparkring 中的llm-inference-bench?

              image.jpeg

              没错,就是这个。

              ivan lanI
              ivan lanI
              ivan lan
              贵族大夫
              编写于 最后由 编辑
              #28

              @benton-yi 那就对上了~

              1 条回复 最后回复
              1
              • 懒人烘培懒
                懒人烘培懒
                懒人烘培
                王侯将相
                编写于 最后由 编辑
                #29

                冲着安静就得加分,贵是有道理的,双7900XTX又在嗷嗷叫了~~

                双 7900 XTX:模型本地跑,Token 随便烧!

                1 条回复 最后回复
                1
                • kop wangK
                  kop wangK
                  kop wang
                  易有太极
                  编写于 最后由 编辑
                  #30

                  看了两个512GB的评测,都是超长上下文prefill速度反而大于相对长的上下文(超短上下文不作数)。

                  感觉mlx还有很大的优化空间。

                  虚心交流,一起进步

                  1 条回复 最后回复
                  0
                  • williamlouisW
                    williamlouisW
                    williamlouis
                    易有太极
                    编写于 最后由 编辑
                    #31

                    速度应该和功耗有个比较。
                    两者的功耗比,辛苦有空的时候做个比较。

                    个人主页:xlkj.org Telegram https://t.me/xlkjorg

                    1 条回复 最后回复
                    0
                    • ivan lanI
                      ivan lanI
                      ivan lan
                      贵族大夫
                      编写于 最后由 编辑
                      #32

                      mlx平台不熟悉,让我先熟悉,后期给大家一个完整的测评

                      1 条回复 最后回复
                      0
                      • 疼哥蛋疼
                        疼哥蛋疼
                        疼哥蛋
                        编写于 最后由 编辑
                        #33

                        好奇下 Mac 4台 M5 Ultra 512GB 能有啥效果,DS 4.1 原版能上 80 t/S 么

                        ivan lanI 1 条回复 最后回复
                        0
                        • 疼哥蛋疼 疼哥蛋

                          好奇下 Mac 4台 M5 Ultra 512GB 能有啥效果,DS 4.1 原版能上 80 t/S 么

                          ivan lanI
                          ivan lanI
                          ivan lan
                          贵族大夫
                          编写于 最后由 编辑
                          #34

                          @疼哥蛋 瓶颈就是雷电五了

                          1 条回复 最后回复
                          0
                          • cc tgoC cc tgo

                            我除了想知道这个测试,更想知道两台256G是不是会比单台512g更快些。让我后续也有个念想。大佬你要不再弄两台256G, 我一定围观捧场。😍

                            terryT
                            terryT
                            terry
                            易有太极
                            编写于 最后由 编辑
                            #35

                            @cc-tgo 你在你的测试帖子中@他不就行了,让 @ivan-lan 和你测试同一个流程。我正好再水一个视频。

                            油管:https://www.youtube.com/@抡锤者

                            ivan lanI 1 条回复 最后回复
                            0
                            • ,terryT terry 引用了 此主题
                            • terryT terry

                              @cc-tgo 你在你的测试帖子中@他不就行了,让 @ivan-lan 和你测试同一个流程。我正好再水一个视频。

                              ivan lanI
                              ivan lanI
                              ivan lan
                              贵族大夫
                              编写于 最后由 编辑
                              #36

                              @terry 不是烂尾了,是mlx-serve和omlx两个推理引擎出的结果,差别很大,前者号称是C++替换Pytorch,性能很高,但是实际性能还不如olmx,而且tps的计算方法都有问题,我尽快把长文本和能耗用omlx测下;

                              1 条回复 最后回复
                              1
                              • ivan lanI
                                ivan lanI
                                ivan lan
                                贵族大夫
                                编写于 最后由 编辑
                                #37

                                老特一句话,赶紧测试
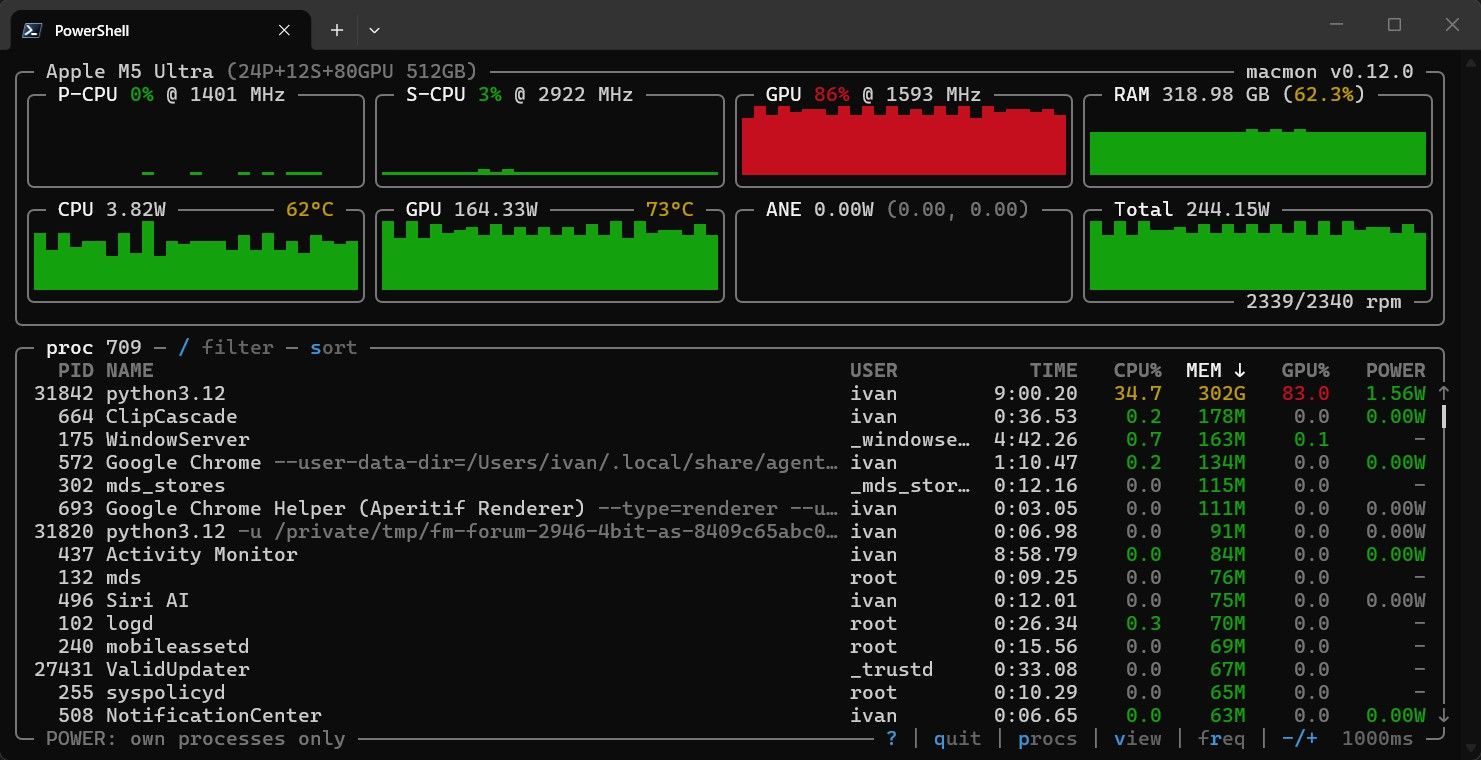
                                过程中的截图,目前在:512K × 8 并发,DSpark 关闭。每路约 50 万输入 token
                                image.jpeg
                                发张图,说明我在干活 @terry

                                terryT 1 条回复 最后回复
                                1
                                • ivan lanI ivan lan

                                  老特一句话,赶紧测试
                                  过程中的截图,目前在:512K × 8 并发,DSpark 关闭。每路约 50 万输入 token
                                  image.jpeg
                                  发张图,说明我在干活 @terry

                                  terryT
                                  terryT
                                  terry
                                  易有太极
                                  编写于 最后由 编辑
                                  #38

                                  @ivan-lan 不着急,我什么时候都能水视频,现在在筹备新频道,完全躺平。

                                  油管:https://www.youtube.com/@抡锤者

                                  ivan lanI 1 条回复 最后回复
                                  0
                                  • terryT terry

                                    @ivan-lan 不着急,我什么时候都能水视频,现在在筹备新频道,完全躺平。

                                    ivan lanI
                                    ivan lanI
                                    ivan lan
                                    贵族大夫
                                    编写于 最后由 编辑
                                    #39

                                    @terry ComfyUI频道?我等好久了

                                    terryT 1 条回复 最后回复
                                    0
                                    • ivan lanI ivan lan

                                      @terry ComfyUI频道?我等好久了

                                      terryT
                                      terryT
                                      terry
                                      易有太极
                                      编写于 最后由 编辑
                                      #40

                                      @ivan-lan 是的,需要构思创意,其实技术难度不高,就是创意。

                                      油管:https://www.youtube.com/@抡锤者

                                      1 条回复 最后回复
                                      0
                                      • ivan lanI
                                        ivan lanI
                                        ivan lan
                                        贵族大夫
                                        编写于 最后由 编辑
                                        #41

                                        交作业:https://lcz.me/topic/3184

                                        1 条回复 最后回复
                                        0

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组