
【全网最详尽实测】M5 Ultra 512GB 对比 4 台 DGX Spark,DeepSeek V4.1 Flash 1017 全矩阵测试,附 1M 上下文补测
-

前一帖 先发了初步结果。这次按 四台 DGX Spark 的 1017 详细测试帖 补跑完整矩阵:1K–512K,1/2/4/8 路,DSpark 开启和关闭各一套,共 72 格。另附 Studio DSpark OFF 的单路 1M 补测,独立于这张主矩阵。
先说结果:单路短输入的首 token 更快;并发解码吞吐仍是 Spark TP4 占优。512K 八路时,Spark TP4 更早让最慢一路出首 token,Studio 更早完成整批。 三项指标各看各的,混在一起读会得出相反结论。展开数据在下面。
一、测试环境与口径
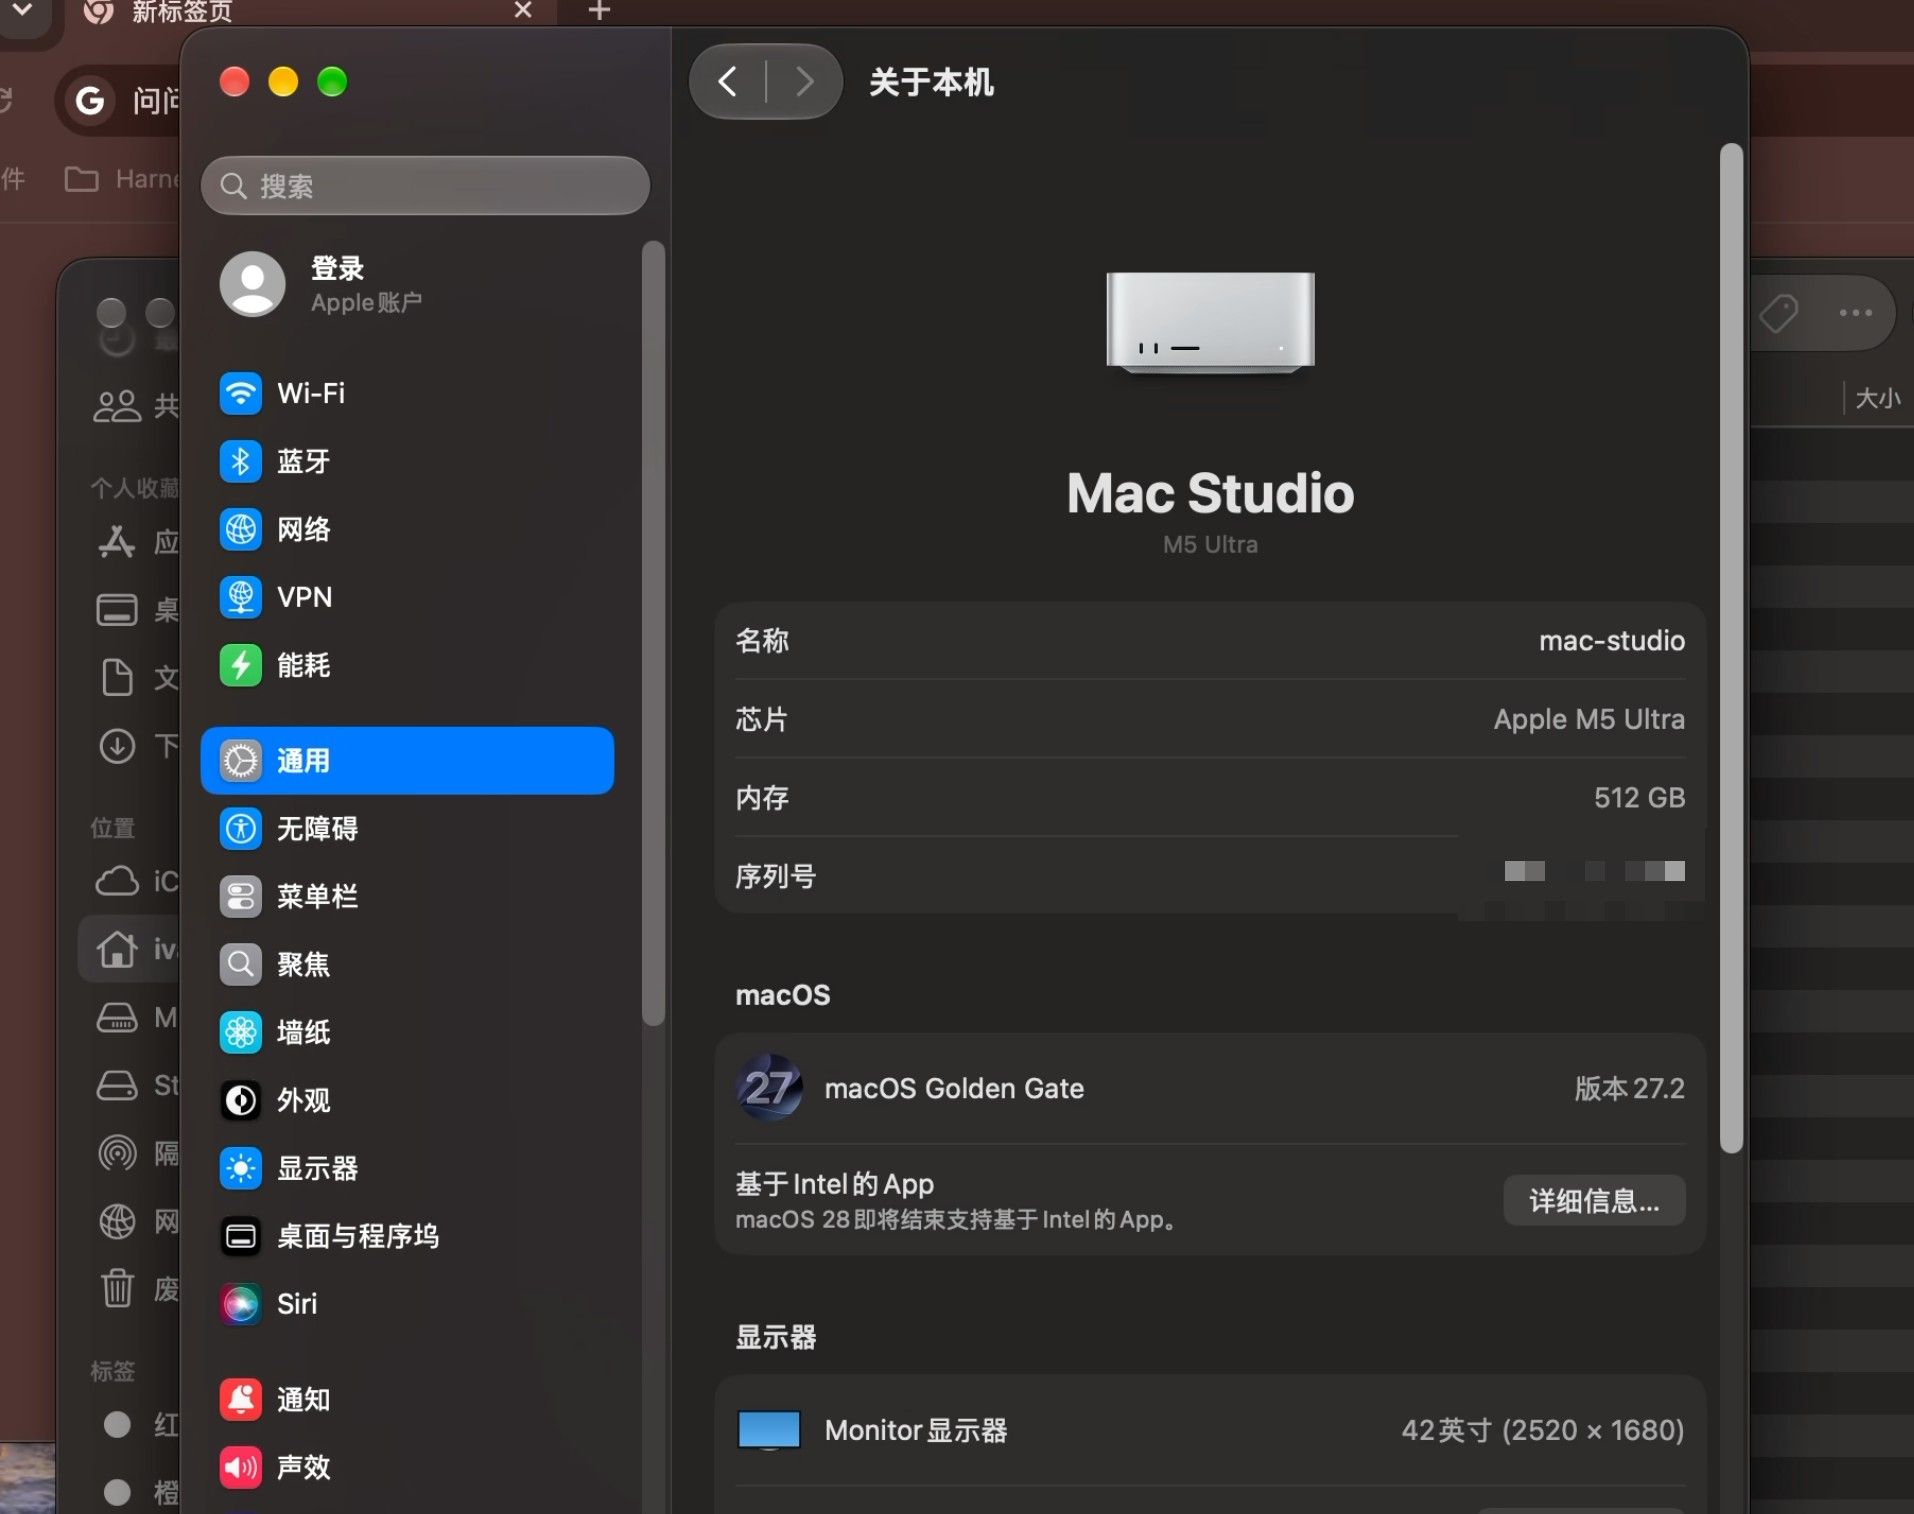
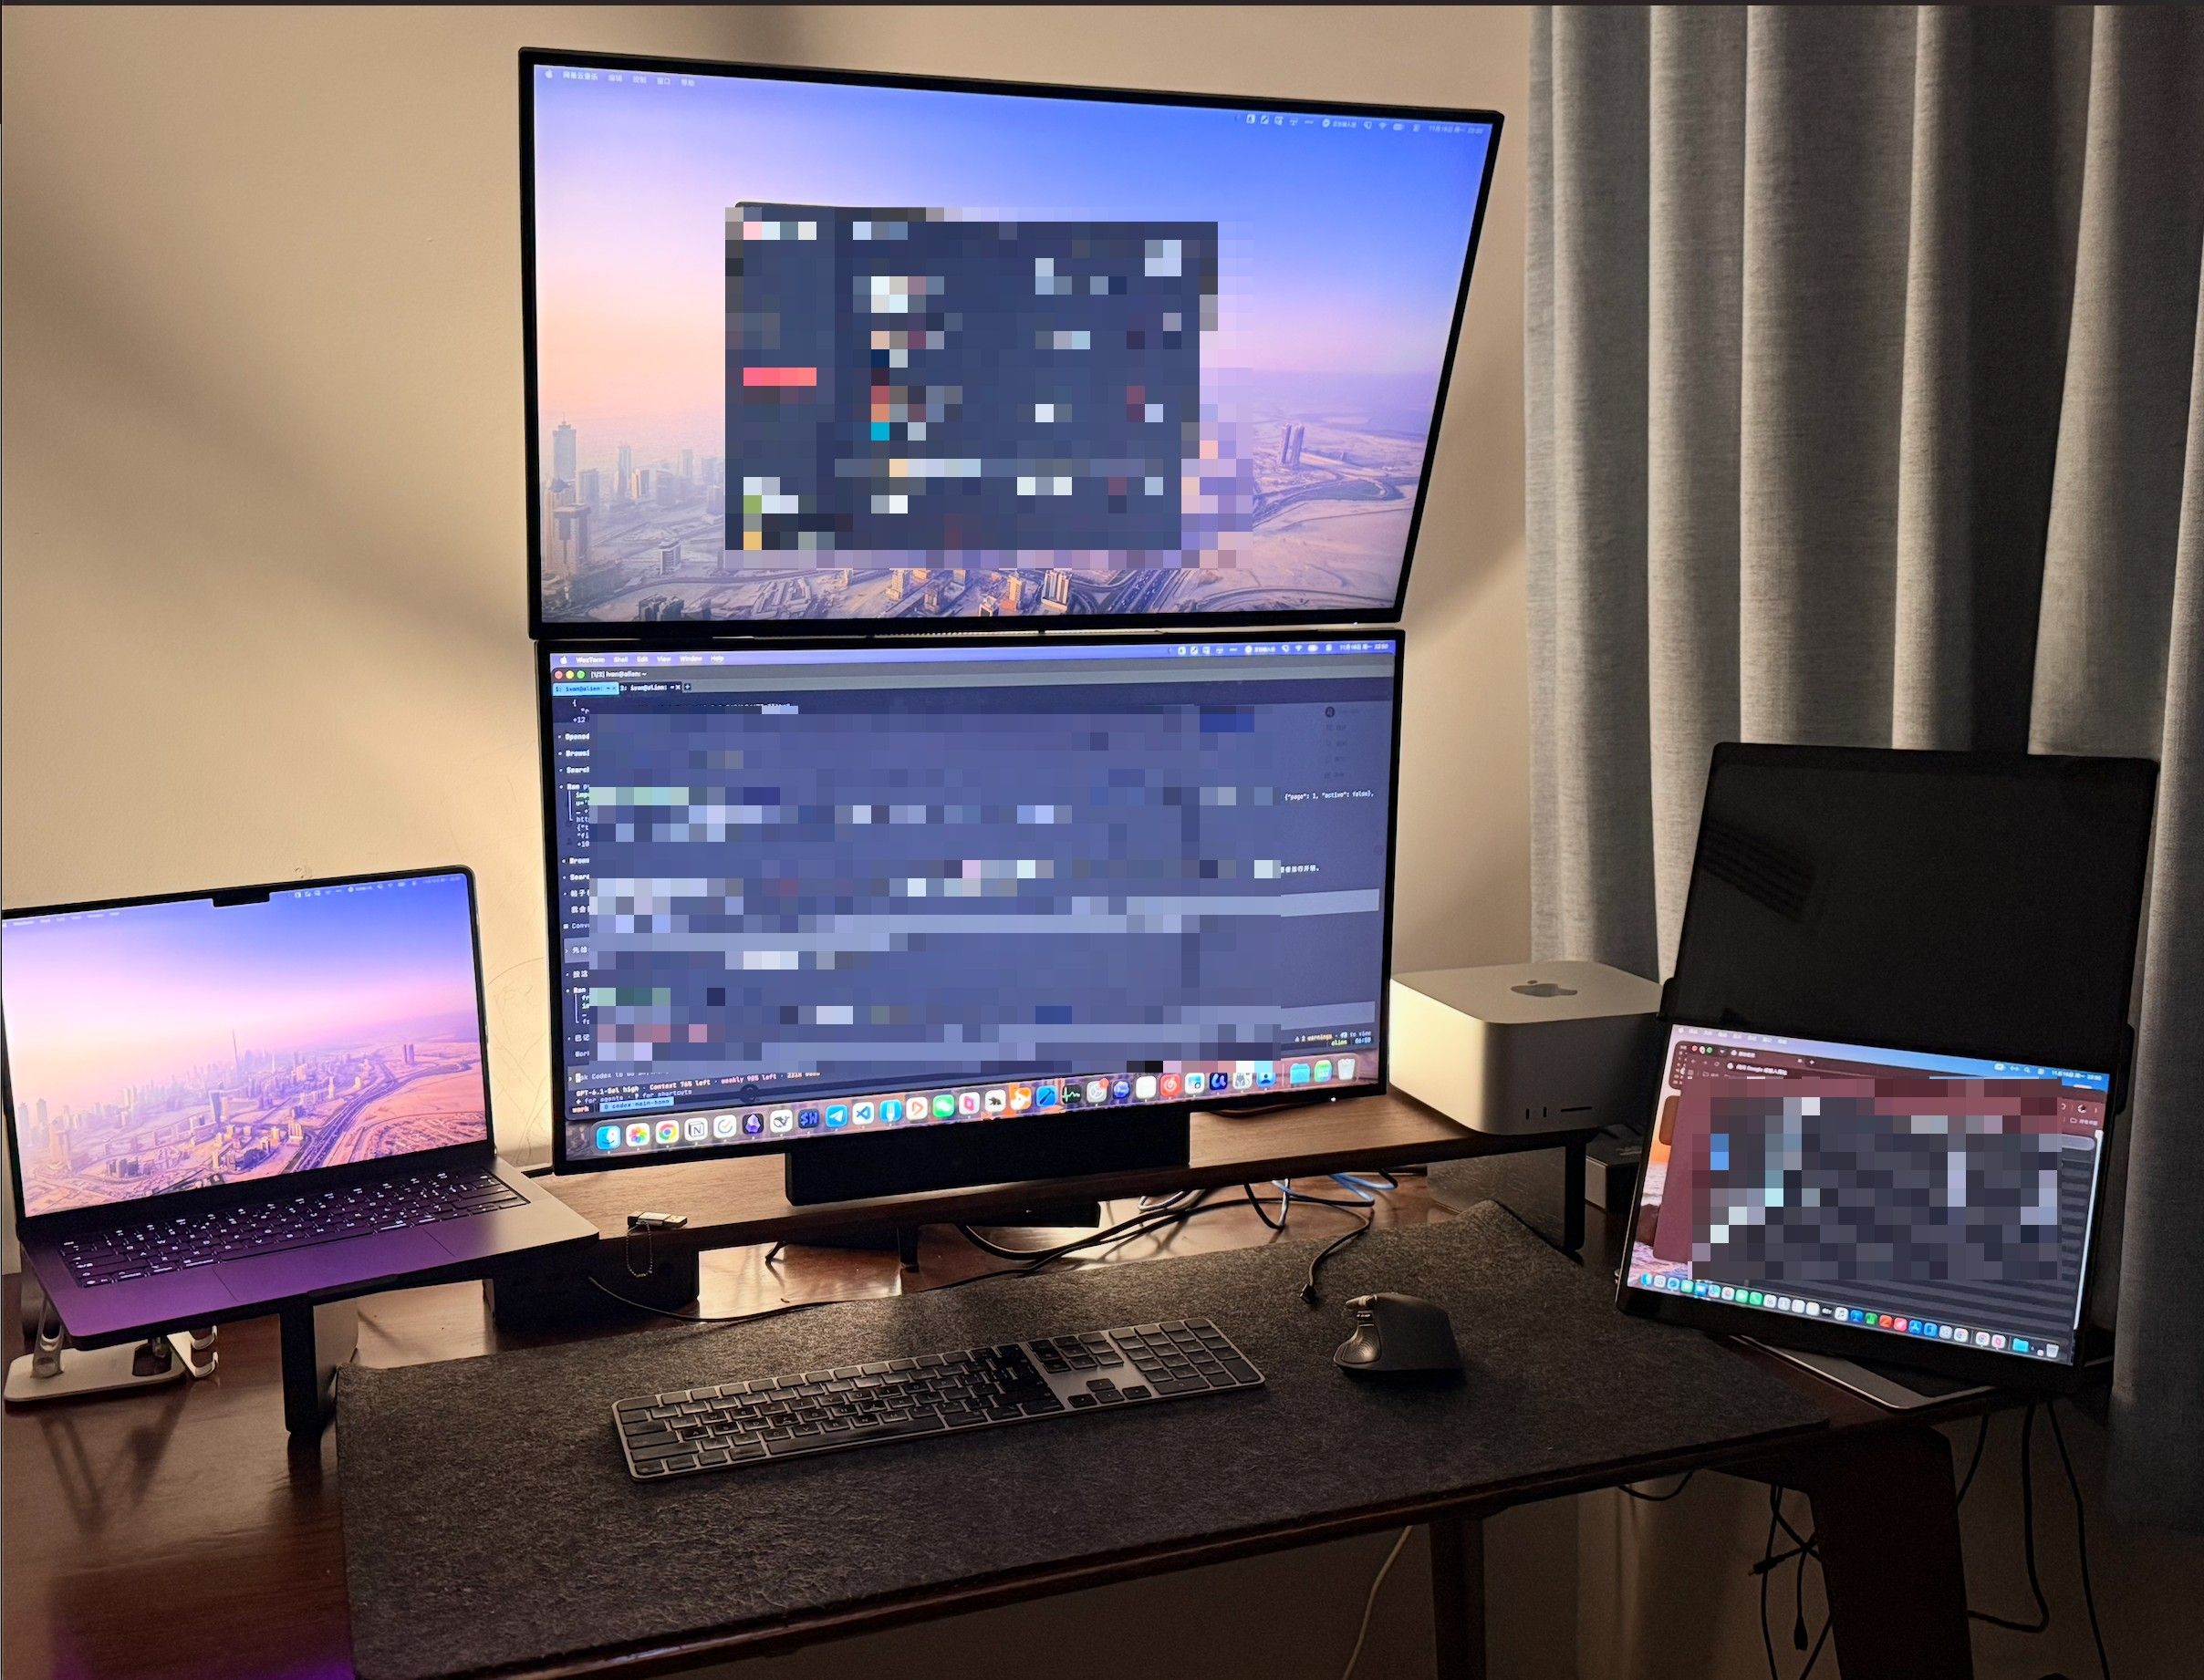
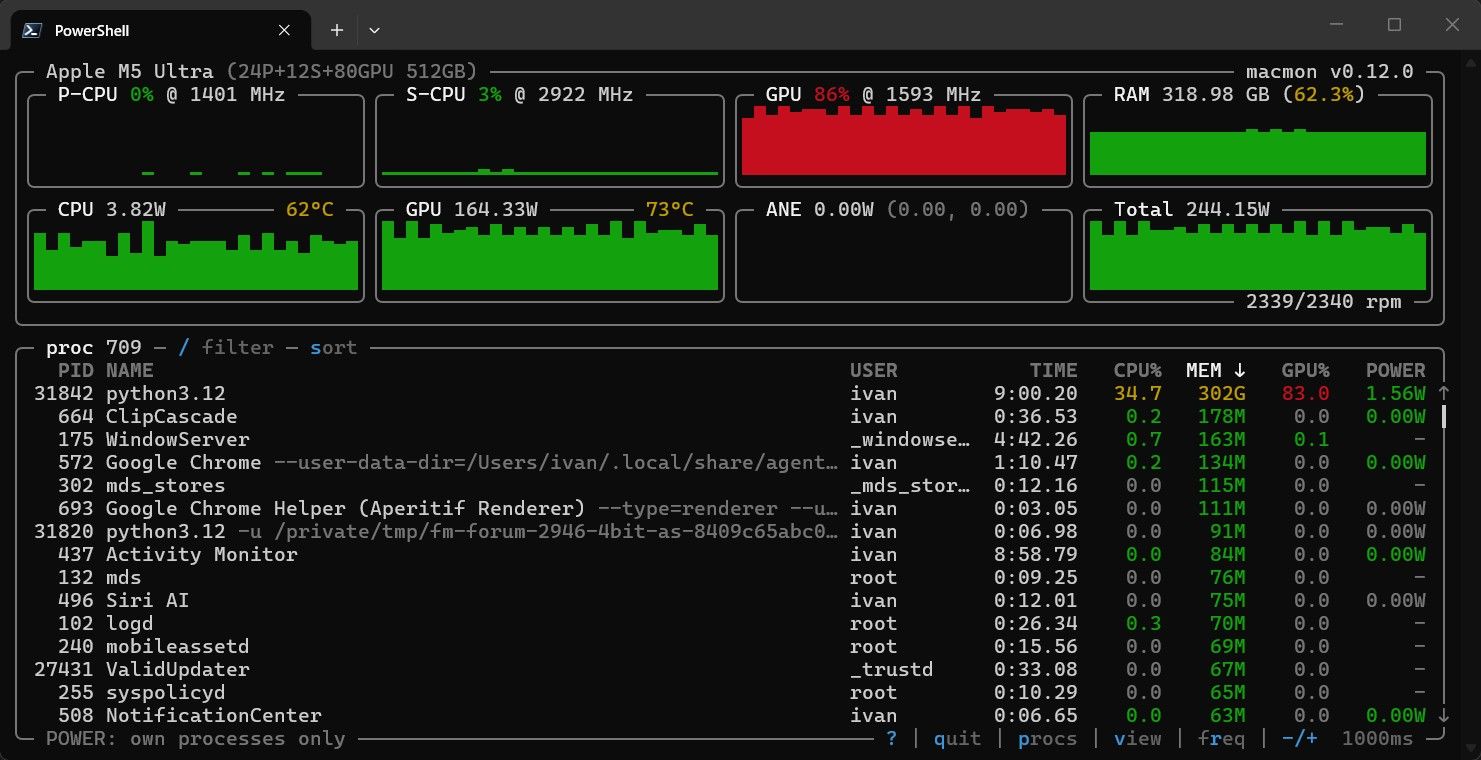
1. 开箱与实机记录

2. 运行配置与测量口径
项目 本次配置 硬件 单台 Mac Studio,M5 Ultra,36 核 CPU/80 核 GPU,512 GB 统一内存,2 TB 内置 SSD 推理引擎 oMLX 0.8.0rc1 模型 DeepSeek V4.1 Flash 1017;Engram 为 4-bit affine,group size 32,scale/bias 为 BF16 解码 Studio DSpark ON/Studio DSpark OFF 各跑一套; enable_thinking=false测试工具 固定 llm-inference-bench 0.7.6DSpark 是推测解码功能,先生成候选 token,再由目标模型验证。
Studio DSpark ON和Studio DSpark OFF分别表示本机开启和关闭该功能;两套测试都关闭思考。Spark TP4表示四台 DGX Spark 采用四路张量并行,成绩引用自原帖,对方开启了 DSpark。负载设置: 每路实际输出 128 token,温度 0.6;填充文本带逐路唯一标记,正式矩阵的前缀缓存命中均为 0。1K–64K 每格三批,各指标独立取中位数;128K–512K 每格一批。合计 168 批、630 路请求。
统计公式与原帖对齐: pp 表示预填充,tg 表示解码。P、U 分别为每路实际输入和输出 token,W 为从发出请求到收到
[DONE]的时长。- 单流 pp、tg:分别对每路的
P / TTFT、U / (W − TTFT)取均值。 - 聚合 pp:
ΣP / max(TTFT)。 - 聚合 tg:
ΣU / (max(W) − max(TTFT))。 - 表中的 TTFT 取最慢一路;墙钟是从第一路发出到最后一路结束的整批用时。
聚合解码吞吐的算法有局限,本次为对比而统一沿用。
ΣU / (max(W) − max(TTFT))的分子是整批输出,分母却只是尾窗,错峰生成时会高估吞吐,也受调度影响。为跟原帖逐档对照,Spark TP4 引用原报,Studio 用同一公式计算。统一口径不代表算法合理。pp 包含排队、传输和首 token 等开销,不是纯引擎预填充速率。对方数据采用原帖的 1017 新权重列。两端引擎、Engram 精度和拓扑不同,这是整套部署对照,不能把差异全部算到硬件上。Studio 关闭思考;原帖服务默认思考 on · high,矩阵请求的开关未单独披露。
3. 内置 SSD
权重和约 123 GB 的 Engram 表放内置盘,运行时按需读取。内置 Apple AP2048Z 2TB 的 fio 3.43 实测顺序读 13.1 GB/s,而 PCIe 4.0×4 的雷电 5 外置 SSD 理论带宽只有 64 Gbit/s,约 8 GB/s,实际还要扣协议开销。大模型加载和 Engram 查表这类用途,内置盘这笔钱值得花。以后要做 Streaming,直接上 4TB。

fio 项目 内置 SSD 外置 USB4 SSD 顺序读/写,QD32 13.1/12.7 GB/s 3.77/3.54 GB/s 4 KiB 随机读,QD1 17,200 IOPS,58 µs 14,300 IOPS,70 µs 4 KiB 随机读,QD32 185,000 IOPS 176,000 IOPS 二、栈自检
检查项 结果 输入与输出计数 1K 单路为 1,004 输入、128 输出 思考开关 正式协议批的 reasoning token 为 0;使用错误开关的先导批已剔除 前缀缓存 正式矩阵逐路命中均为 0 token 流完整性 630 路均生成 128 token,以 length结束,收到 usage 和[DONE]三、长上下文阶梯压测(并发 1)
图中比较 Studio DSpark ON、Studio DSpark OFF 和 Spark TP4。首 token 与总耗时采用对数纵轴。

下表每个对照格按 Studio DSpark OFF / Spark TP4 排列。Studio DSpark ON/Studio DSpark OFF 的差异在图中展示。
上下文 实际输入 TTFT(秒) 单流解码(token/s) 总耗时(秒) 1K 1,004 0.57 / 1.22 49.79 / 55.3 3.14 / 3.75 4K 3,800 1.12 / 1.84 50.27 / 71.5 3.68 / 3.63 8K 7,513 1.96 / 3.10 50.31 / 73.0 4.50 / 5.01 16K 14,955 3.67 / 4.39 50.24 / 83.7 6.22 / 5.99 32K 29,881 7.25 / 7.46 49.38 / 92.7 9.84 / 8.84 64K 61,913 14.96 / 15.30 48.99 / 102.6 17.57 / 16.52 128K 124,759 42.52 / 33.27 47.95 / 67.4 45.19 / 35.17 256K 250,485 76.21 / 73.30 46.92 / 75.5 78.94 / 74.99 512K 501,869 163.36 / 181.40 44.94 / 73.0 166.21 / 183.15 8K 单路,Studio 两档都约 2 秒出首 token。512K 单路,Studio DSpark OFF 为 163.36 秒首 token、166.21 秒完成;Spark TP4 为 181.40/183.15 秒,但其单流解码更快,为 73.0 token/s,Studio DSpark OFF 为 44.94 token/s。
四、高并发 × 上下文扫描
图中每列分别为 2/4/8 路。三行依次是最慢首 token、整批耗时和单流 pp;同一行使用同一纵轴。

提交路数不等于实际解码重叠数。 下图的点是各批最高峰值,竖线表示各批峰值的范围。

512K 八路的 Studio DSpark ON/Studio DSpark OFF 实际解码峰值都是 6 路。八个请求在约 16 ms 内提交,但首个请求约第 154 秒出 token,最慢一路要等到约第 1,214 秒。
五、汇总对照
四张趋势图均覆盖九个上下文档位和 1、2、4、8 路并发,同一指标的四个面板共用纵轴。虚线三角为 Studio DSpark ON,实线圆点为 Studio DSpark OFF,点线方块为 Spark TP4。速率单位均为 token/s。
1. 单流解码吞吐(token/s)
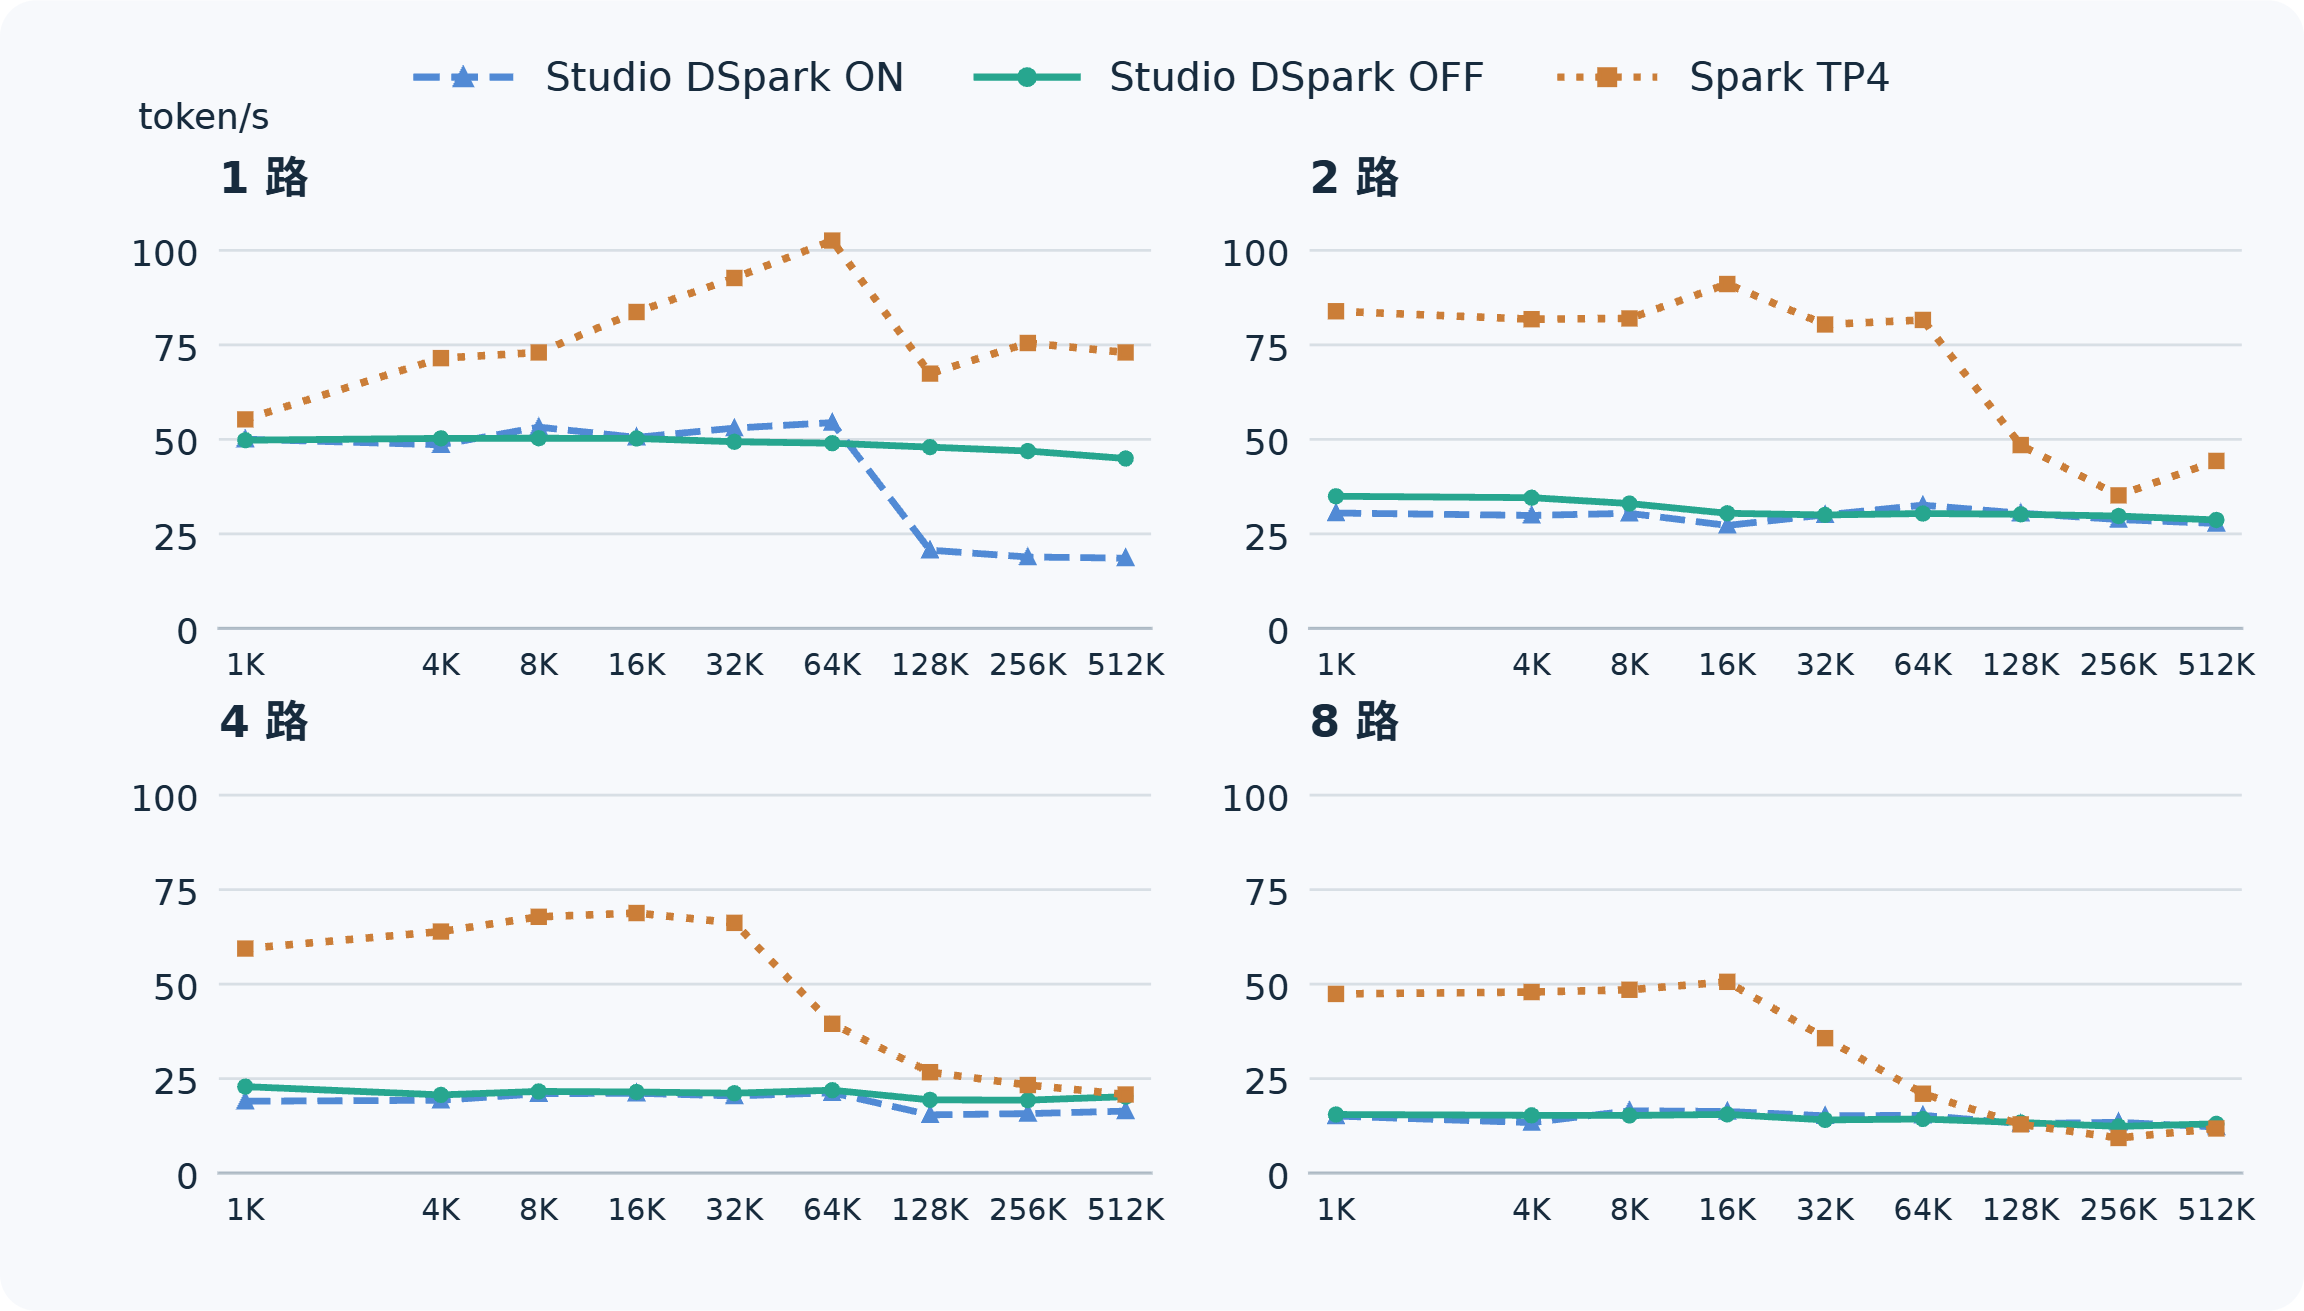
Studio 单路在 128K–512K 的三个单批中,Studio DSpark OFF 约 45–48 token/s,Studio DSpark ON 约 19–21 token/s。到了 512K 八路,三套结果的单流解码都在约 12–13 token/s。
2. 单路预填充吞吐(token/s)

多路提交时,单路预填充取同批各请求
P / TTFT的均值,包含请求在系统内的等待。同样是 512K,Studio DSpark OFF 从单路的 3,072.20 token/s 降到八路时的 770.70 token/s;Spark TP4 同档八路为 887.3 token/s。单路速率与整批聚合速率应分开看。3. 聚合解码吞吐(token/s)
本图采用原帖口径,不等于整批真实解码吞吐。 错峰时分子含尾窗之前的输出,会高估。为保持对比一致仍沿用该算法,具体例子见第七节。
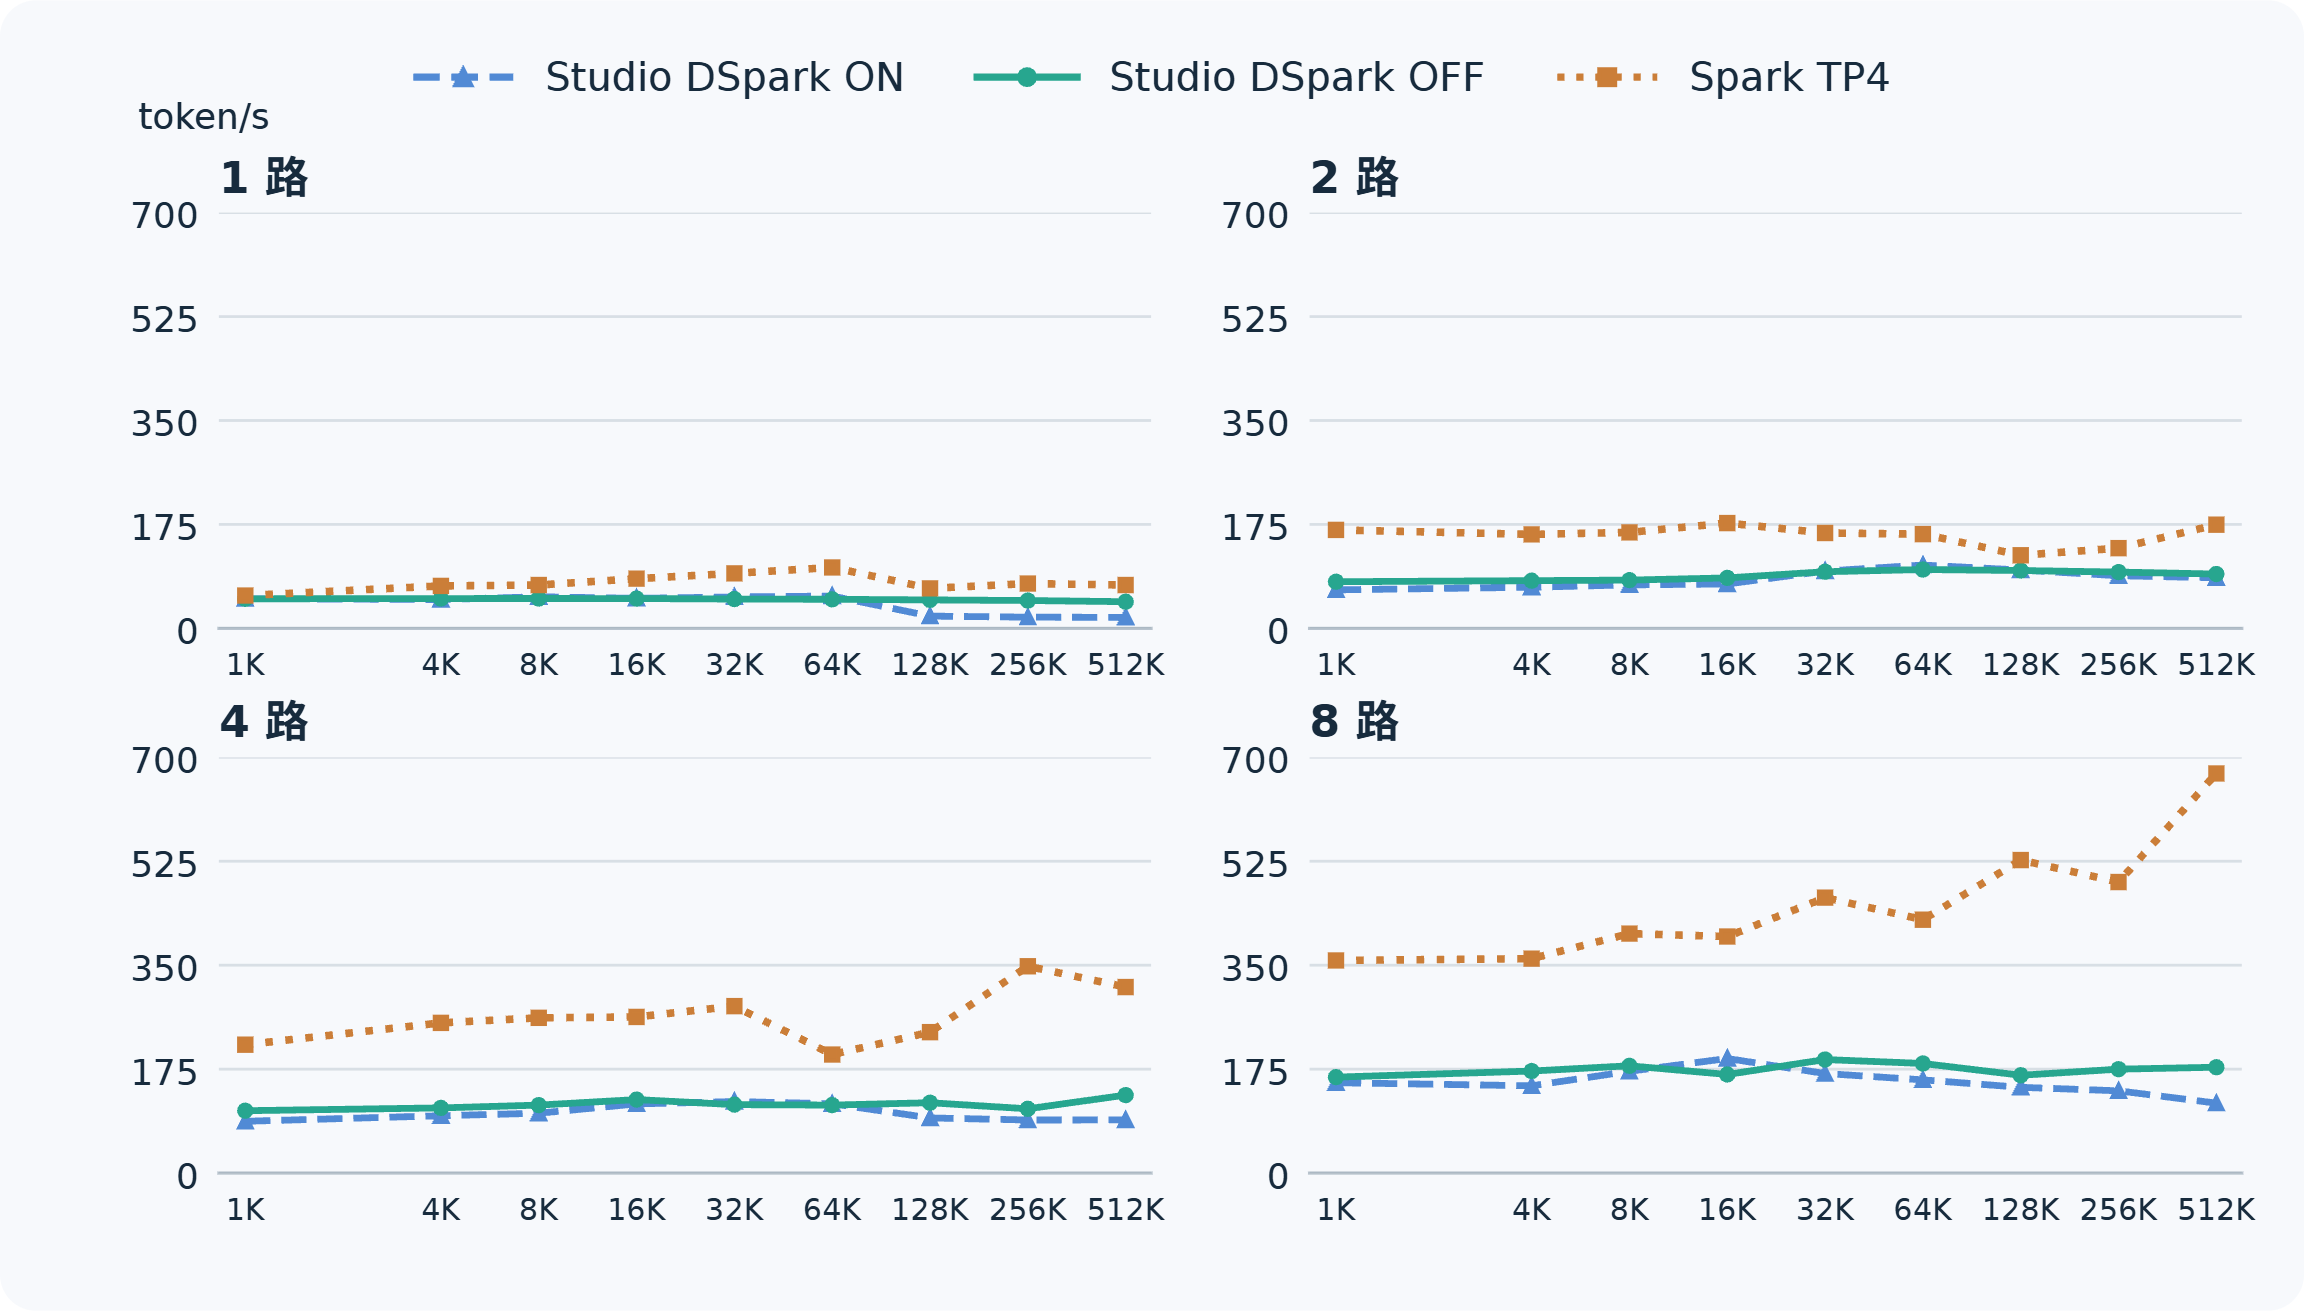
512K 八路,Spark TP4 为 672.8 token/s,Studio DSpark ON/Studio DSpark OFF 为 117.78/178.27 token/s。这个指标采用原帖公式;是否更早交付,还要看墙钟。
4. 聚合预填充吞吐(token/s)

八路下,32K 时 Spark TP4 更高;512K 时 Studio 两档约 3,300 token/s,Spark TP4 约 2,860 token/s。相对位置随负载变化。
六、对比小结
先看两个代表负载:8K 单路、512K 八路。每个面板按自己的指标排序,条长从零开始。

1. Studio 同机开关
36 个配对档位中,Studio DSpark OFF 有 25 格聚合 tg 更高,但不能只按这个数选开关。例如 16K 八路:Studio DSpark ON 的聚合 tg 为 192.93,Studio DSpark OFF 为 166.04 token/s;整批耗时却是 Studio DSpark ON 48.61 秒、Studio DSpark OFF 43.84 秒。长档每格只有一批,能定位差异,不能据此估计稳定收益。
2. 四台 Spark 同档参考
512K 单路,Studio DSpark OFF 首 token 163.36 秒,比 Spark TP4 的 181.40 秒快;但 Spark TP4 单流解码 73.0 token/s,明显高于 Studio DSpark OFF 的 44.94。到了 512K 八路,Spark TP4 最慢首 token 仅 815.73 秒,整批却要 1,405.41 秒;Studio DSpark OFF 是 1,215.89 秒和 1,221.65 秒。首 token 和整批完成排出的名次相反。
两侧引擎、Engram 精度和拓扑都不同,Spark TP4 公开的是原报汇总,没有逐路时钟。这些数字描述各自整套推理栈在该负载下的结果;要判断单项硬件的影响,需要控制运行栈和量化再测。
七、聚合 tg 与实际交付时间
512K 八路,两套设置都输出了 1,024 token,公式表现与实际交付时间的差距最明显。
部署 聚合 tg(token/s) 公式分母约值(秒) 整批耗时(秒) Studio DSpark ON 117.78 8.69 1,222.56 Studio DSpark OFF 178.27 5.74 1,221.65 聚合 tg 的分子计入了较早完成各路的输出,分母却是
max(W) − max(TTFT)。所以 Studio DSpark OFF 的聚合 tg 高约 51%,整批只早约 0.91 秒结束。这是原帖公式在错峰负载下的读数,不能理解为整批快了 51%。八、结论
以 512K 为例,分别比较首 token 等待和整批完成时间。每个面板只显示一个指标,单位为秒,越低越好;单路、八路分开比较。

- 单路:Studio DSpark OFF 两项都更快。 相对 Spark TP4,首 token 更早 18.04 秒,整路完成更早 16.94 秒。这个结果针对本次 512K 输入、128 token 输出。
- 八路:两项指标的领先方不同。 Spark TP4 的首 token 等待更短,比 Studio DSpark OFF 少 400.16 秒;Studio DSpark OFF 的整批完成时间更短,比 Spark TP4 少 183.76 秒。
- 不能把解码速度当成交付时间。 单用户看这一轮什么时候开始输出、什么时候结束;批量任务看最慢一路的等待和整批收尾。只看聚合 tg,会漏掉排队与预填充的等待。
- 本次边界: 不评价生成质量和能效,长输出收益需要另测。单路 1M 补测见第九节。Spark TP4 的原帖未附逐路时钟,本次采用其发布的汇总值。
九、单路 1M 上下文补测
同一台 Studio 使用 Studio DSpark OFF,另跑一条 1M 请求。沿用 oMLX 0.8.0rc1、4-bit affine Engram 和
llm-inference-bench 0.7.6。这批数据独立于 1K–512K 的 72 格主矩阵,不与 Spark TP4 做同档性能比较。指标 本次实测 服务上下文上限 1,048,576 token 实际输入/输出 1,000,000/128 token 首 token 延迟(TTFT) 642.264 秒 整路完成时间 645.338 秒 单路预填充吞吐 1,556.99 token/s 单流解码吞吐 41.63 token/s 服务进程常驻内存峰值(RSS) 318.57 GiB swap 0 服务返回 HTTP 200,推理 token 和前缀缓存命中均为零,以
length和[DONE]正常结束。这是一次生成测试。 整个任务发出了 76 次 HTTP 请求,但其中只有 1 次生成,不能按 76 次性能采样理解。测试后已回收进程和监听端口。
客户端的 600 秒限制针对单次读取的静默时间,不是整个生成过程的总时长。本次最长读取间隔为 10.123 秒,TTFT 独立计时,因此首 token 用时超过 600 秒与请求成功并不矛盾。
本帖以图表展示完整扫描,逐档原始数值和逐路记录另行留存,不在正文重复铺开。
- 单流 pp、tg:分别对每路的
-
,
 I ivan lan 引用了 此主题
-
-
 最后一个小测验居然是跑一兆上下文
家用机跑一兆,真敢想啊 -
最后一个小测验居然是跑一兆上下文
家用机跑一兆,真敢想啊 -
@xiongjie-gao 没有使用场景,纯测试
-
-
-
-
-
不错。完全可用。而且没什么噪音。力挺 MAC。
-
-
-
-
,
 T terry 固定了此主题
-
-
-
-
-
,I ivan lan 引用了 此主题



 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!
 本帖由优秀升级为精华(两者互斥,只补差价),作者 +3 积分,累计 6 分。
