跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. 来交作业了,华南金牌X99套装+RTX3090Ti+RTX3060双卡装机完毕

来交作业了,华南金牌X99套装+RTX3090Ti+RTX3060双卡装机完毕

已定时 已固定 已锁定 已移动 热议 AI硬件
nvidia多卡部署
26 帖子 13 发布者 2.5k 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 九 九门奇人

    你这个贴子我很感兴趣。在我的印象中,这种配置的短板在低端一点的显卡上,我很想看看你的3060会跑出什么样的成绩出来。

    J
    J
    joker_chang
    体面乡绅 硕果累累
    发表于 最后由 编辑
    #8

    @九门奇人 我之前在老机器上跑过(64G物理内存,3060 12G显存,windows10),llama.cpp加载Qwen3.6-35B-A3B-UD-Q4_K_M.gguf,8tokens/s;Qwen3.6-27B-Q4_K_M.gguf只有零点几token/s

    1 条回复 最后回复
    0
    • A
      A
      applejuice
      王侯将相
      发表于 最后由 编辑
      #9

      我因为nvlink 整个预算超了
      整体弄到来包裹邮寄都2万了...
      心滴血
      希望 拿到 机器 可以回点血

      1 条回复 最后回复
      0
      • 暧 暧昧光影

        我也是3090ti+3060,目前只能周末折腾 目前只能单卡3090ti跑27B+80K上下文,还没空装Ubuntu,期待你的表现

        J
        J
        joker_chang
        体面乡绅 硕果累累
        发表于 最后由 编辑
        #10

        @暧昧光影 windows10下llama.cpp是编译好了,但是今天的结果很不理想。不管是单3090还是3090+3060,都只能跑到个位数tokens/s

        效果还不如前几天用LM Studio加载unsloth非MTP的版本

        A Ray WangR 2 条回复 最后回复
        0
        • J joker_chang

          @暧昧光影 windows10下llama.cpp是编译好了,但是今天的结果很不理想。不管是单3090还是3090+3060,都只能跑到个位数tokens/s

          效果还不如前几天用LM Studio加载unsloth非MTP的版本

          A
          A
          applejuice
          王侯将相
          发表于 最后由 编辑
          #11

          @joker_chang 说:

          @暧昧光影 windows10下llama.cpp是编译好了,但是今天的结果很不理想。不管是单3090还是3090+3060,都只能跑到个位数tokens/s

          效果还不如前几天用LM Studio加载unsloth非MTP的版本

          试试vllm

          1 条回复 最后回复
          0
          • J joker_chang

            @暧昧光影 windows10下llama.cpp是编译好了,但是今天的结果很不理想。不管是单3090还是3090+3060,都只能跑到个位数tokens/s

            效果还不如前几天用LM Studio加载unsloth非MTP的版本

            Ray WangR
            Ray WangR
            Ray Wang
            体面乡绅
            发表于 最后由 Ray Wang 编辑
            #12

            @joker_chang https://github.com/noonghunna/club-3090

            照这个抄作业,不过前提是装linux,3090用llama.cpp方案,最低也能跑到20 tokens/s。用vllm方案可以跑到50+。

            玩大模型还是别用windows了

            Server: 2x E5 2680v4 | 2x RTX 3090 | 128GB DDR3 ECC
            PC: 9950x | 1080 Ti | 96GB DDR5

            J 1 条回复 最后回复
            0
            • Ray WangR Ray Wang

              @joker_chang https://github.com/noonghunna/club-3090

              照这个抄作业,不过前提是装linux,3090用llama.cpp方案,最低也能跑到20 tokens/s。用vllm方案可以跑到50+。

              玩大模型还是别用windows了

              J
              J
              joker_chang
              体面乡绅 硕果累累
              发表于 最后由 编辑
              #13

              @Ray-Wang 谢谢您的回复,我先折腾几天,不行就重装Ubuntu系统

              1 条回复 最后回复
              0
              • sirwangS
                sirwangS
                sirwang
                易有太极
                发表于 最后由 编辑
                #14

                换成linux吧。

                J 1 条回复 最后回复
                0
                • J
                  J
                  joker_chang
                  体面乡绅 硕果累累
                  发表于 最后由 编辑
                  #15

                  折腾了几天,踩了无数坑:
                  1、windows10的电源一定要用卓越性能,不然GPU的频率根本跑不起来,会被限制到180w左右
                  2、cmake编译llama.cpp不要抄作业(反正我本人没搞定,自己编译的能跑但是最多不到10tokens/s),直接用官方https://github.com/ggml-org/llama.cpp/releases的版本,3090下Windows x64 (CUDA 12)
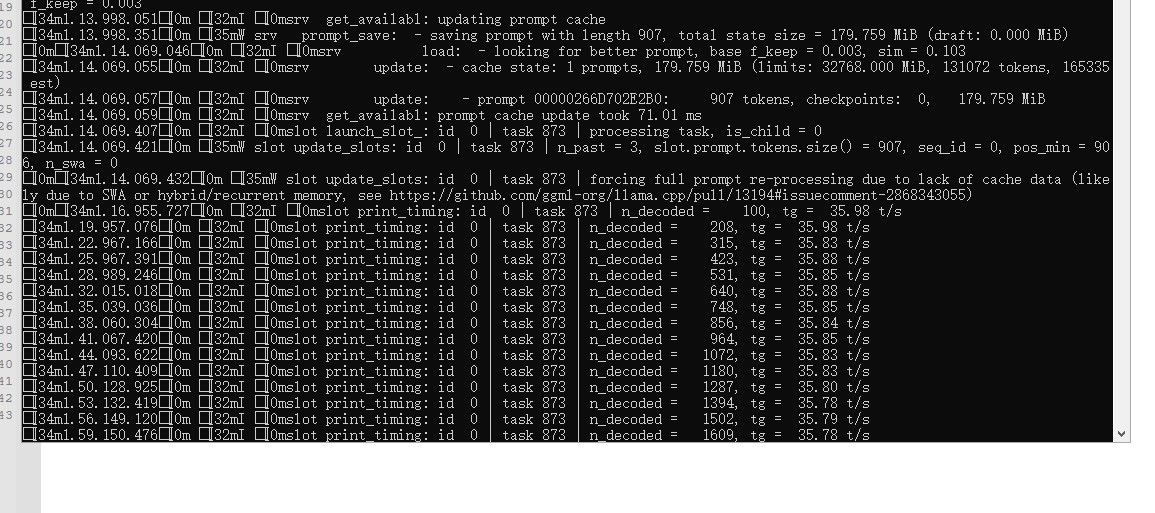
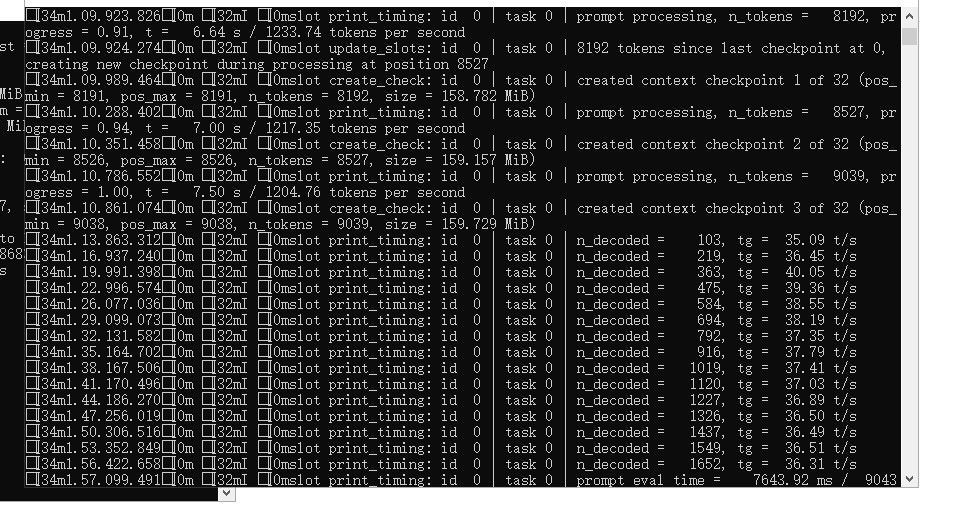
                  3、官方编译的版本能Qwen3.6 27B跑到35tokens/s,不过MTP没什么效果,我跑unsloth的MTP版本Qwen3.6 27B,也就只能跑到37tokens/s
                  188067d1-3762-48c0-9bee-673d2d4ab02c-image.jpeg

                  02bc2f94-3075-4d19-bc06-f9df4653f2b4-image.jpeg

                  J johnnybegoodJ rock shiR 3 条回复 最后回复
                  1
                  • sirwangS sirwang

                    换成linux吧。

                    J
                    J
                    joker_chang
                    体面乡绅 硕果累累
                    发表于 最后由 编辑
                    #16

                    @sirwang 等明天装好双卡(物理上3060没插),双卡测试一下,再折腾linux

                    1 条回复 最后回复
                    0
                    • J joker_chang

                      折腾了几天,踩了无数坑:
                      1、windows10的电源一定要用卓越性能,不然GPU的频率根本跑不起来,会被限制到180w左右
                      2、cmake编译llama.cpp不要抄作业(反正我本人没搞定,自己编译的能跑但是最多不到10tokens/s),直接用官方https://github.com/ggml-org/llama.cpp/releases的版本,3090下Windows x64 (CUDA 12)
                      3、官方编译的版本能Qwen3.6 27B跑到35tokens/s,不过MTP没什么效果,我跑unsloth的MTP版本Qwen3.6 27B,也就只能跑到37tokens/s
                      188067d1-3762-48c0-9bee-673d2d4ab02c-image.jpeg

                      02bc2f94-3075-4d19-bc06-f9df4653f2b4-image.jpeg

                      J
                      J
                      joker_chang
                      体面乡绅 硕果累累
                      发表于 最后由 joker_chang 编辑
                      #17

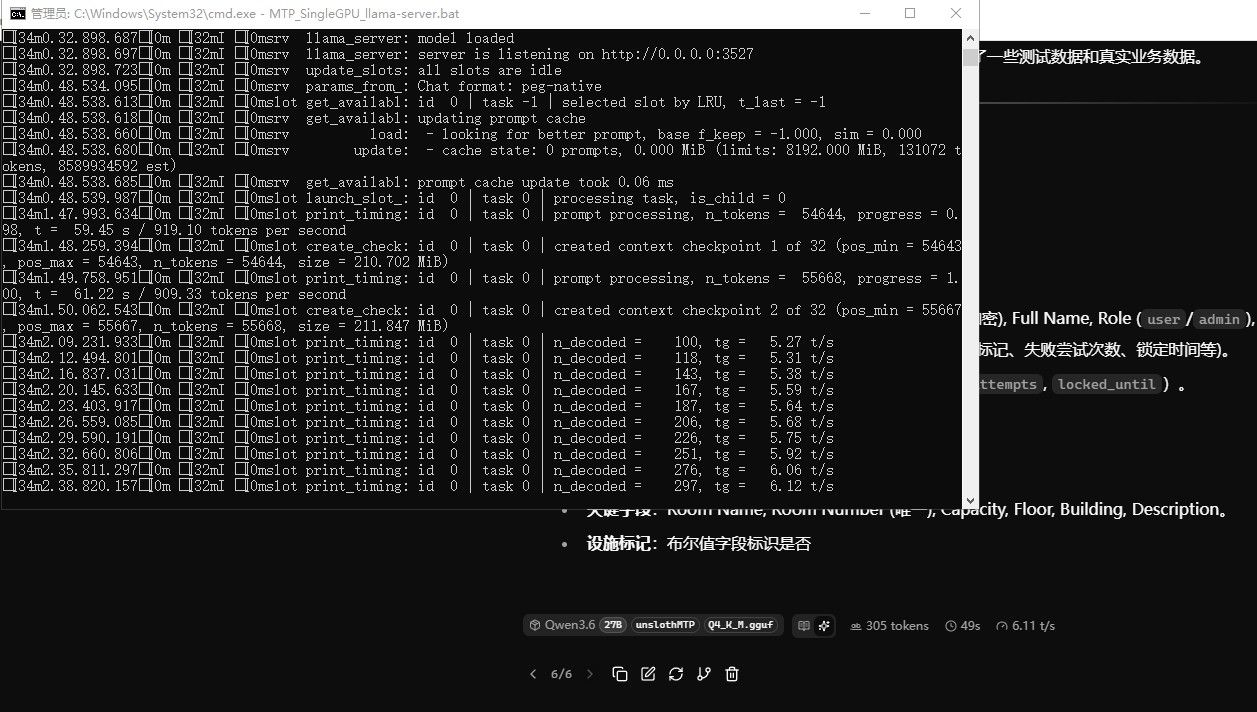
                      9a1fc078-9911-4ed1-9d7c-6a2f95cced3a-image.jpeg

                      这是我自己编译的llama.cpp

                      同样的模型,同样的硬件,同样的启动脚本,差别简直了......
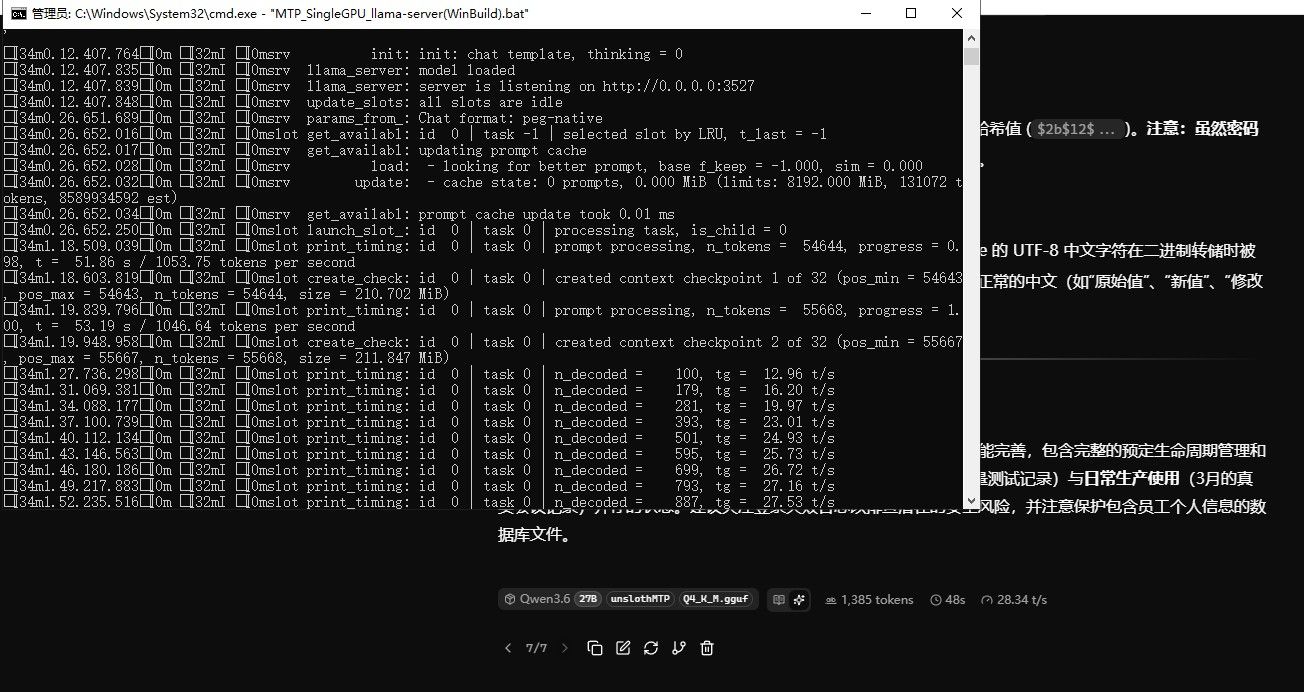
                      32ad04c9-dd7c-4a0b-adb1-b48fce5945b7-image.jpeg

                      这是https://github.com/ggml-org/llama.cpp/releases/download/b9305/llama-b9305-bin-win-cuda-12.4-x64.zip的

                      哎~

                      1 条回复 最后回复
                      1
                      • J joker_chang

                        折腾了几天,踩了无数坑:
                        1、windows10的电源一定要用卓越性能,不然GPU的频率根本跑不起来,会被限制到180w左右
                        2、cmake编译llama.cpp不要抄作业(反正我本人没搞定,自己编译的能跑但是最多不到10tokens/s),直接用官方https://github.com/ggml-org/llama.cpp/releases的版本,3090下Windows x64 (CUDA 12)
                        3、官方编译的版本能Qwen3.6 27B跑到35tokens/s,不过MTP没什么效果,我跑unsloth的MTP版本Qwen3.6 27B,也就只能跑到37tokens/s

                        188067d1-3762-48c0-9bee-673d2d4ab02c-image.jpeg

                        02bc2f94-3075-4d19-bc06-f9df4653f2b4-image.jpeg

                        johnnybegoodJ
                        johnnybegoodJ
                        johnnybegood
                        王侯将相
                        发表于 最后由 编辑
                        #18

                        @joker_chang 你MTP没设置好, 你看看我的帖子

                        1 条回复 最后回复
                        1
                        • J joker_chang

                          折腾了几天,踩了无数坑:
                          1、windows10的电源一定要用卓越性能,不然GPU的频率根本跑不起来,会被限制到180w左右
                          2、cmake编译llama.cpp不要抄作业(反正我本人没搞定,自己编译的能跑但是最多不到10tokens/s),直接用官方https://github.com/ggml-org/llama.cpp/releases的版本,3090下Windows x64 (CUDA 12)
                          3、官方编译的版本能Qwen3.6 27B跑到35tokens/s,不过MTP没什么效果,我跑unsloth的MTP版本Qwen3.6 27B,也就只能跑到37tokens/s

                          188067d1-3762-48c0-9bee-673d2d4ab02c-image.jpeg

                          02bc2f94-3075-4d19-bc06-f9df4653f2b4-image.jpeg

                          rock shiR
                          rock shiR
                          rock shi
                          体面乡绅 硕果累累
                          发表于 最后由 编辑
                          #19

                          @joker_chang 3090跑qwen27b,mtp理论上应该55-60t/s。
                          你可以丢给AI让他帮你改一下启动代码。

                          主机:GPU0-3080 20g(H3),GPU1-3080 20g(Zimage)
                          副机:2x2080ti 22g,strata qwen3.8 next Flash iq3_s

                          J 1 条回复 最后回复
                          0
                          • E
                            E
                            ezios
                            体面乡绅
                            发表于 最后由 编辑
                            #20

                            prefill速度多少

                            最近开始玩LLM和COMFYUI
                            手头只有RTX4060

                            考虑购入RTX2080TI22G娱乐一下

                            J 1 条回复 最后回复
                            0
                            • E ezios

                              prefill速度多少

                              J
                              J
                              joker_chang
                              体面乡绅 硕果累累
                              发表于 最后由 编辑
                              #21

                              @ezios
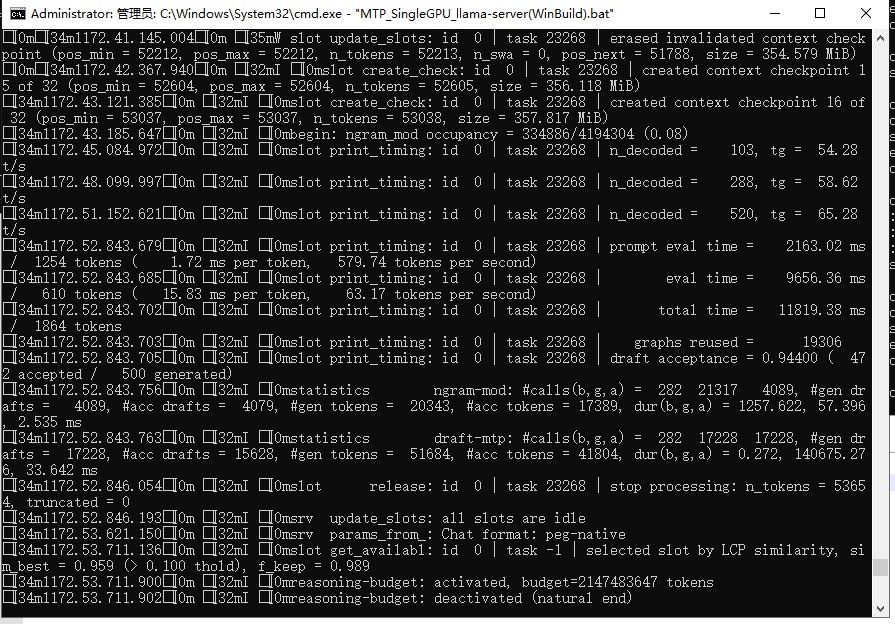
                              1172.52.843.679 I slot print_timing: id 0 | task 23268 | prompt eval time = 2163.02 ms / 1254 tokens ( 1.72 ms per token, 579.74 tokens per second)

                              这直接显示了prompt eval的速度。所以prefill速度是处理1254个token用了2163.02 ms,即1.72毫秒每token,或579.74 tokens/s。

                              1ce86a71-2324-4e29-961b-9770f464aa2f-image.jpeg

                              1 条回复 最后回复
                              0
                              • rock shiR rock shi

                                @joker_chang 3090跑qwen27b,mtp理论上应该55-60t/s。
                                你可以丢给AI让他帮你改一下启动代码。

                                J
                                J
                                joker_chang
                                体面乡绅 硕果累累
                                发表于 最后由 编辑
                                #22

                                @rock-shi

                                @rock-shi 经过论坛大神的指点(--ubatch-size 1024),和自己不断的折腾,能达到这个值了。

                                启动参数:
                                --host 0.0.0.0 ^
                                --port 3527 ^
                                --reasoning off ^
                                --n-gpu-layers -1 ^
                                --ctx-size 131072 ^
                                --batch-size 2048 ^
                                --ubatch-size 1024 ^
                                --flash-attn on ^
                                --cache-type-k q4_0 ^
                                --cache-type-v q4_0 ^
                                --spec-type draft-mtp,ngram-mod ^
                                --spec-draft-n-max 3 ^
                                --spec-ngram-mod-n-max 5 ^
                                --spec-ngram-mod-n-min 3 ^
                                --temp 0.7 ^
                                --parallel 1

                                J 1 条回复 最后回复
                                1
                                • J joker_chang

                                  @rock-shi

                                  @rock-shi 经过论坛大神的指点(--ubatch-size 1024),和自己不断的折腾,能达到这个值了。

                                  启动参数:
                                  --host 0.0.0.0 ^
                                  --port 3527 ^
                                  --reasoning off ^
                                  --n-gpu-layers -1 ^
                                  --ctx-size 131072 ^
                                  --batch-size 2048 ^
                                  --ubatch-size 1024 ^
                                  --flash-attn on ^
                                  --cache-type-k q4_0 ^
                                  --cache-type-v q4_0 ^
                                  --spec-type draft-mtp,ngram-mod ^
                                  --spec-draft-n-max 3 ^
                                  --spec-ngram-mod-n-max 5 ^
                                  --spec-ngram-mod-n-min 3 ^
                                  --temp 0.7 ^
                                  --parallel 1

                                  J
                                  J
                                  joker_chang
                                  体面乡绅 硕果累累
                                  发表于 最后由 编辑
                                  #23

                                  将启动脚本和运行日志丢给云端大模型(Qwen3.7-Max)分析,被告知:

                                  一、“日志显示 ngram-mod 的接受率为 0(#acc drafts = 0, #acc tokens = 0),但它仍占用了 16MB 显存和每次推理的检查开销。”

                                  移除:
                                  【
                                  ngram-mod ^
                                  --spec-ngram-mod-n-max 5 ^
                                  --spec-ngram-mod-n-min 3
                                  】

                                  二、启用 --kv-unified 以激活 idle slots 缓存
                                  日志警告:【W srv init: --cache-idle-slots requires --kv-unified, disabling】

                                  三、增大 Host Prompt Cache 上限
                                  当前仅 8192 MiB(默认值),对于 coding 场景(大量重复系统提示词/代码库前缀)过于保守。

                                  因此增加相关参数:【
                                  --cache-ram 32768 ^
                                  --kv-unified
                                  】

                                  修订启动参数:
                                  --reasoning off ^
                                  --n-gpu-layers -1 ^
                                  --ctx-size 131072 ^
                                  --batch-size 2048 ^
                                  --ubatch-size 1024 ^
                                  --flash-attn on ^
                                  --cache-type-k q4_0 ^
                                  --cache-type-v q4_0 ^
                                  --spec-type draft-mtp ^
                                  --spec-draft-n-max 3 ^
                                  --temp 0.7 ^
                                  --parallel 1 ^
                                  --cache-ram 32768 ^
                                  --kv-unified

                                  感觉修改后,效果并不明显(没有提高也没有下降,正负值在1%上下)......

                                  1 条回复 最后回复
                                  0
                                  • J
                                    J
                                    janebo
                                    发表于 最后由 编辑
                                    #24

                                    最近也是纠结,手上也是有一张 3060 12g 卡是直接出掉换7900xtx,还是上买一张3060 12g 来,但是换两张3060 主板要换,我的主板小板只有一张16x PCI槽,折腾成本也高,最近在看3090 24g 基本上差不多六千多,跑ComfyUI是我的需求,模型我直接走供应商还比较方便。

                                    terryT 1 条回复 最后回复
                                    0
                                    • J janebo

                                      最近也是纠结,手上也是有一张 3060 12g 卡是直接出掉换7900xtx,还是上买一张3060 12g 来,但是换两张3060 主板要换,我的主板小板只有一张16x PCI槽,折腾成本也高,最近在看3090 24g 基本上差不多六千多,跑ComfyUI是我的需求,模型我直接走供应商还比较方便。

                                      terryT
                                      terryT
                                      terry
                                      易有太极
                                      发表于 最后由 编辑
                                      #25

                                      @janebo 肯定是单卡好

                                      油管:https://www.youtube.com/@抡锤者

                                      1 条回复 最后回复
                                      0
                                      • qw erQ
                                        qw erQ
                                        qw er
                                        发表于 最后由 编辑
                                        #26

                                        3090插在X99的第几个卡槽啊,插在第1个的话第二个还能插显卡吗?第二个是X4还是X16的?我还没动手想抄作业

                                        1 条回复 最后回复
                                        0

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组