跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 用於電商搭建自運營的模型選擇qwen3.6 27b 用Q4還是Q8合適

用於電商搭建自運營的模型選擇qwen3.6 27b 用Q4還是Q8合適

已定时 已固定 已锁定 已移动 LLM讨论区
本地模型qwen-27b量化
11 帖子 5 发布者 576 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • G
    G
    Gavin2024
    发表于 最后由 编辑
    #1

    想做電商,讓Hermes agent來搭建,打算用next js技術棧, 平時使用Lm studio 加載qwen3.6 27b q4_k_m, 我總覺得不夠聰明,很多時候頁面明明未做好就說做好。我想說,換成q8_0 會不會效率好一點? 準確率高一點?
    日後上線,Hermes agent自己運營網站,維護,推廣,那是不是q8_0會更合適?

    1 条回复 最后回复
    1
    • kop wangK
      kop wangK
      kop wang
      易有太极
      发表于 最后由 编辑
      #2

      Q4量化和Q8量化的差距不是质的差距。所以Q4不够用的话,90%的可能性是Q8也不行。
      而且不够聪明其实有很多个维度的解释,楼主可以晒出你的模型启动全参数,这样可以更综合的判断问题

      虚心交流,一起进步

      G 1 条回复 最后回复
      1
      • kop wangK kop wang

        Q4量化和Q8量化的差距不是质的差距。所以Q4不够用的话,90%的可能性是Q8也不行。
        而且不够聪明其实有很多个维度的解释,楼主可以晒出你的模型启动全参数,这样可以更综合的判断问题

        G
        G
        Gavin2024
        发表于 最后由 Gavin2024 编辑
        #3

        @kop-wang 討教一下,q4和q8區別是什麼呢? 我一直不太明白,不是專業技術人員, 簡單理解為壓縮率的差別,所以以為q8會聰明很多。

        kop wangK 1 条回复 最后回复
        0
        • G Gavin2024

          @kop-wang 討教一下,q4和q8區別是什麼呢? 我一直不太明白,不是專業技術人員, 簡單理解為壓縮率的差別,所以以為q8會聰明很多。

          kop wangK
          kop wangK
          kop wang
          易有太极
          发表于 最后由 kop wang 编辑
          #4

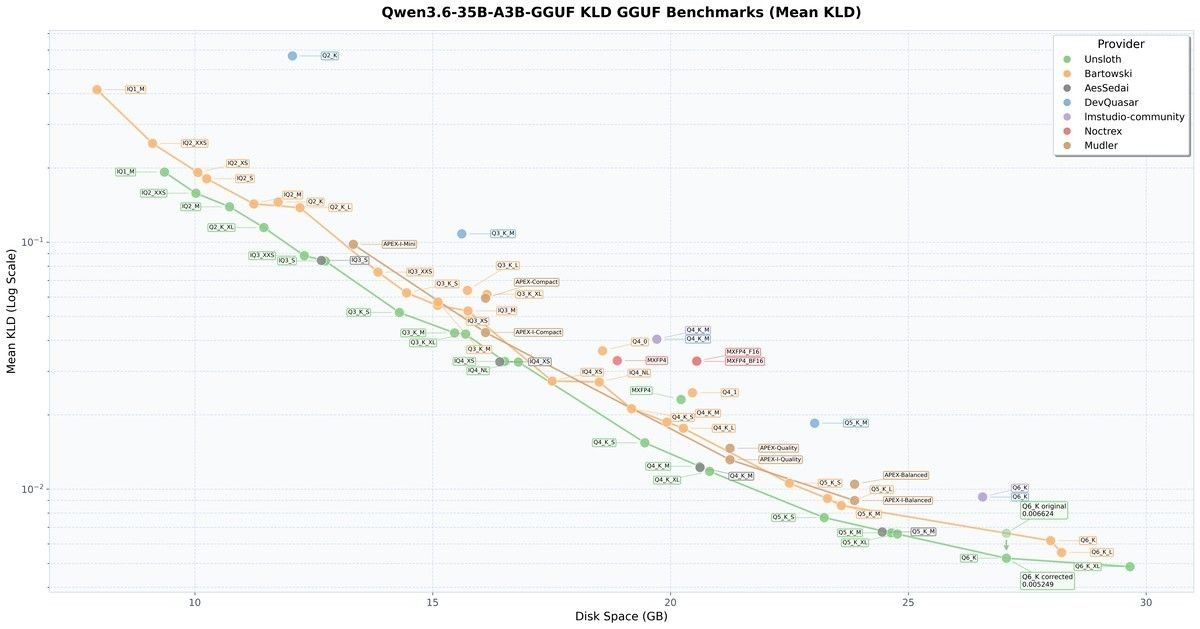
          @Gavin2024 大致是这样的,认真来说是精度的区别,一个是4bit精度,一个是8bit精度。而且严格来说,他不是“损失”,他是和全量模型之间的“区别”。这个“区别”是中性词汇,只不过我们更讨厌不稳定,所以把他理解为损失。

          至于说这个“区别”,也就是KL散度,可以看下图:
          a22f3b29-bec4-4875-ab6d-dfc2177f6293-image.jpeg

          虚心交流,一起进步

          1 条回复 最后回复
          0
          • AGIA
            AGIA
            AGI
            贵族大夫 硕果累累
            发表于 最后由 编辑
            #5

            看你硬件,q4相比q8有些许差距,幻觉会多一些,q6是甜品级别的,不行就上q5,看你硬件。lm studio和llama.cpp差距较大,用llama.cpp吧,论坛很多帖子。

            你要说你的硬件,你的参数

            https://agi.cd/@x

            5 G 2 条回复 最后回复
            1
            • AGIA AGI

              看你硬件,q4相比q8有些许差距,幻觉会多一些,q6是甜品级别的,不行就上q5,看你硬件。lm studio和llama.cpp差距较大,用llama.cpp吧,论坛很多帖子。

              你要说你的硬件,你的参数

              5
              5
              566656661
              王侯将相
              发表于 最后由 566656661 编辑
              #6

              @AGI

              lmstudio不是llama.cpp的fork嘛

              而且電商估計要並發, llama.cpp不太合適吧?

              AGIA 1 条回复 最后回复
              0
              • AGIA AGI

                看你硬件,q4相比q8有些许差距,幻觉会多一些,q6是甜品级别的,不行就上q5,看你硬件。lm studio和llama.cpp差距较大,用llama.cpp吧,论坛很多帖子。

                你要说你的硬件,你的参数

                G
                G
                Gavin2024
                发表于 最后由 编辑
                #7

                @AGI 13600kf 32gb內存, 3090 24gb+3080 10gb。 想添加3060 12gb, 湊到46gb顯存

                kos orK AGIA 2 条回复 最后回复
                1
                • G Gavin2024

                  @AGI 13600kf 32gb內存, 3090 24gb+3080 10gb。 想添加3060 12gb, 湊到46gb顯存

                  kos orK
                  kos orK
                  kos or
                  至尊皇帝
                  发表于 最后由 编辑
                  #8

                  @Gavin2024 真的 VRAM 太缺了~不得不

                  1 条回复 最后回复
                  0
                  • G Gavin2024

                    @AGI 13600kf 32gb內存, 3090 24gb+3080 10gb。 想添加3060 12gb, 湊到46gb顯存

                    AGIA
                    AGIA
                    AGI
                    贵族大夫 硕果累累
                    发表于 最后由 编辑
                    #9

                    @Gavin2024 这个需要你测试了,46g用q6就可以,再高了,收益不值得。需要测试你的上下文和并发数的取舍,这个只能根据你的情况调试。没有你实际使用情况,谁也无法给你具体参数。

                    https://agi.cd/@x

                    1 条回复 最后回复
                    0
                    • 5 566656661

                      @AGI

                      lmstudio不是llama.cpp的fork嘛

                      而且電商估計要並發, llama.cpp不太合適吧?

                      AGIA
                      AGIA
                      AGI
                      贵族大夫 硕果累累
                      发表于 最后由 编辑
                      #10

                      @566656661 这个我还真不清楚,我只知道parallel 上下文是互相隔离的啊,应该不会影响吧
                      https://agi.cd/@x

                      5 1 条回复 最后回复
                      0
                      • AGIA AGI

                        @566656661 这个我还真不清楚,我只知道parallel 上下文是互相隔离的啊,应该不会影响吧
                        5
                        5
                        566656661
                        王侯将相
                        发表于 最后由 编辑
                        #11

                        @AGI

                        llama.cpp的架構只適合單人使用啊, 并發的請求處理是一個接一個

                        1 条回复 最后回复
                        0

                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                        有了你的建议,这篇帖子会更精彩哦 💗

                        注册 登录
                        回复
                        • 在新帖中回复
                        登录后回复
                        • 从旧到新
                        • 从新到旧
                        • 最多赞同


                        • 登录

                        • 登录或注册以进行搜索。
                        • 第一个帖子
                          最后一个帖子
                        0
                        • 版块
                        • 最新
                        • 标签
                        • 热门
                        • 用户
                        • 群组