跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 刚把推理引擎跑到15 token/s,新人发帖想听听大家的意见

刚把推理引擎跑到15 token/s,新人发帖想听听大家的意见

已定时 已固定 已锁定 已移动 LLM讨论区
本地模型
14 帖子 5 发布者 659 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • terryT
    terryT
    terry
    易有太极
    发表于 最后由 terry 编辑
    #2

    这里又不是麻省理工,发个帖子有什么紧张的。你发的这个玩意一般人看不懂,技术大牛们可以来给你品品,超出了我的理解范围。

    油管:https://www.youtube.com/@抡锤者

    bingqin wangB 1 条回复 最后回复
    1
    • terryT terry 于 将此主题从 随便聊聊 移至此处
    • terryT terry

      这里又不是麻省理工,发个帖子有什么紧张的。你发的这个玩意一般人看不懂,技术大牛们可以来给你品品,超出了我的理解范围。

      bingqin wangB
      bingqin wangB
      bingqin wang
      体面乡绅
      发表于 最后由 编辑
      #3

      @terry 感谢老大 你的视频对我帮助也很大 少踩了不少坑 你太谦虚了

      1 条回复 最后回复
      0
      • 5
        5
        566656661
        王侯将相
        发表于 最后由 566656661 编辑
        #4

        整數運算? 是指非FP形式的GEMM嗎? INT8的W8A8或者INT4的W4A4?

        如果是用來適配舊顯卡/NPU這個思路不是不行

        但是目前的新顯卡大方向是FP低精度運算, 可能聚焦在NPU比較好? 目前大多數NPU的用法也是NPU Prefill + GPU Decode

        AMD XDNA系列跟Intel的NPU系列

        Intel的爛命名, 沒有架構名字, 只叫NPU然後加個數字, Arrow Lake (Ultra 200)用NPU 3720, Panther Lake (Ultra 300)用NPU 5

        bingqin wangB 1 条回复 最后回复
        1
        • 5 566656661

          整數運算? 是指非FP形式的GEMM嗎? INT8的W8A8或者INT4的W4A4?

          如果是用來適配舊顯卡/NPU這個思路不是不行

          但是目前的新顯卡大方向是FP低精度運算, 可能聚焦在NPU比較好? 目前大多數NPU的用法也是NPU Prefill + GPU Decode

          AMD XDNA系列跟Intel的NPU系列

          Intel的爛命名, 沒有架構名字, 只叫NPU然後加個數字, Arrow Lake (Ultra 200)用NPU 3720, Panther Lake (Ultra 300)用NPU 5

          bingqin wangB
          bingqin wangB
          bingqin wang
          体面乡绅
          发表于 最后由 编辑
          #5

          @566656661 果然是专家 确实是非浮点运算 但是比您说的这种更极端 我从数学底层把所有乘除和微分计算都换成了有限加法表达的公式 也就是全面离散数学化 非线性计算用了一部分查表 我的目标是NPU 利用CANN算子做优化 这样有俩个好处1.可以最大避免带宽影响大力出奇迹 2.所有结果计算可审计 相同的seed得到的答案完全一致 比较适合高确定性场景

          5 1 条回复 最后回复
          1
          • kos orK
            kos orK
            kos or
            至尊皇帝
            发表于 最后由 编辑
            #6

            不懂, 但是只要能你做得比其他引擎快 就成了; 建議和其他引擎benchmark 在相同條件下 對照一下推理速度和輸出品質 等你的好消息 🙂

            bingqin wangB 1 条回复 最后回复
            0
            • kos orK kos or

              不懂, 但是只要能你做得比其他引擎快 就成了; 建議和其他引擎benchmark 在相同條件下 對照一下推理速度和輸出品質 等你的好消息 🙂

              bingqin wangB
              bingqin wangB
              bingqin wang
              体面乡绅
              发表于 最后由 编辑
              #7

              @kos-or 其实说白了就是穷的 我就想现在不是升腾的加速卡便宜 看看能不能想办法把不到一万块的96g显存用起来 不求n卡的速度 起码能用就是胜利 一分钱一分货 能用就行

              1 条回复 最后回复
              1
              • kos orK
                kos orK
                kos or
                至尊皇帝
                发表于 最后由 编辑
                #8

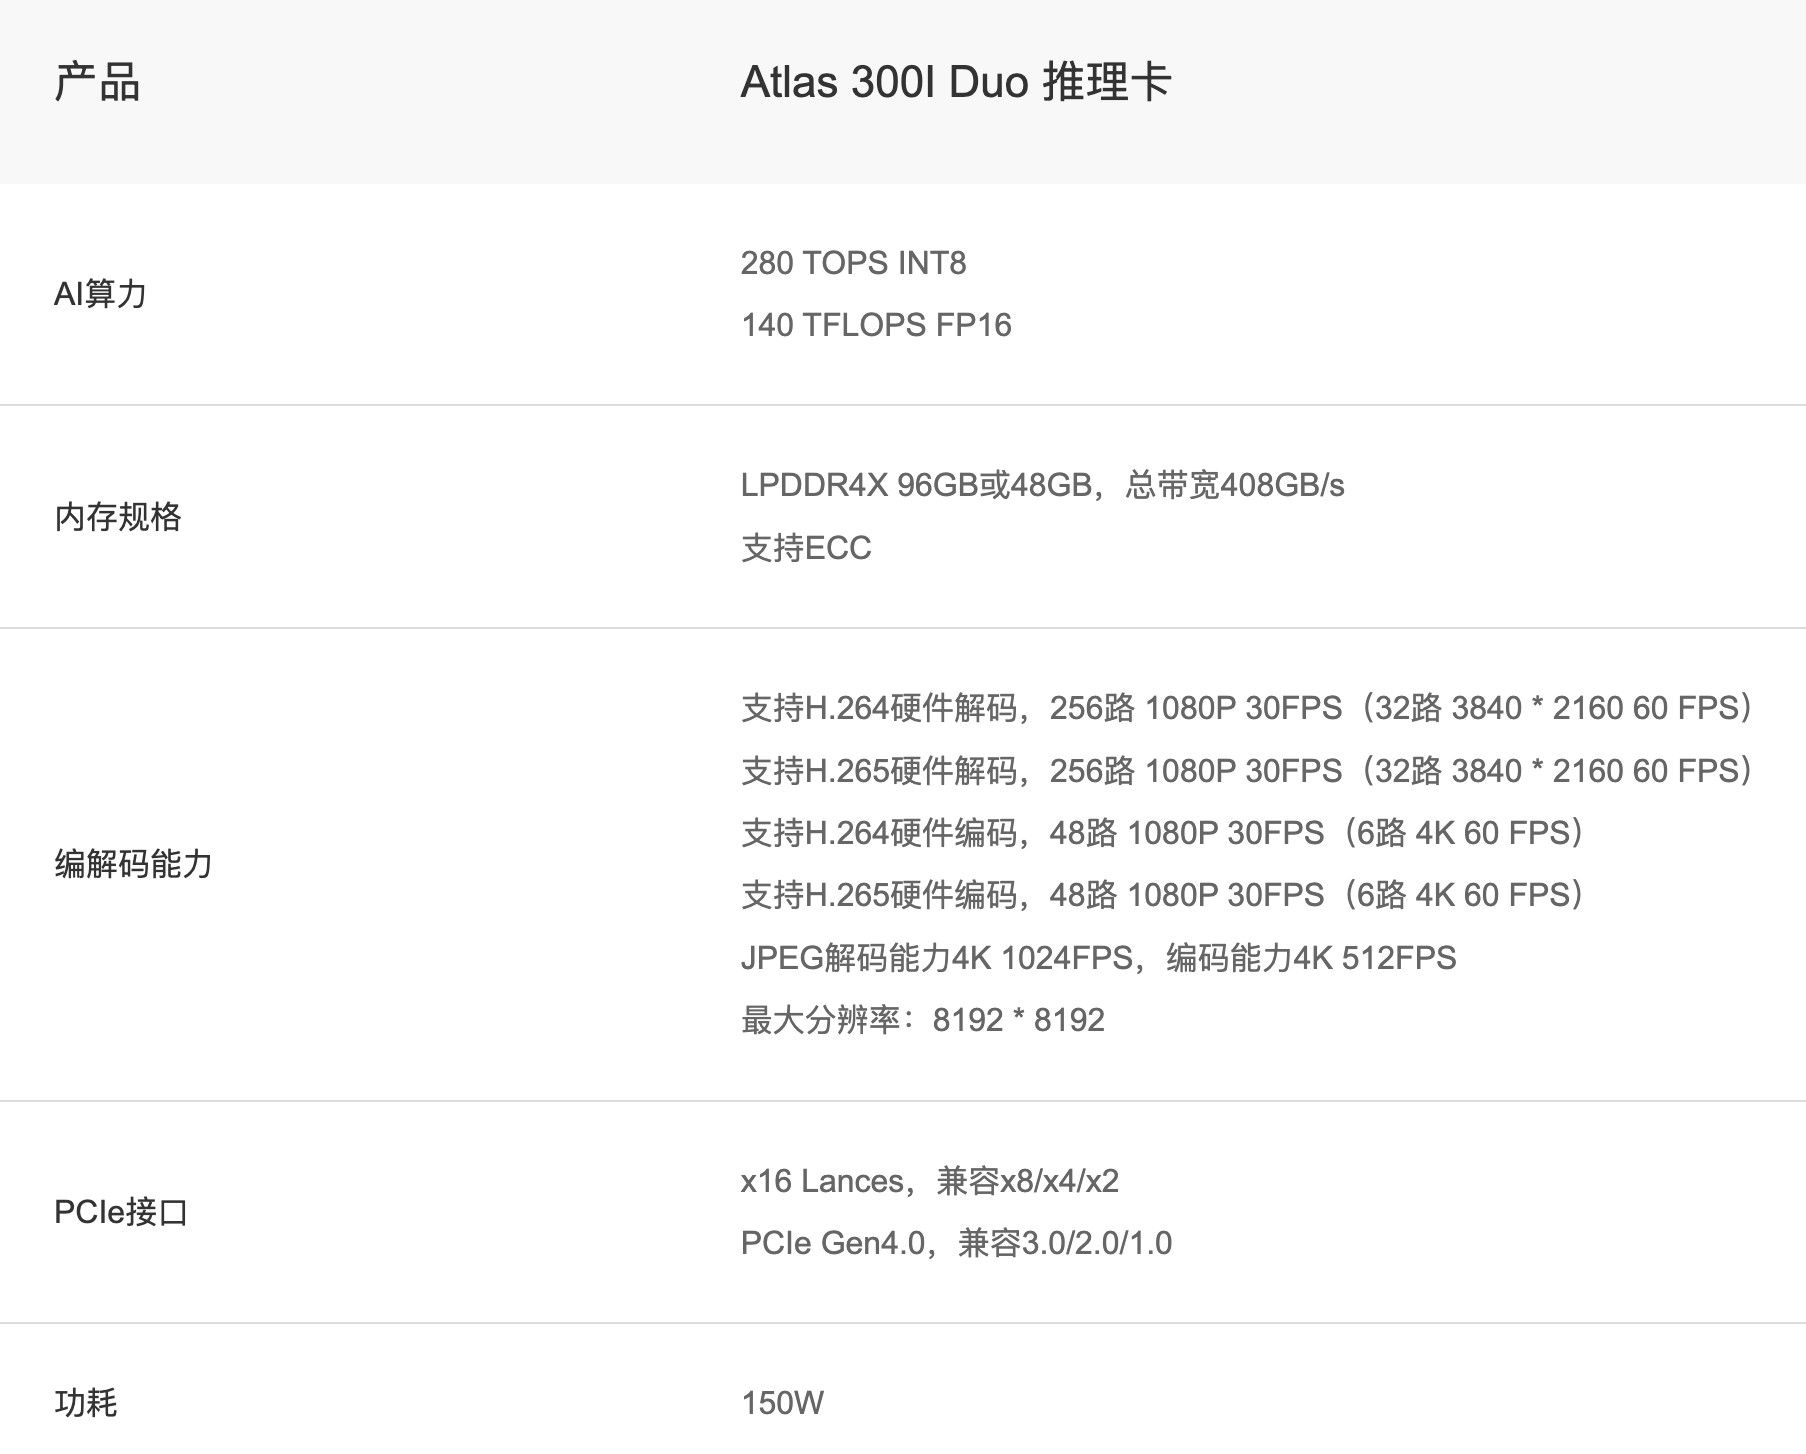
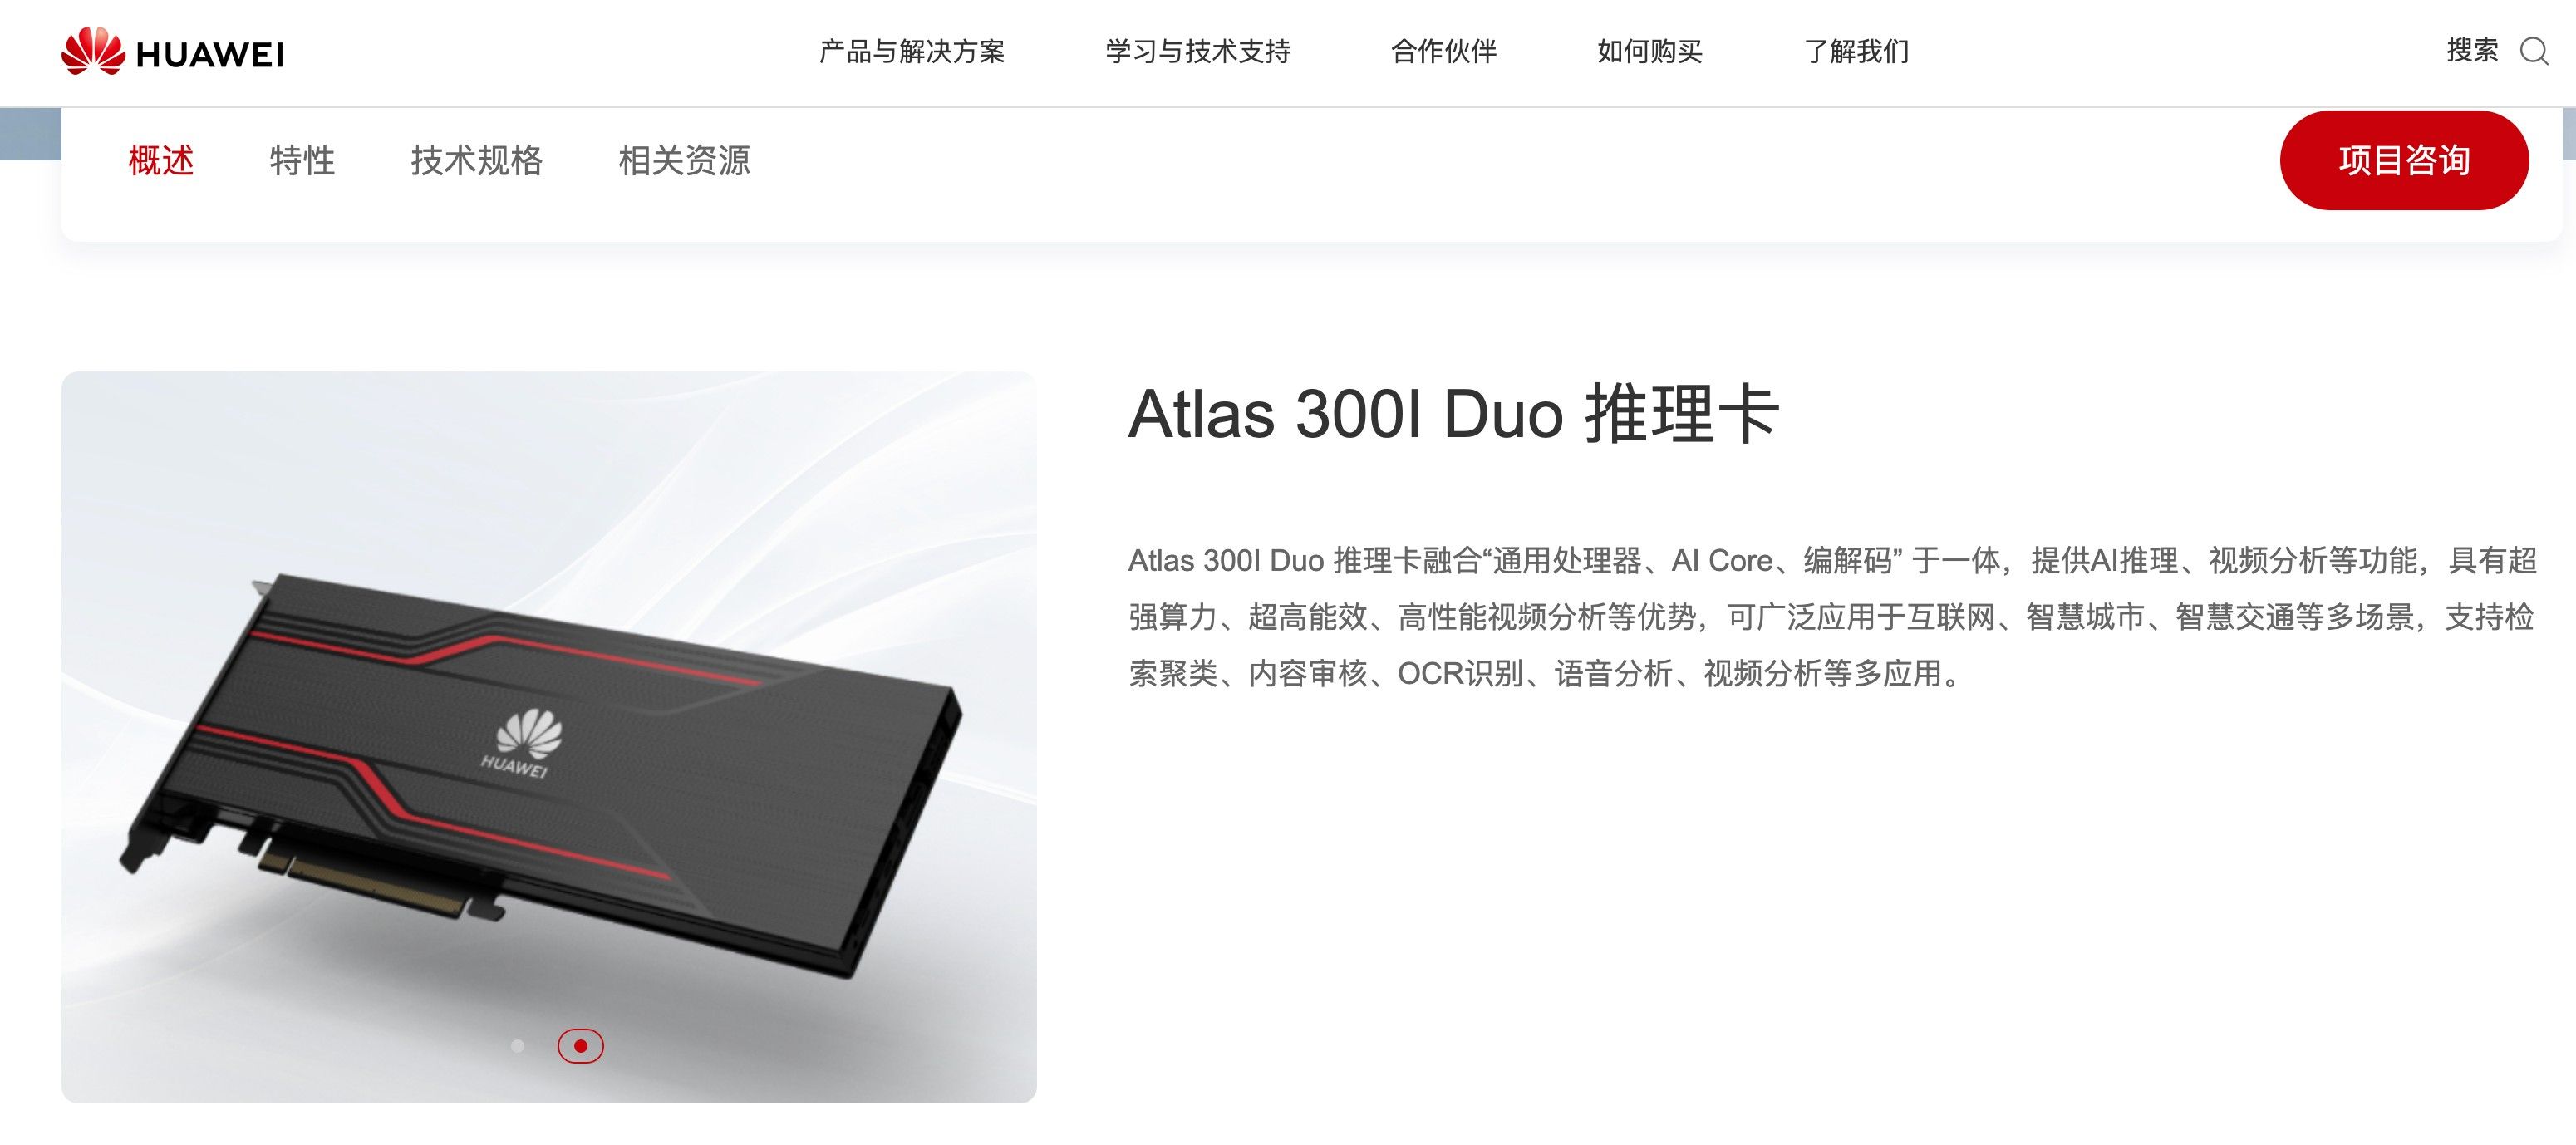
                我今天才在研究這張卡 Atlas 300I Duo 推理卡 不知道群裡是否有人使用過?

                LPDDR4X 96GB或48GB,总带宽408GB/s

                7c339a5c-81d6-41e8-8924-446cc7540b06-image.jpeg
                85456b9f-6bb6-4736-ab32-ba04704a7e71-image.jpeg

                bingqin wangB 5 2 条回复 最后回复
                0
                • kos orK kos or

                  我今天才在研究這張卡 Atlas 300I Duo 推理卡 不知道群裡是否有人使用過?

                  LPDDR4X 96GB或48GB,总带宽408GB/s

                  7c339a5c-81d6-41e8-8924-446cc7540b06-image.jpeg
                  85456b9f-6bb6-4736-ab32-ba04704a7e71-image.jpeg

                  bingqin wangB
                  bingqin wangB
                  bingqin wang
                  体面乡绅
                  发表于 最后由 编辑
                  #9

                  @kos-or 这卡目前来看 除了显存大 貌似就都是骂 没看到社区有夸优点的

                  1 条回复 最后回复
                  1
                  • bingqin wangB bingqin wang

                    @566656661 果然是专家 确实是非浮点运算 但是比您说的这种更极端 我从数学底层把所有乘除和微分计算都换成了有限加法表达的公式 也就是全面离散数学化 非线性计算用了一部分查表 我的目标是NPU 利用CANN算子做优化 这样有俩个好处1.可以最大避免带宽影响大力出奇迹 2.所有结果计算可审计 相同的seed得到的答案完全一致 比较适合高确定性场景

                    5
                    5
                    566656661
                    王侯将相
                    发表于 最后由 编辑
                    #10

                    @bingqin-wang

                    因爲我沒有做過内核維護跟開發, 所以沒辦法作太多評論

                    不過我以前有見過有人討論過純整數運算的LLM引擎期刊, 名字好像叫I-LLM

                    Integer-Only Inference, 如果沒記錯的話用的是INT4以及Bit Packing的INT6

                    1 条回复 最后回复
                    0
                    • kos orK kos or

                      我今天才在研究這張卡 Atlas 300I Duo 推理卡 不知道群裡是否有人使用過?

                      LPDDR4X 96GB或48GB,总带宽408GB/s

                      7c339a5c-81d6-41e8-8924-446cc7540b06-image.jpeg
                      85456b9f-6bb6-4736-ab32-ba04704a7e71-image.jpeg

                      5
                      5
                      566656661
                      王侯将相
                      发表于 最后由 编辑
                      #11

                      @kos-or

                      CANN架構要追上CUDA估計還要起碼五年以上的開發跟成熟吧...

                      不過CUDA可不會停下來等CANN

                      bingqin wangB 1 条回复 最后回复
                      1
                      • 5 566656661

                        @kos-or

                        CANN架構要追上CUDA估計還要起碼五年以上的開發跟成熟吧...

                        不過CUDA可不會停下來等CANN

                        bingqin wangB
                        bingqin wangB
                        bingqin wang
                        体面乡绅
                        发表于 最后由 编辑
                        #12

                        @566656661 CANN社区他们内部开发人员都吐槽 别提了 但是没钱买显卡 这是硬伤

                        1 条回复 最后回复
                        1
                        • bingqin wangB
                          bingqin wangB
                          bingqin wang
                          体面乡绅
                          发表于 最后由 编辑
                          #13

                          不求能追上CUDA 只要大概能跑 没有过于忍不了的延迟就行 特别是国内单位 现在都必须全国产 所以这问题早晚得解决

                          1 条回复 最后回复
                          1
                          • terryT terry 于 将此主题从 Mark专区 移至此处
                          • stxpnetS
                            stxpnetS
                            stxpnet
                            王侯将相
                            发表于 最后由 编辑
                            #14

                            那个卡应该是8卡叠加才效果好,也是再国产的无奈。业余玩家玩的话,单卡感觉有点像dgx spark或者amd 395。看被显存大,实则跑得慢,除非你能忍受晚上让它自己跑, 用时长换质量

                            双卡3090 PCIE 4.0 16X/16X

                            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                            1 条回复 最后回复
                            1

                            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                            有了你的建议,这篇帖子会更精彩哦 💗

                            注册 登录
                            回复
                            • 在新帖中回复
                            登录后回复
                            • 从旧到新
                            • 从新到旧
                            • 最多赞同


                            • 登录

                            • 登录或注册以进行搜索。
                            • 第一个帖子
                              最后一个帖子
                            0
                            • 版块
                            • 最新
                            • 标签
                            • 热门
                            • 用户
                            • 群组