显存到底留多少空间最合适? 有点迷了。
-
我的显卡是24G的3090,以下是启动参数(这个分支的填充速度一直比较好,用-b 8192可以达到1200-4000t /s )
  killall llama3-server 2>/dev/null; sleep 3
     killall llama-server 2>/dev/null; sleep 3
     export LD_LIBRARY_PATH=/d1/llama/buun-llama722/build/bin:$LD_LIBRARY_PATH
CUDA_VISIBLE_DEVICES=0 /s1/llama.cpp/buun-llama722/build/bin/llama-server \
   -m    /n1/Qwen3.6-35B-A3B-UD-IQ4_NL_XL.gguf \
   --mmproj /n1/mmproj-F16-35b-a3b-unsloth.gguf \
  --props --ctx-checkpoints 40 \
  -fa on --metrics --fit off -c 155072 -n 10240 \
  -ctk turbo8 -ctv turbo8 --kv-unified -t 6 -tb 6 \
  --jinja --no-mmap --mlock -np 1   -b 8192 -ub 2048  --image-min-tokens 1024  \
  --chat-template-file /s1/qwen3.6-27b-gguf/apex-qwen-chat-template.jinja \
  --host 0.0.0.0 --port 8025 \
  --reasoning off   \
    --chat-template-kwargs '{"preserve_thinking":true}' \
  --reasoning-format deepseek --reasoning-budget 300 \
  --temp 0.63 --top-p 0.925 --top-k 20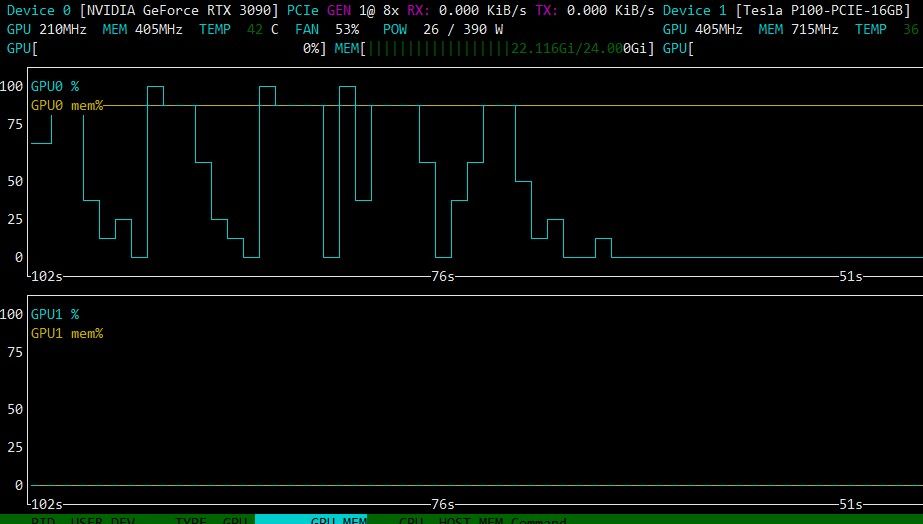
剩余约2G,上下文已经跑了差不多100K,速度140t/s左右,但是有时候接近100K的时候,生成速度又只有90t/s,甚至50多t/s.
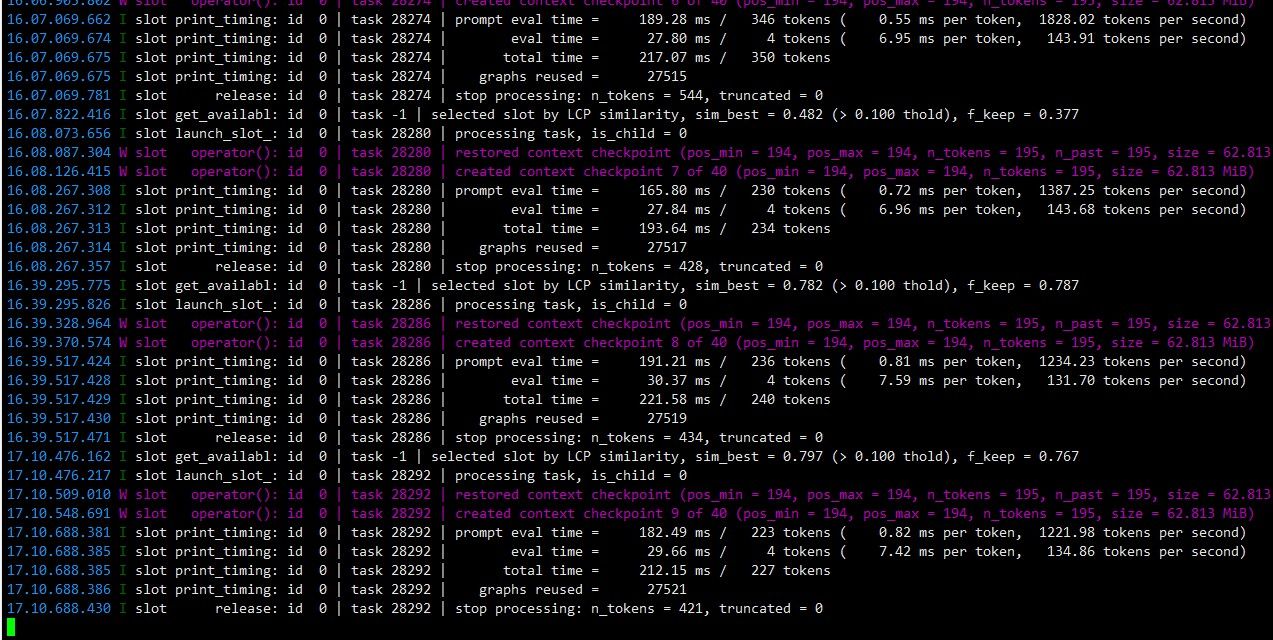 目前这样看留1.8G空闲应该是比较合适的。虽然它一直没有被占用,但是如果留少了,上下文长一点,整体速度都会降低。
-
 T terry 于 将此主题固定
-
rtxpro 4500 32gb
我现在chrome常驻4gb vram, 然后运行comfyui minimax , 我知道他可能会吃多一点vram,每一次饱饱都32gb vram,
但是我看处理输出速度还是保持在 6s/it, 就没有什么管chrome...换做在以前16gb, 我时不时要restart chrome, 然后再关闭py, 做一大堆有得没得。。。
-
这个问题可以算清楚,不用靠感觉。关键在于搞清楚 llama.cpp 的显存是怎么分配的:
1. 你的 -c 155072 已经把"余量"吃掉了
llama.cpp 启动时按 -c 的完整值预分配 KV cache,不是按实际用量动态扩。所以显存占用 ≈ 模型权重 + KV(-c 全量) + 计算缓冲,你感觉"剩多少"其实在启动那一刻就定死了。2. 该留多少
- 只跑 llama-server:权重+KV 之外留 1-2G 给驱动/系统就够(你已经 --no-mmap + --mlock,不会 swap 抖动,这条是对的)。
- 同时开 Chrome + ComfyUI 的话(imbiplaza 的例子):Chrome 常驻 1-4G,ComfyUI 加载模型瞬间还要再吃几 G,这时按峰值留 10-15%。
- 判断标准不是"剩多少",而是 nvidia-smi 看峰值:只要不触发 CUDA OOM,把 -c 往上加、吃到 90-95% 就是最优,剩下 5-10% 是给驱动和突发留的。
3. 你配置里能省显存的旋钮
- -ctk turbo8 -ctv turbo8 已经是 Q8 KV,比 FP16 省一半,很对。
- 想塞更大上下文:-ctk q4_0 再省一半(多数任务质量损失可接受),或者减 -c。
- 挂了 mmproj 的话,图片 token 也占 KV(--image-min-tokens 1024),算上下文要把图算进去。
一句话:llama.cpp 里没有"留余量"这个操作,-c 就是余量的反面;把 -c 调到显存 90-95% 为止,剩下的交给驱动。纸上得来终觉浅没错,但显存账本可以先算后验。
-
系统 于 取消固定此主题