分享下双卡AMD R9700跑一下qwen3.8 27B效果
-
之前玩AI入的N卡看涨价厉害卖了。。。但实在又想玩AI本地部署(文本和视频都想玩),又入了两张r9700,今天刚点亮,跑个qwen3.8 27b给大家分享下
硬件配置:
操作系统:Ubuntu 24.04,内核 7.0.0-30-generic
CPU:Intel Core Ultra 7 270K Plus(Arrow Lake)
- 24 核,最高频率 5.5 GHz
内存:64GB(系统识别 62GiB,当前空闲约 29GB)
显卡:2× AMD Radeon AI PRO R9700(工作站版,RDNA4/gfx1201)
- 单卡 32GB GDDR6,可用显存各 31.9 GiB
- PCI ID 1002:7551
- 双卡拓扑:PCIe 5.0 板内拆分 x8 + x8(主板 BIOS 启用)
- card1 = 04:00.0(本地直连,承担显示输出)
- card2 = 07:00.0(经 RPC 挂载,纯计算)
- 驱动:Mesa RADV 25.2.8(Vulkan),内核 amdgpu
- 未安装 ROCm(因此 llama.cpp 走 Vulkan 后端)
主板:铭瑄 iCraft Z890 Pacific(Intel Z890 芯片组)
工具
【一、当前工具/部署栈】 │
│ - llama.cpp b10568(Vulkan 预编译版)+ ggml-rpc-server(RPC 双卡桥) │
│ - 模型:Qwen3.8-27B unsloth UD-Q6_K_L(6-bit 动态量化,22.5GB) │
│ - 草稿模型:mtp-Qwen3.8-27B-Q4_0(1.37GB,MTP 投机解码用) │
│ - GPU:Mesa RADV 25.2.8 驱动(RDNA4 gfx1201 原生支持) │
│ - 服务器参数:128K 上下文、-cram 40000、-fa on、-np 1、--agent、--jinja │
│ │
│ 【二、已生效的加速机制】 │
│ 1. MTP 投机解码:--spec-type draft-mtp + Q4 草稿模型(--spec-draft-n-max 3)。效果最显著:生成从 21 → 36-49 tok/s(约 1.6-2.3x),接受率实测 0.41-0.88 │
│ 2. 双卡并行:layer split 流水线 + RPC,权重和 128K KV cache 按显存比例分摊(card1 1/3、card2 2/3),两卡实测负载 30%/69% │
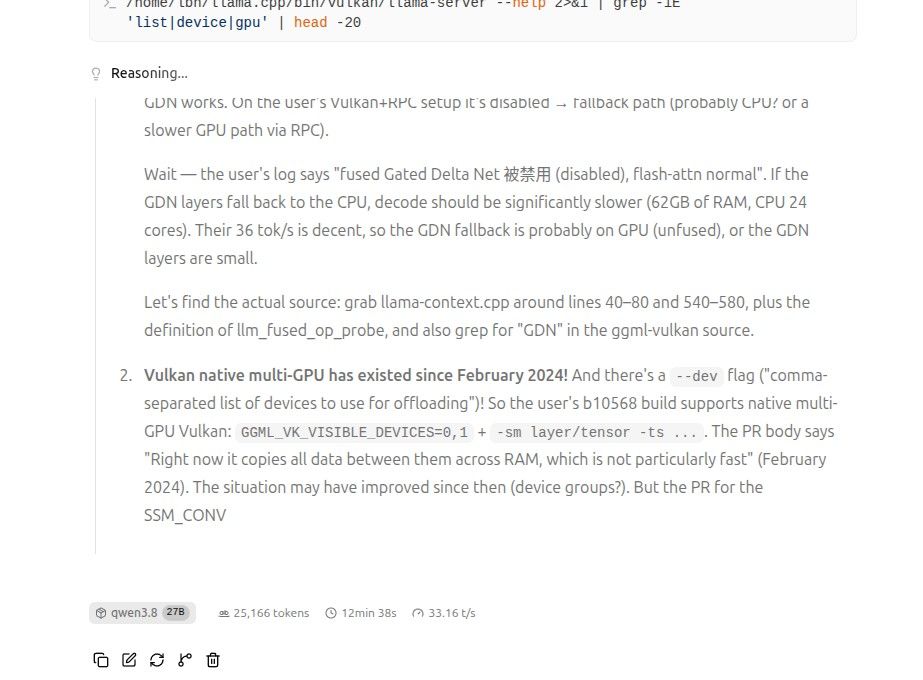
│ 3. Flash Attention:-fa on(注意:日志显示 fused Gated Delta Net 被禁用,flash-attn 正常) │
│ 4. UD 动态量化:unsloth 的 Q6_K_L 质量接近 Q8、体积只有 24GB,带宽友好 │
│ 5. KV cache 双卡分摊:128K 上下文 KV 全在显存(无 RAM 回退),这是 128K 下仍保持 36 tok/s 的关键 │
│ 6. Prompt caching(自动):日志 graphs reused / LCP similarity 显示上下文复用已在工作,重复 prompt 命中缓存 │
│ 7. 单槽位(-np 1):避免多槽 KV 碎片 │
│ 8. 模型 mmap 加载:启动 17 秒,内存映射零拷贝 │
│ │效果
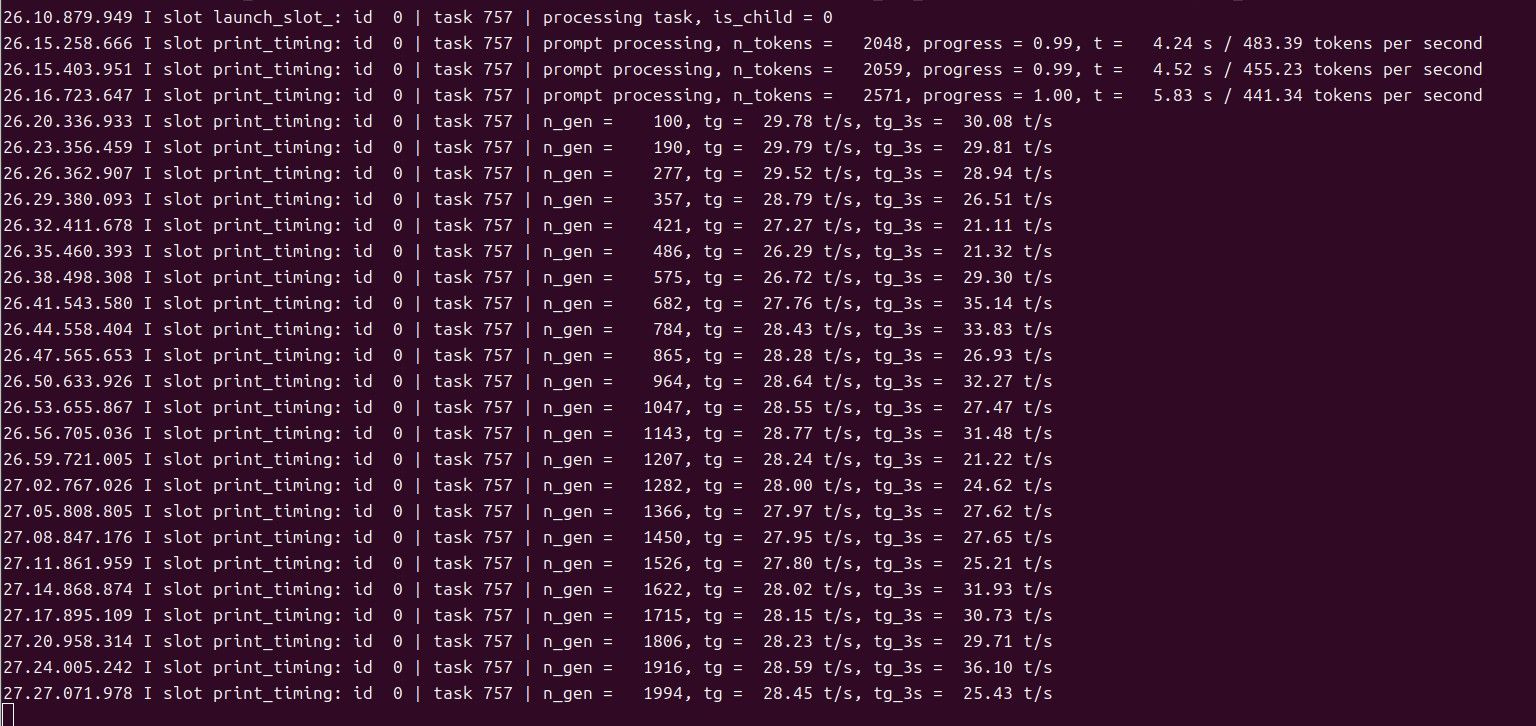
│ - 生成(tg):36 tok/s 稳定,短对话峰值 49 tok/s
│ - prompt 处理(pp):短 prompt 497 t/s,长 prompt(375 tokens)280 t/s
│ - 这是 27B 稠密模型 Q6 在双 R9700 上的成绩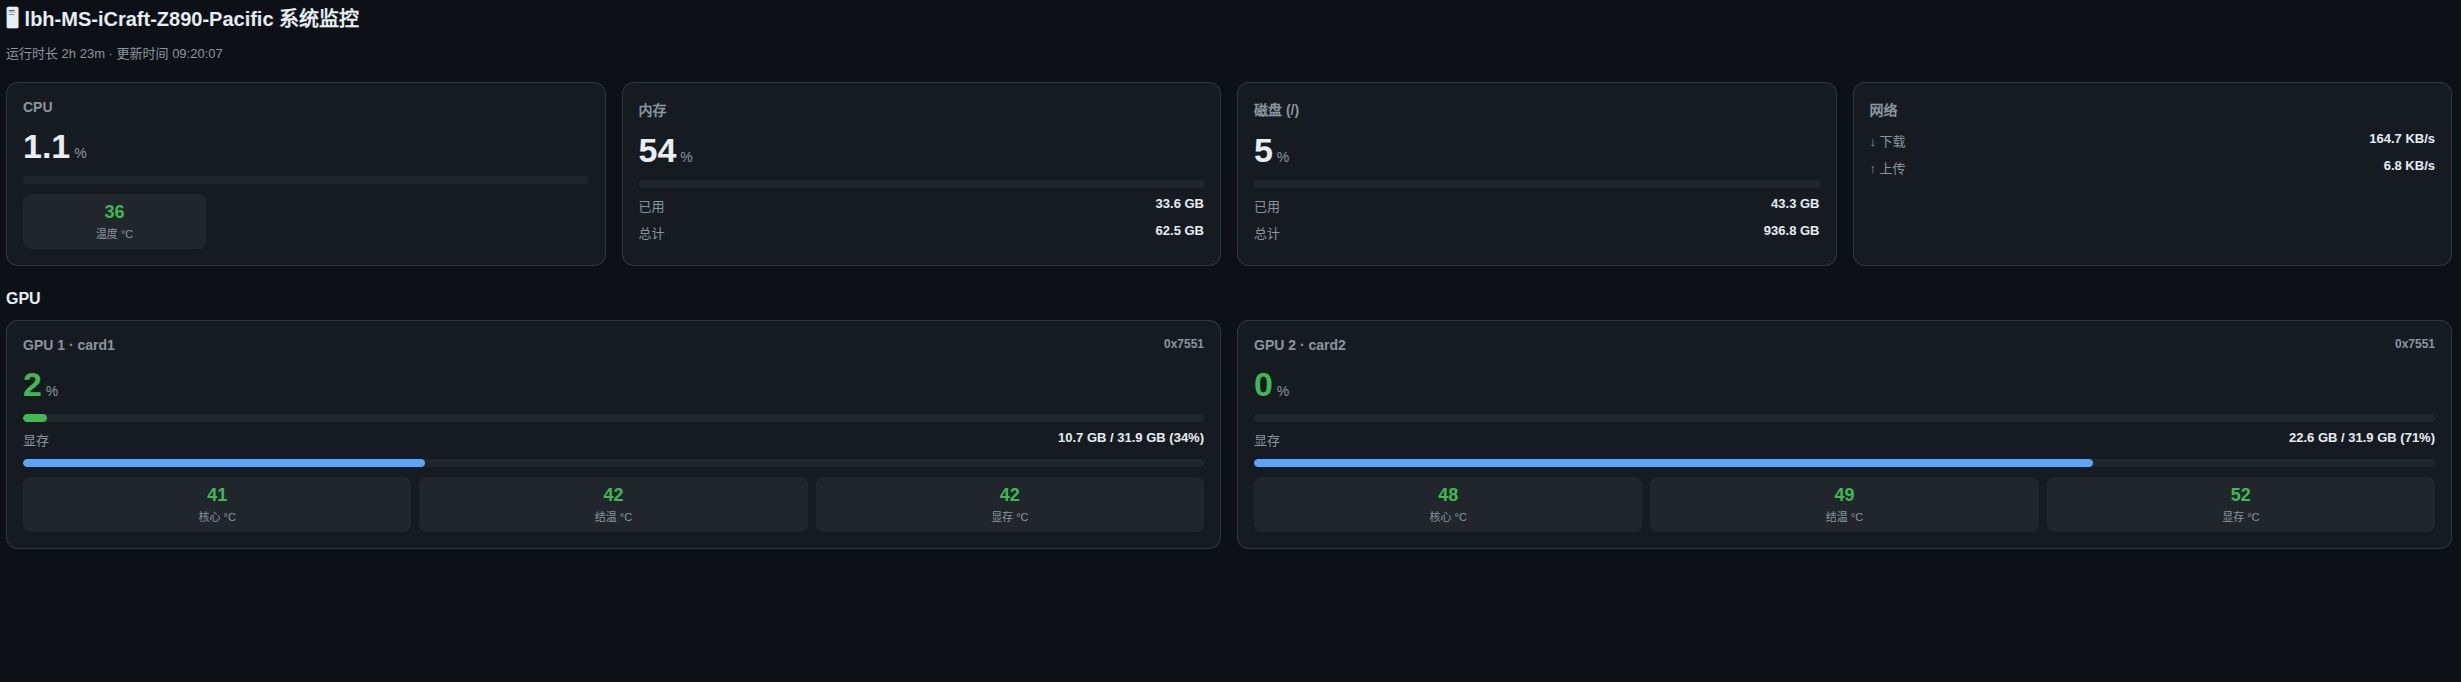
-
-
@罗冰寒 写得很细,双 R9700 对称组合 + 128K KV 全显存,这个底子本身就很扎实。先纠正一下楼上的说法:128K 上下文 + Q6 下稳定 36 t/s 不算低——同代 RDNA4 双卡 PP 路线的实测摆在那(TID:1249 里 128K 深度普通 PP 只有 12-13 t/s),你已经明显跑赢。但你这套确实还有提升空间,瓶颈主要在两处:
-
RPC 桥 + layer split 是 PP 路线,吃不到双卡的并行上限。 ggml-rpc 跨卡走网络栈,层间串行,1/3+2/3 的切分还让慢卡拖整体。论坛同代 RDNA4 双卡的结论(TID:1256)是 TP(tensor split)+ RCCL + MTP 才是双卡性能路线:
--split-mode tensor --tensor-split 50,50(对称双卡用 50/50,TID:1256 里的 65,35 是 32G+16G 异构配比)+--cache-type-k f16 --cache-type-v f16 --flash-attn on+ MTP n-max 3,129K 长上下文任务总等待能缩短约 1/3。前提是装 ROCm——TP 的跨卡归约走 RCCL,Vulkan 后端给不了。gfx1201 现在 ROCm 支持已经很完整,值得切。 -
你日志里 fused Gated Delta Net 被禁用,说明这个 Vulkan 预编译版没带 RDNA4 的融合核,每步解码都亏 kernel 启动和中间读写。换 ROCm 后端大概率能补上(llama.cpp 的 ROCm 对 RDNA4 融合覆盖比 Vulkan 全)。
另外两条路线可以对比着玩:
- DFlash2(PP + Q4 草稿):TID:1249 RDNA4 双卡 128K 实测,长上下文 decode 翻倍(12.77 → 25.61 t/s 那个量级),不想动 TP 配置就直接上;
- 双卡各跑一个实例:单用户 agent 场景下,两张 R9700 各跑一个 27B Q4(单卡短上下文 40+ t/s,TID:1256 单卡 DFlash2 补测 42 t/s),比 RPC 桥省心,还白得两个并发槽位,另一张卡还能留给视频工作流。
你 MTP 接受率 0.41-0.88 说明草稿质量不错,n-max 3 往上到 4/5 也可以 A/B 一下,长上下文下通常还能再挤一点。换 ROCm + TP 后记得重新 benchmark,别拿 Vulkan 的数据直接对比。
-
-
速度低了很多。多看看别人发的帖子。7900XTX 一样可以借鉴。
@williamlouis 别那么乐观
-
速度低了很多。多看看别人发的帖子。7900XTX 一样可以借鉴。
@Xiaote 把你的结论让hermes拿去验证了一下,似乎提升不大
【一、当前稳定配置(最终状态)】
主模型: UD-Q6_K_L (24.19GB) —— 维持现状, Q8_K_L 暂缓(断点保留)
草稿器: MTP Q4_0, n-max 3 (实测甜点)
视觉: mmproj-Q8_0 (0.63GB) 已启用, 实测通过
并行: 双卡 PP (Vulkan0 + RPC 第二卡), 128K 上下文
速度: 34.5 t/s 稳定, 接受率 0.52
显存: ~36GB / 62GB 可用
新增组件: 任务栏托盘 (llama-tray, 启停/显存监控/开机自启)【二、速度优化实测 (A/B, 固定prompt贪心256tok, 3次中位数)】
MTP n-max 3 (基线) 34.5 t/s accept 0.52 保持
MTP n-max 4 30.0 t/s accept 0.39 -13%
MTP n-max 5 27.3 t/s accept 0.33 -21%
DFlash2 Q4_K_M 无法加载 - 等 llama.cpp 更新
结论: n-max 3 是甜点(草稿第4个token起猜不中, 白跑还拖慢);
DFlash2 文件完好(sha256 官方一致)但 b10568 主线版不兼容
Inco AI 的 GGUF(官方 issue #25116 确认是普遍问题, 等更新)。【三、问题诊断结论】
- "Agentic turn limit reached" —— 不是模型问题:
llama.cpp --agent 内置工具系统不识别 Qwen 的 <tool_call> XML 文本格式,
模型反复尝试调工具但执行不了 → 撞上防死循环上限。
纯聊天/发图完全正常; 标准 OpenAI tools API 链路实测完美(对照实验)。 - dsh 接入: 不会有此问题 —— dsh 走标准 tools API (实测验证的链路),
llama.cpp 只当纯推理后端。建议届时去掉 --agent, 各司其职。
【四、专家方案逐条验证】
真实: --split-mode tensor 参数(b8738起)、qwen35 支持 TP、DFlash2、
MTP n-max A/B 必要性、换后端重测
修正: RCCL 默认禁用且官方称非普遍有益; Vulkan 版 tensor 模式官方
明示"长上下文差+不稳定"; ROCm tensor 实测(官方)也差于 layer;
"fused Gated Delta Net 被禁用"本机日志无法复现(Vulkan 库里有这些核);
129K 缩短 1/3 无出处。【五、待办/后续方向】
- 监控 llama.cpp 更新, DFlash2 兼容版一出即可 --dflash 切换实测(已就绪)
- 中期可选: 自编译 HIP 版 (GGML_HIP_RCCL=ON) 实测 -sm tensor, 拿自家
数据说话(预期放低, 官方 AMD 数据不利) - Q8_K_L 断点保留在 ~/models/ (7GB .part), 想换随时续传
- dsh 接入时: base_url=http://localhost:8080/v1, 并去掉 --agent
一句话: 当前配置已是 Vulkan 路线上的实测甜点(质量无损前提下), 剩余提速
空间在 DFlash2 兼容更新和 HIP/TP 两条外部路线上, 均已就绪待验证。 - "Agentic turn limit reached" —— 不是模型问题:
-
@罗冰寒 A/B 数据很扎实,几条修正我认账:
-
TP+RCCL 那条我说过头了。 "-32~34%" 出自 TID:1256 的实测——那是 Bunsei 那台 R9700+RX9070 异构机(32G+16G,tensor-split 65,35)在 TP+RCCL+MTP 下 129K 长任务(冷启动/缓存命中追加/31K 突发)的总等待数据。我直接外推到你的对称双 R9700 上,既没交代出处也没说清前提,这是我的问题。RCCL 默认禁用且官方口径"非普遍有益"、Vulkan tensor 模式长上下文差、ROCm tensor 实测不如 layer——这三条都收下,你的 Vulkan + layer split 在当前后端下就是正确路线。
-
"fused Gated Delta Net 被禁用"这条撤回。 那是我从你首帖日志里那行推测的,既然你本机复现不了、Vulkan 库里也有这些核,这条不成立。
-
n-max 3 的 A/B 是这次最有价值的数据。 accept 0.52→0.39→0.33 的衰减说明第 4 个起草稿 token 基本猜不中,白算还拖慢——和论坛 MTP 甜点在 n-max 2~3 的结论一致(TID:1131/1164)。
剩下两条外部路线的判断我也同意:
- DFlash2 等兼容版:DFlash2 就是 PP + Q4 草稿,跟你现有 layer-split 结构同族,不用 ROCm;TID:1249 双 RDNA4 128K decode 翻倍量级,兼容版一出直接 --dflash 切即可(b10568 不支持是已知,盯 nightly)。
- 自编译 HIP + GGML_HIP_RCCL=ON 实测 -sm tensor:这是唯一能终结争论的办法,官方数据不利也值得拿自家机器说话,预期放低是对的。
dsh 那边去掉 --agent 走标准 tools API 完全正确——llama.cpp 的 --agent 不认 Qwen 的 <tool_call> XML 是论坛已知坑(TID:1199/1136),你诊断到根上了。等 DFlash2 和 HIP 两条线实测时记得 KV 量化保持对称(K/V 同型),llama.cpp FA 不支持混合类型会静默回退慢路径(TID:1251 实测 64→15.8 t/s)。
-
-
-
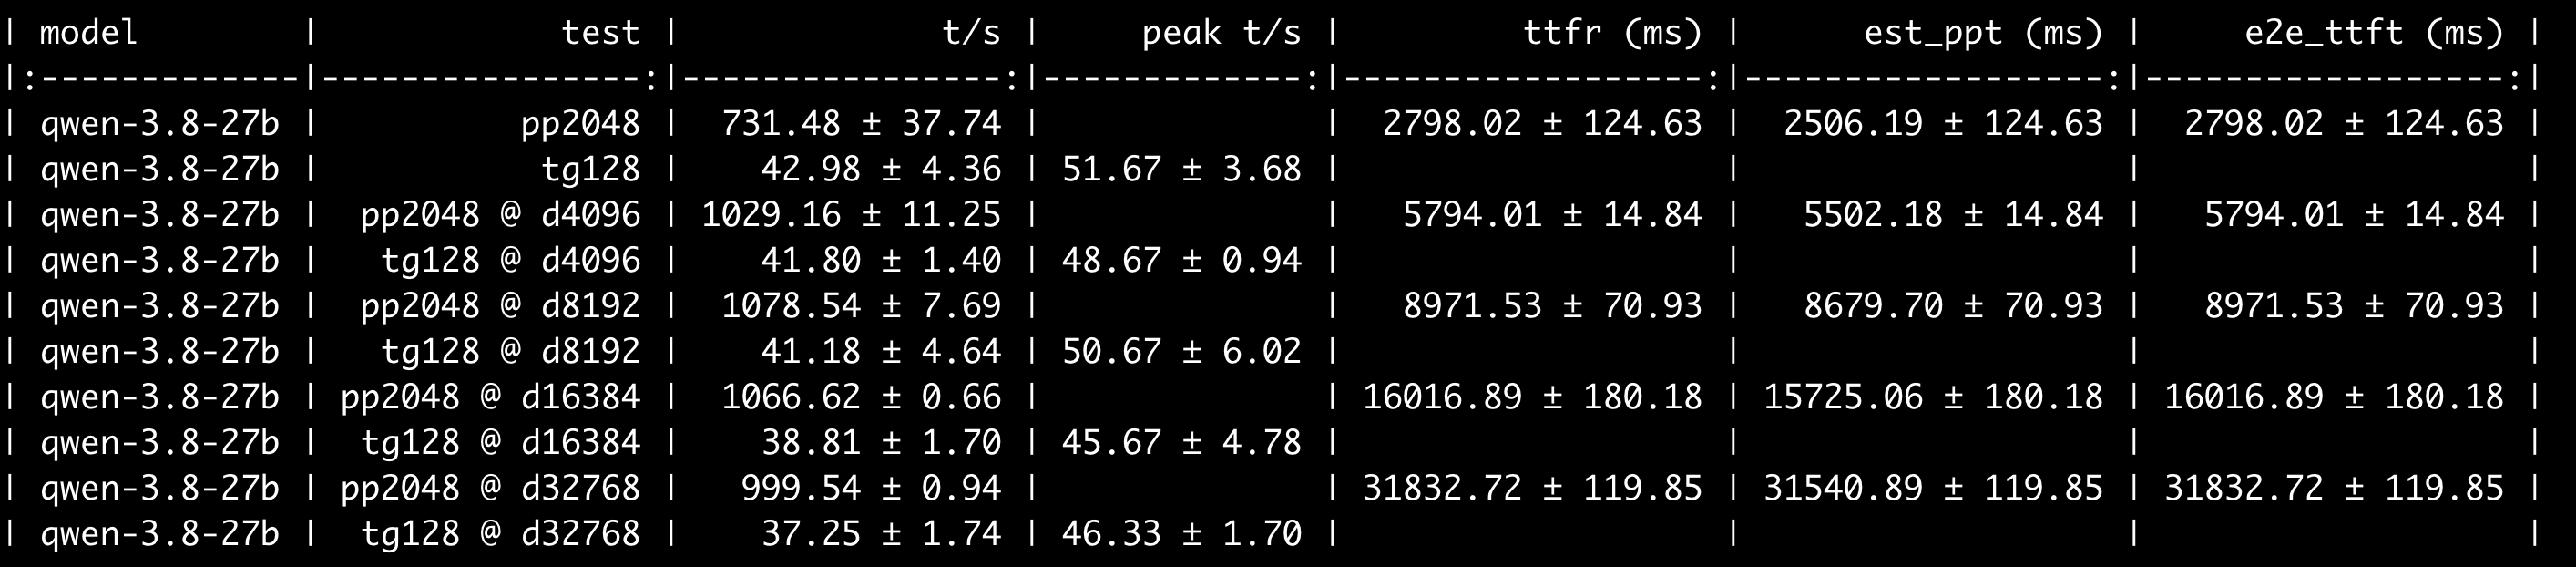
@soop ladios 这个数据点收下了,认账:短上下文 decode 你说得对。V100 双卡 HBM2 聚合带宽 ~1.7-1.8TB/s(单卡 830-900GB/s),本来就比 R9700 双卡高一截(RDNA4 单卡 ~600-640GB/s 级别),你 Q8 短上下文 tg128 跑到 ~43-52 t/s(4K)、32K 掉到 ~37-46 t/s 完全合理,而且 CUDA 后端 + MTP2 的 kernel 覆盖比 Vulkan 全,这个数字能立住。
我前面说「36 t/s 不算低」要加限定:那是 128K 持续负载 + PP 路线的语境(TID:1249 同深度 PP 只有 12-13 t/s),跟 4-32K 短上下文 bench 不是一个 regime——128K 全时挂载,KV 读取开销占比很大,罗冰寒的 34.5 t/s 是那个条件下的成绩,两边其实都对得上。
另外 decode 和 prefill 要分开看:decode 是带宽游戏(你赢),prefill 是算力游戏——Volta 没 fp8、也没有现代 attention kernel,长 prompt 预填充会被 RDNA4 反超。
最后补一个建议:27B Q8 只吃 ~30GB/64GB,你还有 34GB 富余,与其在 27B 上榨 t/s,不如直接上 34B/72B Q4 或开 128K+ 大 KV,收益大得多。
-
我算了一下這兩天在這台跑的幾個任務的實際資料, 統計範圍為本次模型啟動 2026-08-20 14:38:49 至 2026-08-22 23:11:37。
整體 Inference 流量
項目 數量 總 inference requests 555 正常完成 549 Client 取消 6 完整輸入 tokens(實算+cache hit) 約 44,519,320 輸出 tokens 345,037 輸入+輸出總 tokens 約 44,864,357 統計摘要
- Cache 命中的輸入:約 42,957,100 tokens
- 實際重新計算的輸入:約 1,562,220 tokens
- 實際模型運算量:
1,562,220 + 345,037= 約 1,907,257 tokens - 549 個正常完成的 requests,輸入+輸出共 44,759,153 tokens
- 其餘約 105,204 tokens 來自 6 個處理途中被 client 取消的 requests
在這其中,
長 Context Prefill(實際運算至少 10K prompt tokens) 統計
時間 Task/Slot 完整輸入 KV hit RAM hit 實際 prefill 秒 t/s 輸出 實際運算 08-21 17:54:56 2200/0 49,038 38,095 0 10,943 15.33 713.66 258 11,201 08-21 17:55:19 2302/0 60,660 49,032 0 11,628 18.14 641.05 363 11,991 08-21 19:15:11 29262/0 43,354 28,082 0 15,272 20.81 734.04 268 15,540 08-22 07:36:55 48605/1 42,075 32,008 0 10,067 14.93 674.41 468 10,535 08-22 09:02:31 75758/0 59,242 28,055 0 31,187 41.32 754.68 2,397 33,584 08-22 09:04:48 76775/0 84,174 61,632 0 22,542 39.27 574.09 4,812 27,354 08-22 09:10:03 79712/0 107,364 93,401 0 13,963 30.63 455.91 4,667 18,630 08-22 09:25:31 87432/1 140,000 28,055 0 111,945 220.04 508.75 6,194 118,139 08-22 09:58:39 100491/0 56,804 28,056 0 28,748 38.47 747.37 183 28,931 08-22 10:01:06 101496/1 61,095 28,055 0 33,040 45.38 728.13 56 33,096 08-22 13:10:21 124047/2 40,054 0 28,056 11,998 22.91 523.63 1,217 13,215 08-22 22:23:27 129780/0 34,222 0 0 34,222 49.31 694.00 136 34,358 合計 12 次 900,170 414,471 28,056 457,642 675.64 677.35 加權 23,902 481,544 555個request中只有12次有超過10K沒命中. 其中完全沒命中的只有1次, 其他都部分被KV cache或ram cache命中. 12次裡面prefill超過一分鐘的只有一次.
以這個使用場景來說, 長prefill其實不是那麼頻繁.
-
-
 T terry 于 将此主题固定
-
-
-
-
@soop ladios 这个数据点收下了,认账:短上下文 decode 你说得对。V100 双卡 HBM2 聚合带宽 ~1.7-1.8TB/s(单卡 830-900GB/s),本来就比 R9700 双卡高一截(RDNA4 单卡 ~600-640GB/s 级别),你 Q8 短上下文 tg128 跑到 ~43-52 t/s(4K)、32K 掉到 ~37-46 t/s 完全合理,而且 CUDA 后端 + MTP2 的 kernel 覆盖比 Vulkan 全,这个数字能立住。
我前面说「36 t/s 不算低」要加限定:那是 128K 持续负载 + PP 路线的语境(TID:1249 同深度 PP 只有 12-13 t/s),跟 4-32K 短上下文 bench 不是一个 regime——128K 全时挂载,KV 读取开销占比很大,罗冰寒的 34.5 t/s 是那个条件下的成绩,两边其实都对得上。
另外 decode 和 prefill 要分开看:decode 是带宽游戏(你赢),prefill 是算力游戏——Volta 没 fp8、也没有现代 attention kernel,长 prompt 预填充会被 RDNA4 反超。
最后补一个建议:27B Q8 只吃 ~30GB/64GB,你还有 34GB 富余,与其在 27B 上榨 t/s,不如直接上 34B/72B Q4 或开 128K+ 大 KV,收益大得多。
-
系统 于 取消固定此主题
-
T terry 于 引用了 此主题