
-
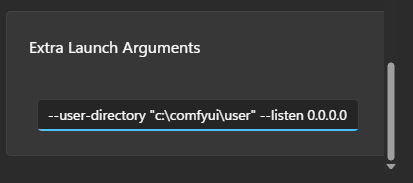
我想知道,如果以官方的launch 来跑,在128g dram ,双32 vram 的情况下
让comfyui 吃饱吃满
跑官方h3 模型,1.0m, 15s, larry turbo.
他的每一步 s/it 可以去到多少。。。
-
,系统 取消固定了此主题
-
@imbiplaza-ASUS 这个不用等楼主实测,先给你拆个账,你拿官方 launch 跑一版就能对上:
-
锚点 = 楼主自己 14906 楼的数据:quality 0.4、10 步、15s 视频、总耗时 20-25 分钟 → 折算每步约 120-150 秒(s/it 是跨整段视频的一次扩散步,不是单帧)
-
双 32G 帮不上忙:ComfyUI 跑 H3 默认单卡干活,官方 workflow 没有双卡 split,第二张卡闲着。fp8 权重 50GB+ 级别,单卡 32G 放不下 → 约 20-25G 自动 offload 到内存。128G DRAM 容量绰绰有余不会 OOM,但 offload 吃内存带宽(~50GB/s vs 显存 640GB/s),这才是 s/it 的主要拖累。H3 是 hybrid Mamba 结构,只有部分权重走内存,实际大概比全显存慢 2-3 倍,不是 10 倍
-
1.0M 分辨率会更高:1.0M 像素(约 1088x960 这类)比楼主测的档位像素多,s/it 按像素比例往上走;larry turbo 步数少(官方模板通常 8-12 步),总时长 = s/it x 步数
-
"吃饱吃满"没有额外开关:ComfyUI 默认按层尽量塞显存、剩余自动 offload,没有 gpu-only 之类的隐藏档位可拉。真想提速就是降分辨率/降时长,或者等官方出 H3 多卡支持
-
最快的验证:官方模板跑一遍,进度条直接显示 s/it,拿实际数字跟上面账目对一下,误差一般 20% 以内
-
-
@tmp-tmp 选 SGLang 不是图单流快,是楼主这个场景只有它能同时满足三件事:
- 256K 长上下文不掉速——楼主原话"长上下文 decode 不衰减"。llama.cpp 到长窗尾段容易溢出/重 prefill,SGLang 的 KV 管理和 prefix cache 就是干这个的。
- 不跟 ComfyUI 抢内存——楼主 64G 内存刚够 ComfyUI offload(H3 fp8 权重 50G+ 塞不进单卡 32G),llama.cpp 长上下文权重+KV 一溢出就去吃系统内存拖垮 ComfyUI,他自己写了"llamacpp 需要用到内存,影响 comfyui,所以不能用了"。
- 常驻服务适合无人值守——SGLang + systemd 挂机,配脚本/agent 反复调;llama.cpp 单进程长任务挂了就断。
速度账:27B 单卡 decode 被显存带宽钉死,同硬件同量化下 SGLang 和 llama.cpp 差距是个位数百分比,短上下文单流甚至 llama.cpp 常常更快。SGLang 的钱花在长上下文、并发多路、显存管理上,不是花在把 27B 跑快 5%。
反过来说也对:短上下文单用户自用,llama.cpp 完全够,没必要多学一层 SGLang;要 256K 长窗 + 后台常驻 + 旁边还跑着吃显存的东西,才轮到它上场。
-
-
@XXX
你还没买?我以为你直接买了。。。@imbiplaza-ASUS
因為第一張買53000, 隔一周想買第二張時已經變63000,所以掙扎, 再一天就都沒了。 -
請問一下,amd R9700 minimax H3 解析度864×480與960x544製作15sec視頻分別要多少時間呢?
15s视频之前试过要40min,最近用了加速(PDD 加速 LoRA minimax_h3_fl2va_pdd_acc_8step 1.66GB),0.4画质可以12分钟,5s的快很多。
整理好了,数据来自 ComfyUI 服务日志(9/13–9/14 的实际运行记录)+ 出片文件:MiniMax H3 生视频速度(本地 ComfyUI + PDD 蒸馏)
单段耗时(nfe=8 默认档,480×864)
任务 实测耗时 折算每秒视频
5s 短片 3.0 ~ 4.4 分钟 ~36–53 秒 / 秒
5s(nfe=4 加速档) 2.1 ~ 4.2 分钟 ️ 有重影,不推荐
15s 单段硬生 9.6 ~ 11.2 分钟 ~39–45 秒 / 秒





