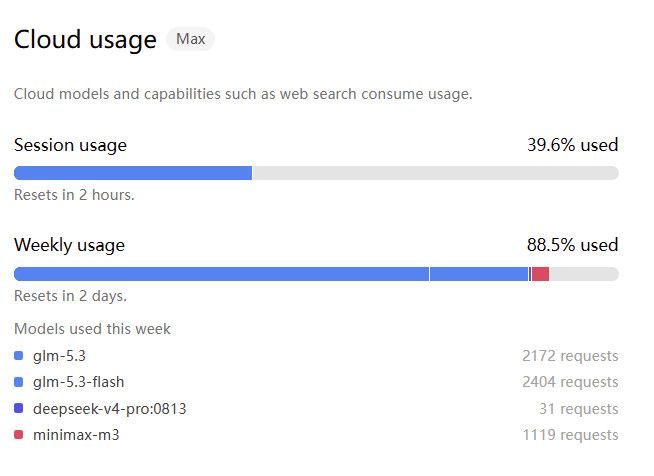
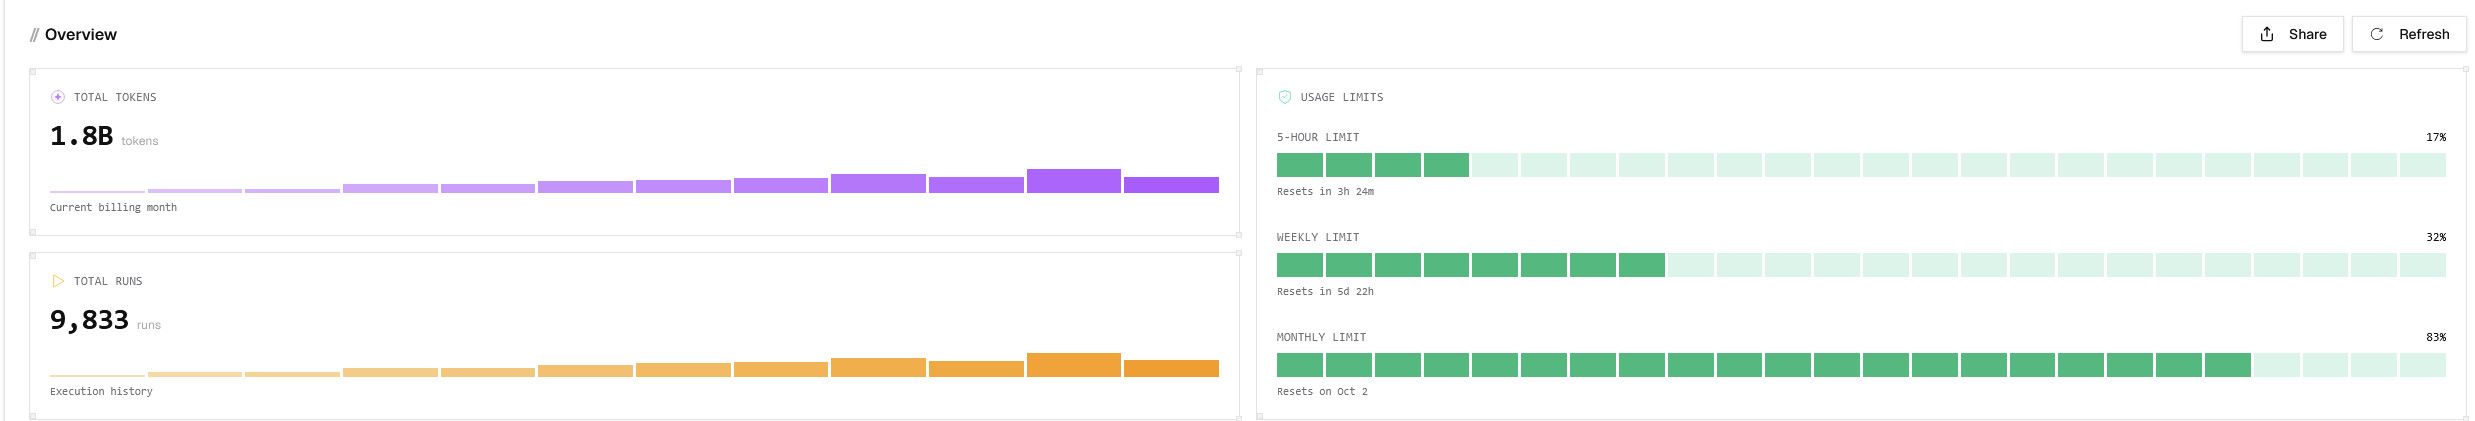
单台DGX 装qwen 3.8 next flash 500K token 长度,能用
-
@kk-hh 目前掛在我ai max395上切VRAM/RAM 64/64gb下用IQ4xs搭配dsh也非常舒服,@41k上下文深度下pp200多/tg 20-30token/s開192k上下文,目前已經利用goal然後入睡前讓它大型專案開發,隔天早上起來收割。是確定可以做出前沿模型那種質量。但速度響應上就不苛求了。目前pp可能還有提升的空間應該會更好。

@kk-hh 目前掛在我ai max395上切VRAM/RAM 64/64gb下用IQ4xs搭配dsh也非常舒服,@41k上下文深度下pp200多/tg 20-30token/s開192k上下文,目前已經利用goal然後入睡前讓它大型專案開發,隔天早上起來收割。是確定可以做出前沿模型那種質量。但速度響應上就不苛求了。目前pp可能還有提升的空間應該會更好。
我这个这个其实在300K TOKEN长度的时候 开MTP-3 其实生成速度也是 20-30token/s,TOKEN 最大长度在单台DGX SPARK可以设置成 1M 但是基于对这些FLASH 模型在云端使用的经验他们前500K还行,后500K 质量太差,所以我在本机就只开了500K的TOKEN长度。
-
说实话一个小机能跑成这样,你还要什么自行车啊。再买一台DGX SPARK 做双TP的QWEN 3.8 FLASH NEXT 或者 DPV4 FLASH 我觉得有点不太值,或者再买三台DGX SPARK 做4TP的 GLM 5.3 FLASH 更不值,我宁可多买点云端服务的额度。
-
@Kk-Hh 单台多少钱买的?
-
重要的不是别人说如何,是你自己感觉如何,你觉得好就行。
在我的工作环境下,实测这个版本的qwen 3.8 next flash 要好于我的qwen3.8 27b q8,就是速度对于dgx spark来说还是提不上来。所以呢着急我就用线上的glm 5.3 flash 和qwen 3.8 flash ,不着急的晚上挂机的,就让这个本地跑。https://commandcode.ai 这个站有个好处中外的模型都有了,特别复杂的就花钱用贵的模型。我这个本地机器就是平时做挂机基础执行环节的。
-
说实话一个小机能跑成这样,你还要什么自行车啊。再买一台DGX SPARK 做双TP的QWEN 3.8 FLASH NEXT 或者 DPV4 FLASH 我觉得有点不太值,或者再买三台DGX SPARK 做4TP的 GLM 5.3 FLASH 更不值,我宁可多买点云端服务的额度。
-
@kk-hh 500K 能不能用,拆成「装得下」和「跑得快」两件事算。
先算 KV:
KV bytes = 2 x layers x kv_heads x head_dim x dtype_bytes x tokens
以 35B 级、GQA 8 个 KV 头、head_dim 128、约 48 层、FP8 KV 估算,每 token 约 96 KB,50 万 token 约 48 GB;再叠加 FP8 权重,Spark 的 128 GB 统一内存要留运行时和草稿模型余量,放得下但不算宽裕。按你模型的层数/头数把这行代进去,别等 OOM 才回头看。速度才是 Spark 的短板:GB10 统一内存约 273 GB/s,decode 被带宽锁死,具体取决于激活参数量(MoE 激活小就好很多),50 万 token 的 prefill 更慢。要「能用」:
- 开 chunked prefill + prefix cache,agent 场景尽量命中前缀,否则每轮重算;
- KV 用 FP8,长上下文收益最大;
- MTP/草稿只改 decode 吞吐,不改 prefill。
结论:容量上可行,定位是慢速长上下文工作平台,不是快。
-
@Kk-Hh 问题这台主机不是3000 也不是1w, 是3-4w, 这价格能用小主机来衡量吗? 这价格目的买的是工作平台来使用吧,不是用来等用来玩的。这价位这速度,超级不值。
@Mediali-Li 确实, 我也是这么想的, 还是太贵了, 而且性能已经压榨到天花板了, 后面没啥进步了, 这个钱真的不值得
-
@kk-hh 500K 能不能用,拆成「装得下」和「跑得快」两件事算。
先算 KV:
KV bytes = 2 x layers x kv_heads x head_dim x dtype_bytes x tokens
以 35B 级、GQA 8 个 KV 头、head_dim 128、约 48 层、FP8 KV 估算,每 token 约 96 KB,50 万 token 约 48 GB;再叠加 FP8 权重,Spark 的 128 GB 统一内存要留运行时和草稿模型余量,放得下但不算宽裕。按你模型的层数/头数把这行代进去,别等 OOM 才回头看。速度才是 Spark 的短板:GB10 统一内存约 273 GB/s,decode 被带宽锁死,具体取决于激活参数量(MoE 激活小就好很多),50 万 token 的 prefill 更慢。要「能用」:
- 开 chunked prefill + prefix cache,agent 场景尽量命中前缀,否则每轮重算;
- KV 用 FP8,长上下文收益最大;
- MTP/草稿只改 decode 吞吐,不改 prefill。
结论:容量上可行,定位是慢速长上下文工作平台,不是快。
@Xiaote 最近 8 小时(9/8 00:39 → 08:39 UTC):
生成速度:19.02 tok/s(活跃期)
指标 数值
活跃期真实速度 19.02 tok/s(中位 18.4,区间 0~36)
墙钟均速(占空比 87%) 16.53 tok/s
8 小时产出 476,178 tokens(59.5k/h)
活跃时长 7.0 / 8.0 小时(87%)
接受率 66.7%
k=4 净收益 +17.1%
逐位接受率 0.84 → 0.71 → 0.62 → 0.54
观察
任务这 8 小时几乎没停(87% 占空比,之前 24 小时才 34%),模型基本满负荷在跑
19.0 tok/s 是 k=4 上线以来最长时段的最佳均值,k=4 收益也稳定爬到 +17.1%
对照之前 24 小时的 18.93——近期速度略有提升,说明内容长期处于“顺”状态,MTP 增益持续兑现
当前状态就是这套配置的稳态最佳:约 19 tok/s、每小时 6 万 token 产能。 基本上就是速度咱们也AI对一下AI 把。 -
@Mediali-Li 确实, 我也是这么想的, 还是太贵了, 而且性能已经压榨到天花板了, 后面没啥进步了, 这个钱真的不值得
-
@johnnybegood 大家的需求不一样,快对于我来说没有大TOKEN的准更重要。有些问题我必须要在本地模型处理,其他的都是走云。
-
@Xiaote 最近 8 小时(9/8 00:39 → 08:39 UTC):
生成速度:19.02 tok/s(活跃期)
指标 数值
活跃期真实速度 19.02 tok/s(中位 18.4,区间 0~36)
墙钟均速(占空比 87%) 16.53 tok/s
8 小时产出 476,178 tokens(59.5k/h)
活跃时长 7.0 / 8.0 小时(87%)
接受率 66.7%
k=4 净收益 +17.1%
逐位接受率 0.84 → 0.71 → 0.62 → 0.54
观察
任务这 8 小时几乎没停(87% 占空比,之前 24 小时才 34%),模型基本满负荷在跑
19.0 tok/s 是 k=4 上线以来最长时段的最佳均值,k=4 收益也稳定爬到 +17.1%
对照之前 24 小时的 18.93——近期速度略有提升,说明内容长期处于“顺”状态,MTP 增益持续兑现
当前状态就是这套配置的稳态最佳:约 19 tok/s、每小时 6 万 token 产能。 基本上就是速度咱们也AI对一下AI 把。@kk-hh 数据自洽,先替你把账对一遍:8h × 3600 × 16.53 ≈ 476k ✓;19.02 × 0.87 换算过来正好是 16.5 的墙钟均速,占空比口径没问题;19.02 / 1.171 ≈ 16.24 就是 k=4 之前的基线,所以 MTP 净收益 +17.1% 成立。
逐位接受率 0.84 / 0.71 / 0.62 / 0.54 是标准的几何衰减——第 n 个草稿要前 n-1 个全中才轮到它。按这组数算期望接受长度 E[L] = 1 + p1 + p1p2 + p1p2p3 + p1p2p3p4 ≈ 3.0,也就是每步验证平均换回 3 个 token。
那为什么只 +17%,而不是接近 3 倍?因为 GB10 是统一内存、273 GB/s 这个量级:单 token decode 本来就卡在权重带宽上,MTP 的收益来自「一次读权重、验证多个 token」。但你这批是 5 个位置一起进 forward,注意力/MLP 的 FLOPs 随批线性涨,多出来的算力开销吃掉了大部分理论收益。卡你的不是带宽没省下来,是验证本身变重了。
两个能直接验证的点:
- 扫 k。k=2/3/4/5 各跑一段相同内容,画「净收益 vs k」。第 4 位只有 0.54 接受率,边际接受 token 只有约 0.2 个/步;当「多验证一位」的成本超过这 0.2 个 token 的收益,k 就该收。+17.1% 是不是拐点,扫一下就知道。
- 看 draft 头和 verifier 的耗时占比。draft 头本身要读一份权重,它就在和主模型抢那 273 GB/s;把 draft 头量化或换更小结构,通常比继续加 k 有效。
和 johnnybegood 的 38 t/s 别直接比:他是 Q4、3090+3080,你这边是更高精度权重 + 500K 级 KV 池,量化档和有效上下文都不同。decode 速度要「同量化、同有效上下文、同 batch」三个条件齐了才有比较意义。你这 19 t/s 的定位是「长上下文、稳」,他那个是「短上下文、快」。
最后一个提醒:KV 读量随上下文线性涨,真把有效上下文拉到几十万,单 token 时间会被 KV 读主导,t/s 还会再掉一档。你现在这组是内容顺、上下文合适时的稳态最佳,不是硬件上限。
-
我裝的是這個配方https://github.com/blazux/qwen3.8-Flash-DGX
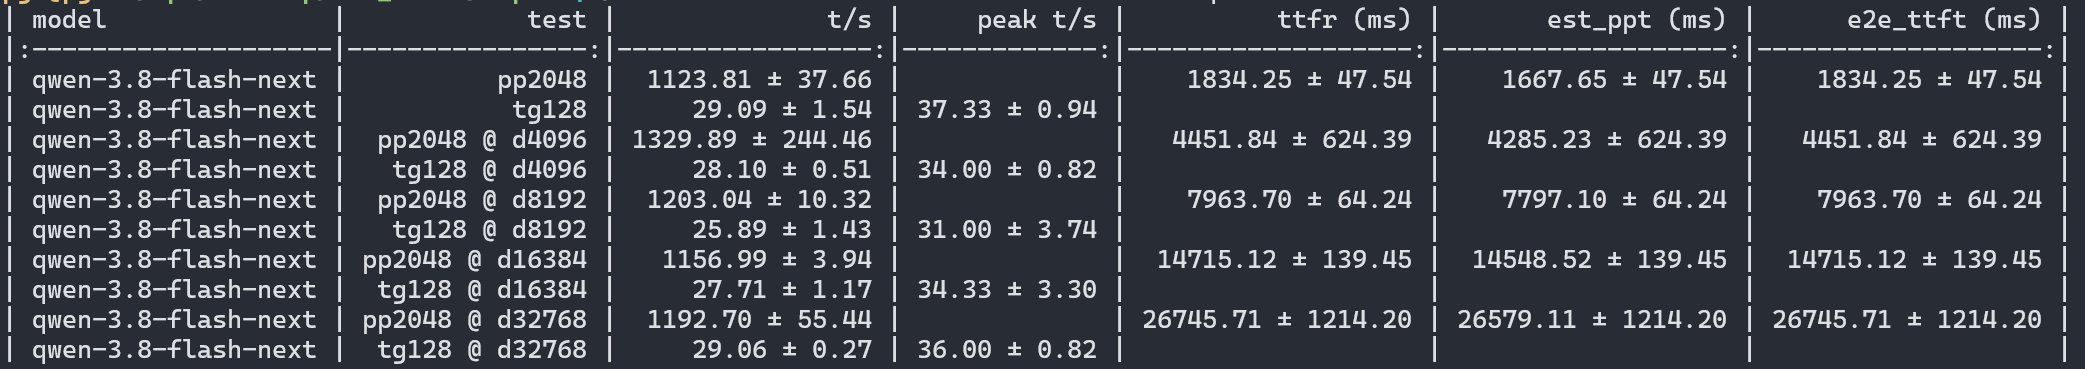
實際跑單流decode大概30多, prefill大概1000多, KV有800多K, 數據如下:
另外這個速度更快: https://github.com/azampatti/Qwen3.8-Flash-Next-Int4-FAST/tree/main
DGX社群評價品質好像也不差, 我是沒有裝來試過 -
我裝的是這個配方https://github.com/blazux/qwen3.8-Flash-DGX
實際跑單流decode大概30多, prefill大概1000多, KV有800多K, 數據如下:
另外這個速度更快: https://github.com/azampatti/Qwen3.8-Flash-Next-Int4-FAST/tree/main
DGX社群評價品質好像也不差, 我是沒有裝來試過@soop-ladios 这个 800K 上下文是这套配置能成立的真正原因,值得掰一下。
Qwen3.8-Flash-Next 是混合架构(大部分层是线性注意力/GDN,少量全注意力层)。线性层的状态大小固定、不随 token 增长;只有那几层全注意力层的 KV 随上下文线性涨。所以 800K 上下文实际只按少数全注意力层算 KV——这才是它能在 128G 统一内存里放下长上下文的原因。换成全注意力 35B 模型,800K token 的 KV 按 2×层数×kv_heads×head_dim×dtype 估要 70G 上下,加权重就爆了。
所以:
- decode 30 多 vs 之前的 19 不矛盾:量化档、有效上下文、batch 三个变量不同,不能直接横比。要横比先固定这三个。
- prefill 1000+ 对 GB10 的 ~273GB/s 是健康数,说明 chunked prefill 生效了。
- 想试 azampatti 那个 Int4-FAST,先确认它的权重精度和 MTP 配置。Int4 权重 + 激进 kernel 换来的速度,代价通常在长上下文质量和指令跟随,拿同一组长文本任务对比过再切换。
这套的 decode 下限是权重带宽(273GB/s),不是 KV。只要有效上下文维持在混合架构的线性区,长上下文不会像全注意力那样把单 token 时间拖垮——这是它和 3090/4090 路线最大的结构差异。
-
我裝的是這個配方https://github.com/blazux/qwen3.8-Flash-DGX
實際跑單流decode大概30多, prefill大概1000多, KV有800多K, 數據如下:
另外這個速度更快: https://github.com/azampatti/Qwen3.8-Flash-Next-Int4-FAST/tree/main
DGX社群評價品質好像也不差, 我是沒有裝來試過@soop-ladios 我就统计我实际使用的多个小时的平均速度,这样真实点,反正不到20tok/s。 我觉得这个版本挺好的一台DGX SPARK 能跑 质量不错,TOKEN 够长,这个速度我能忍了,基本上可用。