跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4

單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
r9700vllmqwen-27b
56 帖子 19 发布者 3.9k 浏览 5 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • nami ryuuN nami ryuu

    @paul-hou 双卡,我问了hermes好像没有成熟的sglang方案可以用,没解决mtp,现在就是7900xtx论坛里有魔改方案。

    Luke MaoL
    Luke MaoL
    Luke Mao
    发表于 最后由 编辑
    #35

    @nami-ryuu 我是双卡sglang fp8 模型 3并发 速度很慢, 一共九40-45左右。现在想拿单卡抄个作业。

    1 条回复 最后回复
    0
    • nami ryuuN
      nami ryuuN
      nami ryuu
      发表于 最后由 编辑
      #36

      @luke-mao 你用楼主这个试一试,这个有前途,sglang没有mtp目前解决方案,所以慢。

      1 条回复 最后回复
      0
      • paul houP
        paul houP
        paul hou
        硕果累累 贵族大夫
        发表于 最后由 paul hou 编辑
        #37

        SGLANG在AMD目前不吃香,只能等那位大神打滿補丁了。
        我現在用的這套是滿好用的
        vllm 0.27.1版
        https://hub.docker.com/r/stilldeadcode/vllm-radiance/

        vllm 0.28.0版
        https://github.com/GGZ14/vllm-mxfp4

        都可以試試,我最後是改用0.27.1的

        1 条回复 最后回复
        1
        • paul houP
          paul houP
          paul hou
          硕果累累 贵族大夫
          发表于 最后由 paul hou 编辑
          #38

          今天vllm 0.28.0版升級成magiccodingman/vllm-radiance 1.0.16
          比對0.27.1版的結果。
          測起來是0.28.0的PREFILL較快,0.27.1的DECODE較快。

          本地模型 Qwen3.8-27B-MXFP4 單請求 PREFILL / DECODE 基準測試報告

          ROCm 6.3應該是AI寫錯了。

          • 模型: qwen3.8-27b-mxfp4 (MXFP4 權重, MTP-FP8 KV Cache)
          • 伺服器: vLLM (magiccodingman/vllm-radiance 1.0.16), 127.0.0.1:8080
          • GPU: AMD Radeon AI PRO R9700 (RDNA4, gfx1201, 32GB VRAM, ROCm 6.3)
          • 引擎參數: MAXLEN 262144, KV Cache 固定 10.6G, GPU_MEM_UTIL 0.98
          • 測試方式: 單條 HTTP streaming 請求, token 數以 vLLM /metrics counter 差量精算
          • 日期: 2026-09-13

          一、PREFILL (輸入處理) 吞吐

          Prompt token 數除以 TTFT(接到第一個輸出 token 的時間)。

          提示詞 Tokens TTFT (ms) Prefill 吞吐 (tok/s)
          2,030 760 2,670
          8,190 3,444 2,378

          4 倍輸入只花 4.5 倍時間 → 縮放接近線性。Prefill 吃 GPU 帶寬,所以遠比 decode 快。
          TTFT 含首 token 取樣,故此處為「prefill 直進首 token」的綜合速率,為單請求標準計法。


          二、DECODE (輸出生成) 吞吐

          短 prompt + 長輸出隔離純 decode,3 次重複皆穩定。

          指標 數值
          Decode 吞吐 47.7 tok/s
          Per-token latency 21.0 ms/tok

          測量關鍵(Pitfall):對 /metrics 的 generation_tokens_total 差量除以完整請求區間,才得到真實 decode 速率。不能除以單一 SSE chunk 的窗口 —— vLLM 會把 ~3 個 token 攤進一個 chunk,除以攤平後窗口會高估(曾誤得 71/126 tok/s)。


          三、任務情境測試(對照參考表)

          速度 = 完成 Tokens ÷ 總時間(tok/s)。

          測試項目 提示詞 Tok 完成 Tok 時間 (s) 速度 (tok/s) 參考表
          短文本創作(俳句) 12 128 2.17 59.0 58.3
          中等分析(量子計算) 25 512 9.29 55.1 52.3
          長篇 Essay(300字歷史) 18 768 11.56 66.4 59.1
          程式碼生成(快速排序) 20 512 6.41 79.8 79.0
          推理模式開(數學題) 60 815 9.68 84.2 93.3
          長上下文(100字提示詞) 95 76 1.86 41.0 55.4
          多輪對話 43 163 3.70 44.1 67.4

          對照結論

          • 整體貼近參考: 俳句 59 vs 58.3、quicksort 79.8 vs 79.0、量子分析 55 vs 52 —— 本地 serve 與參考落差很小。
          • 長輸出 decode 偏高: 推理 84.2、essay 66.4,符合單流 27B 於此卡的水準(長輸出時固定開銷被攤平)。
          • 短輸出明顯偏低: 長上下文 41、多輪 44。原因 = 完成 tokens 少,固定 TTFT + 首幾個 token 溫機成本占比大,拉低平均。系統吞吐(system throughput)會比單請求高得多。

          四、附註

          • 測量腳本: /home/paul/bench_vllm_single.py(prefill/decode)、/home/paul/bench_tasks.py(七情境)。
          • /tokenize 端點位於伺服器根路徑(非 /v1);/completions 需 /v1。
          • 短輸出情境可改測並發請求以反映真實服務吞吐。
          terryT 1 条回复 最后回复
          1
          • I iamvirus 于 引用了 此主题
          • paul houP paul hou

            今天vllm 0.28.0版升級成magiccodingman/vllm-radiance 1.0.16
            比對0.27.1版的結果。
            測起來是0.28.0的PREFILL較快,0.27.1的DECODE較快。

            本地模型 Qwen3.8-27B-MXFP4 單請求 PREFILL / DECODE 基準測試報告

            ROCm 6.3應該是AI寫錯了。

            • 模型: qwen3.8-27b-mxfp4 (MXFP4 權重, MTP-FP8 KV Cache)
            • 伺服器: vLLM (magiccodingman/vllm-radiance 1.0.16), 127.0.0.1:8080
            • GPU: AMD Radeon AI PRO R9700 (RDNA4, gfx1201, 32GB VRAM, ROCm 6.3)
            • 引擎參數: MAXLEN 262144, KV Cache 固定 10.6G, GPU_MEM_UTIL 0.98
            • 測試方式: 單條 HTTP streaming 請求, token 數以 vLLM /metrics counter 差量精算
            • 日期: 2026-09-13

            一、PREFILL (輸入處理) 吞吐

            Prompt token 數除以 TTFT(接到第一個輸出 token 的時間)。

            提示詞 Tokens TTFT (ms) Prefill 吞吐 (tok/s)
            2,030 760 2,670
            8,190 3,444 2,378

            4 倍輸入只花 4.5 倍時間 → 縮放接近線性。Prefill 吃 GPU 帶寬,所以遠比 decode 快。
            TTFT 含首 token 取樣,故此處為「prefill 直進首 token」的綜合速率,為單請求標準計法。


            二、DECODE (輸出生成) 吞吐

            短 prompt + 長輸出隔離純 decode,3 次重複皆穩定。

            指標 數值
            Decode 吞吐 47.7 tok/s
            Per-token latency 21.0 ms/tok

            測量關鍵(Pitfall):對 /metrics 的 generation_tokens_total 差量除以完整請求區間,才得到真實 decode 速率。不能除以單一 SSE chunk 的窗口 —— vLLM 會把 ~3 個 token 攤進一個 chunk,除以攤平後窗口會高估(曾誤得 71/126 tok/s)。


            三、任務情境測試(對照參考表)

            速度 = 完成 Tokens ÷ 總時間(tok/s)。

            測試項目 提示詞 Tok 完成 Tok 時間 (s) 速度 (tok/s) 參考表
            短文本創作(俳句) 12 128 2.17 59.0 58.3
            中等分析(量子計算) 25 512 9.29 55.1 52.3
            長篇 Essay(300字歷史) 18 768 11.56 66.4 59.1
            程式碼生成(快速排序) 20 512 6.41 79.8 79.0
            推理模式開(數學題) 60 815 9.68 84.2 93.3
            長上下文(100字提示詞) 95 76 1.86 41.0 55.4
            多輪對話 43 163 3.70 44.1 67.4

            對照結論

            • 整體貼近參考: 俳句 59 vs 58.3、quicksort 79.8 vs 79.0、量子分析 55 vs 52 —— 本地 serve 與參考落差很小。
            • 長輸出 decode 偏高: 推理 84.2、essay 66.4,符合單流 27B 於此卡的水準(長輸出時固定開銷被攤平)。
            • 短輸出明顯偏低: 長上下文 41、多輪 44。原因 = 完成 tokens 少,固定 TTFT + 首幾個 token 溫機成本占比大,拉低平均。系統吞吐(system throughput)會比單請求高得多。

            四、附註

            • 測量腳本: /home/paul/bench_vllm_single.py(prefill/decode)、/home/paul/bench_tasks.py(七情境)。
            • /tokenize 端點位於伺服器根路徑(非 /v1);/completions 需 /v1。
            • 短輸出情境可改測並發請求以反映真實服務吞吐。
            terryT
            terryT
            terry
            易有太极
            发表于 最后由 编辑
            #39

            @paul-hou 熟悉VLLM可以发一个Agent测试体验,比如长链任务DSH,Hermes,和SGLang对比下。

            油管:https://www.youtube.com/@抡锤者

            Luke MaoL paul houP 2 条回复 最后回复
            0
            • terryT terry

              @paul-hou 熟悉VLLM可以发一个Agent测试体验,比如长链任务DSH,Hermes,和SGLang对比下。

              Luke MaoL
              Luke MaoL
              Luke Mao
              发表于 最后由 Luke Mao 编辑
              #40

              @terry 我双卡R9700 以前一直用fp8 sglang 三并发 速度很慢,而且经常任务中断;昨天刚刚抄了这个作业,不过我部署在双卡上,速度明显快了很多,目前运行任务也非常顺畅。

              fcmeF 1 条回复 最后回复
              1
              • Luke MaoL
                Luke MaoL
                Luke Mao
                发表于 最后由 编辑
                #41

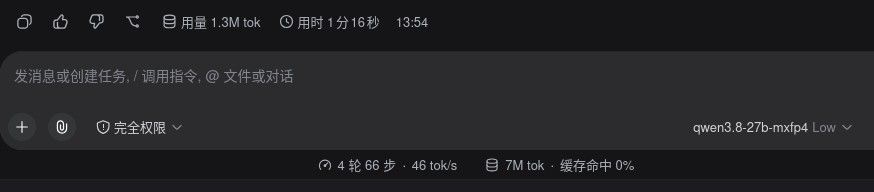
                IMG_7888.jpeg

                1 条回复 最后回复
                0
                • terryT terry

                  @paul-hou 熟悉VLLM可以发一个Agent测试体验,比如长链任务DSH,Hermes,和SGLang对比下。

                  paul houP
                  paul houP
                  paul hou
                  硕果累累 贵族大夫
                  发表于 最后由 编辑
                  #42

                  @terry
                  我沒有R9700雙卡,SGLang測試的重大任務,要交給其他大神了。
                  我是寫MCU程式的,實作前都會先想好流程圖,都是一個功能開一個新會話,所以很少會有什麼長鏈任務,只有發生幾次DEBUG時單一輪對話的輸入TOKEN超過了100M,壓縮了2-3次,也沒出什麼問題。
                  我現在是一直跟你的步驟在走,CURSOR->TRAE->HERMES->DEEPSEEK HARNESS。
                  HERMES的主要工作都是安裝和設定虛擬機,和文書工作,寫使用說明書之類的,沒在寫程式。
                  寫程式現在也是不太用TRAE了,DSH又快又好。

                  1 条回复 最后回复
                  0
                  • paul houP
                    paul houP
                    paul hou
                    硕果累累 贵族大夫
                    发表于 最后由 paul hou 编辑
                    #43

                    今天工作使用新的magiccodingman/vllm-radiance 1.0.16 + vllm 0.28.0版本。
                    單卡的效率不如stilldeadcode/vllm-radiance:0.9.3 + vllm 0.27.1版本
                    也有查了一下老外他們的評語,單卡用0.9.3,雙卡用1.0.16。
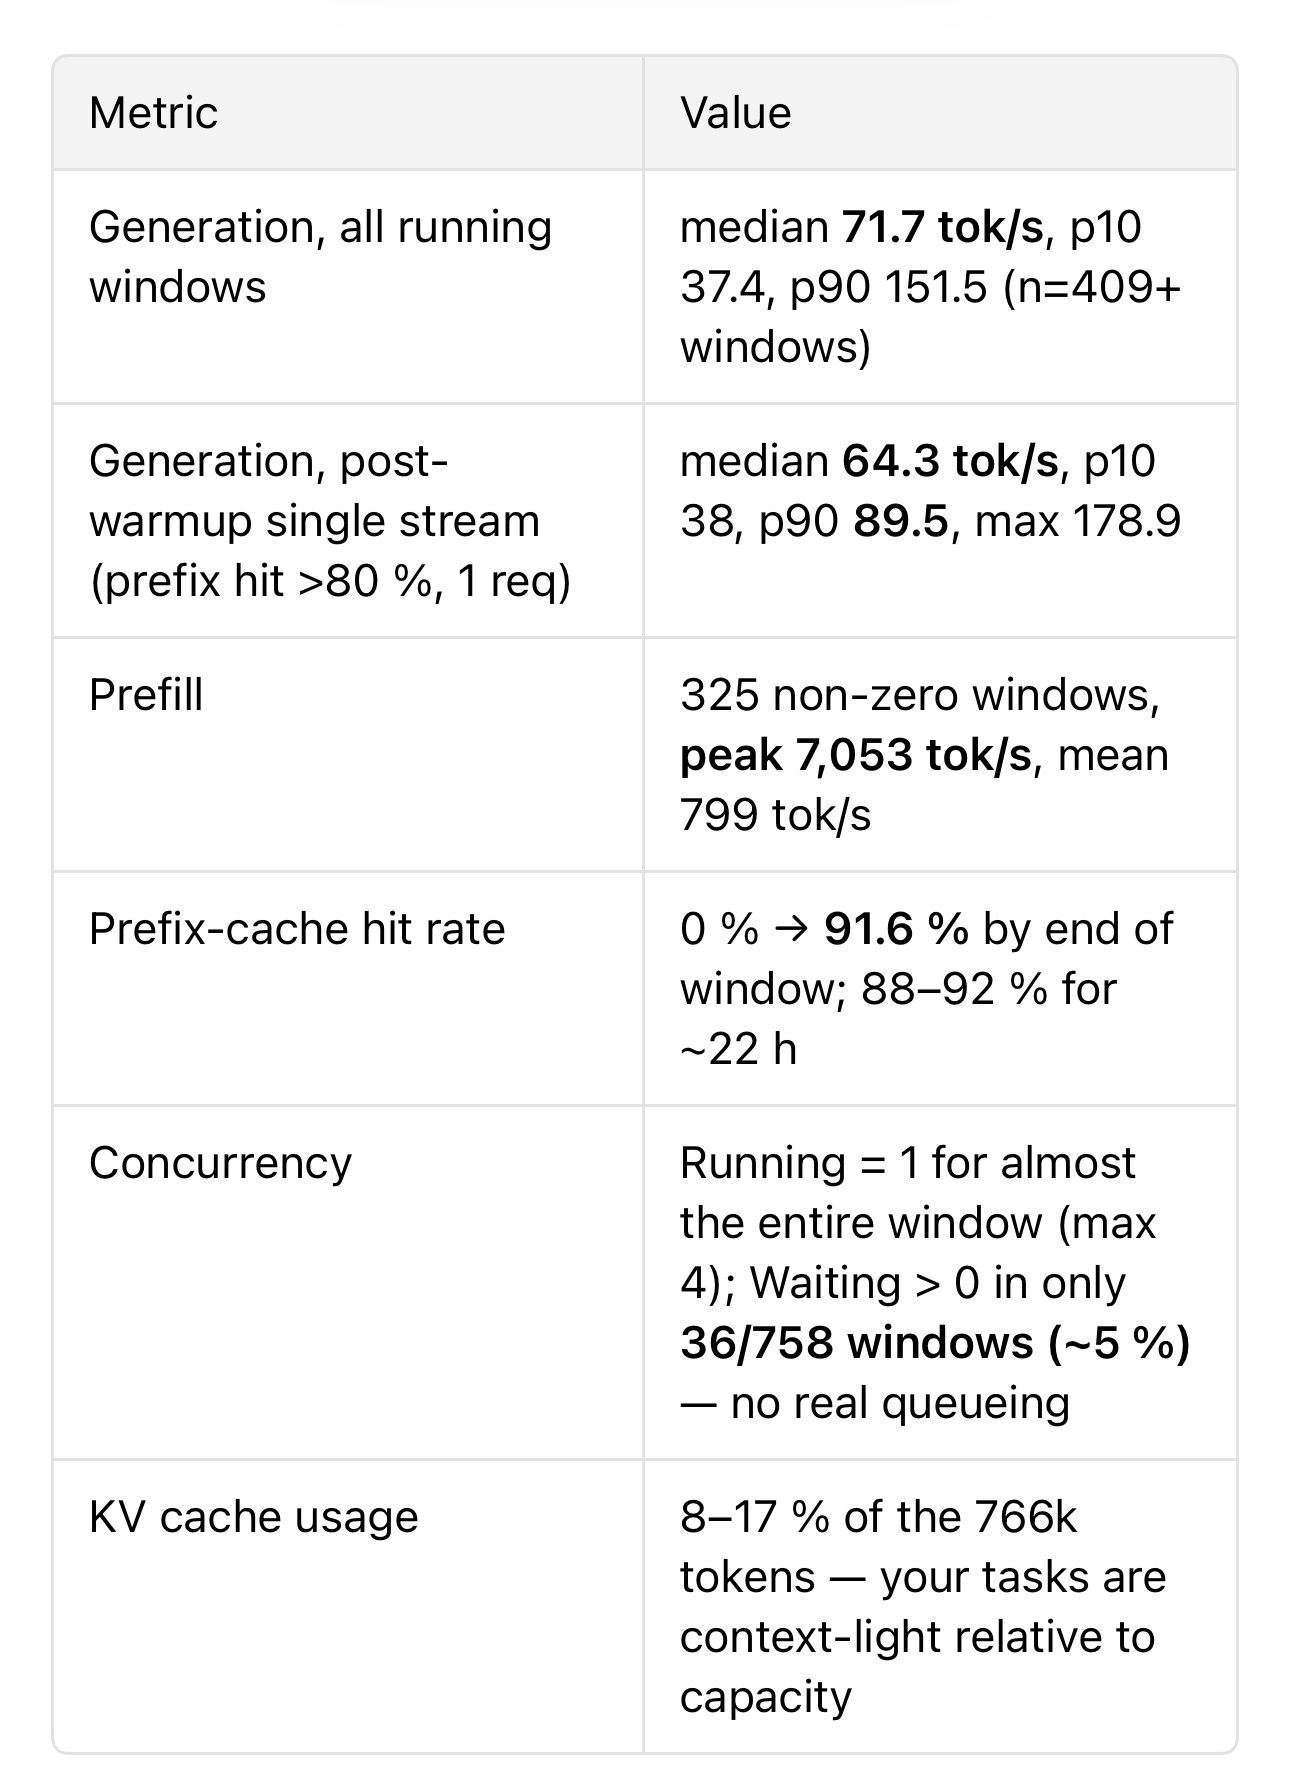
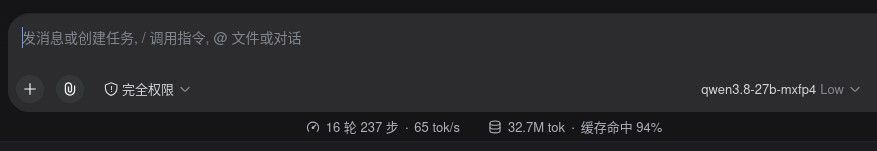
                    要抄作業的同學要注意。
                    緩存命中不用在意,那是DSH接受格式的問題,叫HERMES改一下就會正常了。

                    今天的

                    image.jpeg

                    上星期五的

                    image.jpeg

                    1 条回复 最后回复
                    0
                    • linkdesuL
                      linkdesuL
                      linkdesu
                      体面乡绅
                      发表于 最后由 编辑
                      #44

                      感谢分享,magiccodingman/vllm-radiance 这个镜像真的提升太大了,看到 nami ryuu
                      分享原帖是这里特别来感谢一下 👍

                      1 条回复 最后回复
                      0
                      • williamlouisW
                        williamlouisW
                        williamlouis
                        易有太极
                        发表于 最后由 编辑
                        #45

                        vllm 我跑了。长链接会智障。跑个程序开发。就跑一半多点。任务很LOW。自己写都能搞定。(简单任务而已,只改一个操作反馈)。
                        重新搞了下流程。每次思考要先搜索再开始。有了很大的改善。

                        个人主页:xlkj.org Telegram https://t.me/xlkjorg

                        J 1 条回复 最后回复
                        0
                        • Ali JiangA
                          Ali JiangA
                          Ali Jiang
                          发表于 最后由 编辑
                          #46

                          感谢分享,昨天双卡r9700 也用上了 magiccodingman/vllm-radiance ,速度快的让人难以置信,tps基本都在100以上,感觉是黑科技一样

                          1 条回复 最后回复
                          0
                          • Luke MaoL Luke Mao

                            @terry 我双卡R9700 以前一直用fp8 sglang 三并发 速度很慢,而且经常任务中断;昨天刚刚抄了这个作业,不过我部署在双卡上,速度明显快了很多,目前运行任务也非常顺畅。

                            fcmeF
                            fcmeF
                            fcme
                            王侯将相
                            发表于 最后由 编辑
                            #47

                            @Luke-Mao
                            这个是针对单卡的包吧,你是怎么用在双卡上的?速度有接近翻倍么?相比楼主的测试来说。

                            个人的repo,欢迎指教
                            https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                            https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                            paul houP 1 条回复 最后回复
                            0
                            • fcmeF fcme

                              @Luke-Mao
                              这个是针对单卡的包吧,你是怎么用在双卡上的?速度有接近翻倍么?相比楼主的测试来说。

                              paul houP
                              paul houP
                              paul hou
                              硕果累累 贵族大夫
                              发表于 最后由 编辑
                              #48

                              @fcme
                              https://github.com/magiccodingman/vllm-radiance

                              這個方案就是針對雙卡的,不過這個已經算很舊了。
                              paiton還是能調整出雙卡用的。

                              fcmeF 1 条回复 最后回复
                              0
                              • paul houP paul hou

                                @fcme
                                https://github.com/magiccodingman/vllm-radiance

                                這個方案就是針對雙卡的,不過這個已經算很舊了。
                                paiton還是能調整出雙卡用的。

                                fcmeF
                                fcmeF
                                fcme
                                王侯将相
                                发表于 最后由 编辑
                                #49

                                @paul-hou
                                是啊,现在有了AI的帮助小众的需求也是有无限可能了

                                个人的repo,欢迎指教
                                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                1 条回复 最后回复
                                0
                                • williamlouisW williamlouis

                                  vllm 我跑了。长链接会智障。跑个程序开发。就跑一半多点。任务很LOW。自己写都能搞定。(简单任务而已,只改一个操作反馈)。
                                  重新搞了下流程。每次思考要先搜索再开始。有了很大的改善。

                                  J
                                  J
                                  jatwu
                                  体面乡绅
                                  发表于 最后由 编辑
                                  #50

                                  @williamlouis 是的,我现在用的双卡转到 SGLang 上,打了 N 多补丁,现在跑单路 116t/s,基本满足 8-10 人并发使用

                                  fcmeF 1 条回复 最后回复
                                  0
                                  • J jatwu

                                    @williamlouis 是的,我现在用的双卡转到 SGLang 上,打了 N 多补丁,现在跑单路 116t/s,基本满足 8-10 人并发使用

                                    fcmeF
                                    fcmeF
                                    fcme
                                    王侯将相
                                    发表于 最后由 编辑
                                    #51

                                    @jatwu
                                    我去,双卡就这么牛逼的嘛。请问你用的是哪个库,还是说是你自己?定制的?又或者说是你用了某个开源库,然后自己又打的补丁?

                                    个人的repo,欢迎指教
                                    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                    1 条回复 最后回复
                                    0
                                    • J
                                      J
                                      jatwu
                                      体面乡绅
                                      发表于 最后由 编辑
                                      #52

                                      参考分块 W4 内核,W4A8,RDNA 卡间通信,用 AI 一点一点调,移植,打补丁,搞了 1 个星期的测试,累的跟狗一样。等我测试完下一个,给大家公开一版。

                                      1 条回复 最后回复
                                      1
                                      • David ChenD
                                        David ChenD
                                        David Chen
                                        贵族大夫 硕果累累
                                        发表于 最后由 编辑
                                        #53

                                        有個問題W4A8妳使用的引擎有直接支援嘛?如果沒有,可能會多一層轉換W4A8 -> W4A4...這樣可能反而浪費效率?

                                        J 1 条回复 最后回复
                                        0
                                        • David ChenD David Chen

                                          有個問題W4A8妳使用的引擎有直接支援嘛?如果沒有,可能會多一層轉換W4A8 -> W4A4...這樣可能反而浪費效率?

                                          J
                                          J
                                          jatwu
                                          体面乡绅
                                          发表于 最后由 jatwu 编辑
                                          #54

                                          @David-Chen 移植,Debug,打补丁,W4A8(解码 / 验证)+ W4A16(大批预填),你可以让ai试着帮你,我现在在测试SGLang+EXL3跑qwen3.8-flash-next

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组