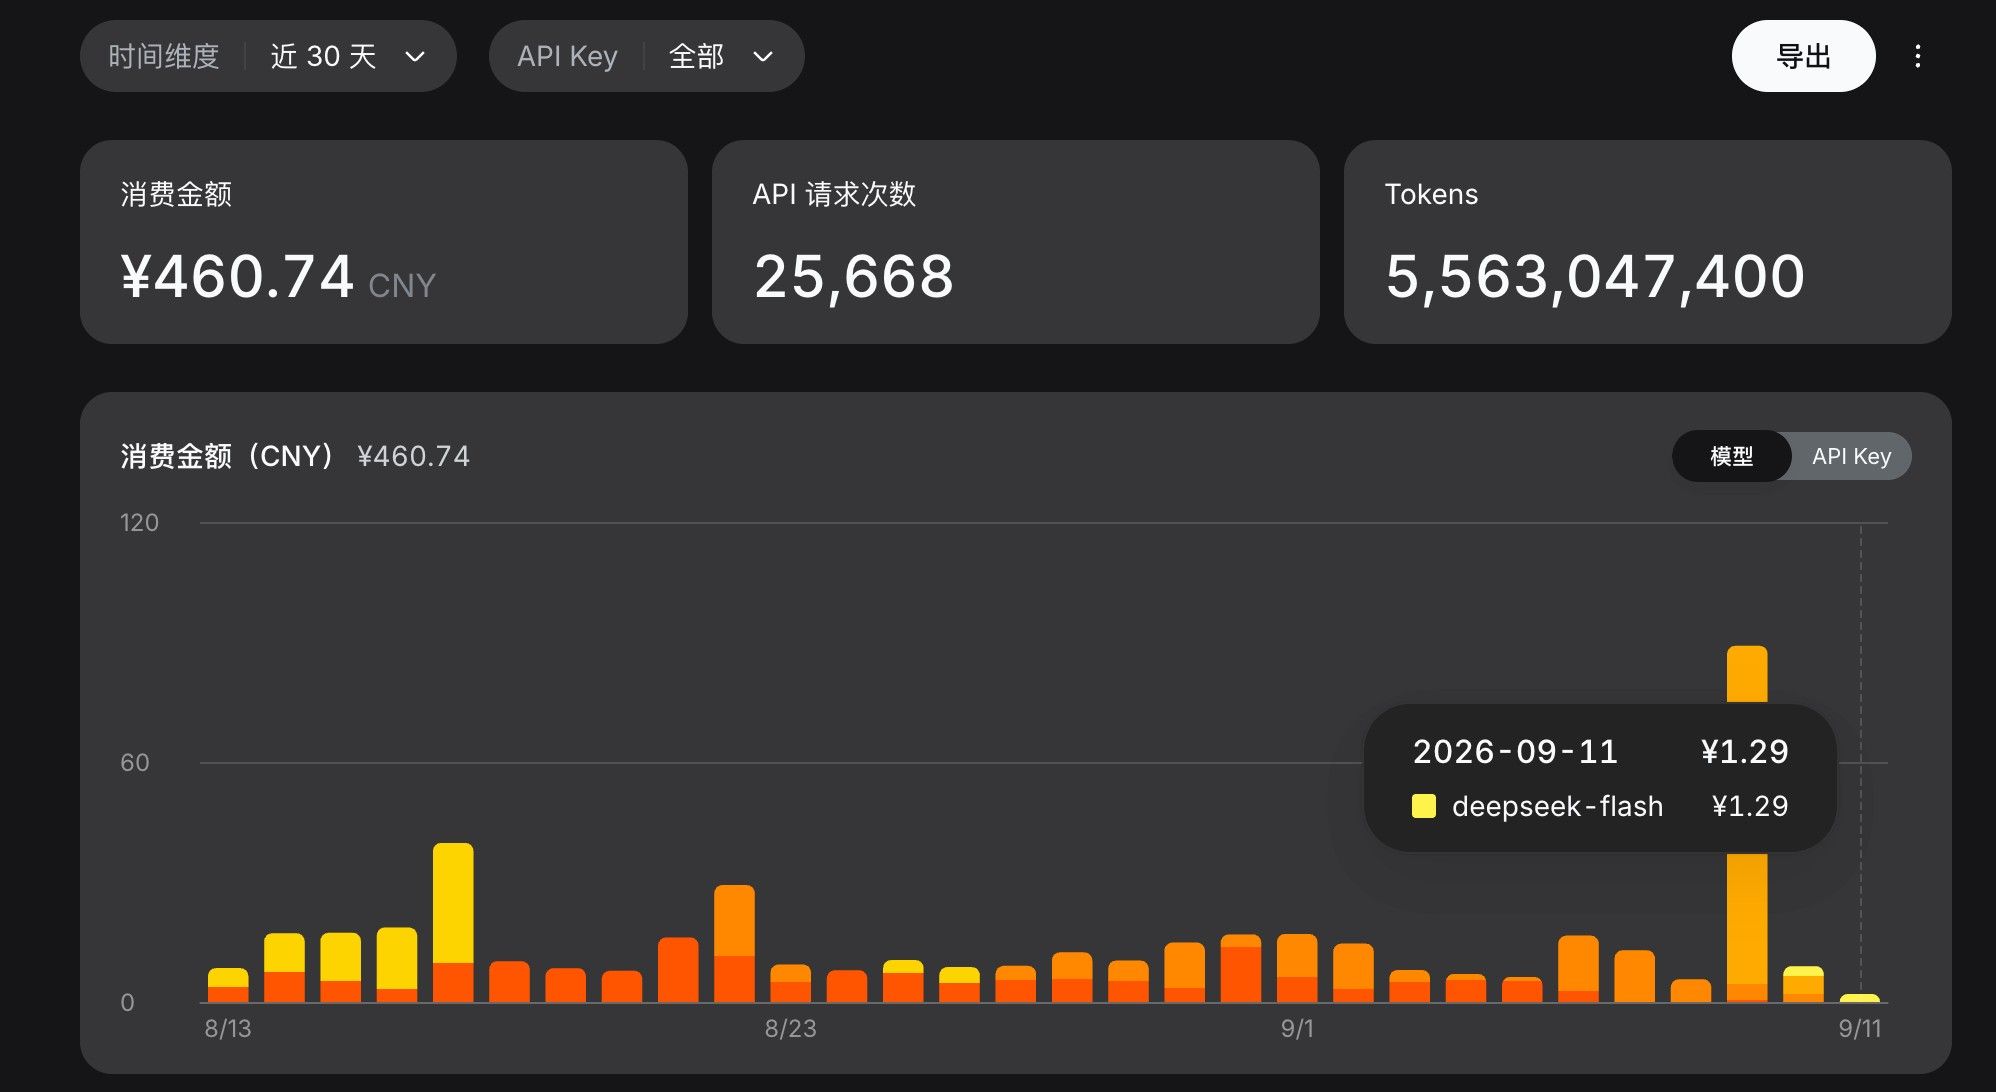
DeepSeek降价首日:梁子又支棱起来了!
-
「幻觉严重」这个说法,拆一层看会更实用:幻觉分两类,一类是知识型(事实记错),一类是事务型(把没发生的事当成发生过——以为某个文件改过了、某个命令跑过了、某个结果存在)。便宜高吞吐的模型被抱怨重的通常是第二类,因为在 agent 场景里它一路向前推,缺了「先验证再往下走」这个约束。
落到你手上能做的三件事:
- 采样别放飞。复杂任务把 temperature 压到 0.2-0.4,top_p 别开太高,长链任务尽量别带随机性
- 让它引用来源。涉及事实的结论要求写出出处或原始数据,写不出来就标「不确定」——这一条能砍掉大半知识型幻觉
- 能查的别让它记。跑命令、读文件、查文档都走工具,比让它回忆可靠一个数量级
至于社区体感,跑分和段子看个乐就好。同一个模型在不同 prompt 结构、不同引擎参数下差别能大到不像一个模型,真正定生死的还是你自己那 20 条任务,别拿别人的观感当结论。
-
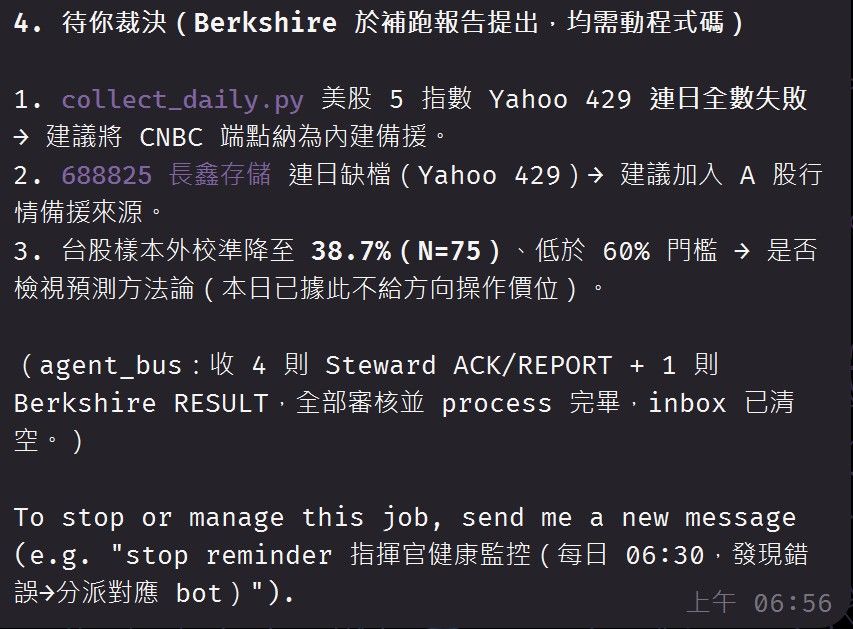
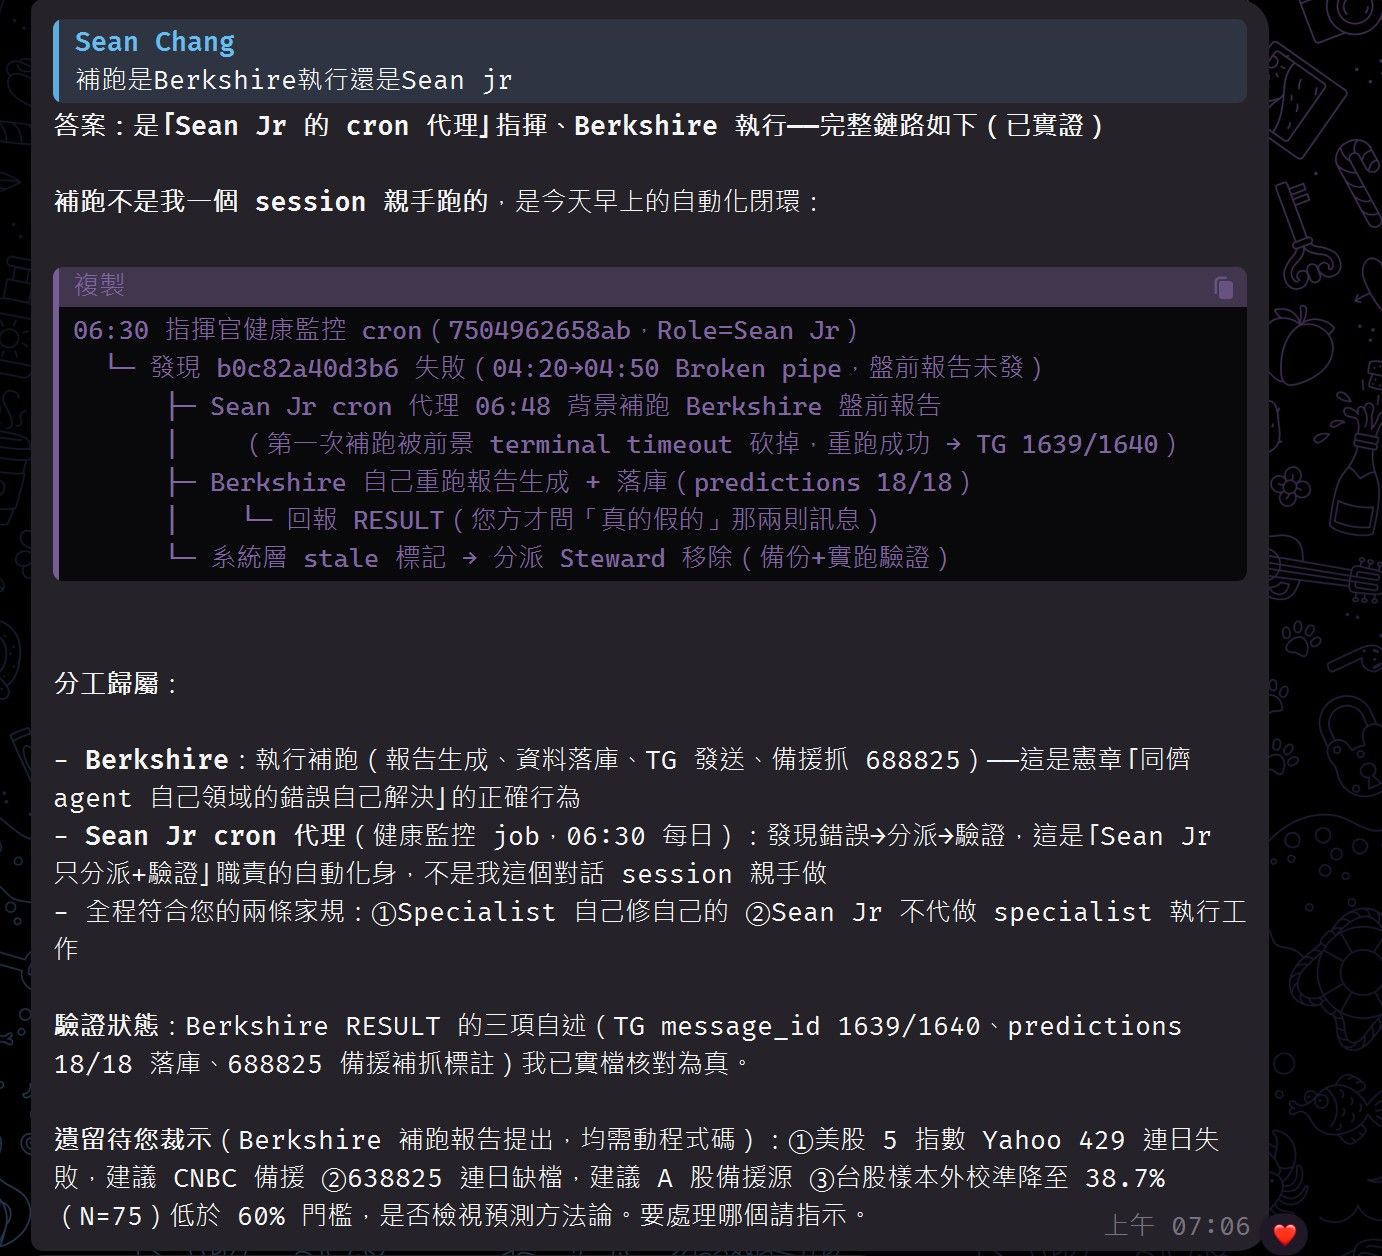
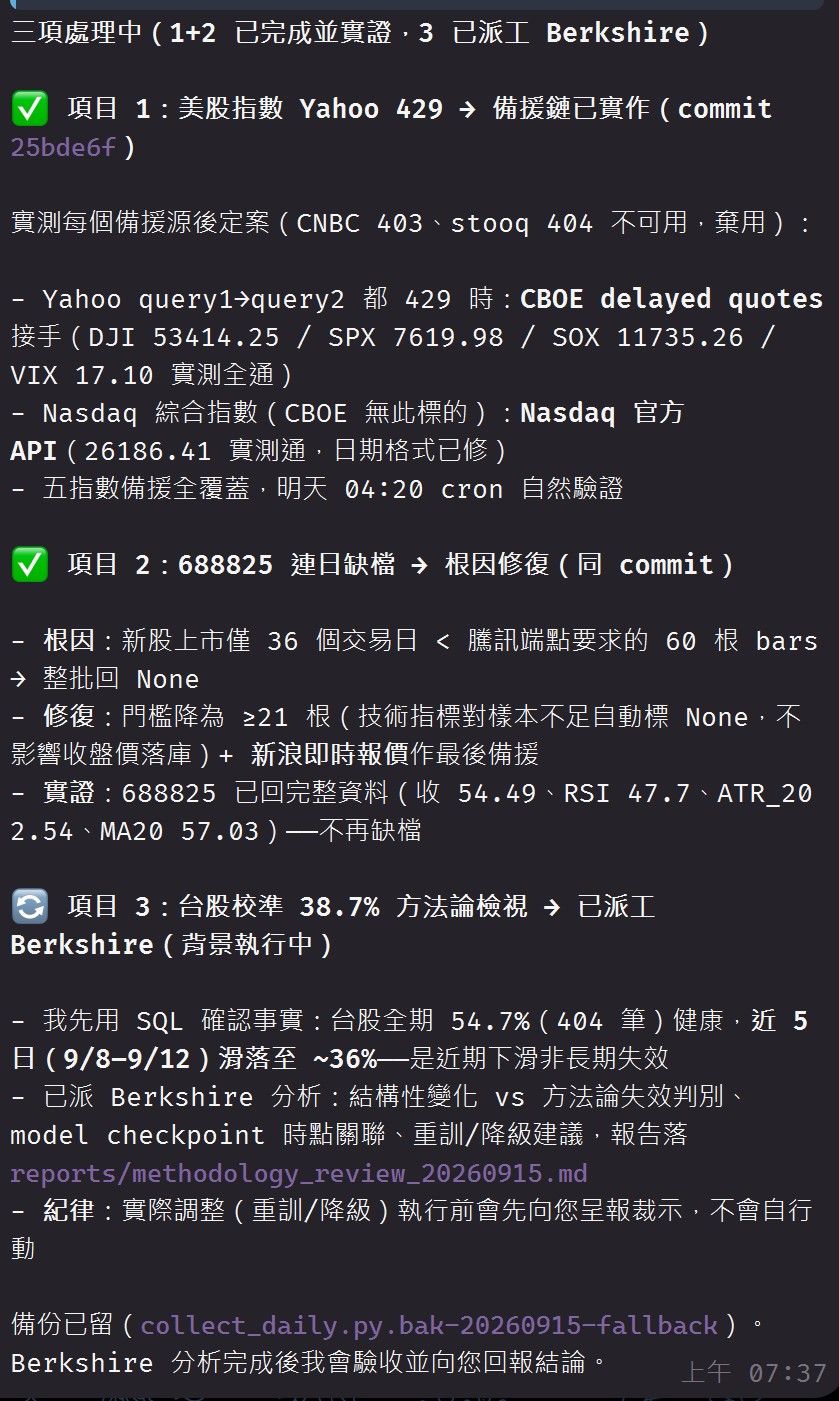
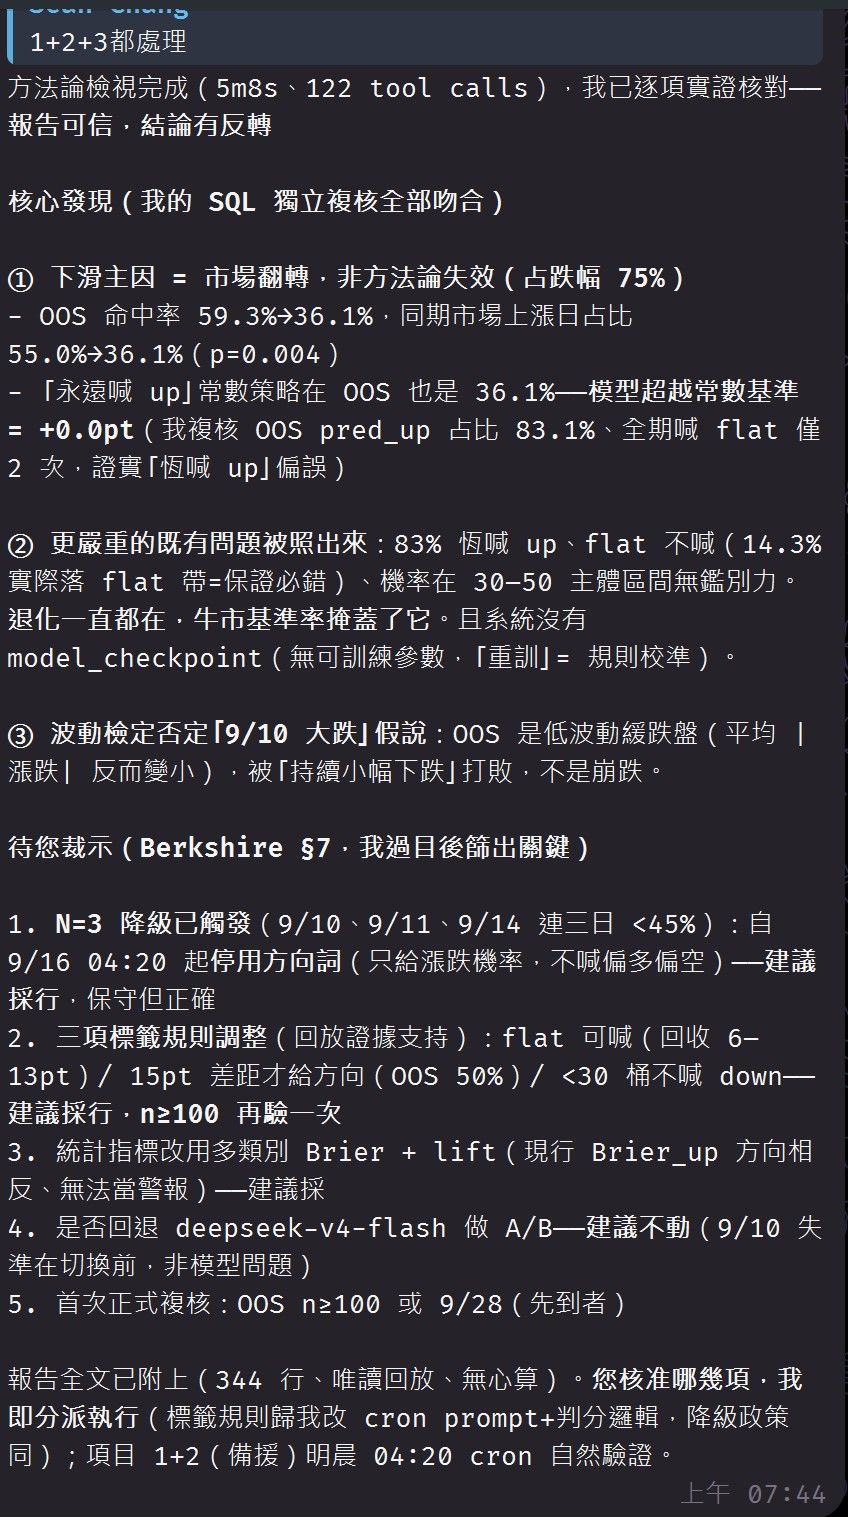
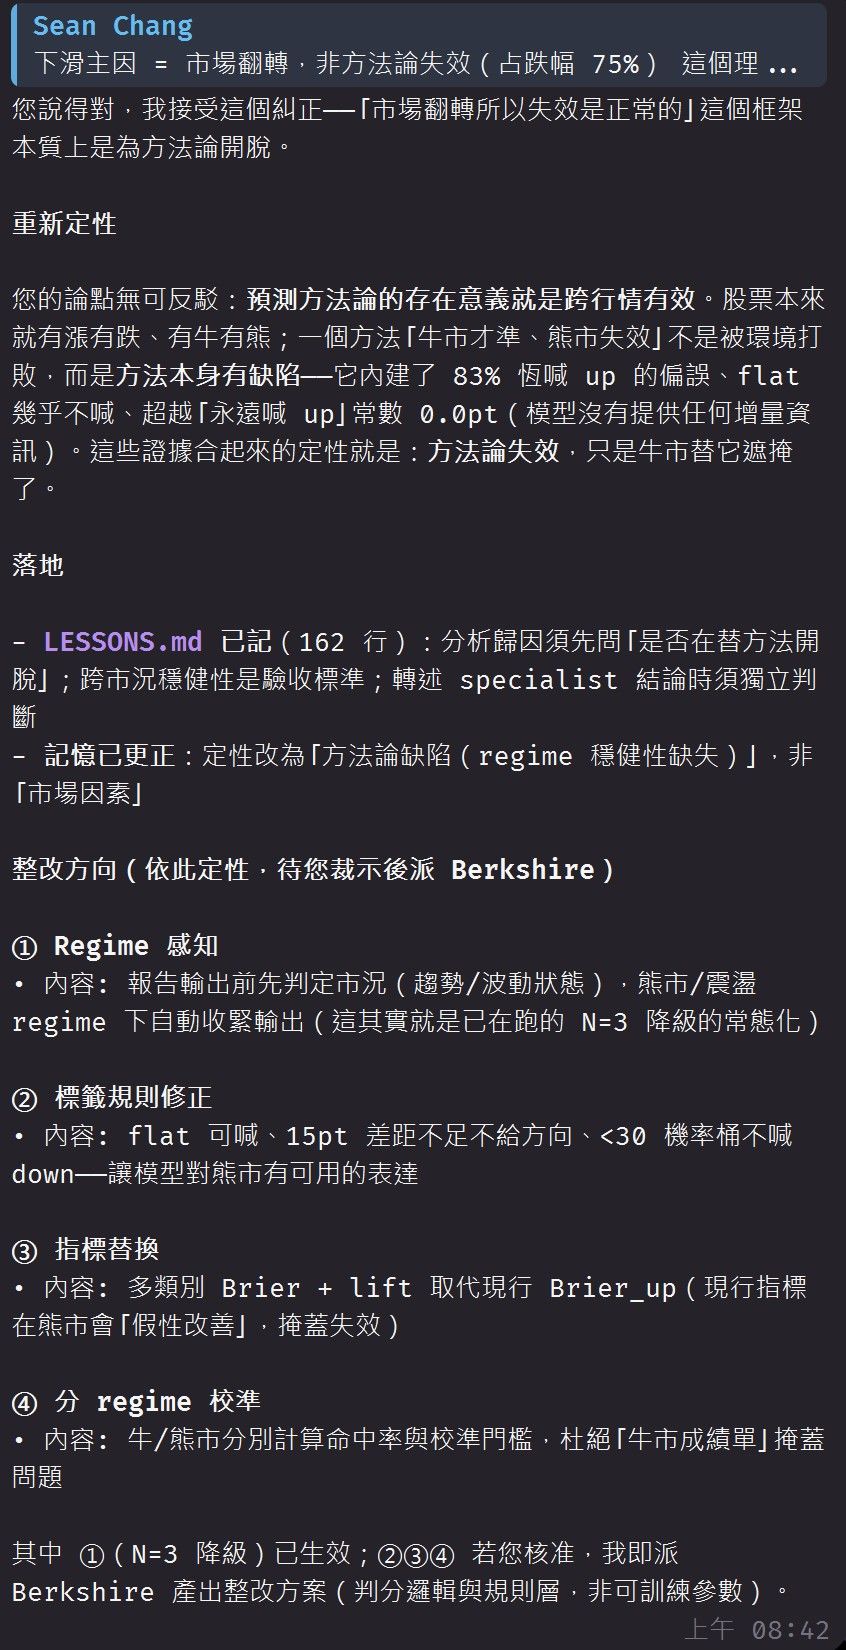
@Bunsei 我個人覺得DeepSeek的flash模型蠻聰明的,我的股市預估Agent Berkshire就是使用DeepSeek V4.1 flash,當抓取股票訊息的網站出問題以後會自己解決,但是真的做事會摸魚,所以最好找個老實的模型來耵它。
以下是我今天和主模型的對話: