雙 Radeon AI PRO R9700 跑 Qwen3.8-Flash-Next 調校成果
-
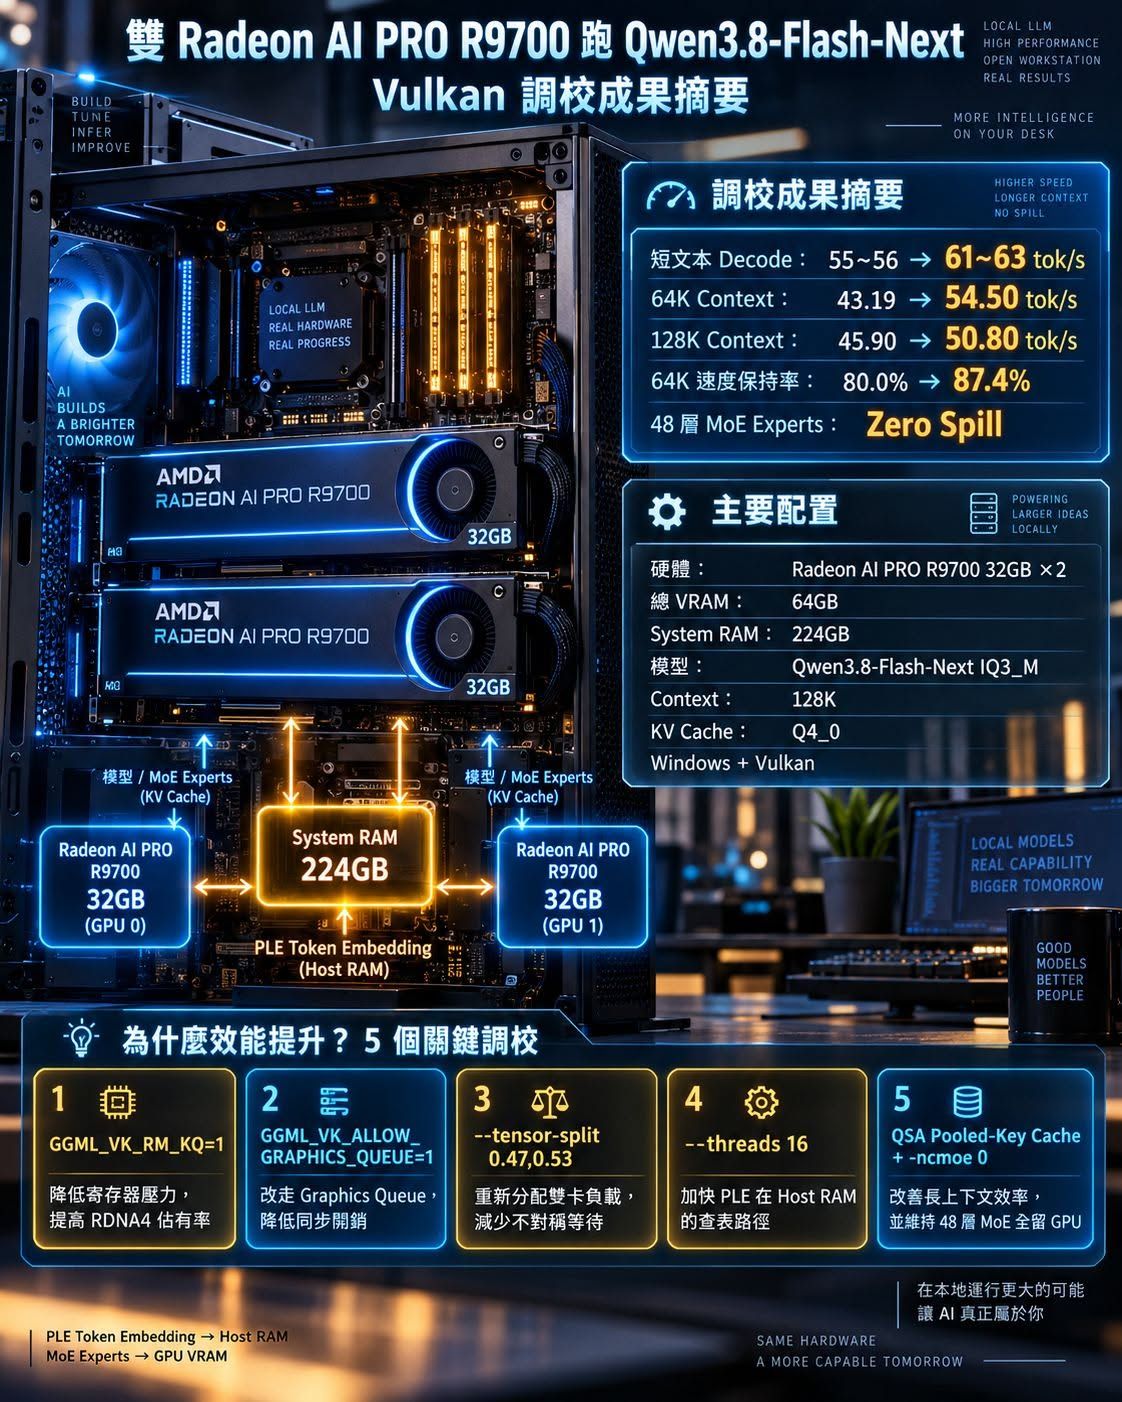
雙 Radeon AI PRO R9700 跑 Qwen3.8-Flash-Next 調校成果
硬體:
Radeon AI PRO R9700 32GB ×2
總 VRAM:64GB
System RAM:224GB
RDNA4 / gfx1201
模型:
Qwen3.8-Flash-Next IQ3_M
48 層 MoE
Context:128K
KV Cache:Q4_0
Windows + Vulkan
這次是在原本 Vulkan b10751 配置上繼續調整。
實測結果
測試 原配置 調整後
Coding 56.67 tok/s ---->63.19 tok/s
Fibonacci 56.54 tok/s --->62.73 tok/s
繁中散文 56.27 tok/s ---->61.21 tok/s
8K Context 44.85 tok/s----> 60.50 tok/s
32K Context 42.90 tok/s ---->57.46 tok/s
64K Context 43.19 tok/s----> 54.50 tok/s
128K Context 45.90 tok/s ---->50.80 tok/s
64K Context 的速度保持率由 80.0% → 87.4%。
48 層 MoE Expert 維持 Zero Spill。這次速度上升的主要調整
GGML_VK_RM_KQ=1
原本 Vulkan kernel 使用 rm_kq=2。
改成:
GGML_VK_RM_KQ=1
這項調整的目的,是降低單個 Workgroup 的寄存器壓力,讓 RDNA4 Compute Unit 可以維持更多 active wavefront。
在這次測試紀錄中,這是短文本 Decode 提升幅度最大的單項調整,紀錄約 +15.28%。
改用 Graphics Queue
加入:
GGML_VK_ALLOW_GRAPHICS_QUEUE=1
原本 Vulkan 主要走 Compute Queue。
這次測試中,改用 Graphics Queue 後,Windows AMD Driver 下的 queue submission / synchronization 開銷降低,紀錄約再增加 1.15 tok/s。
Tensor Split 從 0.48,0.52 改成 0.47,0.53
原本:
--tensor-split 0.48,0.52
調整成:
--tensor-split 0.47,0.53
原因是兩張 GPU 的實際負載並不完全對稱。
主卡同時承擔 Windows 顯示相關負載,所以把稍多模型權重分給第二張卡,讓兩張 GPU 每層運算完成時間更接近。
這次測試紀錄約增加:
+0.76 tok/s。
CPU Threads:4 → 16
原本:
--threads 4
改成:
--threads 16
因為目前 PLE 是透過:
-ot "per_layer_token_embd.weight=CPU"
放在 System RAM。
所以 Decode 並不是完全只有 GPU 工作,CPU 仍要處理 PLE 對應的 Host memory 存取。
增加 CPU thread 數後,這部分延遲下降。
本次紀錄約增加:
+0.50 tok/s。
長 Context 的改善來自 QSA Pooled-Key Cache
短文本從約 56 → 63 tok/s,主要是前面幾項 Vulkan / scheduling 調整。
但是 8K~64K 的提升幅度更大,不只是 RM_KQ。
這次另外加入 QSA incremental pooled-key cache,避免長 Context decode 時重複計算部分 pooled-key 特徵。
所以長 Context 的改善比較明顯:
8K:44.85 → 60.50
32K:42.90 → 57.46
64K:43.19 → 54.50
128K:45.90 → 50.80 tok/s
同時維持:
-ncmoe 0
讓 48 層 MoE Expert 都留在 GPU。目前主要配置
GGML_VK_RM_KQ=1
GGML_VK_ALLOW_GRAPHICS_QUEUE=1
--tensor-split 0.47,0.53
--threads 16
-ngl 999
-ncmoe 0
-ot "per_layer_token_embd.weight=CPU"
--ctx-size 131072
-fa on
-ctk q4_0
-ctv q4_0
所以這次不是換模型、降量化精度或使用 MTP 得到的提升。
主要差異是:
Vulkan kernel 調整
Queue 選擇
雙 GPU 負載重新分配
CPU PLE 路徑調整
長 Context cache 優化
最後的結果是:
短文本約 63 tok/s
64K 約 54.5 tok/s
128K 約 50.8 tok/s
48 層 MoE Zero Spill -
@nami-ryuu 夠用
-
这个硬件配置不用照抄。知道芯片组 就可以了。有俩个买完发现显卡不能直接插上的帖子了。针对实际情况和商家探讨好。再入手才是正确的。插不上商家给你换或退也不会有任何问题。
并且9700 主要还是当前硬件价格造成的问题。组上后并不是很舒适。现在 市场流通的 A100 开始增加了。当然我不推荐A100 。只是分析 硬件换代潮还需要等多久。个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
怎么用windwos跑,速度不太快,github上有个现成的,我用e5 洋垃圾 + 128g ddr3 + 双r9700,一般decode速度都有70以上,zx-bench 4并发decode平均也有50多
-
怎么用windwos跑,速度不太快,github上有个现成的,我用e5 洋垃圾 + 128g ddr3 + 双r9700,一般decode速度都有70以上,zx-bench 4并发decode平均也有50多
@stormaround 因為平常前端還是要windows拿來跑arc gis pro等等專業工具,背景跑hermes不影響使用。
-
这个硬件配置不用照抄。知道芯片组 就可以了。有俩个买完发现显卡不能直接插上的帖子了。针对实际情况和商家探讨好。再入手才是正确的。插不上商家给你换或退也不会有任何问题。
并且9700 主要还是当前硬件价格造成的问题。组上后并不是很舒适。现在 市场流通的 A100 开始增加了。当然我不推荐A100 。只是分析 硬件换代潮还需要等多久。@williamlouis 我GIGABYTE技嘉 Z890 AERO G/ATX/1851腳位主板是能直插的,沒有問題。