【硬核实测】12GB 显存的极限救赎:我的 MiniMax H3 本地生成与 4K 超分工作流
-
适用人群:
- 想跑 MiniMax H3 / Ref2VA / FL2VA
- 想做长视频、动作戏、打斗、镜头衔接
- 想在有限显存下追求画质最大化
🟥 为什么 12GB 显存也能跑长视频?
AI 视频推理显存需求动辄 24GB+,但通过 精度压缩、分段推理、显存碎片管理、软硬件分治,12GB 卡依然能做到:
- 长视频分段生成(>60 秒)
- 高动态动作戏稳定推理
- 4K 超分放大(RTX VSR)
- 画质不衰减的连续镜头
下面是完整的工作流拆解。
🟦 一、硬件与环境约束
 ️ 核心配置
项目 配置 GPU RTX 5070(12GB VRAM) CPU Ryzen 5700X RAM 64GB 存储 SSD (48GB虚拟内存)
 稳定策略:功耗墙锁死 80%
锁功耗墙的好处:
- 避免瞬时电流尖峰导致黑屏
- 显存颗粒温度更低
- 长时间推理不掉帧
- 显卡寿命更健康
- 性能下降不足5%
🟦 二、模型与推理工作流(ComfyUI)
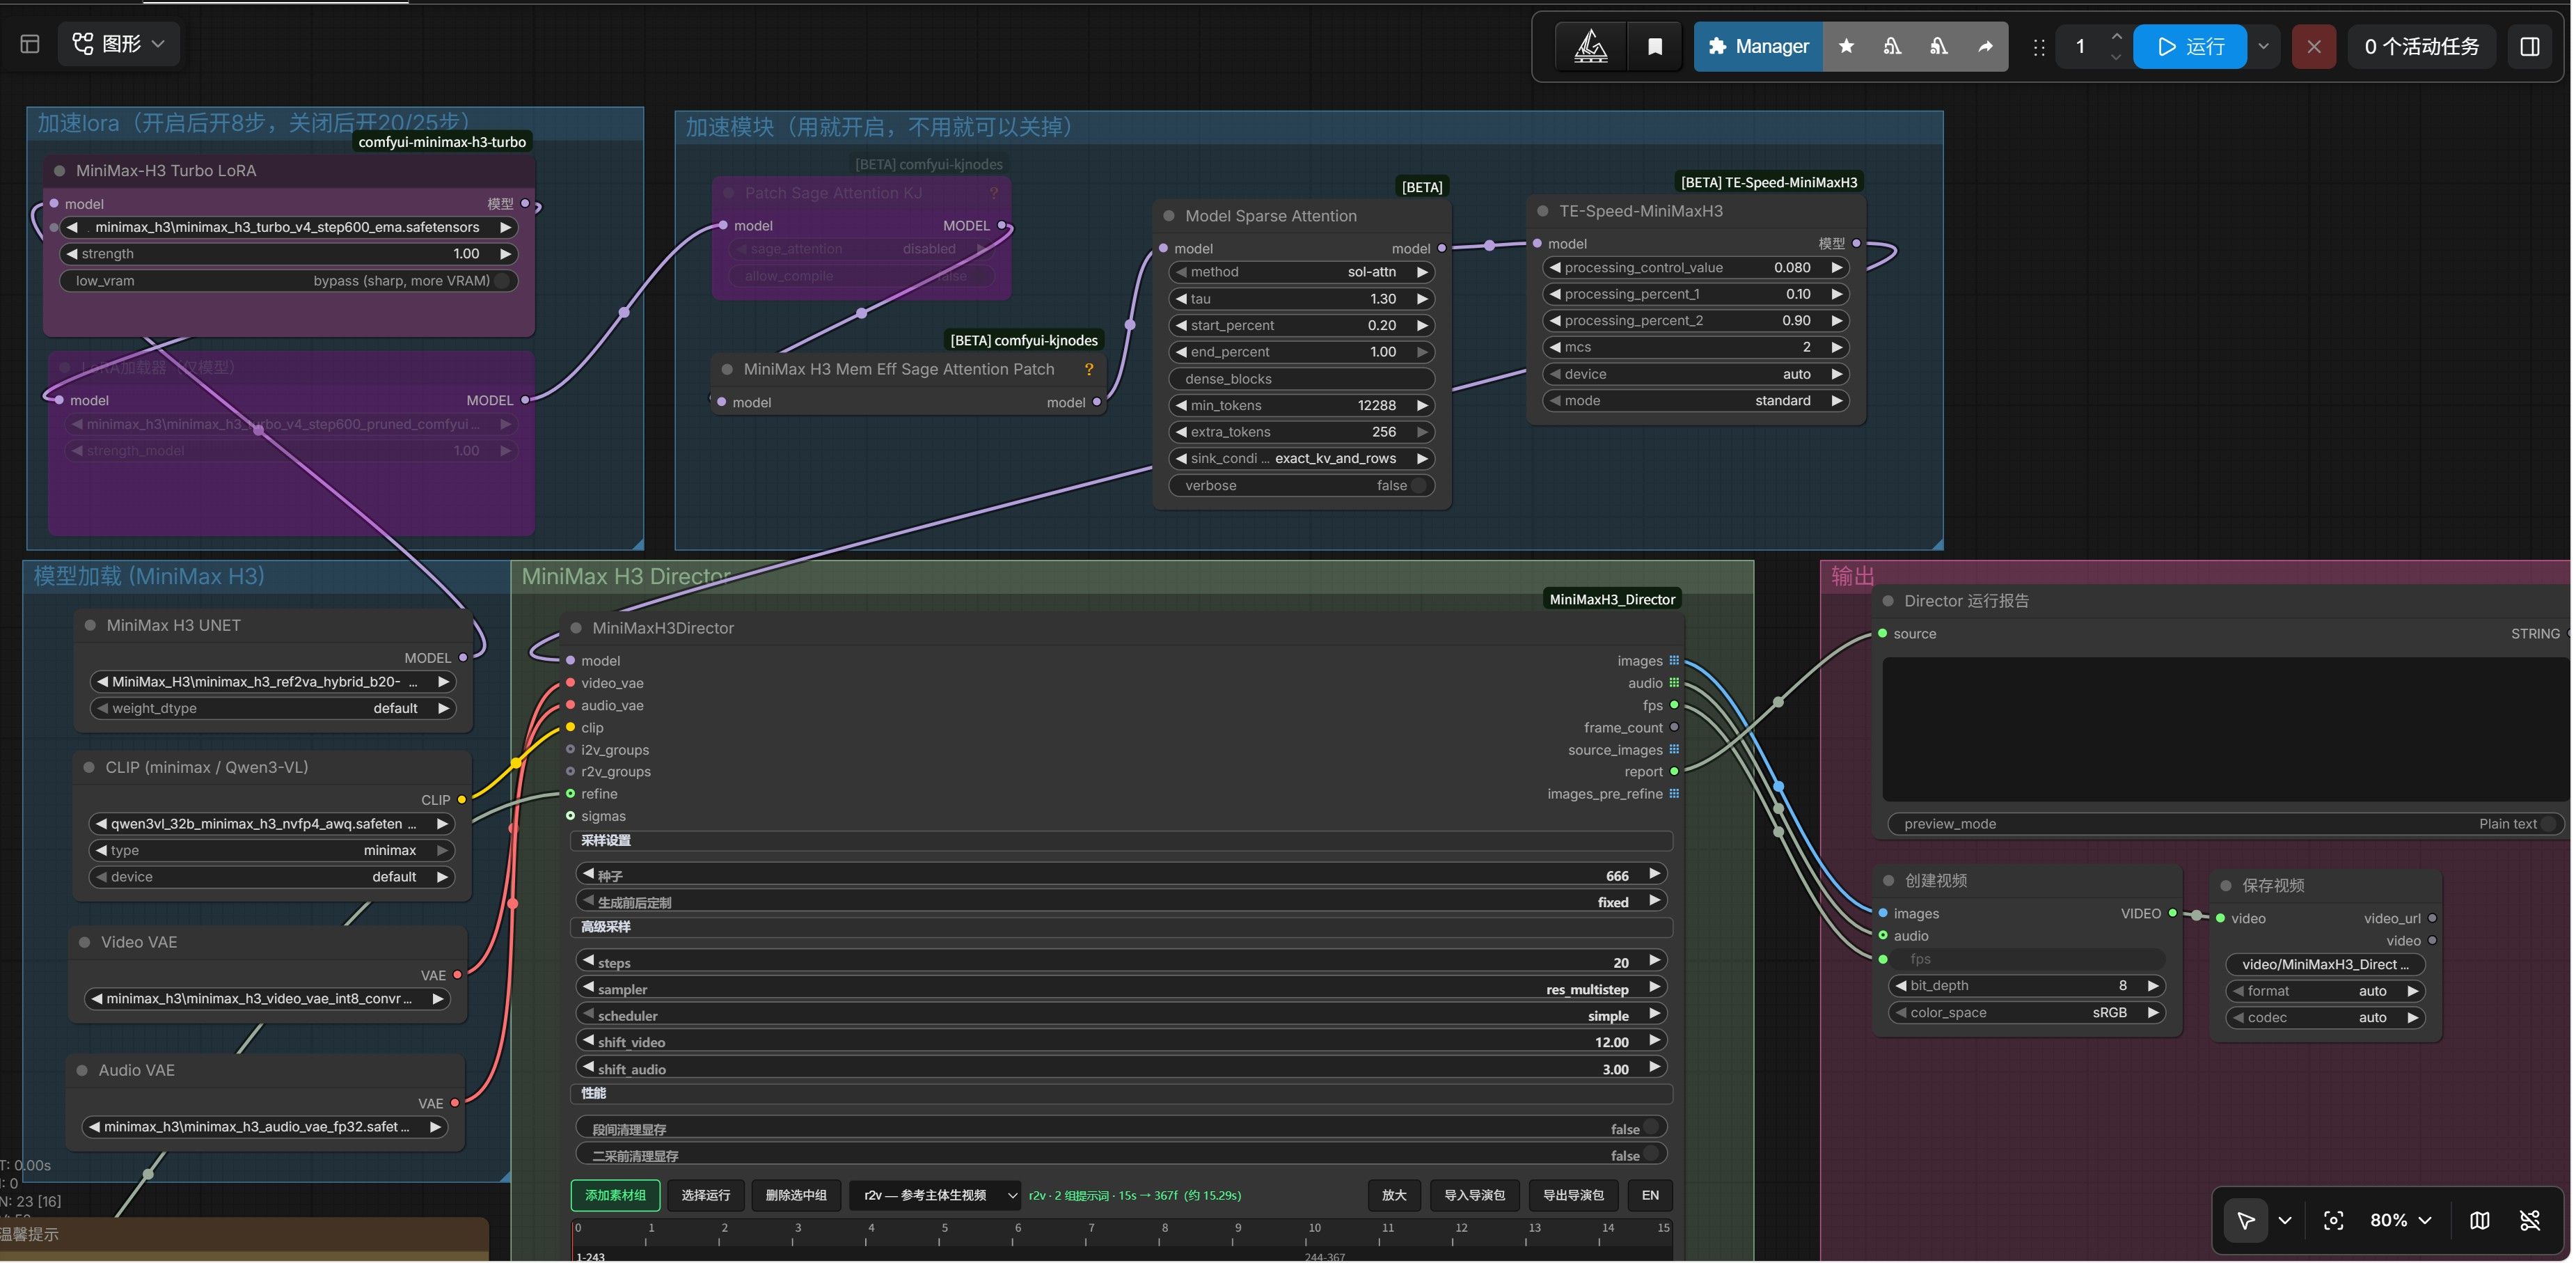
🧬 1. 混合权重(Hybrid)
兼顾 Ref2VA 的可控性 与 FL2VA 的画质:
minimax_h3_ref2va_hybrid_b20-49_pruned_w4a8_mixed.safetensors
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
minimax_h3_video_vae_int8_convrot.safetensors
minimax_h3_audio_vae_fp32.safetensors
加速 LoRA:
minimax_h3_turbo_v4_step600_ema.safetensors
 ️ 2. 精度方案:W4A8(黄金分割点)
精度 显存占用 画质 推荐度 FP16 高 优秀  12GB 不稳
INT8 ConvRot 中 良好  可用
W4A8 低 良好  最佳平衡
NVFP4 低 良好 50系专用
 3. 加速引擎
- MiniMax H3 Mem Eff Patch / Sage Attention Patch
- Block Sparse Attention
- TE-Speed-MiniMaxH3 (3.5+)
三者组合可减少 35–50% 推理时间。
 4. 动态步数策略
场景类型 步数 10 秒0.5M视频推理时间 文戏 / 静态 6-step ~150s 动作戏 / 打斗 8-step ~200s
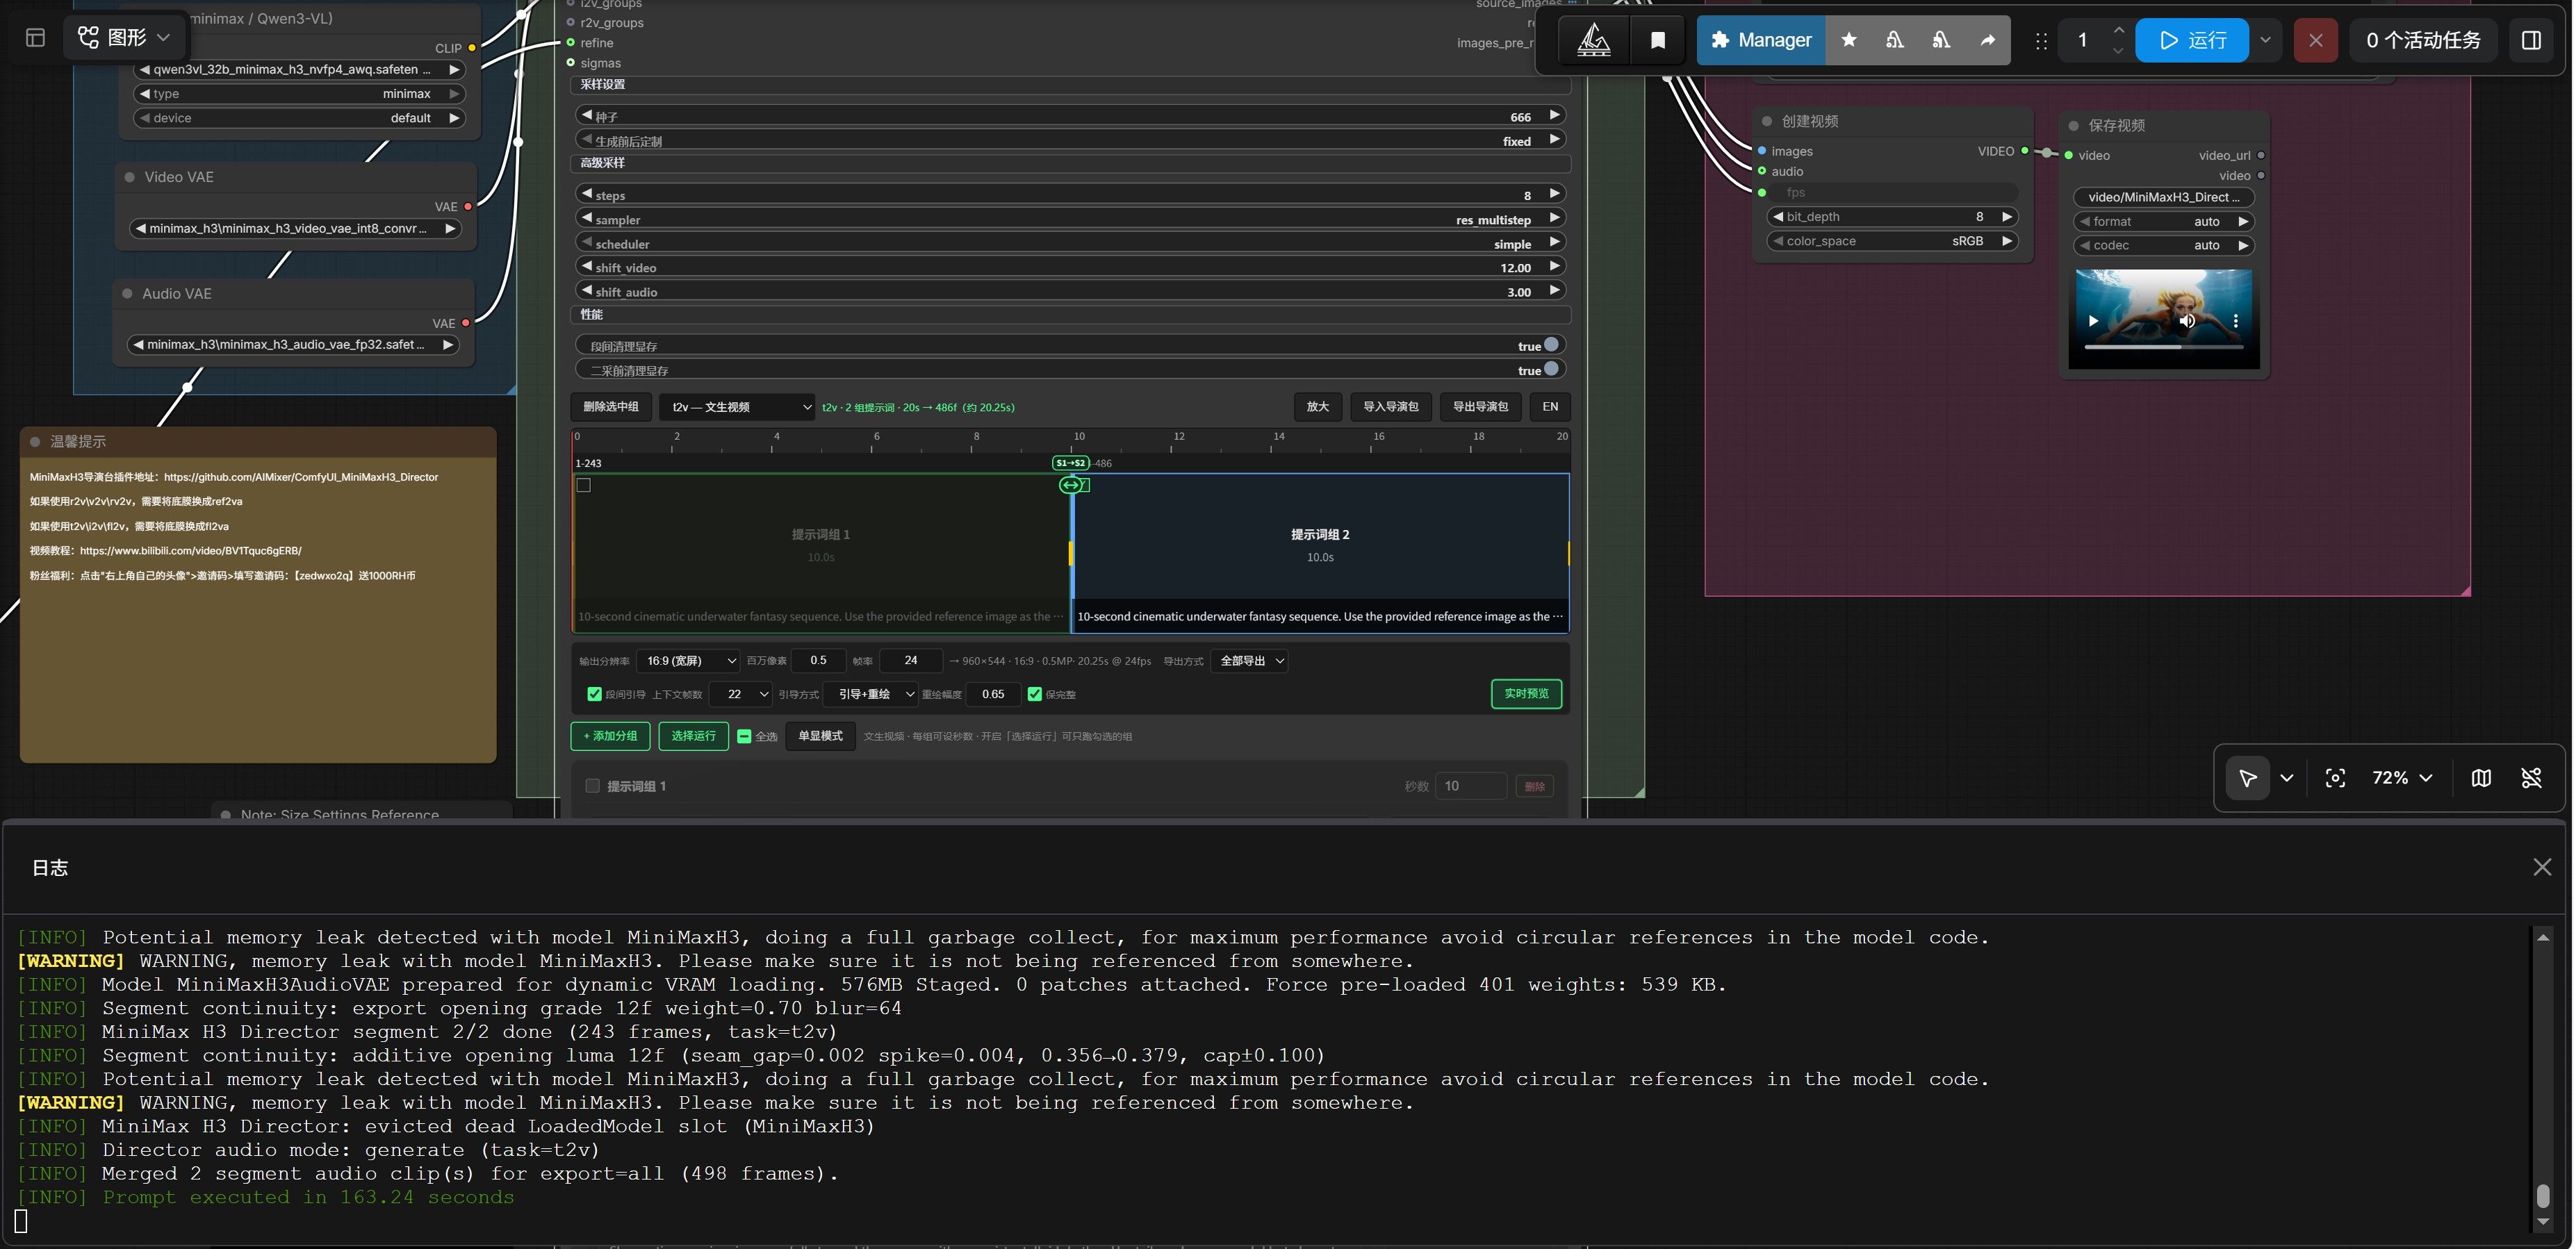
 5. 分段生成 + 引导重绘策略(长视频关键)
核心逻辑:
- 使用“minmax h3 导演台”节点进行分段
- 每段生成 10 秒 视频
- 下一段以上一段的 尾帧 作为视频和声音引导
- 重绘幅度设为 0.65
建议:勾选每段生成后清理一次显存。
效果:
- 动作连续性提升一个档次
- 长视频画质不衰减
- 镜头衔接自然无跳帧
🟦 三、画质放大与修复(The “4K Strategy”)
目标: 在不进行离线 4K 推理的情况下,最终输出依然达到 4K 观感。
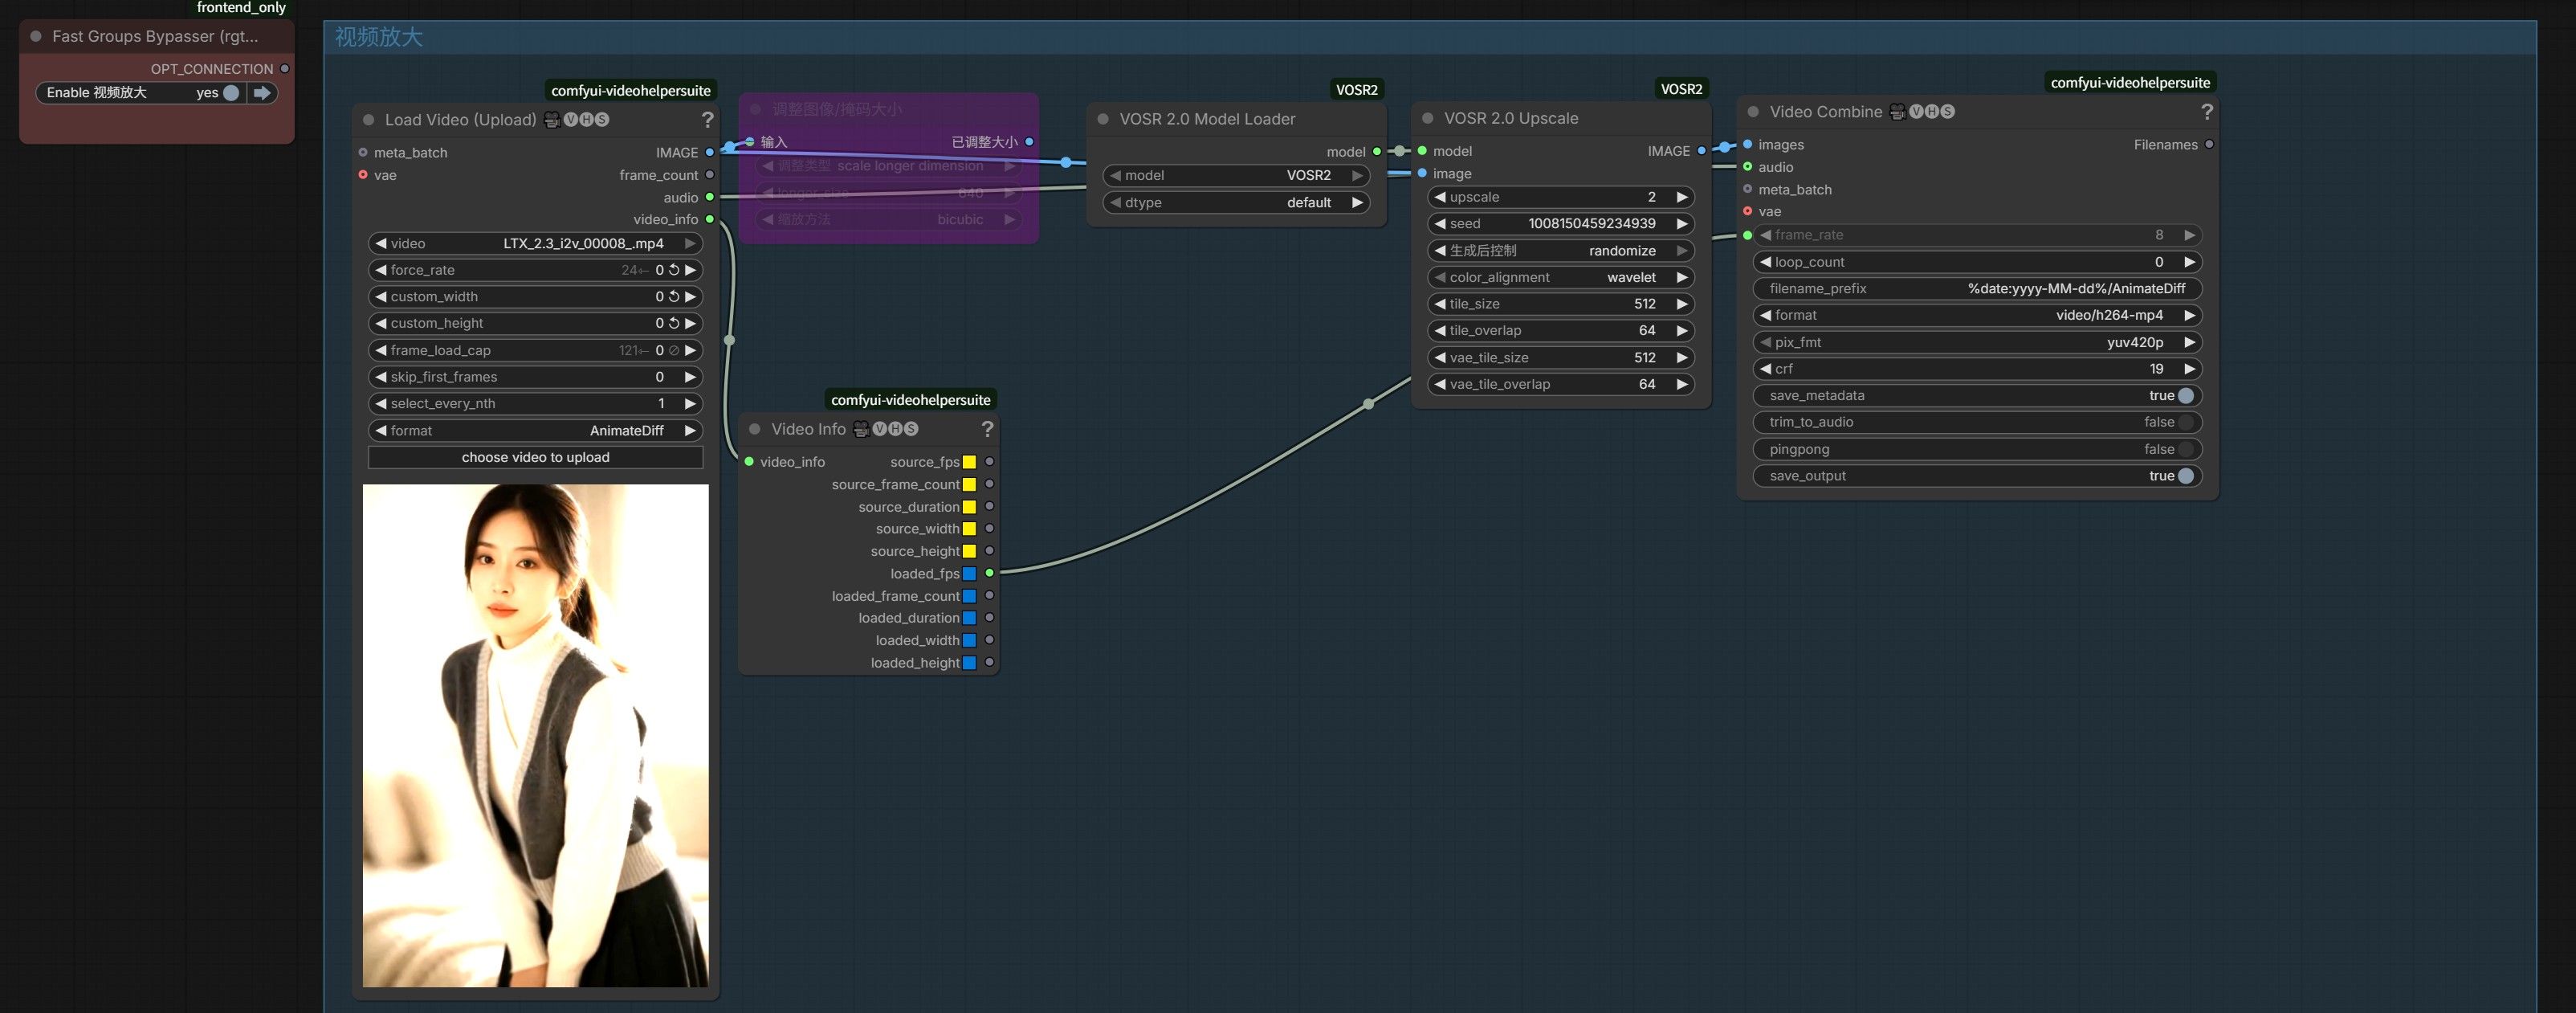
🧩 第一阶段:视频质量修复(VOSR 2.0)
输入:960×544
输出:1080pVOSR 的优势:
- 修复硬线条
- 修复文字
- 修复人物皮肤
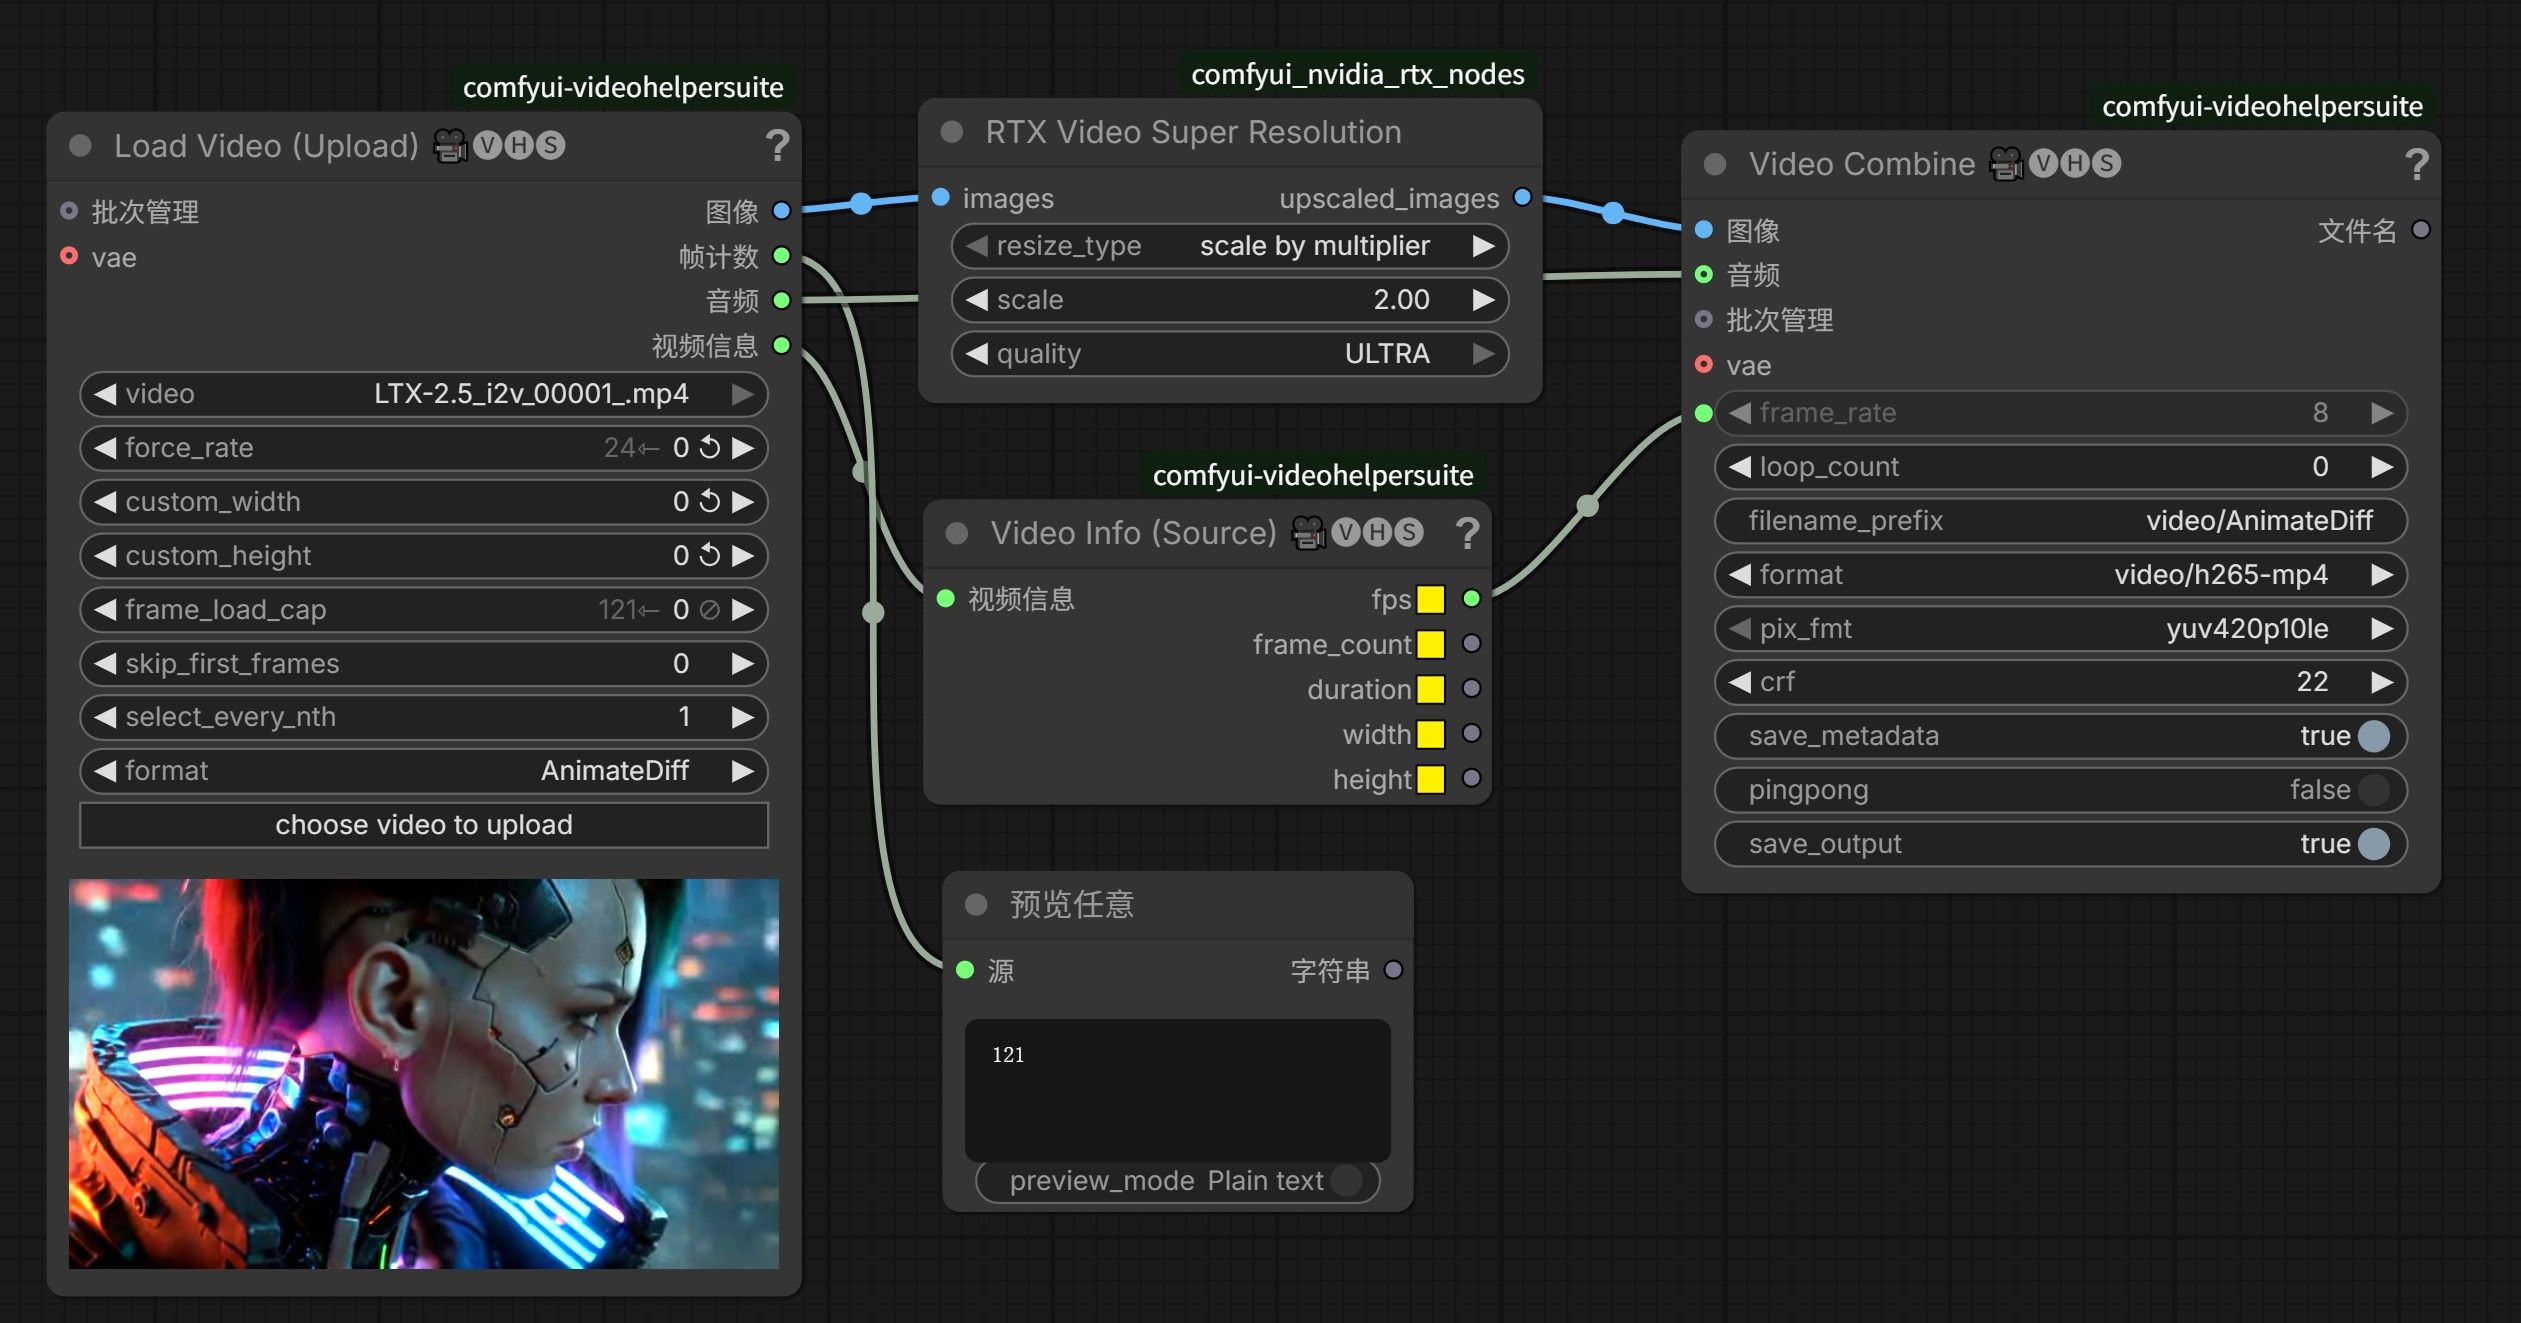
 第二阶段:视频超分放大(RTX VSR)
RTX+Video+Super+Resolution视频放大
输入:1080p
输出:4K- 基于 TensorRT 引擎
- 几乎不占显存
- 画质提升显著
- 适合长视频放大
🟩 四、最终总结
即使只有 12GB 显存:
- 通过 W4A8 精度压缩
- 加速LORA
- 分段重绘策略
- VOSR + RTX VSR 两段式增强
依然可以实现:
- 长视频生成
- 动作戏稳定推理
- 4K 观感输出
- 画质不衰减的连续镜头
如果你也在用 50 系列或 40 系列显卡跑 MiniMax H3,欢迎在评论区分享你的工作流参数。
-
12GB 能做长视频这点没问题,W4A8 + 分块稀疏 + 顺序卸载这套是对的。但有两处得说清楚,不然容易误导后面的人:
- RTX VSR 是显示端的视频增强,做的是更好看的放大,不是生成式细节重建。4K 输出会更锐,但原始帧里没有的信息它补不出来,「画质不衰减」不成立。真要 4K 细节,得上生成式超分(SUPIR / SeedVR2)或高分辨率重绘,代价是显存和时间都按帧算。
- 锁 80% 功耗墙换稳定是对的(压瞬态尖峰),但代价不止 5%:prefill 和大 batch 段会明显吃算力,只有 decode 段(带宽瓶颈)几乎无感。评估时把 prefill 与 decode 分开测。
另外分段生成 60 秒以上,段与段之间建议用首尾帧 + 上段末帧做条件,否则动作戏跨段容易跳。工作流如果放出来可以贴一下,我按上面几条帮你对一遍。
-
-
-
-
-
-
 T terry 于 将此主题固定
-
NV的生态好。拿到流都可以试试。
Windows下也可以直接上。
操作:
1.安装 comfy UI
2.拖拽 工作流 到 web 页面
3.点击报错页面 选择一键下载全部缺失内容(正常是模型,节点都可以一次解决)。下载失败可能是你的VPN的问题。 -
系统 于 取消固定此主题
-
,
 P perter 引用了 此主题
-
,P perter 引用了 此主题
-
-
-
感谢分享!我做的是第一人称写实短片(每集约 2.5–3 分钟),也是 H3 + ComfyUI 官方节点,路子不太一样,贴一下我们的流程互相参考:
一、硬件
- 云端单张 RTX 4090 24G(按小时租),一条命令:上传素材 → 排队生成 → 下载 → 自动关机
- 新台式机 5080 16G 快到了,到了转本地
二、生成
- 模型:fl2va 剪枝版 int8 + qwen3vl nvfp4 + 官方 turbo LoRA 8 步,单种子
- 分辨率 1024×576,一条 8–10 秒(4090 上 8 秒约 4–5 分钟)。成片只出 720p,所以不往上放大
- 每条都是「首帧 + 尾帧 + 控制视频」:
- 首尾关键图先用生图模型画好,同一场景的图并排核对(门、窗、灯、人物衣服要一致)
- 走路、转头、惊吓点这些镜头,先在 3D 里搭灰盒、走一遍机位,导出深度视频,用官方控制网 Union 2.0 控制。门框、墙、人的位置逐帧都很稳,这是我们最依赖的一步
- 机位刚好和线稿对得上的镜头,也会用线稿控制
三、修片(最近实测)
- 视频局部重绘(控制网的 mask + source_video):一条整体都好、只有一块坏(比如玻璃后面多画了人、字走近时变形),只给那块画遮罩重画,其他部分和原片一致。比整条重跑好用多了:同种子重跑会把同一个毛病原样再生一遍
- 官方 AddGuide 接上一段末尾 22 帧:能解决两条拼接时的「停一下再猛走」,但我们遇到接点附近闪一帧、过一会儿曝光突然跳一下、声音没接上。看了楼主推荐的导演台和它致谢的 Motion Context,才知道原因:用 mp4 当引导要解码再编码一轮,声音也要从接点往回接。准备改成从 latent 截尾再测
- Layout 方框控制:人几秒走到哪、几秒鞠躬,能卡得很准(误差约 0.2 秒),但只能和深度二选一,镜头会完全不动,所以我们只在固定机位用
四、后期和检查
- 声音全部后期做(脚步跟着画面的前进速度走),做旧成老式家用摄像机的质感
- 每条都用脚本检查跳帧、停帧、接缝位移和亮度;整片再让一个不知道剧情的审片代理看一遍,确认看得懂、哪里对不上
几个问题请教:
- 导演台好像没有控制视频(深度/线稿)的入口?我们的镜头基本离不开深度控制
- 有人试过 Motion Context 和 Fun ControlNet 一起用吗?
- 楼上有人提到剪枝版细节弱、写实和文字要用完整版 int8,有人拿完整版配 Union 2.0 控制网跑过吗?
以上 经验分享 请指教。
-
-

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!