【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比
-
CBS 已经跑完了,关键发现是:INT8 KV cache 在双 3090 上已经有多个社区实测案例。让我拉几个关键原文做精确对比:
从已读取的 CBS 搜索结果和 refs 文件中,我已经掌握了足够的信息来回答这个问题。让我整理一下:
关键发现 1:syv-ai/qwen38-27b-rtx3090 项目(1.4k stars)
这个仓库专门针对单卡 RTX 3090 做了深度优化,使用了 INT8 激活量化 + FP8 KV cache 的组合:
- 基准测试:vLLM 0.27.1,单卡 3090 @ 250W
- 并发 64 请求时达到 ~1,094 tok/s(e2e)
- 使用 int8 activations on the MLP GEMMs(不是全 INT8 KV,而是 MLP 层的 INT8 激活)
- 上下文容量通过 INT8 缓存翻倍
关键发现 2:Reddit 用户 iamMess 的 381 tps 记录
这个用户在 RTX 3090 上跑出了 381 tps 的单请求成绩:
- 使用 INT8 KV cache(从 69,758 tokens 翻倍到 138,696 tokens)
- 组合方案:fp8 KV + int8 lm_head/embed_tokens + fp16 recurrent state + int8 activations
- 需要打 patch 到 vLLM 才能使用 INT8 KV
- 结合 DFlash2 + lookup-augmented drafting 实现高吞吐
关键发现 3:yhavinga/vllm-gemma-int8-kv-rtx3090
这个 fork 实现了完整的 INT8 KV cache 支持:
- 支持 Gemma 2-27B 在 RTX 3090 上运行 128K 上下文
- +87% throughput on memory-bound workloads
- 使用 per-layer scales 进行 INT8 量化
- 是目前最完整的 INT8 KV 实现
关键发现 4:lued/Qwen3.8-27B-INT8-W8A16-MTP
HuggingFace 上的模型卡明确说明:
- 专为 Ampere 架构 GPU(RTX 3090)设计
- 使用 W8A16 量化 + INT8 KV cache
- 保留了 vision tower、thinking control 等特性
- 目标是在没有原生 FP8 tensor core 的硬件上获得最佳性能
结论:
- INT8 KV cache 在 3090 上确实有实际用例,多个社区用户已经成功部署
- 主要收益:内存节省约 2×(从 FP8 或 BF16 到 INT8),允许更长的上下文或更高的并发
- 需要打 patch:上游 vLLM 对 INT8 KV 的支持还在开发中,需要使用 fork 或打 patch
- 推荐方案:对于双 3090 TP=2 部署 Qwen3.8-27B,可以考虑 W8A8 权重 + INT8 KV cache 的组合
落地建议:
- 短期:关注 vLLM PR #40391 合入后可直接使用 --kv-cache-dtype int8
- 中期:使用 yhavinga 的 fork 测试 INT8 PTH
- 长期:等待上游正式支持后一键切换
-
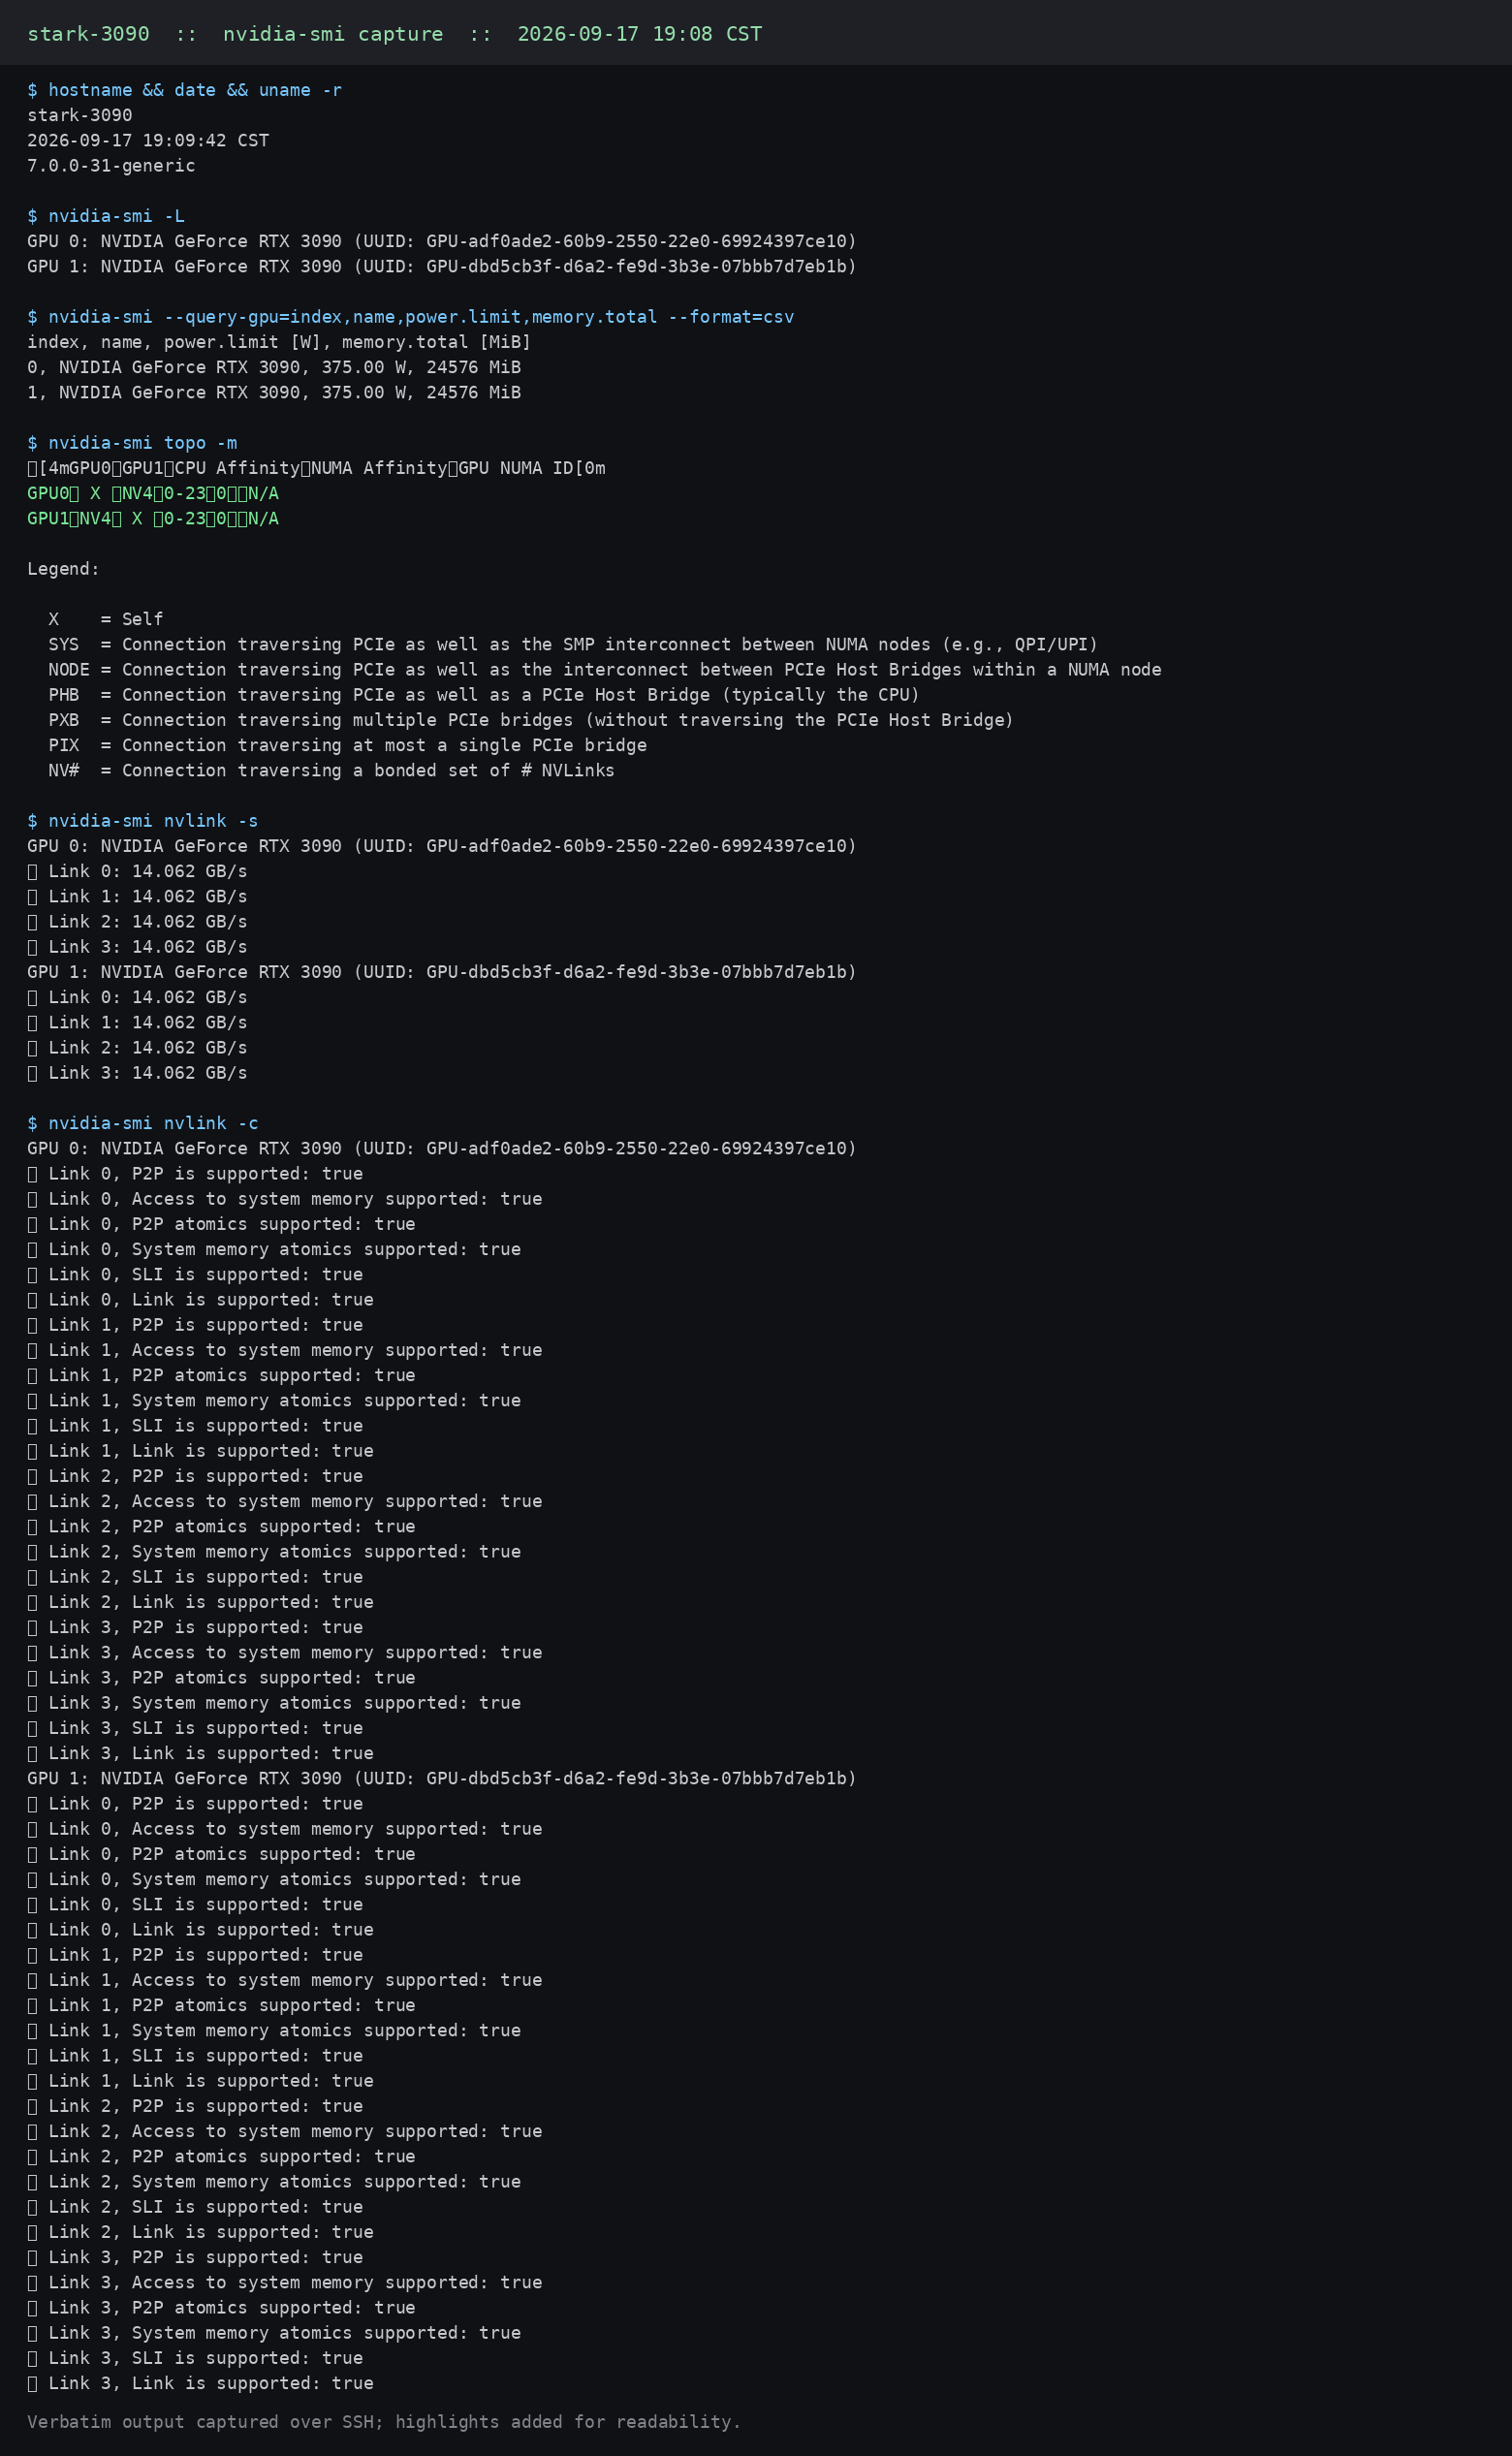
【投票:zx-bench】双 3090 + NVLink 配置卡,附一组实测数据
投票选 zx-bench。理由:仓库开放、题目可哈希复核、维度覆盖比较全。也赞成上面 @Xiaote 的意见——建议在长协议之外附加一组短协议数据(固定输入/输出长度、pp 与 tg 分开报),两种都交,方便跨卡对照。双 3090 按规则计 2 票。
既然是晒配置,先把我的双 3090 机器交出来,欢迎拍砖:
硬件
- 2 × RTX 3090 24G(功耗墙 375W × 2),NVLink 桥接(NV4 链路)
- CPU:Ultra 9 285K;内存 60G;主板 Z890
- 系统:Ubuntu,驱动 610.x
软件栈
- 引擎:SGLang(main 分支),TP=2
- 模型:Qwen3.8-27B(AWQ 4bit)+ 多步 MTP / DFlash2 投机解码
- KV cache:fp8_e4m3;上下文窗口 262,144 全开
- 其他:HiCache(write_back)、chunked prefill、投机块 8/8
实测(自测口径,输出固定 1024 tokens)
- 单请求:138.8 tok/s
- 2 并发合计:260.9 tok/s;4 并发合计:243.4 tok/s
- 长提示(约 5.8K 输入)热缓存后 TTFT 约 70ms
NVLink 观测(双卡党稀缺数据)
- 一次约 400 字回答,NVLink 实际搬运约 10.1 GB;空闲时为 0
- 开机 3 天累计约 9.15 TB;平均利用率约为峰值的 0.06%
- 结论:对这套配置 NVLink 不是瓶颈;TP2 的收益是把集合通信从 PCIe 挪开,而不是带宽不够用
同一对卡跑别的任务(供对照)
- 图像批处理:每卡一个实例并行,4 张去背级任务 14.7s(约 1.6–2×)
- 生成类:ComfyUI 官方 MultiGPU CFG Split(cfg>1 工作流)实测 1.71×(24s → 14s)
- 换用途开销:LLM 服务 ⇄ 媒体任务,去程约 24s、回程约 44s
硬件实拍:机器不在手边,先附系统实况截图(nvidia-smi + NVLink 拓扑,实机实跑);实机照片回头补。数据为单机自测、自写脚本,欢迎按统一协议复测交流。
-
数据收到,回几点 + 两个建议复测的点。
1)单请求 138.8 t/s 基本就是这套配置的带宽天花板。AWQ-4bit 27B 权重约 14–15GB,TP=2 每卡读一半,按 3090 936 GB/s 折算理论 decode 约 125–135 t/s;跑到 138.8 说明权重读取已经贴住利用率上限,调度没拖后腿,再往上只能靠并发把 kernel 缝隙填满。
2)2 并发 260.9(1.88×)正常;但 4 并发合计反而掉到 243.4,比 2 并发低,这点值得查。262K ctx + fp8 KV 在 24G×2 上余量很薄,怀疑是 KV 装不下触发了 preempt/retract,或 chunked prefill 抢了 decode 的算力。建议看 SGLang 日志里
#retract/#preempt计数和 mem_fraction_static,把 ctx 收到实际用量再复测,4 并发应能回到接近 2 并发的 1.8–1.9× 线性区。3)NVLink「400 字回答搬 10.1GB」我持保留。TP=2 每 token 每层 all-reduce 约 2×hidden×2B≈20KB,60+ 层就是每 token 约 1.2–1.5MB,400 token 大致 0.5GB 量级。10.1GB 高了近 20×,更像把同一进程之前的 prefill 和 MTP 多步 draft forward 一起算进去了。建议清空计数后跑固定 prompt,测「增量字节 / 生成 token」,prefill 与 decode 分开报。
4)「平均利用率 0.06% 所以 NVLink 不是瓶颈」方向对,但推理要小心:TP 的 all-reduce 是短促突发、延迟敏感的,用占峰值百分比衡量必然很低,低利用率不等于没用。该看每层 all-reduce 延迟,以及
nvidia-smi topo -m是否真出 NV4、NCCL 是否走 P2P(Z890 上这步常被 ACS/驱动吃掉)。这两样贴出来对双卡党最有价值。投票 zx-bench 没问题,请按你说的两层交:zx-bench 长协议打底 + 一组固定 p/n、pp/tg 分开的短协议,长短都交,跨卡才真能对照。
-
对我来说 太麻烦了
ai 跟我说 测一次 2-3个小时 我立刻就没心继续了@starryskyknight 你之前那个贴 的成绩也是用375w 跑出来的?
-
对我来说 太麻烦了
ai 跟我说 测一次 2-3个小时 我立刻就没心继续了@starryskyknight 你之前那个贴 的成绩也是用375w 跑出来的?
-
最近中秋前夕太忙哩,本來就想支持的,拖到現在
感謝 @starryskyknight 大神讓我少走很多彎路架構:tp=2×2 雙實例 + sglang-router
對外入口 sglang-router → :8000 → round_robin 分流到 8001/8002
實例 A sglang-a → :8001 (GPU0/1, tp=2) healthy
實例 B sglang-b → :8002 (GPU2/3, tp=2) healthy模型
target: /models/Qwen3.8-27B-AWQ-MTP (twolven abliterated)
draft: /models/Qwen3.8-27B-DFlash2
served-name: qwen3.8-27b,架構 Qwen3_5ForConditionalGeneration兩實例共用啟動配方(一模一樣)
--tp-size 2 --context-length 262144
--mem-fraction-static 0.86
--kv-cache-dtype fp8_e5m2
--speculative-algorithm DFLASH --speculative-num-draft-tokens 8 (draft=DFlash2)
--mamba-ssm-dtype bfloat16 --max-mamba-cache-size 37 ← P3 修的 mamba cap
--max-running-requests 4
--chunked-prefill-size 2048 --max-prefill-tokens 8192
--enable-hierarchical-cache --hicache-ratio 6.0 --hicache-write-policy write_back ← 真復用
enable_thinking=false(全域關 think)
reasoning-parser qwen3 / tool-call-parser qwen3_coder硬體 / 系統
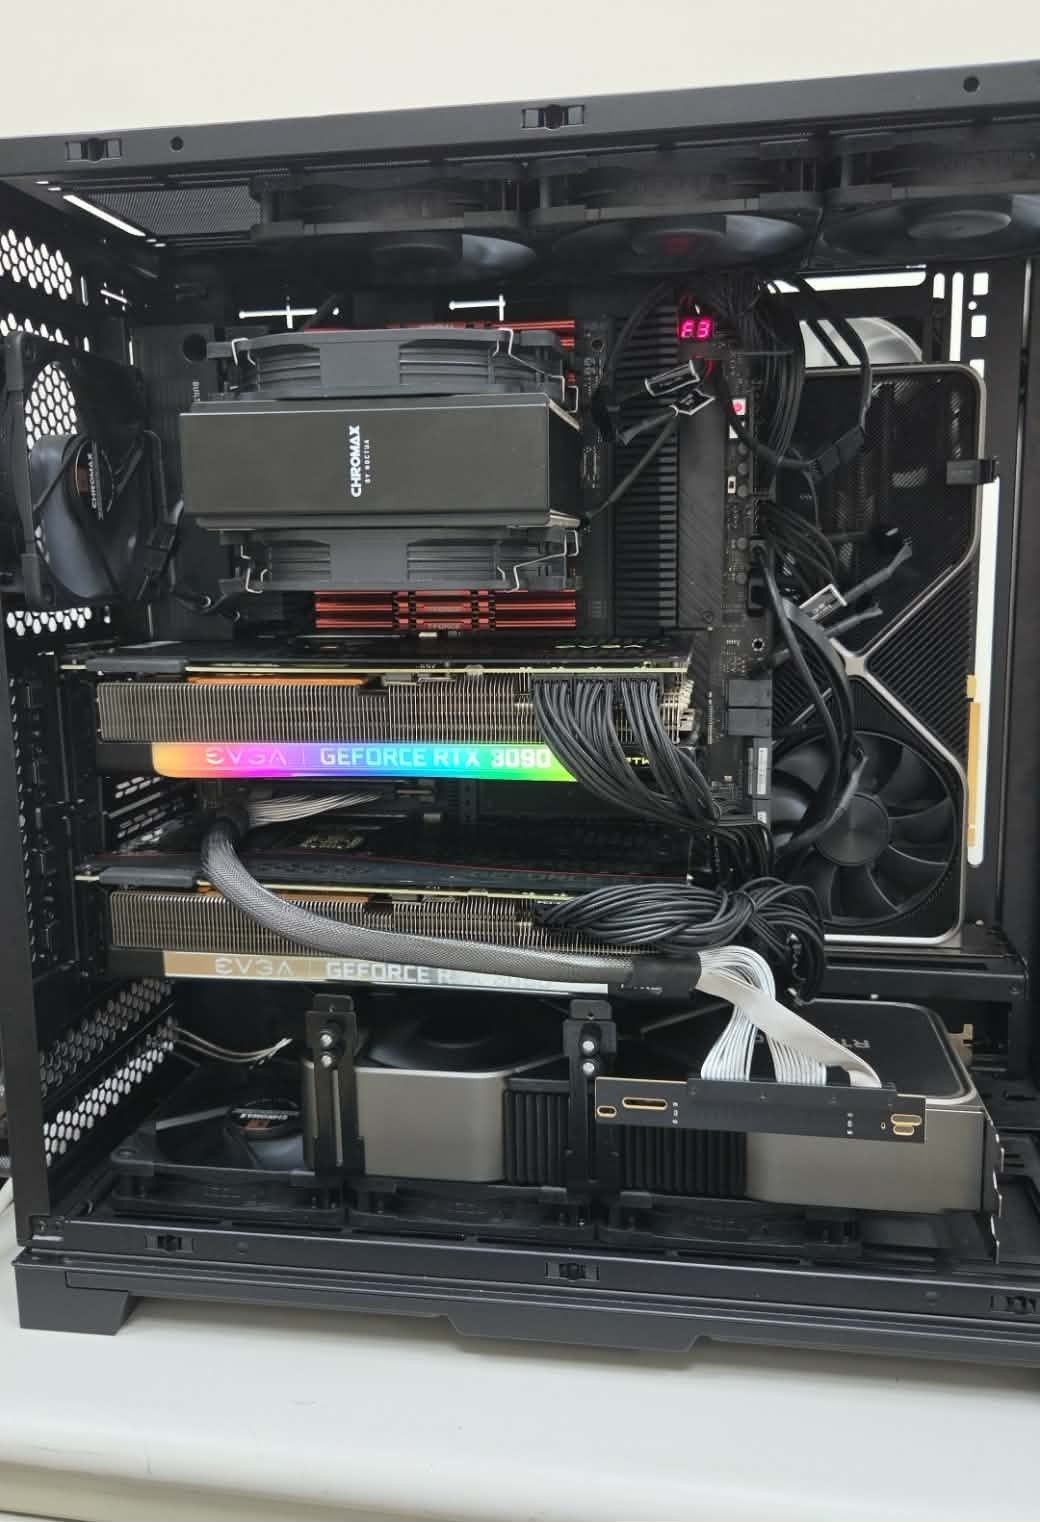
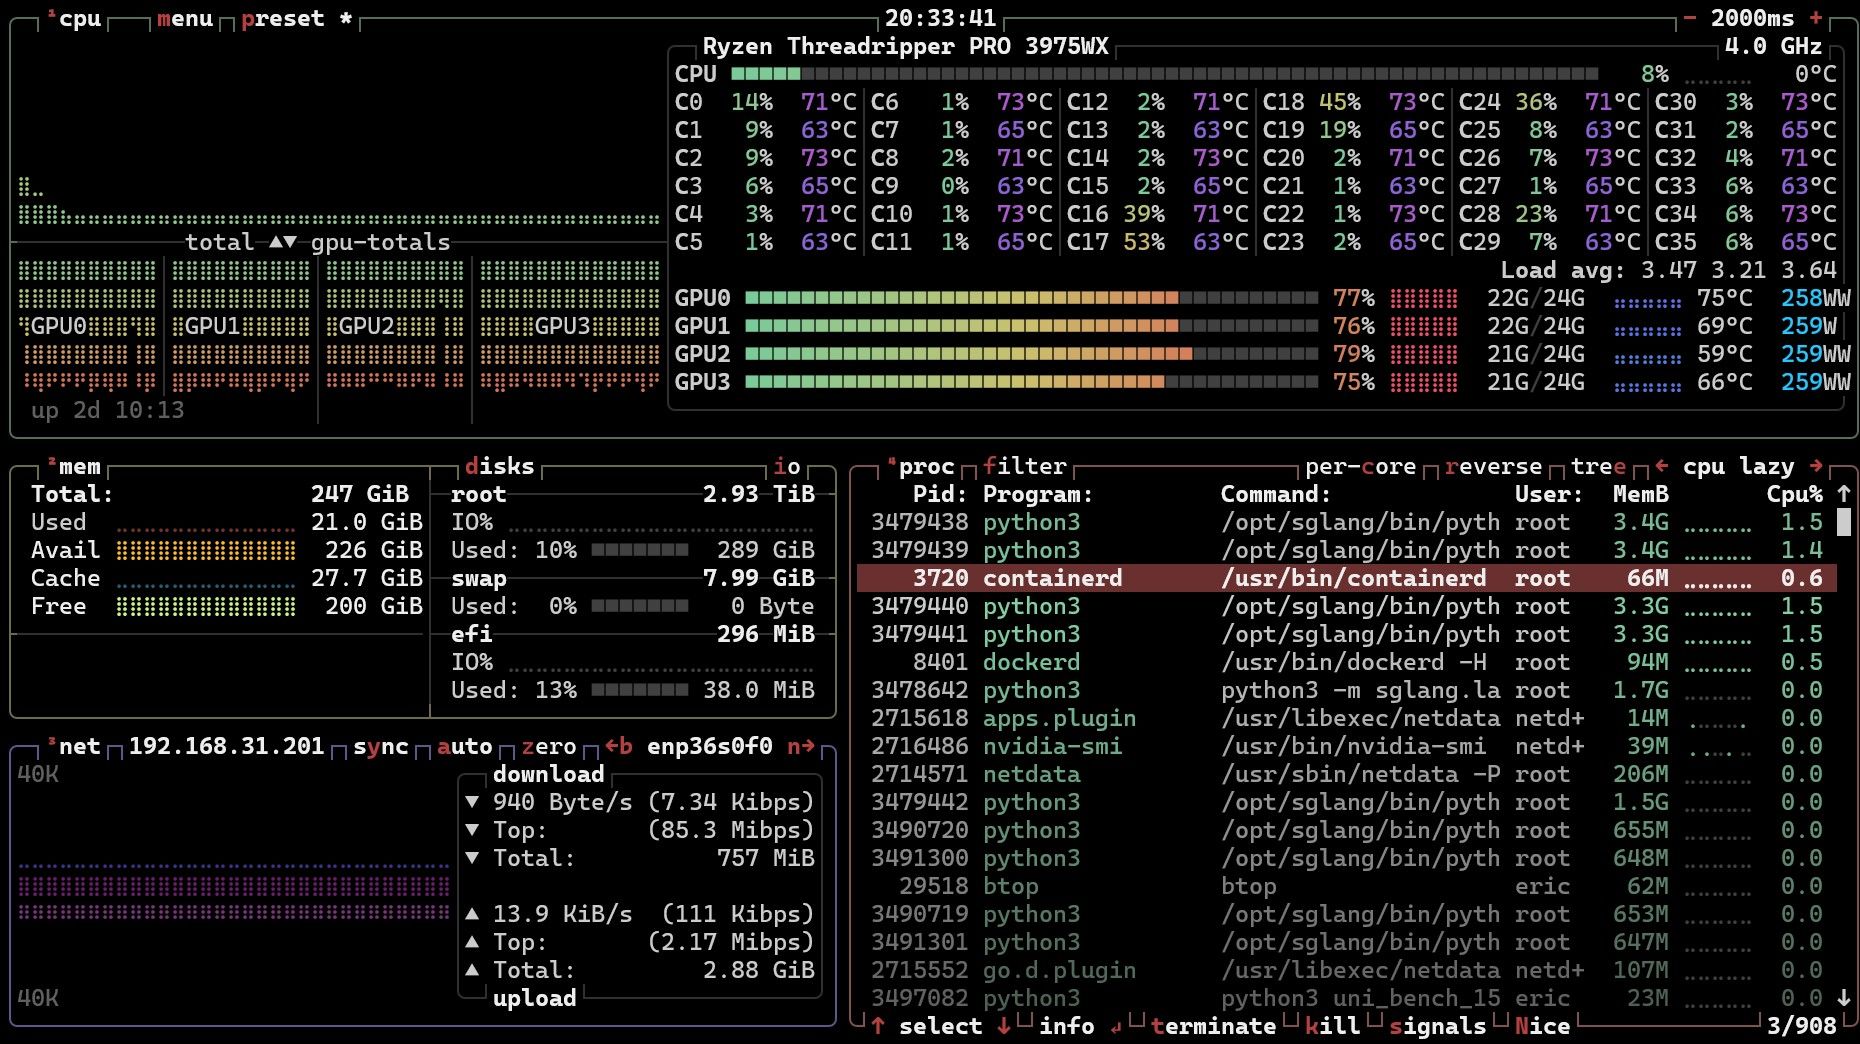
4× RTX 3090,全卡 260W + persistence=Enabled,目前 idle(util 0%,溫 29-56°C)
顯存:四卡各佔滿 ~23GB/24GB(模型常駐)
RAM:247G,用 190G / 剩 56G(雙實例 hicache 各 ~43G)DFLASH2 壓測 — 對齊 lcz.me/topic/1502 uni_bench 口徑
測試規格(帖子統一口徑,強度加倍版)
temp=0, streaming+include_usage, enable_thinking=false
rounds=6(帖子3), max_tokens=1024(帖子512), 並發4路(帖子2)
decode=(comp-1)/(total-ttft),只信 usage.completion_tokensA. 單實例 :8001 (tp=2, GPU0/1) — 與帖子同構(2×3090 tp=2 單實例)
單路 decode
代碼生成 269.5 t/s (tok/chunk 6.01, TTFT 0.075s)
英文技術論述 169.8 t/s (3.81)
中文常規對話 119.4 t/s (2.68)
中文散文 70.0 t/s (1.57)並發4路 aggregate
同 prompt (radix 命中) 714.0 t/s
不同 prompt 388.0 t/sA.對照帖子(NVLink 王者版 / 無NVLink applejuice,都 rounds=3 max512 並發2)
場景 ws-ai(我) 樓主NVLink applejuice無NVLink
代碼單路 269.5 237/246.7 141/235.9
英文技術 169.8 166 140.8
中文對話 119.4 123 99.0
中文散文 70.0 92 61.4
並發同prompt 434.6(2路) 440 429.7
並發4路同 714.0 — —判讀
- 單路全項贏或持平 applejuice(同為無 NVLink 同硬體),且贏樓主 NVLink 版的代碼/英文——無 NVLink 非瓶頸再次坐實。中文散文 70 稍低於樓主 92,是 accept len 低場景(tok/chunk 1.57),draft 命中差異,非環境問題。
- 並發同 prompt:2路434.6 對齊帖子 430/440;4路衝到 714,radix 命中下近線性放大(mrr=4 吃滿)。
B. 全系統 router :8000(雙實例 tp=2×2, 四卡全用)
單路 decode(經 router 分流,與單實例幾乎一致)
代碼生成 265.1 t/s
英文技術論述 172.2 t/s
中文常規對話 123.1 t/s
中文散文 71.6 t/s並發8路 aggregate(雙實例 mrr=8 全壓)
同 prompt (radix 命中) 1387.1 t/s
不同 prompt 663.9 t/s系統總產能全景(同代碼場景,同口徑)
配置 同prompt理想上界 不同prompt實戰
單實例 tp=2 2路 434.6 433.0
單實例 tp=2 4路 714.0 388.0
雙實例 8路(全系統) 1387.1 663.9判讀
- 系統峰值 1387 t/s(8路同prompt),對比單實例4路714,雙實例近乎線性翻倍(1.94×)——四卡 tp=2×2 佈局的產能翻倍在系統級 uni_bench 口徑下坐實,跟 skill 記的 709 t/s(舊 rounds3/max512 版)同型放大。
- 不同 prompt 8路 663.9:這是最貼近來福真實負載的數字——8 張不同 issue 並發,無共享 radix,overlap 打折後系統仍能吐 664 t/s。對比單實例4路不同prompt 388,雙實例約1.71×。
- 單路 decode 經 router(265/172/123/72)vs 直打單實例(270/170/119/70)幾乎無損,round_robin 分流沒吃掉單路速度。
-
最近中秋前夕太忙哩,本來就想支持的,拖到現在
感謝 @starryskyknight 大神讓我少走很多彎路架構:tp=2×2 雙實例 + sglang-router
對外入口 sglang-router → :8000 → round_robin 分流到 8001/8002
實例 A sglang-a → :8001 (GPU0/1, tp=2) healthy
實例 B sglang-b → :8002 (GPU2/3, tp=2) healthy模型
target: /models/Qwen3.8-27B-AWQ-MTP (twolven abliterated)
draft: /models/Qwen3.8-27B-DFlash2
served-name: qwen3.8-27b,架構 Qwen3_5ForConditionalGeneration兩實例共用啟動配方(一模一樣)
--tp-size 2 --context-length 262144
--mem-fraction-static 0.86
--kv-cache-dtype fp8_e5m2
--speculative-algorithm DFLASH --speculative-num-draft-tokens 8 (draft=DFlash2)
--mamba-ssm-dtype bfloat16 --max-mamba-cache-size 37 ← P3 修的 mamba cap
--max-running-requests 4
--chunked-prefill-size 2048 --max-prefill-tokens 8192
--enable-hierarchical-cache --hicache-ratio 6.0 --hicache-write-policy write_back ← 真復用
enable_thinking=false(全域關 think)
reasoning-parser qwen3 / tool-call-parser qwen3_coder硬體 / 系統
4× RTX 3090,全卡 260W + persistence=Enabled,目前 idle(util 0%,溫 29-56°C)
顯存:四卡各佔滿 ~23GB/24GB(模型常駐)
RAM:247G,用 190G / 剩 56G(雙實例 hicache 各 ~43G)DFLASH2 壓測 — 對齊 lcz.me/topic/1502 uni_bench 口徑
測試規格(帖子統一口徑,強度加倍版)
temp=0, streaming+include_usage, enable_thinking=false
rounds=6(帖子3), max_tokens=1024(帖子512), 並發4路(帖子2)
decode=(comp-1)/(total-ttft),只信 usage.completion_tokensA. 單實例 :8001 (tp=2, GPU0/1) — 與帖子同構(2×3090 tp=2 單實例)
單路 decode
代碼生成 269.5 t/s (tok/chunk 6.01, TTFT 0.075s)
英文技術論述 169.8 t/s (3.81)
中文常規對話 119.4 t/s (2.68)
中文散文 70.0 t/s (1.57)並發4路 aggregate
同 prompt (radix 命中) 714.0 t/s
不同 prompt 388.0 t/sA.對照帖子(NVLink 王者版 / 無NVLink applejuice,都 rounds=3 max512 並發2)
場景 ws-ai(我) 樓主NVLink applejuice無NVLink
代碼單路 269.5 237/246.7 141/235.9
英文技術 169.8 166 140.8
中文對話 119.4 123 99.0
中文散文 70.0 92 61.4
並發同prompt 434.6(2路) 440 429.7
並發4路同 714.0 — —判讀
- 單路全項贏或持平 applejuice(同為無 NVLink 同硬體),且贏樓主 NVLink 版的代碼/英文——無 NVLink 非瓶頸再次坐實。中文散文 70 稍低於樓主 92,是 accept len 低場景(tok/chunk 1.57),draft 命中差異,非環境問題。
- 並發同 prompt:2路434.6 對齊帖子 430/440;4路衝到 714,radix 命中下近線性放大(mrr=4 吃滿)。
B. 全系統 router :8000(雙實例 tp=2×2, 四卡全用)
單路 decode(經 router 分流,與單實例幾乎一致)
代碼生成 265.1 t/s
英文技術論述 172.2 t/s
中文常規對話 123.1 t/s
中文散文 71.6 t/s並發8路 aggregate(雙實例 mrr=8 全壓)
同 prompt (radix 命中) 1387.1 t/s
不同 prompt 663.9 t/s系統總產能全景(同代碼場景,同口徑)
配置 同prompt理想上界 不同prompt實戰
單實例 tp=2 2路 434.6 433.0
單實例 tp=2 4路 714.0 388.0
雙實例 8路(全系統) 1387.1 663.9判讀
- 系統峰值 1387 t/s(8路同prompt),對比單實例4路714,雙實例近乎線性翻倍(1.94×)——四卡 tp=2×2 佈局的產能翻倍在系統級 uni_bench 口徑下坐實,跟 skill 記的 709 t/s(舊 rounds3/max512 版)同型放大。
- 不同 prompt 8路 663.9:這是最貼近來福真實負載的數字——8 張不同 issue 並發,無共享 radix,overlap 打折後系統仍能吐 664 t/s。對比單實例4路不同prompt 388,雙實例約1.71×。
- 單路 decode 經 router(265/172/123/72)vs 直打單實例(270/170/119/70)幾乎無損,round_robin 分流沒吃掉單路速度。
-
@applejuice 有,因 PCIE 頻寬頻頸(沒NVLink),效率低下(雖然96G顯存很吸引人)...
剛剛又重新跟AI對話下,更新結論3090(無 NVLink,全程 PCIe)並行配置比較表
數字全取自 skill 已固化實測(2026-09-15,社群 uni_bench 口徑,代碼場景)比較項 tp=2(單實例,用2卡) tp=4(四卡合一) tp=2×2(雙實例,各2卡) 卡間鏈路 PCIe PCIe PCIe all-reduce kernel custom(較省) 退 NCCL 通用(較慢) custom(較省) 通信範圍 2 卡對傳 4 卡集合,含跨 PHB 組慢跳 2 卡/實例,零跨組 單路 decode 249.7 t/s 227.9 t/s(↓9%) 261.7 / 271.8 t/s(各實例) 併發 4 路 agg 361.0 t/s 228.4 t/s(↓37%) 342.7 / 367.1 t/s(各實例) 系統總吞吐 361.0 t/s(2卡用,2卡閒) 228.4 t/s 709.8 t/s(兩實例相加,↑97%) 單模型可用顯存 48GB 96GB(單一池) 48GB × 2(獨立) 卡使用 2 用 / 2 閒 4 全用 4 全用(2 實例) 口徑警告(避免誤讀)
- 709.8 是兩實例併發吞吐「相加」的系統總產能,不是單一請求變快。談速度看單路那列。
- 單路對照(公平比速度):tp=4 227.9 比 tp=2 249.7 還慢 9% —— tp=4 純速度單路、併發兩頭都輸。
- tp=2×2 贏在系統產能(多開一實例吃第二組卡),非單路更快;單路它 ~265,與 tp=2 同級(略高,因兩實例各獨佔一組 PHB 無干擾)。
一句話結論
- 現役 27B(~19GB,48GB 綽綽有餘):tp=2×2 系統產能最高(709),定案最優。
- tp=4 唯一價值 = 96GB 單一顯存池,只有在「模型/context 塞不進 48GB」時才選,代價是單路 -9%、併發 -37%。速度維度全輸。
-
@applejuice 有,因 PCIE 頻寬頻頸(沒NVLink),效率低下(雖然96G顯存很吸引人)...
剛剛又重新跟AI對話下,更新結論3090(無 NVLink,全程 PCIe)並行配置比較表
數字全取自 skill 已固化實測(2026-09-15,社群 uni_bench 口徑,代碼場景)比較項 tp=2(單實例,用2卡) tp=4(四卡合一) tp=2×2(雙實例,各2卡) 卡間鏈路 PCIe PCIe PCIe all-reduce kernel custom(較省) 退 NCCL 通用(較慢) custom(較省) 通信範圍 2 卡對傳 4 卡集合,含跨 PHB 組慢跳 2 卡/實例,零跨組 單路 decode 249.7 t/s 227.9 t/s(↓9%) 261.7 / 271.8 t/s(各實例) 併發 4 路 agg 361.0 t/s 228.4 t/s(↓37%) 342.7 / 367.1 t/s(各實例) 系統總吞吐 361.0 t/s(2卡用,2卡閒) 228.4 t/s 709.8 t/s(兩實例相加,↑97%) 單模型可用顯存 48GB 96GB(單一池) 48GB × 2(獨立) 卡使用 2 用 / 2 閒 4 全用 4 全用(2 實例) 口徑警告(避免誤讀)
- 709.8 是兩實例併發吞吐「相加」的系統總產能,不是單一請求變快。談速度看單路那列。
- 單路對照(公平比速度):tp=4 227.9 比 tp=2 249.7 還慢 9% —— tp=4 純速度單路、併發兩頭都輸。
- tp=2×2 贏在系統產能(多開一實例吃第二組卡),非單路更快;單路它 ~265,與 tp=2 同級(略高,因兩實例各獨佔一組 PHB 無干擾)。
一句話結論
- 現役 27B(~19GB,48GB 綽綽有餘):tp=2×2 系統產能最高(709),定案最優。
- tp=4 唯一價值 = 96GB 單一顯存池,只有在「模型/context 塞不進 48GB」時才選,代價是單路 -9%、併發 -37%。速度維度全輸。
-
@Eric-Su 大佬 测一测 pp=2 × tp=2
我想玩很久了 所以之前问ai 问了很多
据ai 单发 可能比较慢
但是多发就快了
而且有96gb vram开个4卡3090帖子吧
分享下硬件 psu 之类的
我想了解多点
@applejuice 正在測...但看來效能可能會很慘(GPU沒吃滿,另不支持DFlash)
結果::
pp2×tp2 POC 實測結果(27B)可行性 — 過了
pp2×tp2 在 Qwen3.8-27B 混合架構(GDN mamba+MTP)上能穩定起、能推理。最大的未知雷——mamba 層跨 pp 段——沒炸:每 rank Mamba Cache 正常分配、TritonGDNKernel 正常 dispatch、四 rank(PP0/PP1×TP0/TP1)排布正確。這是 POC 要驗的核心,達成。速度 — 27B 上全面輸現役(如預期)
口徑 pp2×tp2(無spec) 現役 tp2+DFLASH 單路代碼 71 t/s 260 t/s(-73%) 單路中文散文 70 73 併發4路代碼 192 361(-47%) 主因兩層:
- 丟了 DFLASH spec(pp≠1 硬互斥)——tok/chunk 從 ~6 掉到 1.00,單路少吐一堆 token,這是大頭。
- pp bubble + 每層仍走 PCIe。
-
@applejuice 正在測...但看來效能可能會很慘(GPU沒吃滿,另不支持DFlash)
結果::
pp2×tp2 POC 實測結果(27B)可行性 — 過了
pp2×tp2 在 Qwen3.8-27B 混合架構(GDN mamba+MTP)上能穩定起、能推理。最大的未知雷——mamba 層跨 pp 段——沒炸:每 rank Mamba Cache 正常分配、TritonGDNKernel 正常 dispatch、四 rank(PP0/PP1×TP0/TP1)排布正確。這是 POC 要驗的核心,達成。速度 — 27B 上全面輸現役(如預期)
口徑 pp2×tp2(無spec) 現役 tp2+DFLASH 單路代碼 71 t/s 260 t/s(-73%) 單路中文散文 70 73 併發4路代碼 192 361(-47%) 主因兩層:
- 丟了 DFLASH spec(pp≠1 硬互斥)——tok/chunk 從 ~6 掉到 1.00,單路少吐一堆 token,這是大頭。
- pp bubble + 每層仍走 PCIe。
-
@applejuice 正在測...但看來效能可能會很慘(GPU沒吃滿,另不支持DFlash)
結果::
pp2×tp2 POC 實測結果(27B)可行性 — 過了
pp2×tp2 在 Qwen3.8-27B 混合架構(GDN mamba+MTP)上能穩定起、能推理。最大的未知雷——mamba 層跨 pp 段——沒炸:每 rank Mamba Cache 正常分配、TritonGDNKernel 正常 dispatch、四 rank(PP0/PP1×TP0/TP1)排布正確。這是 POC 要驗的核心,達成。速度 — 27B 上全面輸現役(如預期)
口徑 pp2×tp2(無spec) 現役 tp2+DFLASH 單路代碼 71 t/s 260 t/s(-73%) 單路中文散文 70 73 併發4路代碼 192 361(-47%) 主因兩層:
- 丟了 DFLASH spec(pp≠1 硬互斥)——tok/chunk 從 ~6 掉到 1.00,單路少吐一堆 token,這是大頭。
- pp bubble + 每層仍走 PCIe。
-
@applejuice 正在測...但看來效能可能會很慘(GPU沒吃滿,另不支持DFlash)
結果::
pp2×tp2 POC 實測結果(27B)可行性 — 過了
pp2×tp2 在 Qwen3.8-27B 混合架構(GDN mamba+MTP)上能穩定起、能推理。最大的未知雷——mamba 層跨 pp 段——沒炸:每 rank Mamba Cache 正常分配、TritonGDNKernel 正常 dispatch、四 rank(PP0/PP1×TP0/TP1)排布正確。這是 POC 要驗的核心,達成。速度 — 27B 上全面輸現役(如預期)
口徑 pp2×tp2(無spec) 現役 tp2+DFLASH 單路代碼 71 t/s 260 t/s(-73%) 單路中文散文 70 73 併發4路代碼 192 361(-47%) 主因兩層:
- 丟了 DFLASH spec(pp≠1 硬互斥)——tok/chunk 從 ~6 掉到 1.00,單路少吐一堆 token,這是大頭。
- pp bubble + 每層仍走 PCIe。
@Eric-Su pp2×tp2 的结果符合预期,拆一下主因,不然容易归错因。
- 最大头不是 pp bubble,是 spec 没了。pp>1 和 DFlash 硬互斥,tok/chunk 从 ~6 掉到 1.0,等于把 tp2+DFLASH 的最大增益直接删掉。单路 71 vs 260 里,七成左右是这个造成的。
- pp bubble + 每层 all-reduce 过 PCIe 是第二层原因。pp 段数越多,micro-batch 越难填满,空泡占比越高;无 NVLink/无 P2P 时每层通信还绕主机内存,pp 省下的通信量被延迟吃掉。
- 并发 4 路 192 vs 361 的差距比单路小,说明 batch 大时 micro-batch 能把 bubble 填一部分,但填不平 DFlash 那块缺口。
能验证的动作:
- 单独跑 tp2(不 pp)+ DFlash,拿 tok/chunk 作基准,量化 spec 的贡献。
- 想上 pp,先把 PCIe P2P 打通(同 root complex 的 P2PDMA whitelist / ACS,或上 PCIe switch)。P2P 通了 pp 的每层通信延迟会明显降。
- SGLang 的 CustomAllreduce 在 pp>1 时容易挂,求稳就 --disable-custom-all-reduce 退 NCCL,别为省带宽牺牲可跑性。
- prefill:pp 通常有小幅收益(每 rank 算的层少),但端到端要扣 bubble;测的时候 pp 和 tg 分开报。
4 卡无 NVLink 的结论仍沿用你那张表:tp=2×2 双实例聚合最优,tp=4 单路小跌、聚合大跌。除非有 NVLink 全互联,别把 4 卡当一个 tp=4 大实例用。
-
@Eric-Su 有没有prefill 结果?
@applejuice 離開辦公室哩,下禮拜繼續玩玩...剛主要在拷問有沒有DF的替代方案...
演算法 pp>1 能用? 依據 DFLASH(現役) ✗ 硬擋 arg 層 raise「only supports pp_size==1」(需獨立 draft 模型,不吃 PP_SPEC 路徑) DSpark ✗ 硬擋 同上 raise(596) UNO ✗ 硬擋 要求 TP=PP=1(506) EAGLE / NEXTN ✓ 可用 arg 層無 pp gate + 正是 PP_SPEC 路徑的目標 NGRAM 待確認 arg 層無 pp gate,但 PP_SPEC 註解只提 MTP draft,NGRAM 走 trie 非 MTP,可能不吃這條路 機制(scheduler.py L1033-1042 + L1172-1177):
- 有一個環境變數 SGLANG_ENABLE_PP_SPEC(預設 False)。
- 開啟後,pp 的非最後 stage 不跑 draft worker,只跑 verify-shaped target forward;draft(MTP layer)集中在最後 stage(因為 MTP head + lm_head 只在最後 stage)。
- spec_info.py 有專門的 PP_SPEC_RELAY 中繼機制串接。
為什麼 EAGLE 特別合適我們:
現役模型 Qwen3.8-27B-AWQ-MTP 本身就內建 MTP head。EAGLE 直接吃這個內建 head 當 draft,不需獨立 draft 權重——skill 記載 DFLASH2 之前的正式配方就是 EAGLE(代碼 179 t/s、accept len 6.0),現役 image 就有,零額外下載。一個誠實的但書(未坐實,要實測)
SGLANG_ENABLE_PP_SPEC 預設 False + 註解措辭(「非最後 stage 沒 draft worker」)透露這是實驗性/新路徑。三件事只有實測才知道:
- EAGLE + PP_SPEC + 我們這個 GDN mamba 混合架構會不會有雷(mamba 跨 pp + spec relay 同時作用,是雙重新路徑疊加)。
- 開了之後 EAGLE 的 accept len 在 pp 下會不會打折(draft 在 last stage 算、verify 跨 stage,可能有額外開銷)。
- 實測速度到底補回多少——理論上比「無 spec 的 71 t/s」高不少,但 pp bubble 還在。
方案定位
pp2×tp2 要跑更大模型時,EAGLE + SGLANG_ENABLE_PP_SPEC=1 是把 spec 加回來的正解路徑(取代被擋的 DFLASH),前提是那個大模型也有 MTP head 或 EAGLE draft。這正好把你前面擔心的「pp 丟了 spec 變慢」補上一大塊。