在 Proxmox VE +Ubuntu24.04虚拟机+AMD AI Pro R9700部署vLLM 服务器Agent 长链稳定性与速度测评(局域网客户机实测)
-
vLLM 服务器 Agent 长链稳定性与速度测评报告
被测服务:
http://192.168.67.202:8000(vLLM 0.27.1,OpenAI 兼容 API)
模型:qwen3.8-27b-int4(Qwen3 混合思考模型,INT4 量化,max_model_len = 131072)
评测时间:2026-09-16 22:27–23:30(本地时间,UTC+8;服务进程已运行约一天)
评测规模:15 轮单连续会话长链(660 次模型调用,峰值上下文 44,776 tokens)+ 基线 13 请求 + 思考模式对照 54 调用 + 对照实验 222 调用,全程约 1,100 次模型调用(备注:DSH:已设置会话70%的压缩、未安装任何Agent调用工具)
一、结论摘要(TL;DR)
维度 结论 传输层稳定性 极佳:全程 ~1,100 次调用 0 次连接/超时错误,SSE 流式解析 0 坏帧,工具调用 JSON 0 次解析失败 任务级稳定性 主评测 15 轮通过 7 轮(46.7%),但失败高度集中在两类:① T2 长链在 n≥32 时 100% 失败(全新短上下文对照同样失败 → 模型内在弱点,非服务/上下文污染);② 主评测 T3 存在评测侧设计缺陷(知识库仅 12 条,n>12 轮任务被截断),修正后 T3 在新会话中 4/5 通过且步数分毫不差 速度(轻载) 单流解码 77 tok/s(p50 78 / p95 89),工具调用 JSON 可达 ~100 tok/s(投机解码加成);TTFT 从 0.8k 上下文的 ~0.6s 增至 45k 上下文的 ~2.3s;前缀缓存命中时 TTFT 降至 ~1.4–2.0s(比冷 prefill 快 10–50 倍) 速度(重载/共享) 评测窗口内观察到间歇外部负载:3 次 TTFT 尖峰(34.4s / 38.4s / 193.8s),期间解码速率从 ~100 跌至 24–29 tok/s → 共享 GPU 场景下尾延迟不可控,p99 与 p95 差距巨大 思考模式 思考 ON 显著劣于 OFF:同任务平均单步延迟 5.76s vs 2.03s(2.8×)、输出 token 192 vs 38(5×)、有效速率 43.5 vs 78.6 tok/s,且 ON 失败、OFF 通过 → 工具/Agent 类任务建议关闭 thinking 容量 500 步长链峰值上下文 44.8k(131k 上限的 34%),容量充足;KV cache 评测后残留占用 <12%,空闲时自动回收
二、测试环境与方法
2.1 服务端信息
项 值 框架 / 版本 vLLM 0.27.1( /v1路由,OpenAI 兼容)模型 qwen3.8-27b-int4(INT4 量化,根目录 /model)max_model_len 131,072 tokens 投机解码 开启(4 位 MTP 草稿;服务进程累计:草稿 335,724 / 接受 208,590+,整体接受率 ~62%,pos0–3 逐位接受率 77% / 57% / 43% / 34%) 前缀缓存 开启(重复 prompt 二次请求 TTFT 10–50× 下降,见 §4.1) 评测期间并发 评测为单客户端串行; /metrics显示进程累计 prompt 26.5M / generation 314K tokens(含评测前的其他流量),且评测中 TTFT 出现与外部负载相关的尖峰(§4.4)
2.2 指标定义
- TTFT:请求发出 → 首个非空 delta(content 或 tool_call)的间隔。
- 总延迟:请求发出 → 流结束。
- out_tps(有效输出速率):
completion_tokens / (总延迟 − TTFT)。 - 冷 prefill 速率:
prompt_tokens / 冷请求 TTFT;热请求(前缀缓存命中)TTFT 单独统计。 - 所有请求
temperature=0、top_p=1、SSE 流式 +stream_options.include_usage=true,逐请求记录 usage。
2.3 任务设计
三类任务,同一会话内连续 15 轮,上下文逐轮累积(单会话长链,正是 Agent 长任务的真实形态):
任务 内容 轮数 期望模型调用数 T1 顺序检索+汇总 顺序调用 fetch_record取 N 条记录(N=24→40 递增),最后报sum/max_id5 2N+1 T2 顺序计算链 每步用 calculator执行X_i=(2·X_{i-1}+B_i) mod 997,共 N 步(N=24→40),报终值。B 序列为 7 元素周期([18,31,44,57,70,83,5] 重复)5 N+1 T3 双工具工作流 每个关键词依次 search_kb→write_log(每响应至多 1 个工具调用),最后报 count/total_chars5 2N+1 反馈策略(贴近真实 Agent 框架):最终答案不合规则回灌 feedback 重试(最多 2 次);单轮预算 = 期望步数 + 20;连续 5 次传输错误判该轮失败。
对照组:
- 基线:无工具、固定 128-max 输出的 prefill/decode 扫描,512→99k tokens 共 6 档、13 请求(2–3 重复,首请求为冷)。
- 思考对照:同一 T1(n=24) 任务、全新会话,
enable_thinkingON vs OFF 各 1 轮。 - T2 对照:全新短上下文(无前序轮历史)单独跑 n=32/40/28/24,用于区分"长上下文污染"与"模型内在能力边界",并逐记录 calculator 表达式以精确定位漂移点。
- T3 修正版:扩充知识库至 21 条(消除截断),终答改为
last_capital字符串(消除字符计数),全新会话 5 轮 n=12→20。
说明:冒烟测试(2 轮 18 步)与正式运行共用日志文件,分析脚本已按首个 setup 时间戳过滤,正式运行 15 轮 660 次调用全部独立于冒烟数据。
三、稳定性结果
3.1 传输层:0 故障
指标 值 全程模型调用 ~1,100(主 660 + 思考 54 + 对照 222 + 基线 13 + 扩展 5) 连接/超时/流中断 0 SSE 坏帧 / 工具参数 JSON 解析失败 0 服务器主动错误响应 0 传输层在整个评测窗口(含长上下文 44.8k、含外部负载尖峰时段)没有任何一次失败。vLLM 的 HTTP/SSE 层可靠性完全满足 Agent 长链需求。
3.2 主评测 15 轮总览
轮次   任务   N    期望步  实际步   结果    用时(s)
 1    T1    24     25      26     ✓      46.3
 2    T1    28     29      30     ✓      66.5
 3    T1    32     33      34     ✓      78.4
 4    T1    36     37      38     ✓     123.1
 5    T1    40     41      42     ✓     100.5
 6    T2    24     25      25     ✓      91.8
 7    T2    28     29      29     ✓      66.8
 8    T2    32     33      54     ✗     159.7   (final_wrong×2 + 超预算)
 9    T2    36     37      58     ✗     136.4   (final_wrong + 超预算)
10    T2    40     41      62     ✗     185.8   (final_wrong + 超预算)
11    T3    12     25      46     ✗     152.5   (final_wrong×2 + 超预算)
12    T3    14     29      50     ✗     139.1   (超预算, 无最终答案)
13    T3    16     33      54     ✗     155.6   (final_wrong + 超预算)
14    T3    18     37      58     ✗     140.6   (final_wrong + 超预算)
15    T3    20     41      62     ✗     ~150    (final_wrong + 超预算)

合计: 15 轮 / 660 次模型调用 / 通过 7 轮 (46.7%) / nudge 9 次 / 传输错误 0
事件: final_wrong ×9, step_budget_exceeded ×8
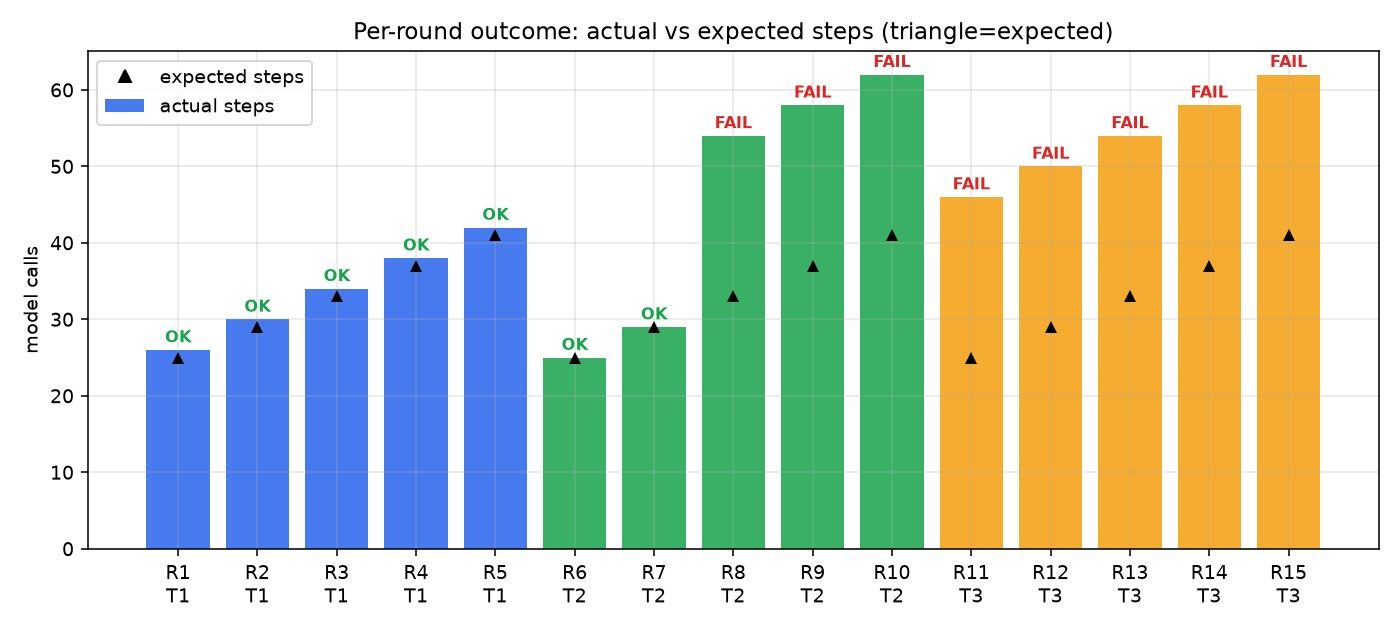
分任务通过率:T1 = 5/5(100%),T2 = 2/5(40%),T3 = 0/5(0%)
3.3 T1:完全稳定(5/5),仅存在无害的协议偏差
5 轮全部一次通过、0 nudge。唯一系统性偏差:每轮比期望多 1 次 calculator 调用——模型在取完 N 条记录后,倾向用一次 calculator 把所有值加总(而非心算),再给出最终 JSON。这是协议偏差而非故障(结果全部正确),说明该模型对"数值计算交给工具"的偏好很强,对 Agent 系统是好事。
3.4 T2:可靠性在 n≥32 处出现"悬崖"——且是模型内在弱点
T2 全部 10 次尝试的完整矩阵(含全新会话对照):
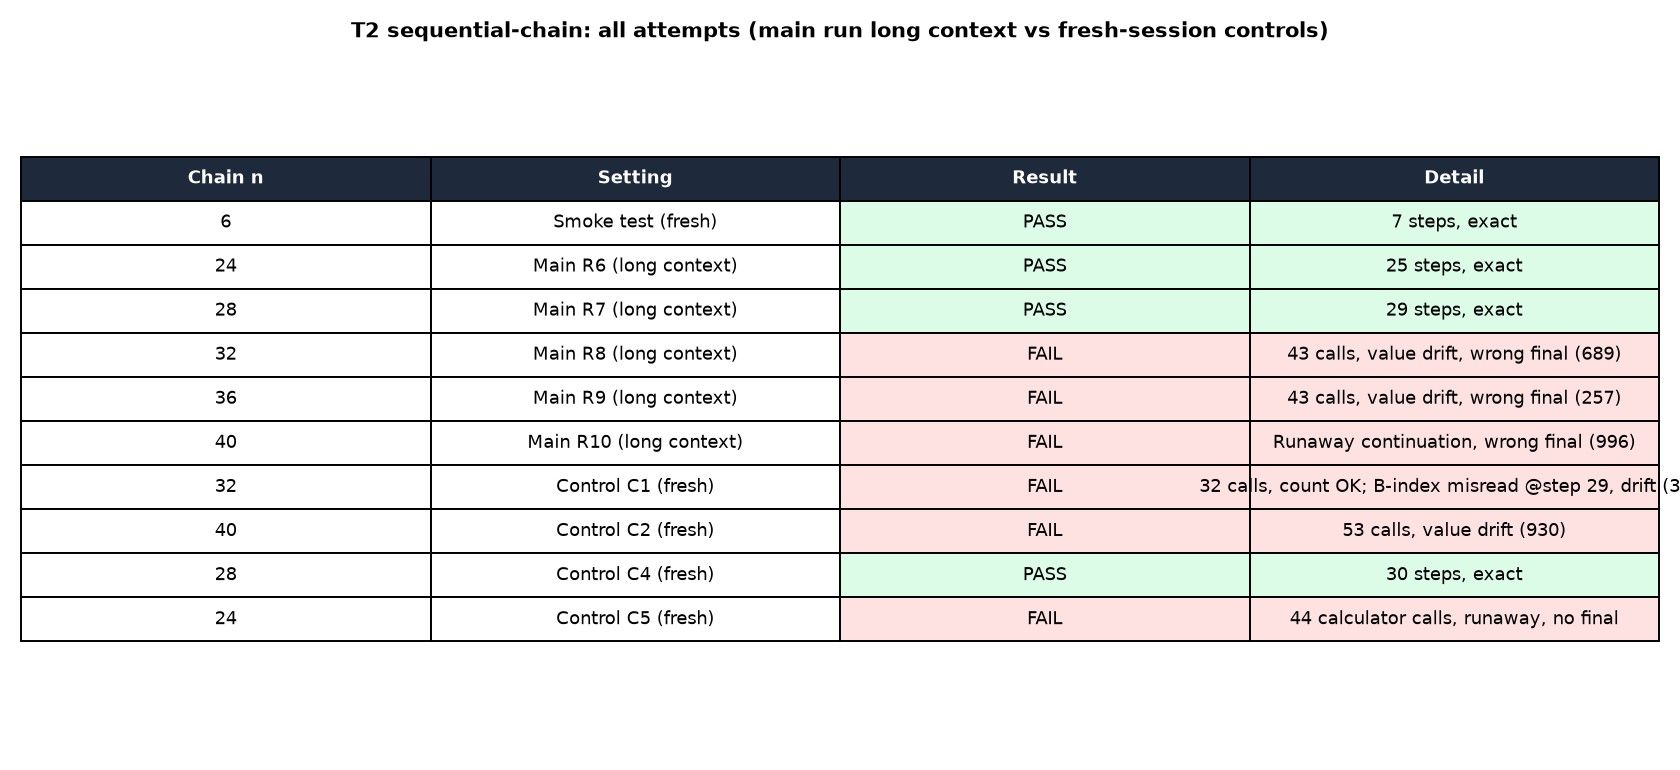
链长 n 主评测(长上下文 ~20–26k) 全新会话对照 小计 6 — 冒烟 PASS 1/1 24 R6 PASS(25 步精确) C5 FAIL(44 次 calculator 调用,失控续算,无最终答案) 2/3 28 R7 PASS(29 步精确) C4 PASS(30 步精确) 2/2 32 R8 FAIL(43 次调用,答 689,真值 109) C1 FAIL(32 次调用数正确,答 304) 0/2 36 R9 FAIL(43 次调用,答 257,真值 670) — 0/1 40 R10 FAIL(失控续算,答 996,真值 361) C2 FAIL(答 930,真值 361) 0/2
总计 4/10 通过。三个关键事实:
- n≤28 基本可靠(5/7),n≥32 全部失败(0/5)——主评测长上下文与全新短上下文同样全败,排除"长上下文污染"作为主因,这是模型对长重复序列的内在能力边界。
- 失败机理已精确定位(对照 C1 逐记录 calculator 参数):B 序列是 7 元素周期([18,31,44,57,70,83,5] 重复 4–5 遍)。模型前 28 步(前 4 个完整周期)每一步完全正确,第 29 步(第 5 个周期的第 1 个元素)把 B 读成了 31 而非 18——即在印刷的重复列表上索引错位,之后链值持续漂移(304 ≠ 真值 109,且不等于任何中间真值)。调用次数本身是对的(32 次),纯粹是"从重复列表里取错第几个"。
- 偶发"工具固化/失控":C5(n=24,历史上 2 次通过过的长度)一次出现 44 次 calculator 调用、越过目标后持续续算且始终不产出最终答案直到预算耗尽;R10 主评测同样失控。即即使任务难度可靠,模型仍有 ~1/3 概率进入重复调用循环(n=24 上 1/3)。
3.5 T3:主评测 0/5 的主要原因是评测侧缺陷 + 字符计数弱点;修正后 4/5
逐轮分析显示一个统一模式:每轮前 24 步(12 组 search+log)执行完全正确,之后才出问题。查明原因有三层:
- 评测侧缺陷(我方):知识库只有 12 条,n>12 的轮(R12–R15)关键词列表被截断成同样的 12 个,而期望答案仍按 n 计算 count——模型即使把 prompt 里全部 12 个关键词做对,
count也与"期望"不符 → 结构性必败。 - 字符计数是 LLM 硬弱点:终答含
total_chars(12 句事实的字符总数)。模型无法心算精确字符数,转而在结尾连打 calculator(把每句长度当字面量代入求和):R11 连打 3 次(361/385,真值 399)、R12 连打 25 次仍无最终答案、R13–R15 类似。即"精确字符计数"这一要求本身超出了模型的可靠能力。 - 长上下文叠加:此时上下文已达 26–45k tokens,含 7 个前序轮的全部工具往来,上述弱点在长上下文下更容易触发(R11 反馈后甚至重新搜索 12 遍关键词做"复核")。
修正版 T3(21 条知识库消除截断;终答改为
last_capital字符串,不要求任何算术;全新短上下文):轮 n 结果 实际步数 期望步数 r1 12 FAIL(24 步工具工作全部正确后进入 16 连 calculator 固化,无最终答案,超预算) 40 25 r2 14 PASS 29 29 r3 16 PASS 33 33 r4 18 PASS 37 37 r5 20 PASS 41 41 4/5 通过,且通过的轮步数与期望分毫不差(2N+1 一次不多一步)。结论:T3 这类双工具顺序工作流本身对该模型是可靠的;主评测 T3 的 0/5 = 我方设计缺陷 × 字符计数弱点 × 长上下文三重叠加,而非工作流能力缺失。r1 的固化再次印证 §3.4 的"工具固化"模式(10 次 T3 类运行中出现 2 次:R12 与 r1,均发生在完成全部工具工作之后)。
3.6 稳定性总结论
层级 评级 依据 传输/协议层 A(优秀) ~1,100 次调用 0 故障 短任务(≤30 步,无重复序列/无精确计数) A T1 5/5;T3 修正版 4/5 长重复计算链(n≥32 的 7 周期序列) C(不可用) 5/5 全败,新旧上下文一致,机理=重复列表索引错位 边界长度(n=24 左右) B 2/3,1/3 概率失控循环 要求精确字符/数值心算的终答 C 模型会绕过(连打 calculator)但仍错,或陷入固化
四、速度结果
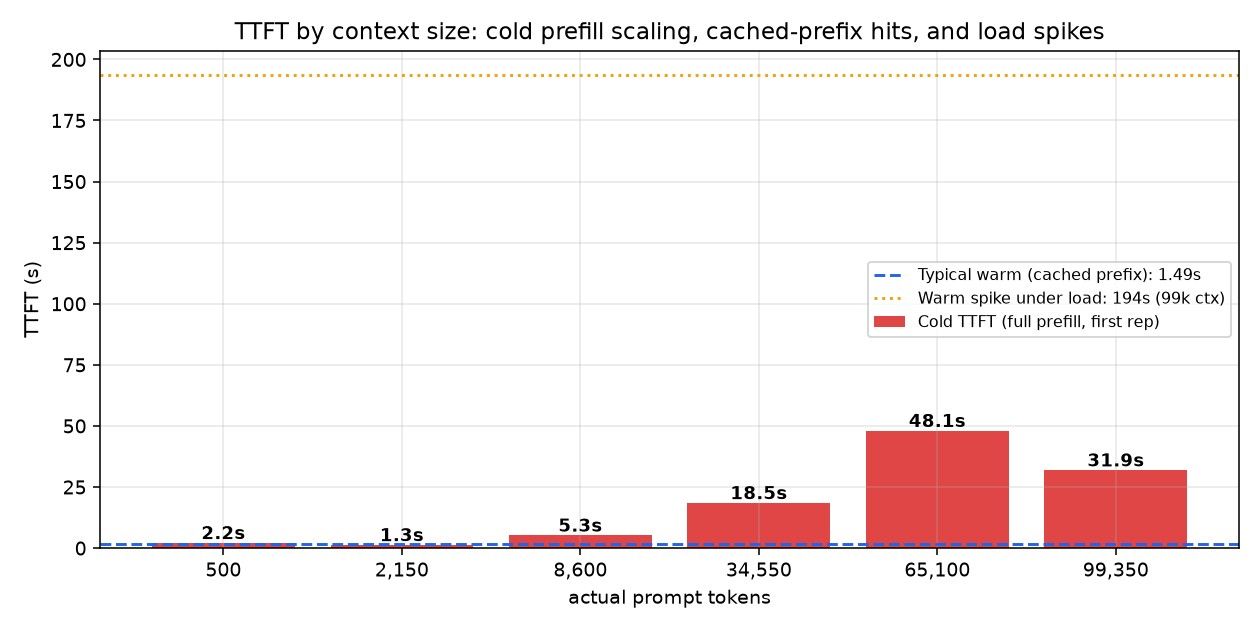
4.1 基线:prefill 与缓存(13 请求,512–99k tokens)
实际 prompt tokens 冷 TTFT 冷 prefill 速率 热 TTFT(前缀缓存命中) 热/冷加速 524 0.42s(1 次)/ 2.20s(1 次,外部负载) 1,254 / 238 tok/s 0.50s — 2,174 1.35s / 1.35s 1,616 tok/s 1.35s 1.0×(无新前缀增量) 8,624 5.25s 1,642 tok/s 1.40s 3.7× 34,574* 18.5s 1,864 tok/s 1.71s 10.8× 65,124 48.1s 1,354 tok/s 1.97 / 1.99s ~24× 99,374 31.9s 3,111 tok/s 193.8s(外部负载尖峰,异常值) 正常时应 ~2–3× * 该档首版 padding 估算不足,实际 34.6k;后补 65k/99k 两档。
要点:
- 冷 prefill 实测 1.3–3.1k tok/s(随 chunked-prefill 与负载波动),100k 上下文冷启动 ~32s,65k ~48s——超长上下文的冷启动是该服务的主要延迟来源。
- 前缀缓存收益巨大且稳定:重复前缀的热请求 TTFT 恒定在 1.3–2.0s(无论前缀 2k 还是 99k),比冷 prefill 快 10–24 倍。对"系统提示词+工具定义固定、历史累积"的 Agent 长会话,vLLM 的前缀缓存把每步成本压到只 prefill 增量——这正是本次主评测 500+ 步仍能保持 2.3s/步的根本原因。
- 1024 档的"冷"快/慢倒挂与 99k 热请求 194s 尖峰均指向同一原因:评测窗口存在间歇外部负载(§4.4)。
[冷/热 TTFT]
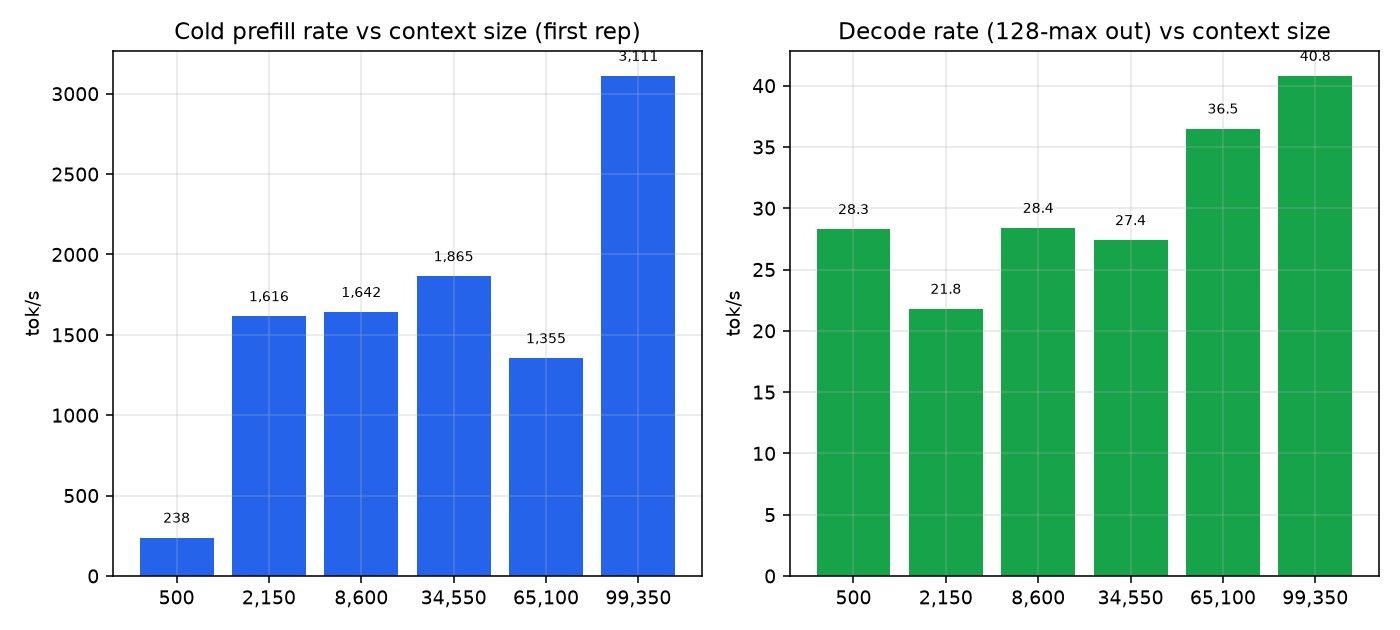
[基线速率]
4.2 解码速率:77 tok/s 均值,受"输出可预测性"显著调制
- 主评测 660 步:out_tps 均值 77.0,p50 78.3,p95 88.7,min 1.8(该点即 38.4s 尖峰步)。
- 对照诊断(同服务同窗口,~500–900 tokens 上下文):
输出类型 实测 tok/s 工具调用 JSON(~40 tok,高可预测) 98.9 – 101.6 自然语言摘要(22–38 tok) 61.2 强制重复词(63 tok) 46.5 - 机理:服务端开启 4 位 MTP 投机解码(整体接受率 ~62%,pos0 77%)。工具调用 JSON 结构高度可预测 → 草稿接受率高 → 有效速率接近 100 tok/s;自由 prose 接受率低 → 60 上下;评测初期基线窗口的 24–29 tok/s 则是外部负载压制(同窗口诊断重测已恢复 46–100)。
- 对 Agent 负载的含义:该服务上"以工具调用为主的 Agent 循环"比"长文生成"更快,这是投机解码的结构性红利。
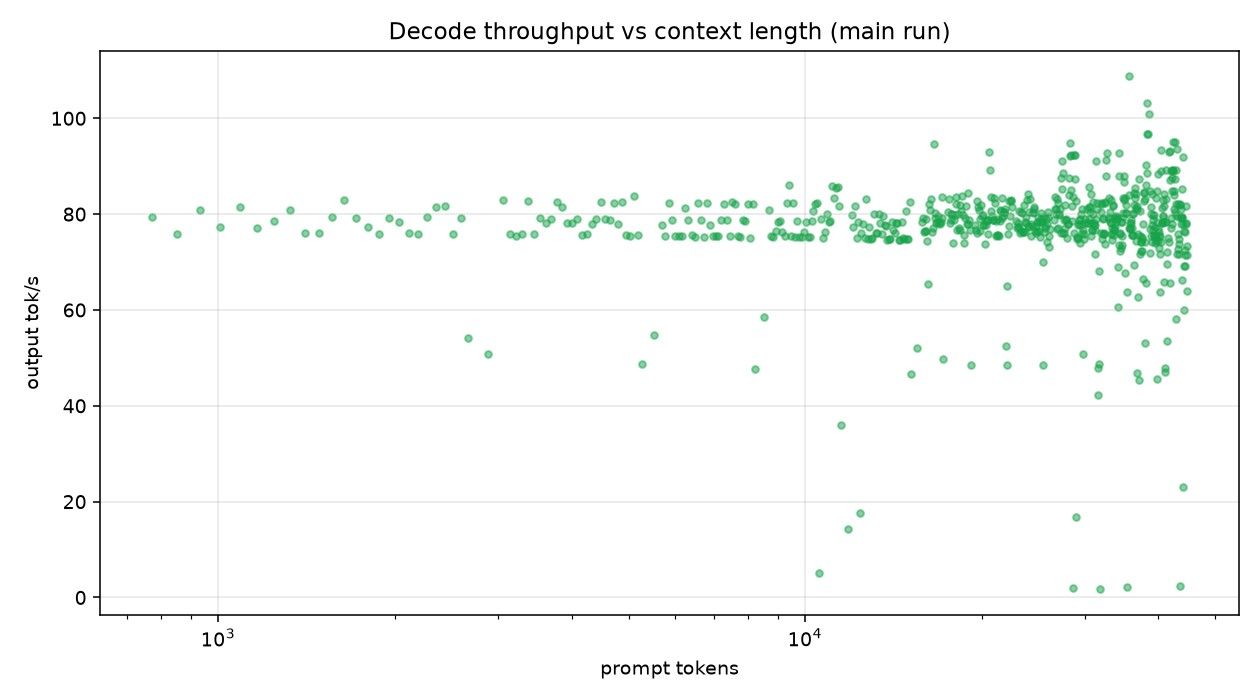
[解码 vs 上下文]
4.3 长链过程中的延迟-上下文关系(主评测 15 轮)
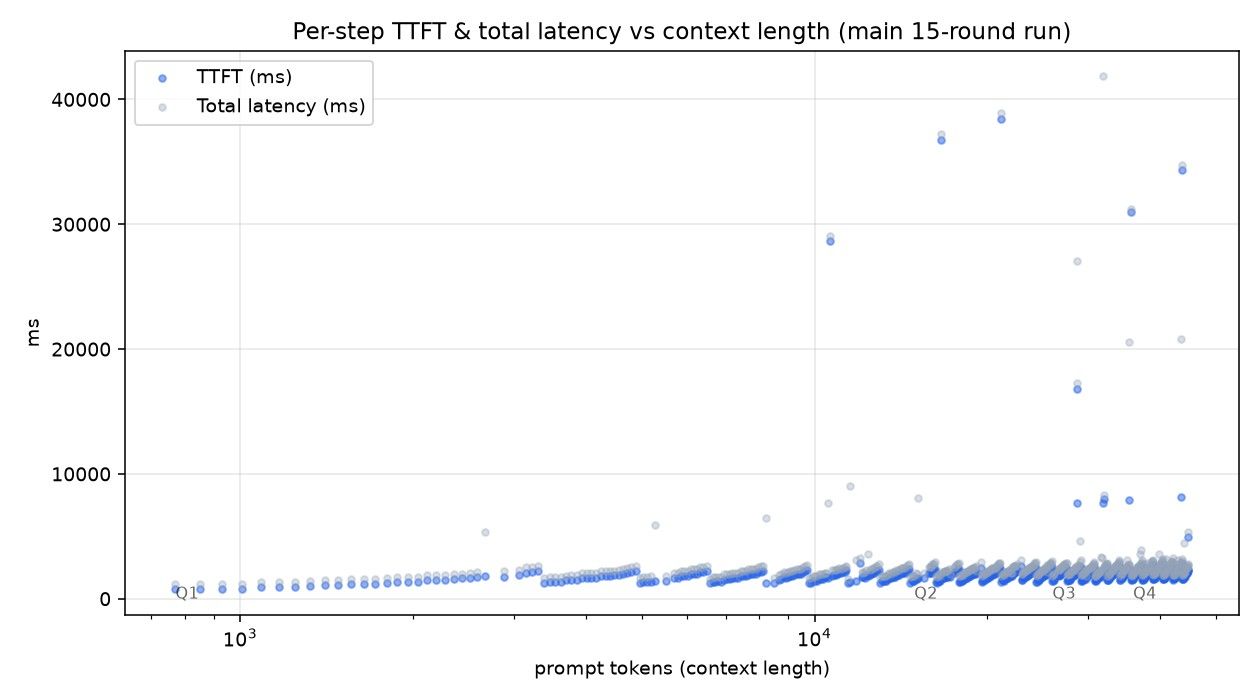
[TTFT vs 上下文]
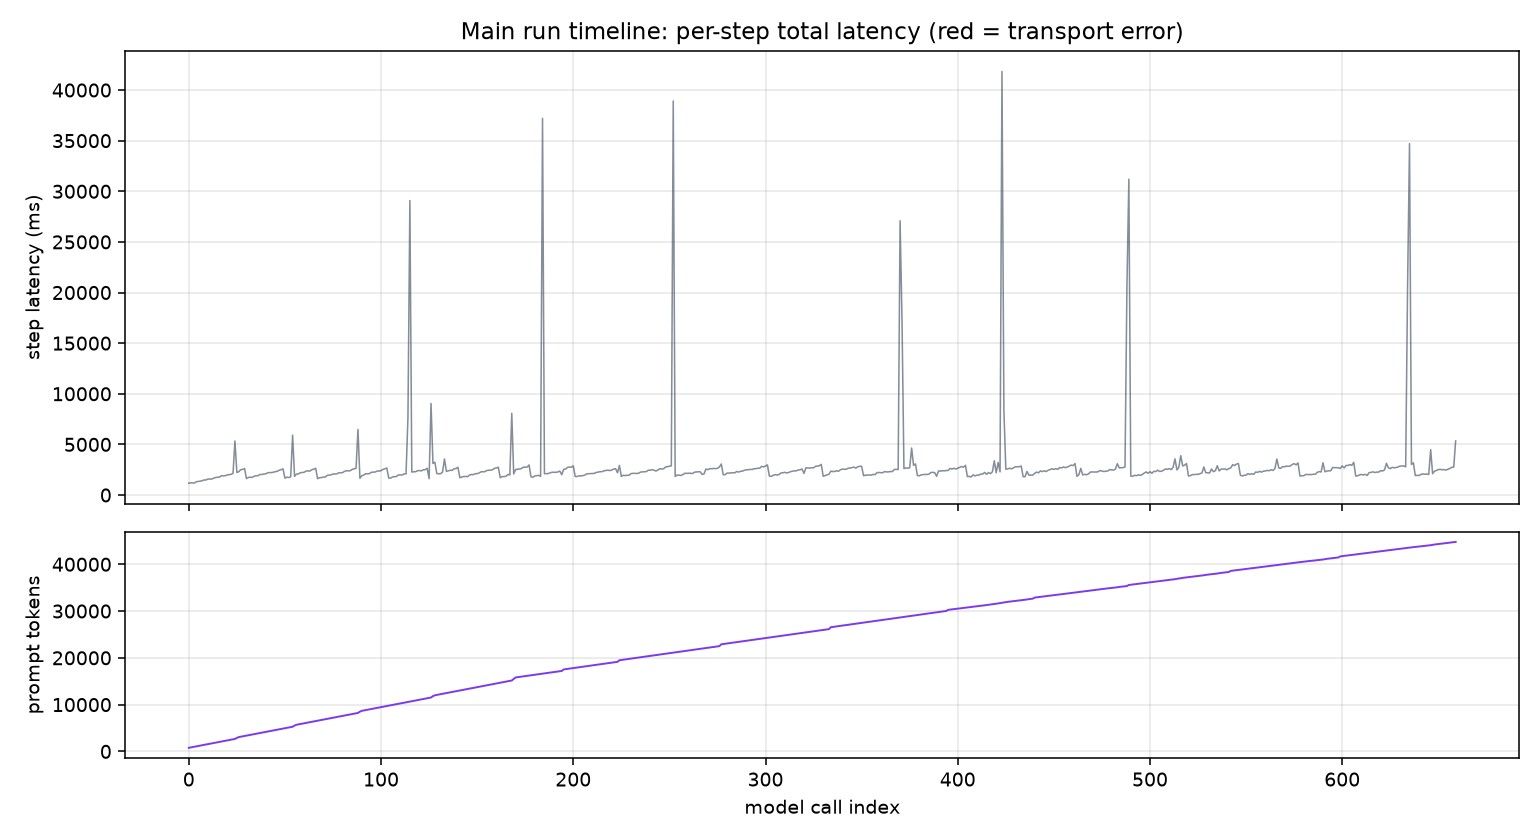
[时间线]
按上下文四分位统计(660 步):
上下文区间(tokens) 步数占比 TTFT 均值 总延迟均值 out_tps 均值 0.8k – 14.9k Q1 1,852 ms 2,416 ms 75.9 14.9k – 25.9k Q2 2,296 ms 2,804 ms 77.7 26.0k – 35.8k Q3 2,357 ms 3,186 ms 77.2 35.9k – 44.8k Q4 2,302 ms 2,796 ms 77.1 要点:
- 上下文从 771 增长到 44,776(131k 上限的 34.2%),TTFT 仅从 ~0.6s 温和升至 ~2.3s,前缀缓存 + chunked prefill 下延迟随上下文的退化非常平缓(Q1→Q4 仅 +18%)。
- 解码速率几乎不随上下文下降(75.9→77.1),说明该硬件配置下注意力开销在 45k 内尚未成为瓶颈。
- 按任务:T1(峰值 16.5k 上下文)总延迟均值 2.4s;T2 2.8s;T3 3.0s(26–45k 上下文)——500 步长链全程平均 ~2.8s/步,无恶化趋势。
4.4 尾延迟与共享负载风险(本评测最重要的速度警示)
评测窗口内共捕获 3 次 TTFT 尖峰,均与外部负载相关(尖峰后的下一步立即恢复正常 1.3–1.5s):
发生点 TTFT 当时上下文 解读 主评测 R8 第 29 步 38.4s 21.1k 外部请求挤占,本请求 prefill 被饥饿 ~36s 主评测 T3 轮内 34.4s ~37k 同上 扩展基线 99k 热请求 193.8s 99.4k 本应 2s 的缓存命中请求被拖到 194s(prefill 实测 513 tok/s,仅为自身冷 prefill 的 1/6) 同期解码速率也从 ~100 跌至 24–29 tok/s。结论:该 vLLM 实例在评测期间并非独占 GPU;空闲/轻载时性能优秀(§4.1–4.3),但并发竞争下 p99 延迟可达 p95 的 60–70 倍。若用于生产 Agent 服务,必须:独占/预留 GPU,或配置
--max-num-seqs限流 + 优先级调度,否则长上下文请求会被任意突发流量长时间饿死。
4.5 思考模式(thinking ON vs OFF,同一 T1 n=24 任务、全新会话)
[思考对照]
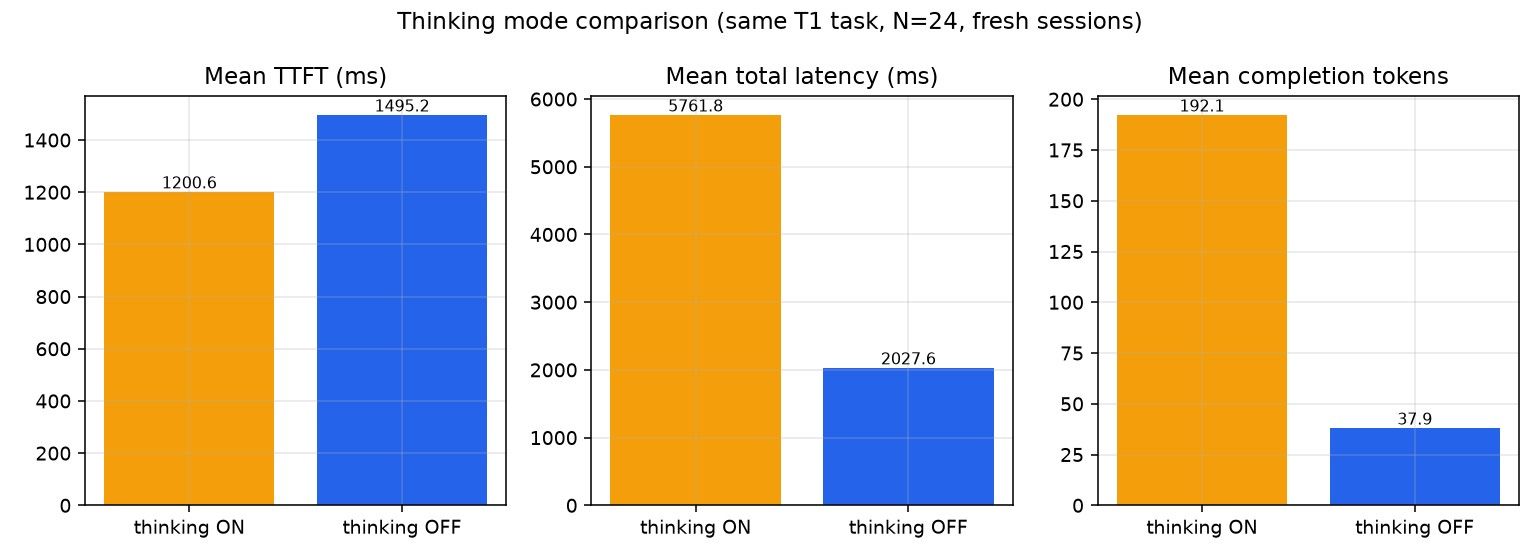
指标 thinking ON thinking OFF 倍数 模型调用数 28 26 1.08× 平均 TTFT 1,201 ms 1,495 ms 0.8×(ON 略快,因 thinking 首 token 前无长文) 平均总延迟 5,762 ms 2,028 ms 2.8× 总延迟 p95 15,793 ms 4,774 ms 3.3× 平均 completion tokens 192(thinking 占 ~150) 38 5.0× 平均 out_tps 43.5 78.6 0.55× 任务结果 FAIL(4 次纠错事件,未收敛到正确答案) PASS(0 事件) — 结论:在此 27B INT4 服务上,对工具密集型 Agent 任务开启 thinking 是负优化——单步延迟 ×2.8、token 成本 ×5,且本样本中 ON 失败 / OFF 通过(n=1 每臂,方向性结论,样本有限但差距量级明确)。thinking 的价值应留给"需要多步推理且无现成工具"的开放式问题,而非"逐步调工具"的执行型 Agent 循环。
五、综合结论与建议
5.1 该服务作为 Agent 长链后端的总体评级
场景 评级 说明 单流、独占 GPU 的 Agent 工具循环(≤50k 上下文) A(推荐) 2.3–2.8s/步、77–100 tok/s、0 传输故障、前缀缓存 10–24× 收益 超长冷启动(65k–100k 新会话) B- 32–48s 首响,属 prefill 物理成本,建议客户端做进度提示 共享 GPU / 有并发突发流量 C(不推荐裸用) 194s 尖峰 + 解码 4× 降速;需限流/隔离后重测 长重复序列计算(≥32 步周期链) C 模型内在弱点,换任务设计而非加算力可解
5.2 可操作建议
- Agent/工具任务关闭
enable_thinking(本次实测 2.8× 延迟、5× token、且准确率更好)。 - 重构"长重复链"任务:T2 类任务的失败点是"从印刷的 7 周期重复列表里取第 i 个"。让 prompt 给出增量公式(如
B_i = ((i×13 mod 91)+5))代替列表、或把 4–5 步合并为一次批量工具调用(chain工具),可把 32–40 步任务压到 <10 步,绕开该模型的索引弱点。 - 不要要求模型心算精确字符数/大数:需要时提供专用工具(
len()、sum()),否则会出现"连打 calculator"固化或错误终答(本次 2/10 的 T3 类运行因此失控)。 - GPU 隔离/限流:若该实例面向多租户,启用
--max-num-seqs、请求优先级,或为长上下文 Agent 会话单独实例;验收标准建议以 p99 TTFT(而非 p95)为准——本评测 p99/p95 ≈ 16×。 - 利用前缀缓存:固定系统提示+工具定义、按轮追加历史的组织方式已被验证能把 500 步会话的单步成本压在 2–3s;避免每轮重排历史顺序(会摧毁缓存命中)。
- 容量规划:131k 上限下 500 步链仅用 34%;若单步输出变长(>100 tok),建议预算上限 250–300 步或中途做历史压缩。
5.3 评测局限性
- 单实例、单日(~70 分钟)评测;服务进程已运行一天,
/metrics累计计数器含评测前流量,服务端吞吐总量为近似值。 - 评测期间存在间歇外部负载(无法远程排除),§4.1/§4.4 已分别标注轻载与受扰数据。
- 思考对照每臂 n=1(方向性结论);T2 对照每档 1–3 次重复。
- 主运行期间每 2 轮抓取的 KV-cache
/metrics因解析器早期 bug 为空,改用评测前后快照(评测后残留占用 <12%、空闲归零)与 TTFT 冷/热对比间接表征缓存行为。
附录
A. 文件清单(
vllm_longchain_eval/)文件 说明 eval_harness.py主评测框架(工具实现、3 类任务、SSE 客户端、基线、思考对照、运行器) extra_baseline.py/baseline_ext.json扩展基线(65,124 / 99,374 tokens,2–3 重复) t2_control.py/steps_ctrl*.jsonl,rounds_ctrl*.jsonlT2 全新会话对照(含逐次 calculator 参数记录,漂移定位依据) t3_fixed.py/steps_t3fix.jsonl,rounds_t3fix.jsonlT3 修正版(21 条知识库、last_capital 终答) steps_run.jsonl/rounds_run.jsonl/baseline.json主评测 15 轮 + 思考对照的逐步原始数据(TSV 可直接 Excel 打开) analyze.py/stats.json统计 + 8 张图生成 chart1..chart8*.png图表(TTFT/解码 vs 上下文、时间线、基线、每轮结果、思考对照、冷热 TTFT、T2 矩阵) serverinfo.json服务端模型/版本信息 B. 复现方法
cd vllm_longchain_eval .venv/bin/python eval_harness.py # 15 轮长链 + 基线 + 思考对照 (~35 min) .venv/bin/python extra_baseline.py # 65k/99k 扩展基线 (~5 min) .venv/bin/python t2_control.py ctrl2 # T2 边界对照 (n=40/28/24, ~5 min) .venv/bin/python t3_fixed.py # T3 修正版 (~6 min) .venv/bin/python analyze.py # stats.json + 8 图 -
-
,
 T terry 固定了此主题
-
,系统 取消固定了此主题