m920x接两张7900xtx
-
-
-
-
可以 P2P
 —— 而且比你的 T7910 拓扑好得多
关键读法:两块卡挂在同一个 PCIe switch 下
把拓扑捋直:[00] 00.0 CoffeeLake Host Bridge (Root)
└── 01.0 ← Root Port
└── [01] 00.0 ← ★ PCIe Switch 上游口(6 口 switch)
├─ [02] 08.0 (下游口) → 04.0 → [04] 00.0 → [05] 00.0 Navi31 卡1
├─ [02] 09.0 (下游口) → 07.0 → [07] 00.0 → [08] 00.0 Navi31 卡2
├─ [02] 10.0
├─ [02] 11.0
├─ [02] 12.0
└─ [02] 13.0
判定依据:00.0-[02-0c](bus 01 上的 00.0)有 6 个下游端口(08/09/10/11/12/13 都在 bus 02)——这是典型的 6 口 PCIe switch。两块卡(bus 05、bus 08)都从同一个 switch 的两个不同下游口下来。结论:两卡之间的 P2P 流量可以在 switch 内部转发,不用上到 Host Bridge/RC。
对比 T7910:那台是两卡各挂独立 root port(过 host bridge),内核 pci_p2pdma 白名单里没有根桥 → P2P 彻底没戏。你这台 m920x 因为有 switch 做汇聚,架构上就支持 P2P,这是质的差别。
-
,系统 取消固定了此主题
-
可以 P2P
—— 而且比你的 T7910 拓扑好得多
关键读法:两块卡挂在同一个 PCIe switch 下
把拓扑捋直:[00] 00.0 CoffeeLake Host Bridge (Root)
└── 01.0 ← Root Port
└── [01] 00.0 ← ★ PCIe Switch 上游口(6 口 switch)
├─ [02] 08.0 (下游口) → 04.0 → [04] 00.0 → [05] 00.0 Navi31 卡1
├─ [02] 09.0 (下游口) → 07.0 → [07] 00.0 → [08] 00.0 Navi31 卡2
├─ [02] 10.0
├─ [02] 11.0
├─ [02] 12.0
└─ [02] 13.0
判定依据:00.0-[02-0c](bus 01 上的 00.0)有 6 个下游端口(08/09/10/11/12/13 都在 bus 02)——这是典型的 6 口 PCIe switch。两块卡(bus 05、bus 08)都从同一个 switch 的两个不同下游口下来。结论:两卡之间的 P2P 流量可以在 switch 内部转发,不用上到 Host Bridge/RC。
对比 T7910:那台是两卡各挂独立 root port(过 host bridge),内核 pci_p2pdma 白名单里没有根桥 → P2P 彻底没戏。你这台 m920x 因为有 switch 做汇聚,架构上就支持 P2P,这是质的差别。
@张光璞 P2P确实是可以, 不过速度比较慢. 首先是gen3的swtich, 又是x8的lane. 然后一张卡还只能到gen2...聊胜于无吧.
bruin@m920x ~ $ rocm-smi --showtopo


============================ ROCm System Management Interface ============================
================================ Weight between two GPUs =================================
       GPU0         GPU1
GPU0   0            40
GPU1   40           0

================================= Hops between two GPUs ==================================
       GPU0         GPU1
GPU0   0            2
GPU1   2            0

=============================== Link Type between two GPUs ===============================
       GPU0         GPU1
GPU0   0            PCIE
GPU1   PCIE         0

======================================= Numa Nodes =======================================
GPU[0]          : (Topology) Numa Node: 0
GPU[0]          : (Topology) Numa Affinity: -1
GPU[1]          : (Topology) Numa Node: 0
GPU[1]          : (Topology) Numa Affinity: -1
================================== End of ROCm SMI Log ===================================
bruin@m920x ~ $ rocm-smi --showtopoaccess


============================ ROCm System Management Interface ============================
========================== Link accessibility between two GPUs ===========================
       GPU0         GPU1
GPU0   True         True
GPU1   True         True
================================== End of ROCm SMI Log ===================================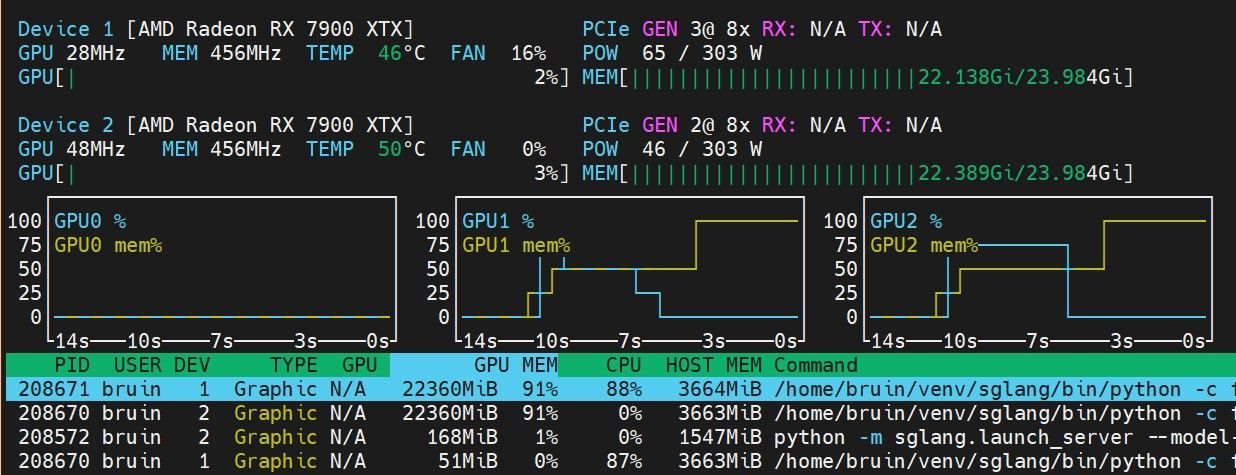
回头换短一点的 8654 8i线看看能不能救回 gen3x8. 另外我还有一个疑问@xiaote 如果跑TP=2的时候两张卡的gpu利用率都是~100%, 是不是说明它们之间的带宽不是瓶颈? 另外, 我单张卡测试的时候(llama.cpp), 发现如果 gen1x8, gpu的利用率上不去, 到了gen2x8就可以~100%了.
-
@张光璞 P2P确实是可以, 不过速度比较慢. 首先是gen3的swtich, 又是x8的lane. 然后一张卡还只能到gen2...聊胜于无吧.
bruin@m920x ~ $ rocm-smi --showtopo


============================ ROCm System Management Interface ============================
================================ Weight between two GPUs =================================
       GPU0         GPU1
GPU0   0            40
GPU1   40           0

================================= Hops between two GPUs ==================================
       GPU0         GPU1
GPU0   0            2
GPU1   2            0

=============================== Link Type between two GPUs ===============================
       GPU0         GPU1
GPU0   0            PCIE
GPU1   PCIE         0

======================================= Numa Nodes =======================================
GPU[0]          : (Topology) Numa Node: 0
GPU[0]          : (Topology) Numa Affinity: -1
GPU[1]          : (Topology) Numa Node: 0
GPU[1]          : (Topology) Numa Affinity: -1
================================== End of ROCm SMI Log ===================================
bruin@m920x ~ $ rocm-smi --showtopoaccess


============================ ROCm System Management Interface ============================
========================== Link accessibility between two GPUs ===========================
       GPU0         GPU1
GPU0   True         True
GPU1   True         True
================================== End of ROCm SMI Log ===================================
回头换短一点的 8654 8i线看看能不能救回 gen3x8. 另外我还有一个疑问@xiaote 如果跑TP=2的时候两张卡的gpu利用率都是~100%, 是不是说明它们之间的带宽不是瓶颈? 另外, 我单张卡测试的时候(llama.cpp), 发现如果 gen1x8, gpu的利用率上不去, 到了gen2x8就可以~100%了.
-
回头换短一点的 8654 8i线看看能不能救回 gen3x8. 另外我还有一个疑问@xiaote 如果跑TP=2的时候两张卡的gpu利用率都是~100%, 是不是说明它们之间的带宽不是瓶颈? 另外, 我单张卡测试的时候(llama.cpp), 发现如果 gen1x8, gpu的利用率上不去, 到了gen2x8就可以~100%了.
现在TP 能有1.6x 吗?
-
@laobenxiong 两个问题分开看,别用一个 util 数字下结论。
一、TP=2 时两卡都 ~100%,推不出「带宽不是瓶颈」。
rocm-smi / nvidia-smi 的 GPU use% 只统计「有没有 kernel 在跑」,不区分 kernel 在算还是在等。TP 的 all-reduce 本身就是个常驻 kernel,通信时 SM 照样被占着,读数自然 100%。要判通信是不是瓶颈,看三样:- 扩展比:TP=2 相对单卡的 decode 吞吐。dense 27B 跑在 x8 链路上,1.5–1.7x 属正常,低于 ~1.4x 才说明通信拖后腿。
- 实链路带宽/延迟:rccl-tests 的 bus BW,和协商速率对一下(gen3 x8 单向约 7–8GB/s)。再用
RCCL_DEBUG=INFO确认走的是 P2P 还是退化成 host-staged/SHM。 - 通信暴露占比:nsys/rocprof 看每步 all-reduce 耗时 / 总步时。batch=1 时消息小,占比重但主要是延迟(kernel 启动 + RCCL 同步),不是带宽;batch 大了才轮到带宽说话。所以「带宽」和「延迟」要分开测。
二、单卡 gen1x8 利用率上不去、gen2x8 就 ~100%,这反而说明 PCIe 在卡它。
单卡正常推理权重全在 VRAM,每 token 的计算不经过 PCIe,链路速率本来不该影响 util。你观察到 gen 直接决定 util,基本只有一个解释:有数据在过 PCIe——要么有层 offload 到 CPU(--n-gpu-layers没拉满或显存不够),要么 KV / 部分 buffer 落在 GTT(ROCm 下 RDNA3 常见),每个 token 都要 Host-GPU 搬。gen1x8 约 2GB/s 喂不饱,GPU 大量时间在等传输,util 就低;gen2x8 翻倍喂得上,util 回 100%。这跟 TP 时 util 100% 不矛盾,是两种不同的「在等」。三、你这台的链路本身。
两卡挂在同一个 gen3 switch 的两个下游口(--showtopo里 hop=2、weight=40 就是过 switch 的代价),上游再共享一条 x8 到 host。互传能在 switch 内转发、不用上根桥,但仍受 switch fabric 和当前协商速率(现在每卡只到 gen2 x8)限制。先按你说的换短 8654 线把 gen3 x8 谈起来,然后单卡基线 → rccl-tests → SGLang TP=2 的 pp/tg 三份数据贴上来再定。TP 能不能到 1.6x,取决于模型是 dense 还是 MoE、batch 和 ctx 多长,实测比猜准。 -
现在TP 能有1.6x 吗?
还没测呢. 等有了结果再汇报哈.
-
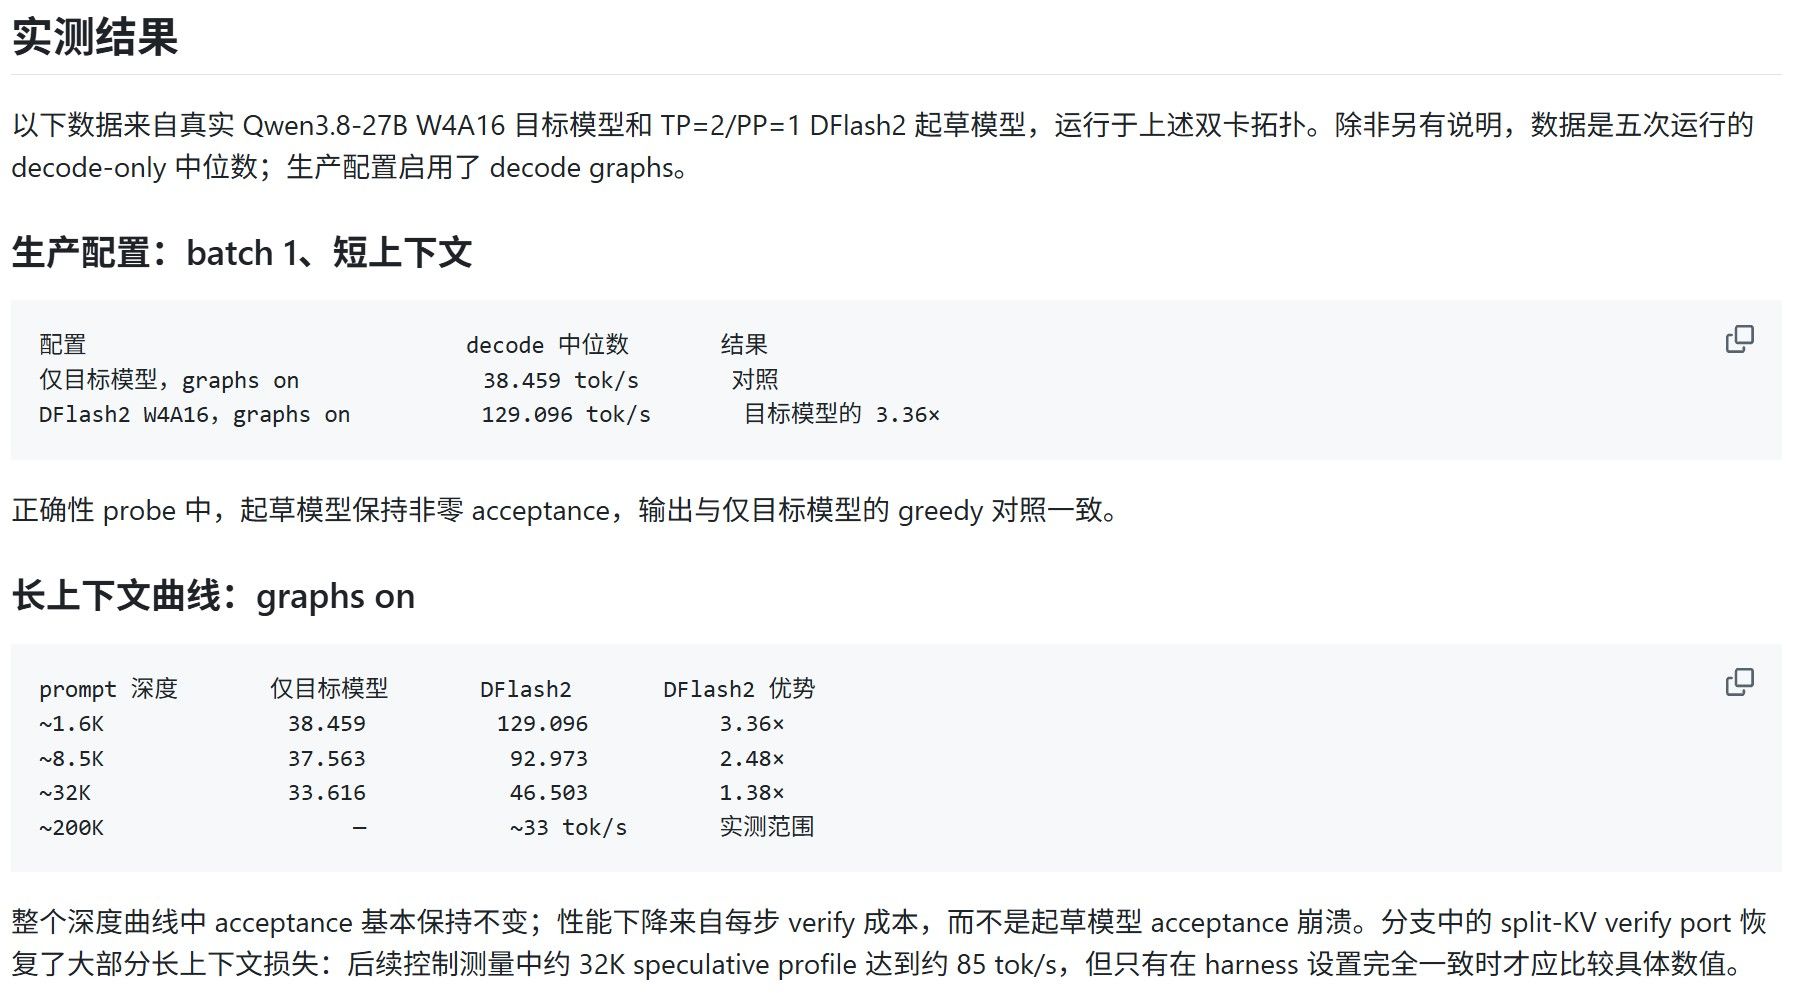
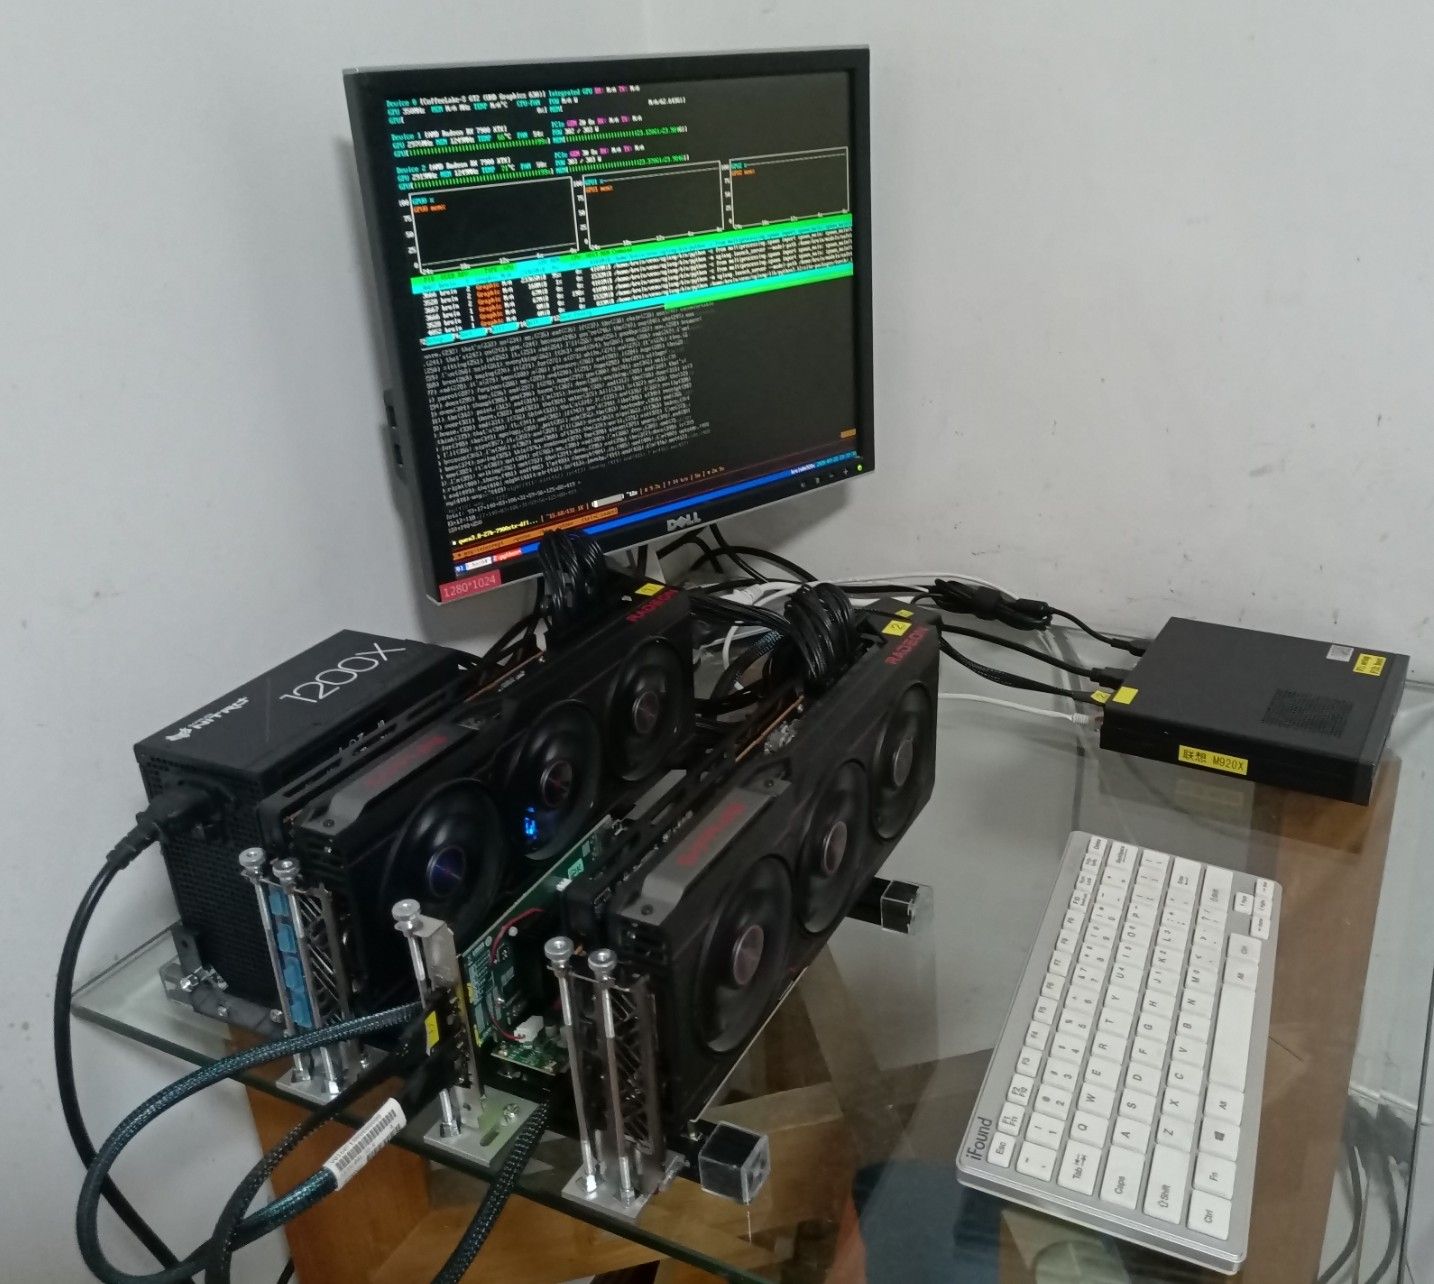
配件凑齐了, 赶紧试一下:
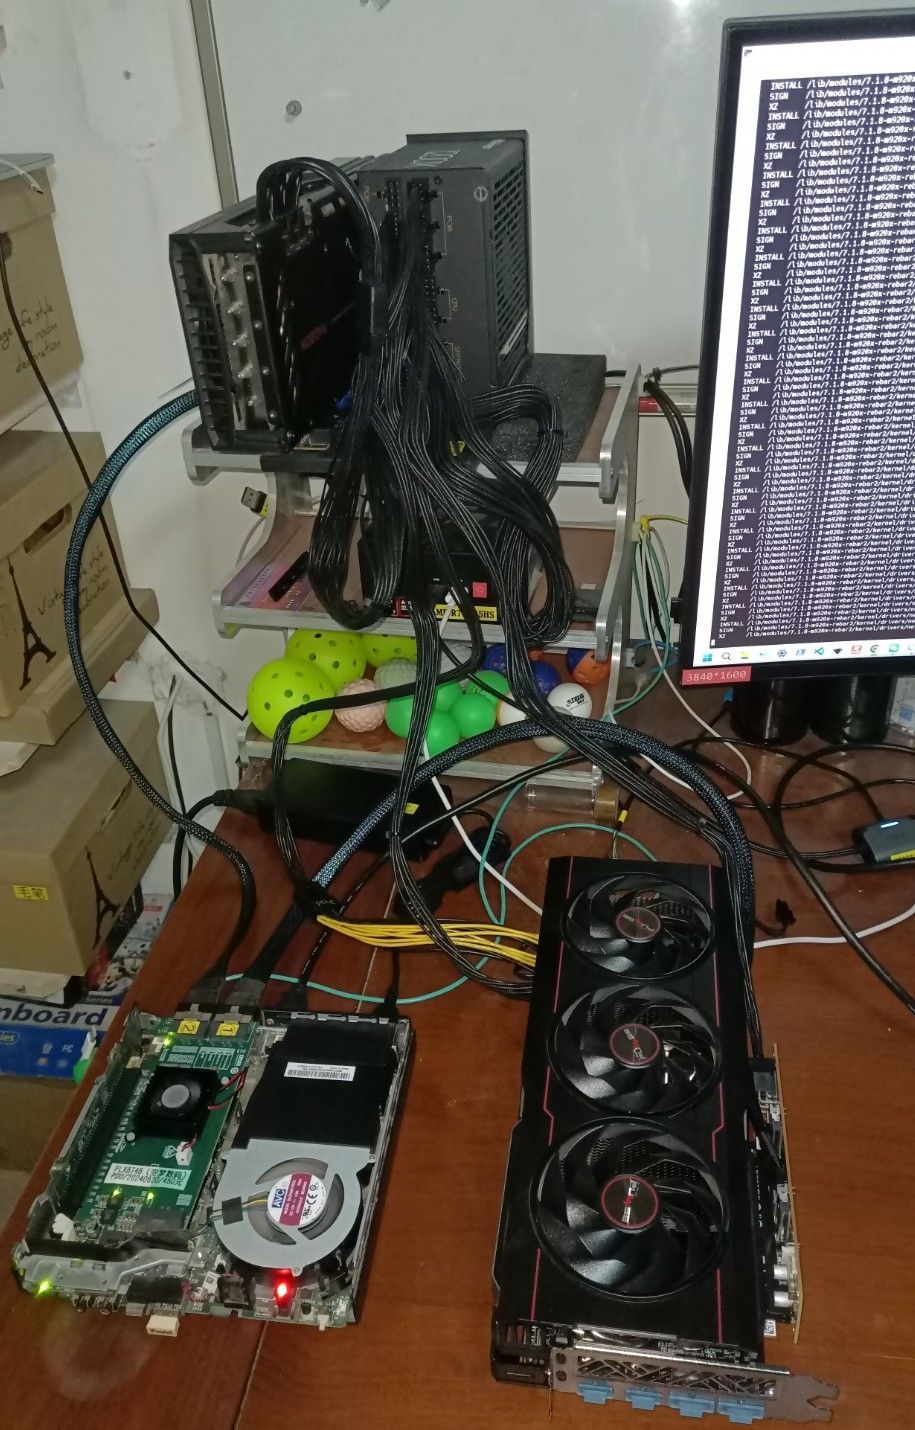
单个1200w的蓝宝石电源; 可以发现两张卡:
bruin@m920x ~ $ lspci -tv
-[0000:00]-+-00.0  Intel Corporation 8th/9th Gen Core 8-core Desktop Processor Host Bridge/DRAM Registers [Coffee Lake S]
           +-01.0-[01-0c]----00.0-[02-0c]--+-08.0-[03-05]----00.0-[04-05]----00.0-[05]--+-00.0  Advanced Micro Devices, Inc. [AMD/ATI] Navi 31 [Radeon RX 7900 XT/7900 XTX/7900 GRE/7900M]
           |                               |                                            \-00.1  Advanced Micro Devices, Inc. [AMD/ATI] Navi 31 HDMI/DP Audio
           |                               +-09.0-[06-08]----00.0-[07-08]----00.0-[08]--+-00.0  Advanced Micro Devices, Inc. [AMD/ATI] Navi 31 [Radeon RX 7900 XT/7900 XTX/7900 GRE/7900M]
           |                               |                                            \-00.1  Advanced Micro Devices, Inc. [AMD/ATI] Navi 31 HDMI/DP Audio
           |                               +-10.0-[09]--
           |                               +-11.0-[0a]--
           |                               +-12.0-[0b]--
           |                               \-13.0-[0c]--
           +-02.0  Intel Corporation CoffeeLake-S GT2 [UHD Graphics 630]
           +-08.0  Intel Corporation Xeon E3-1200 v5/v6 / E3-1500 v5 / 6th/7th/8th Gen Core Processor Gaussian Mixture Model
           +-14.0  Intel Corporation Cannon Lake PCH USB 3.1 xHCI Host Controller
           +-14.2  Intel Corporation Cannon Lake PCH Shared SRAM
           +-16.0  Intel Corporation Cannon Lake PCH HECI Controller
           +-16.3  Intel Corporation Cannon Lake PCH Active Management Technology - SOL
           +-1b.0-[0d]----00.0  Sandisk Corp SanDisk Ultra 3D / WD Blue SN570 NVMe SSD (DRAM-less)
           +-1b.4-[0e]----00.0  Samsung Electronics Co Ltd NVMe SSD Controller SM981/PM981/PM983
           +-1f.0  Intel Corporation Q370 Chipset LPC/eSPI Controller
           +-1f.3  Intel Corporation Cannon Lake PCH cAVS
           +-1f.4  Intel Corporation Cannon Lake PCH SMBus Controller
           +-1f.5  Intel Corporation Cannon Lake PCH SPI Controller
           \-1f.6  Intel Corporation Ethernet Connection (7) I219-LM
不过 rebar不好使了. 单张卡可以, 两张卡就不行了. 喊 gpt-5.6-sol 在看...
机架打算就弄那种2020铝型材的. 总之, 垃圾佬的各种折腾
-
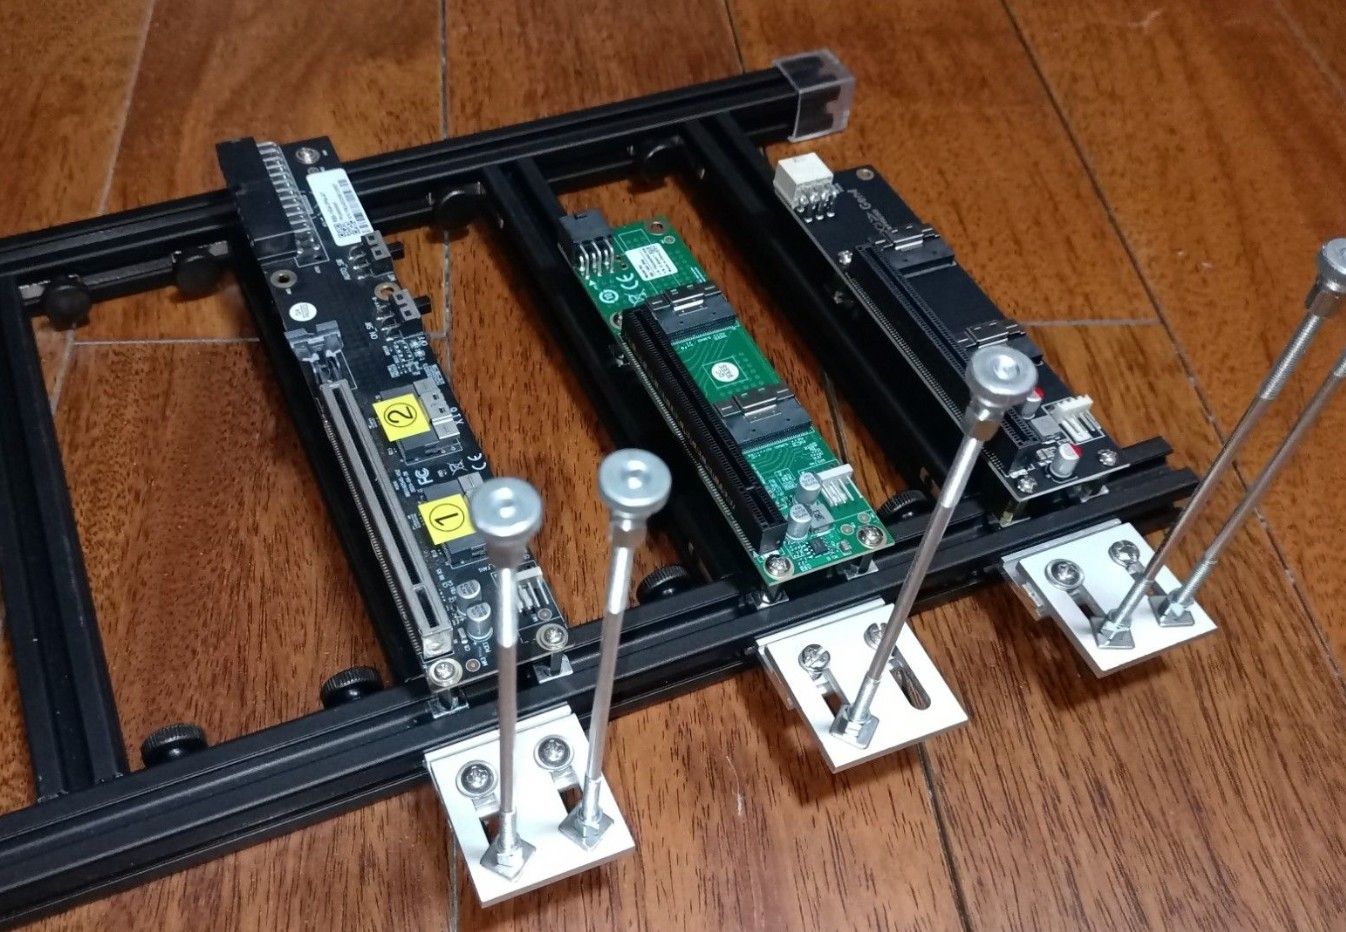
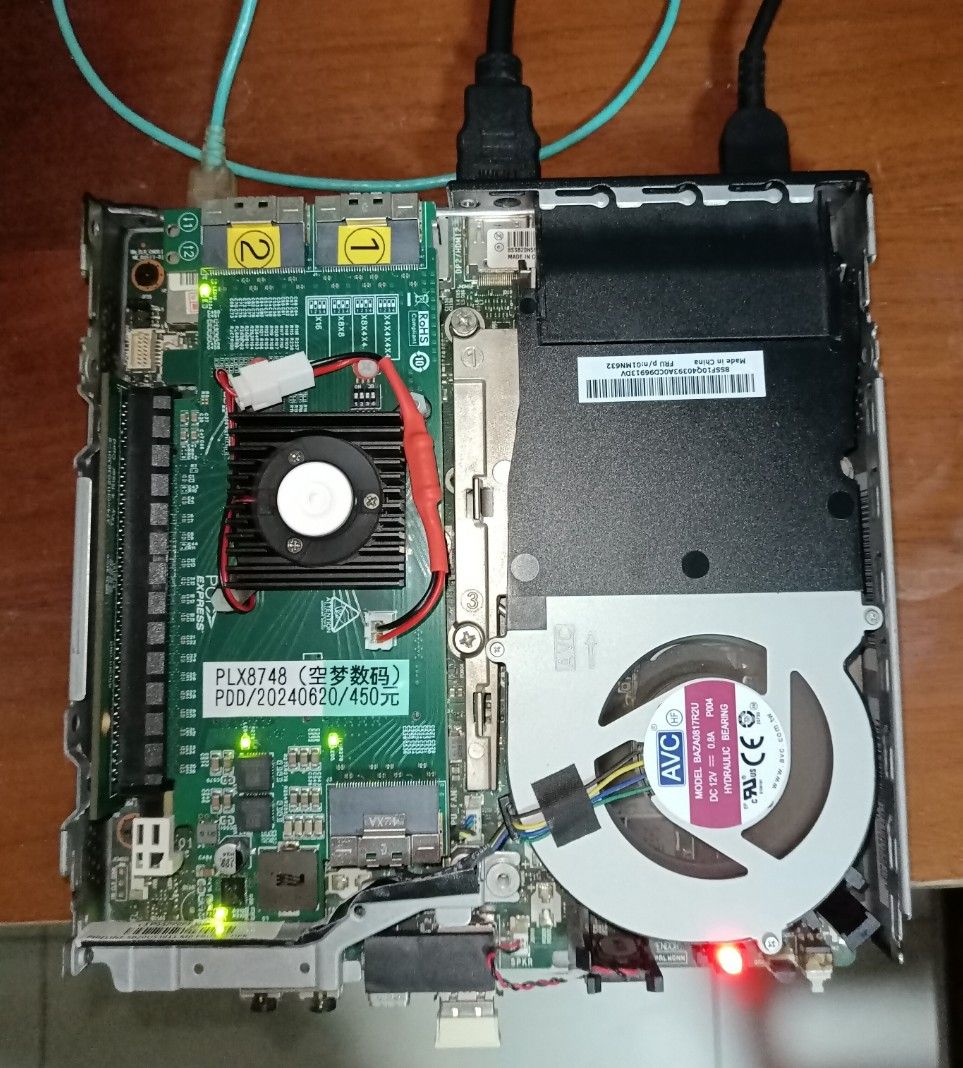
搞了个开放式机架, 折腾了好一阵, 勉强装好了.
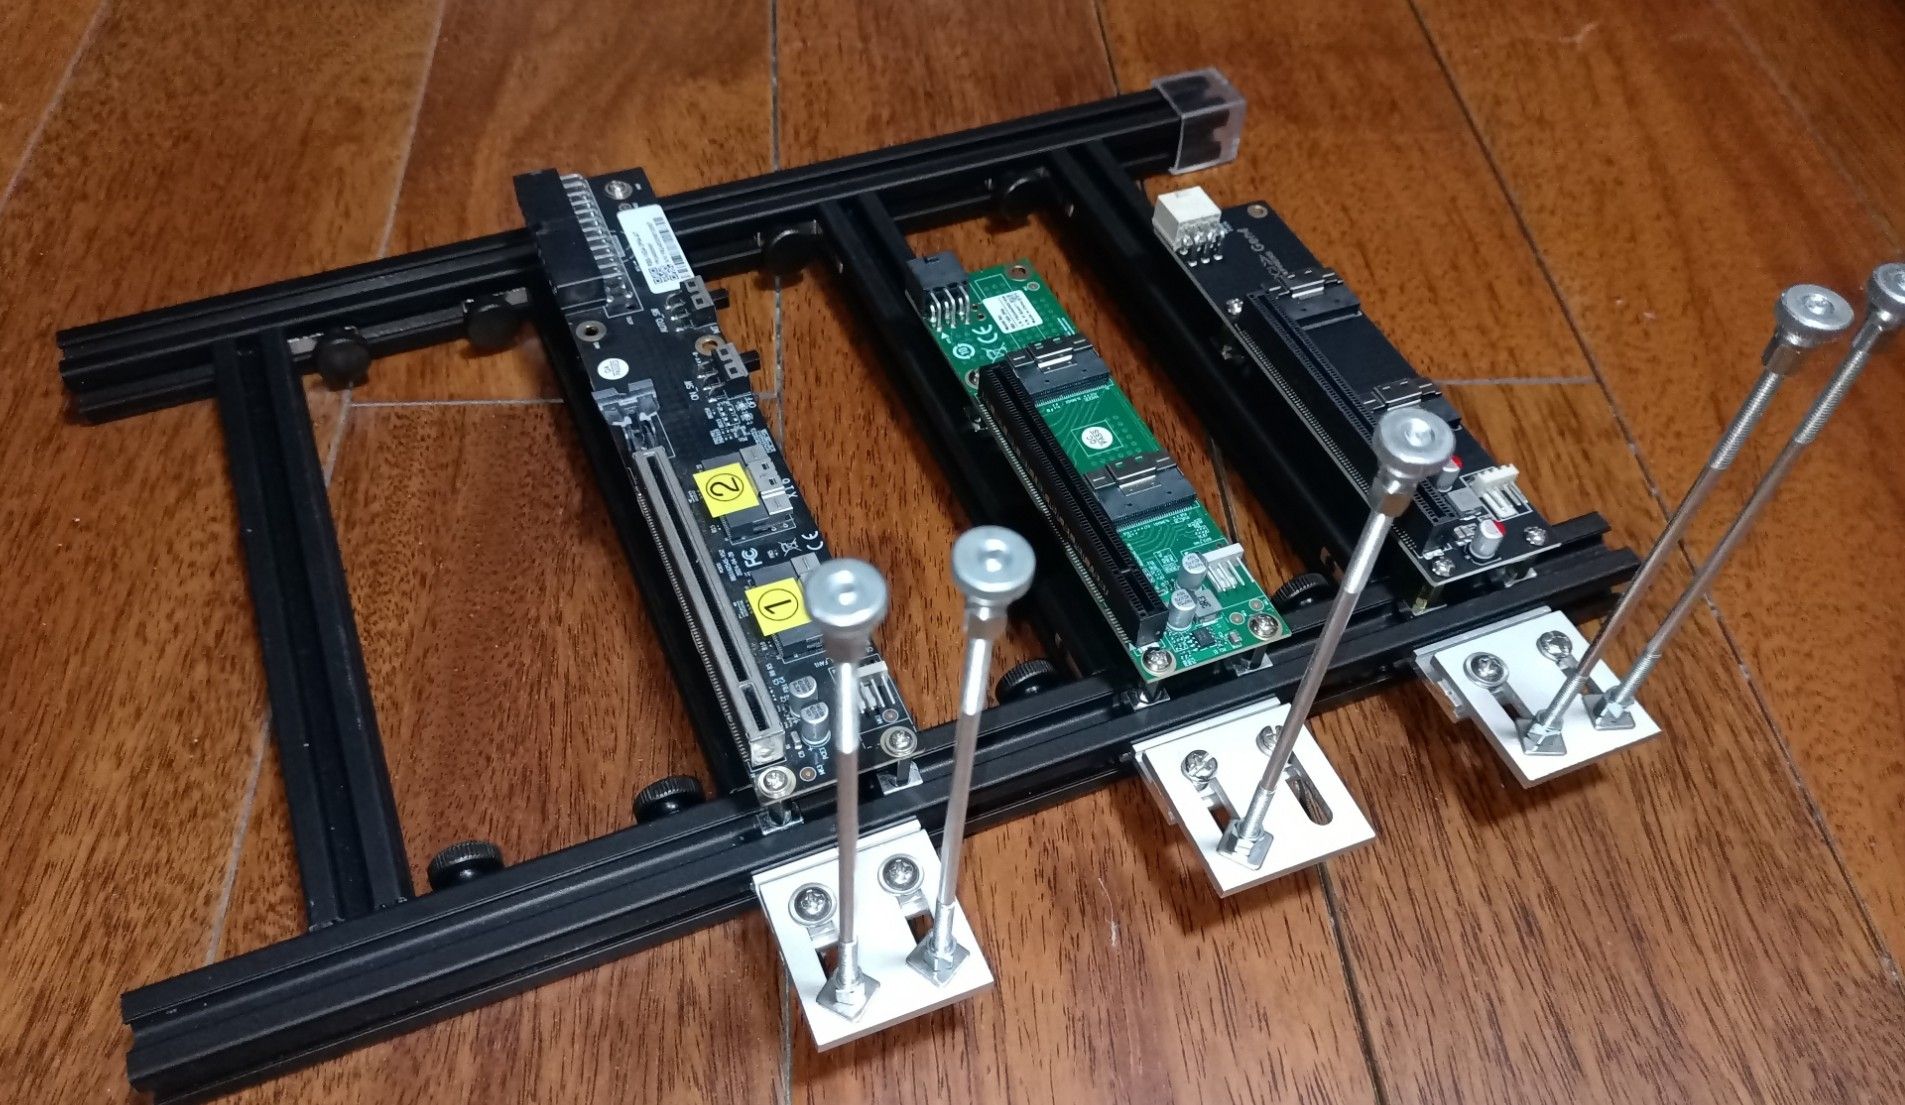
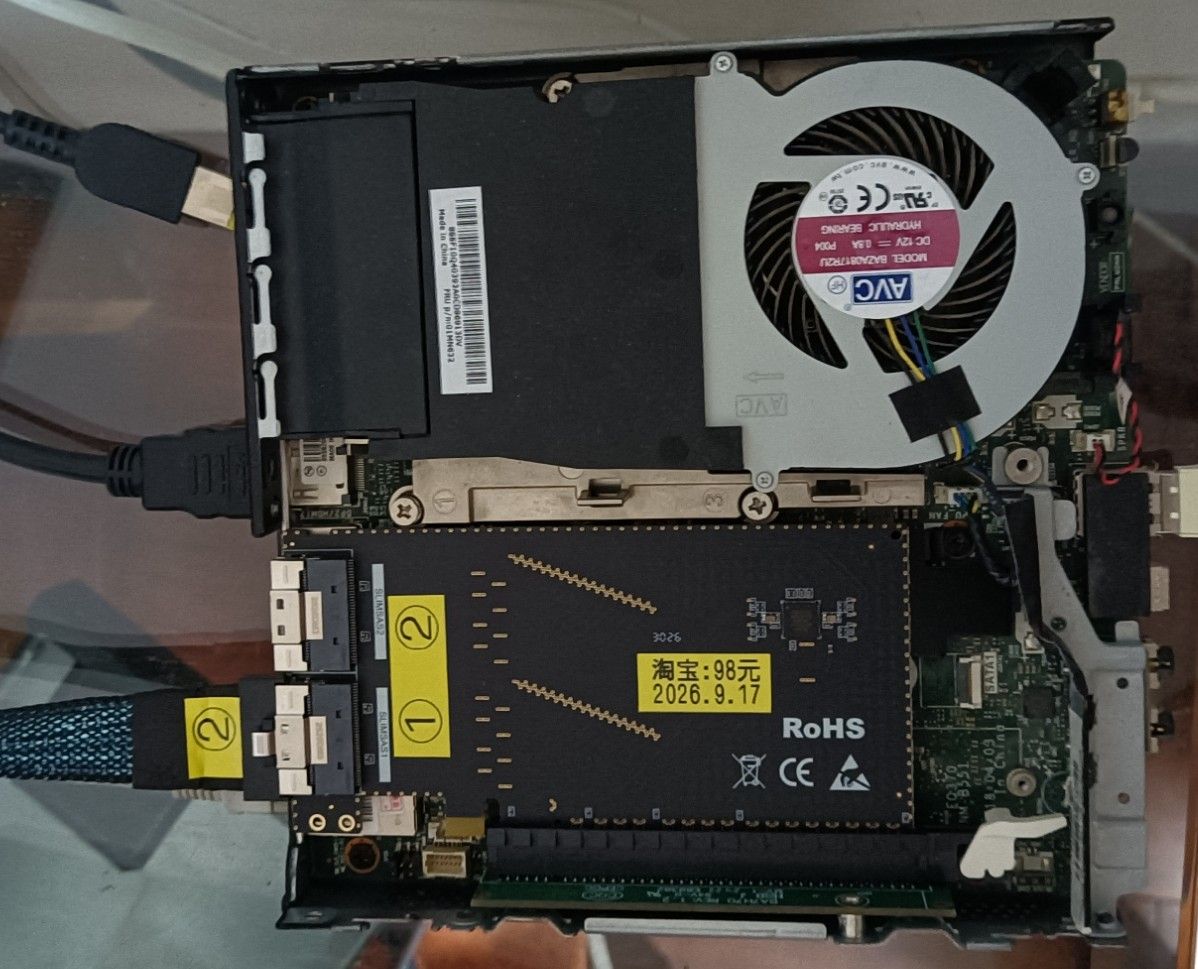
pci switch 卡由于散热片太高, 小主机盖不上. 所以又弄了个转接卡, 好在都是便宜货, 值不了多少钱, 就是瞎折腾

今天还发现那张闲鱼卡, 当功耗超过300w时有一点高频噪音, 不知道什么原理.
-
-
,
 T terry 固定了此主题
-
-
-
搞了个开放式机架, 折腾了好一阵, 勉强装好了.
pci switch 卡由于散热片太高, 小主机盖不上. 所以又弄了个转接卡, 好在都是便宜货, 值不了多少钱, 就是瞎折腾
今天还发现那张闲鱼卡, 当功耗超过300w时有一点高频噪音, 不知道什么原理.
-
-
搞了个开放式机架, 折腾了好一阵, 勉强装好了.
pci switch 卡由于散热片太高, 小主机盖不上. 所以又弄了个转接卡, 好在都是便宜货, 值不了多少钱, 就是瞎折腾
今天还发现那张闲鱼卡, 当功耗超过300w时有一点高频噪音, 不知道什么原理.
-
-
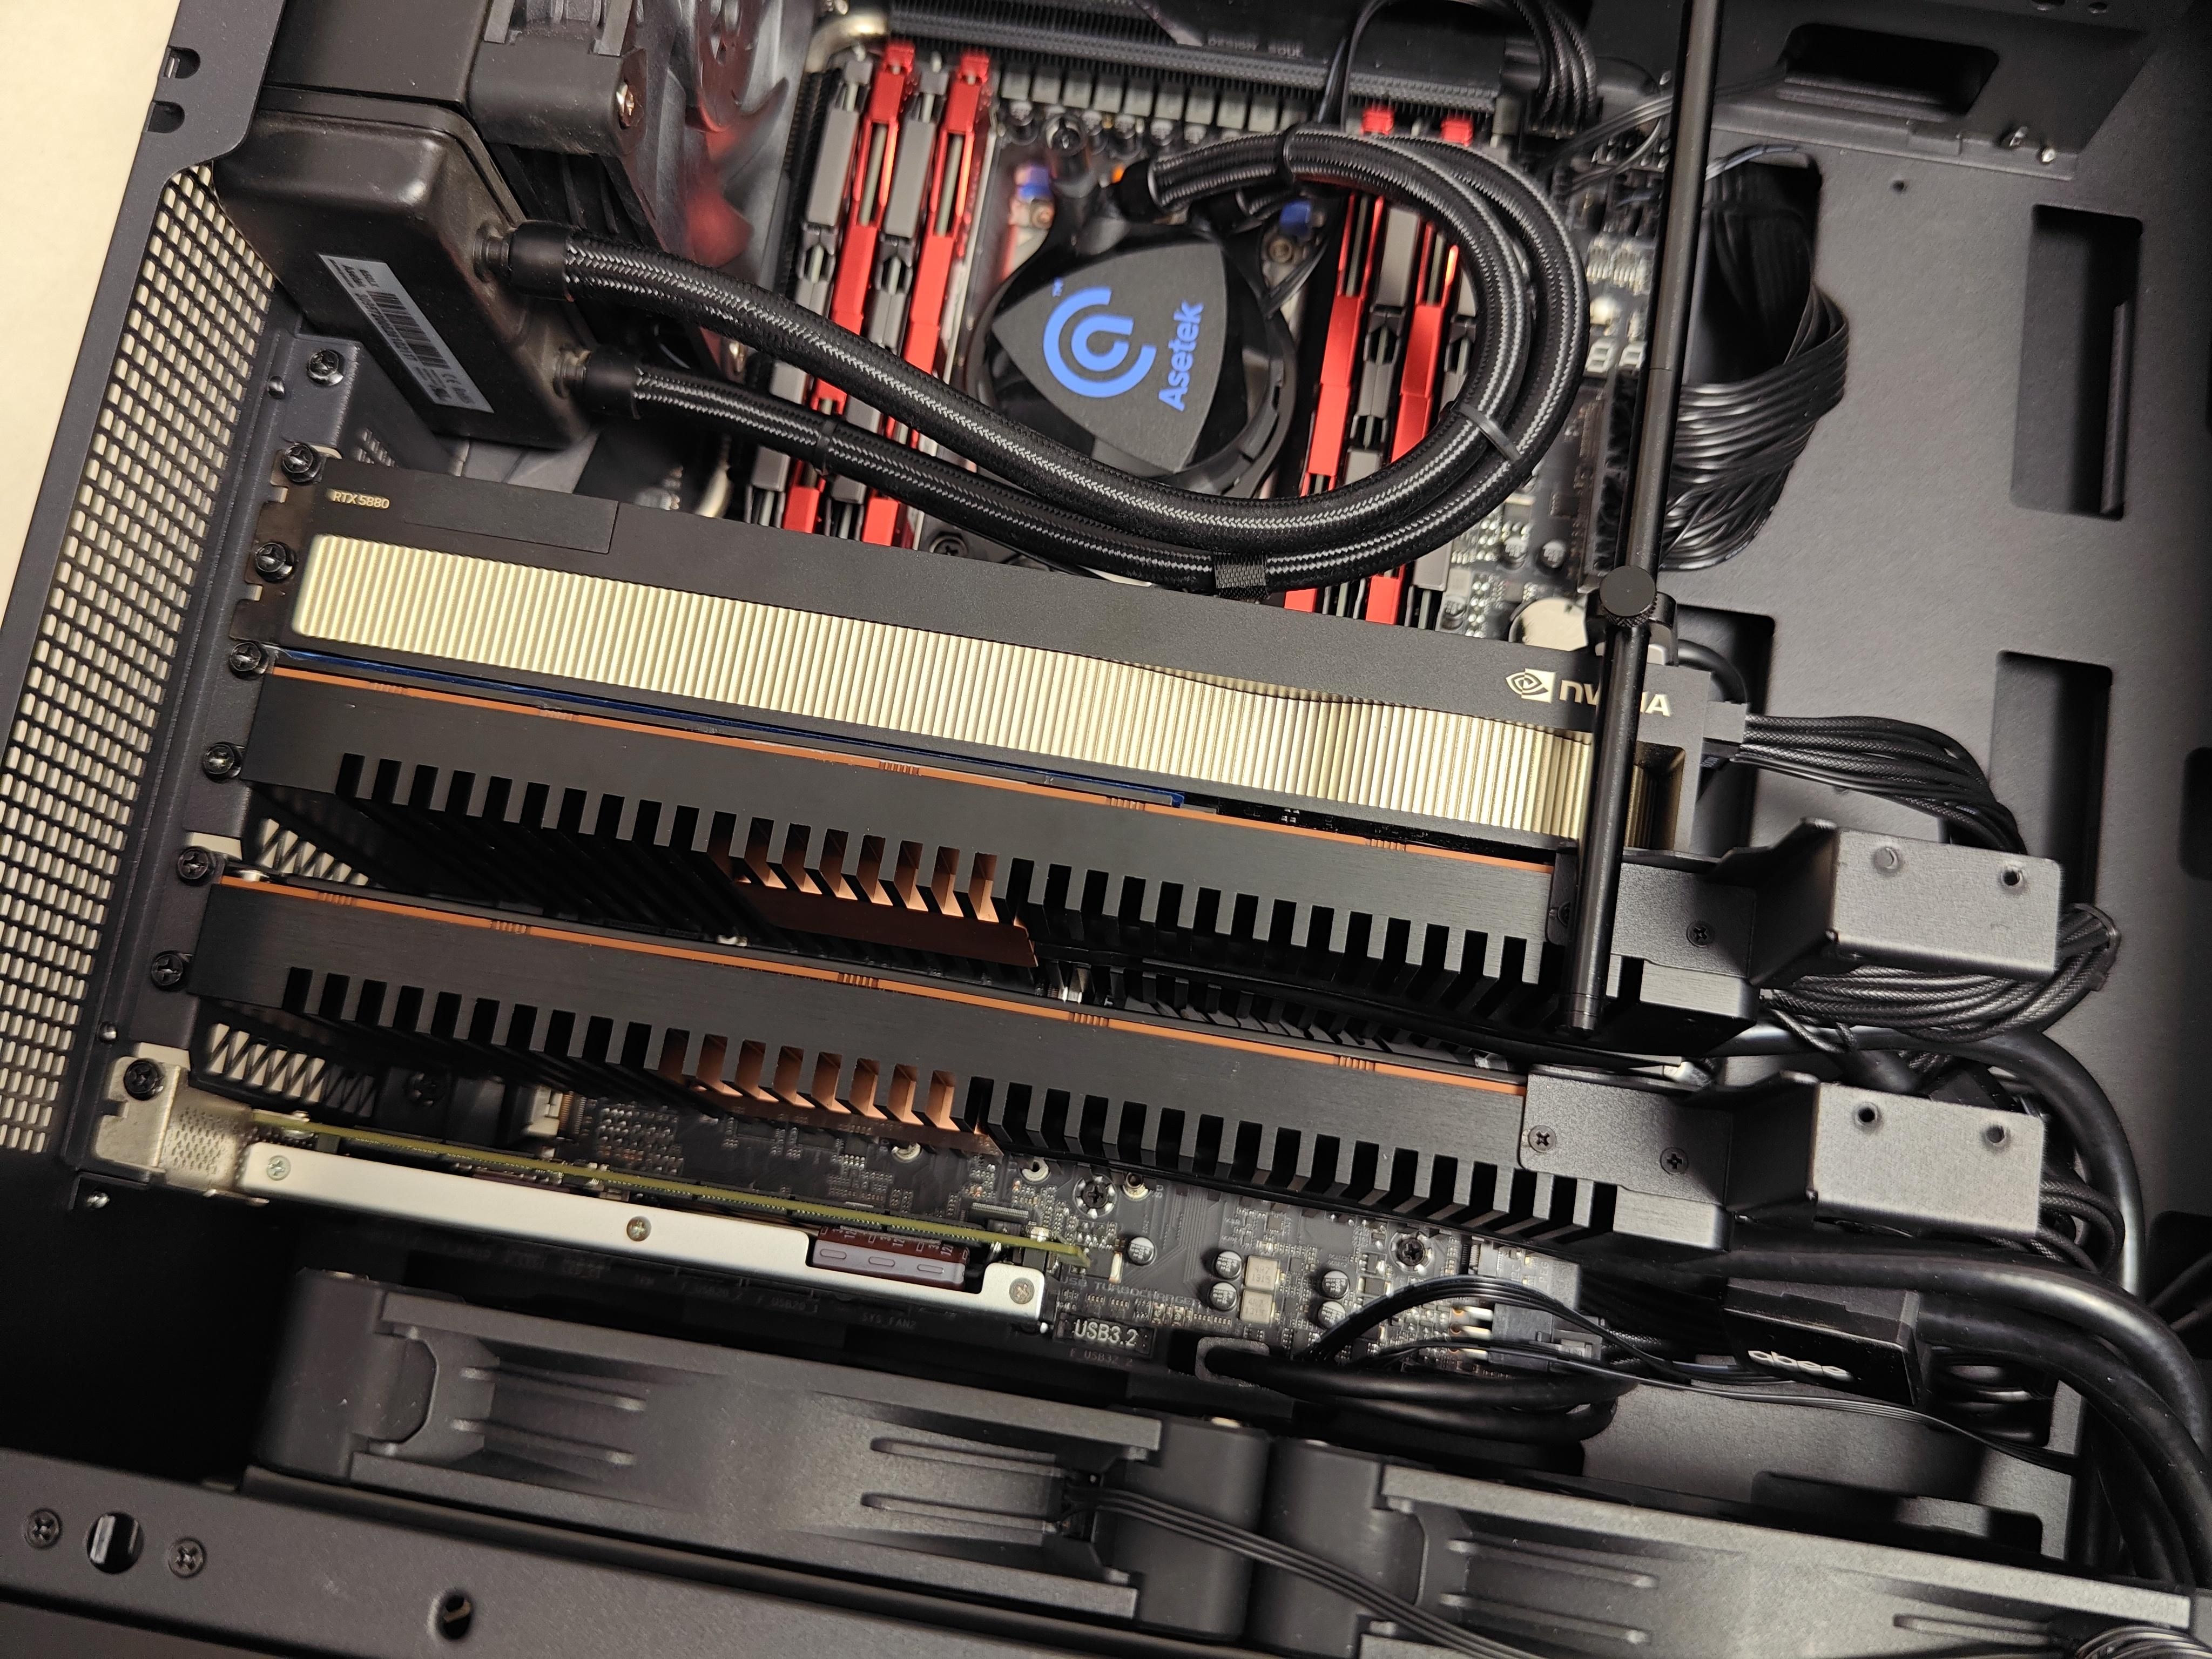
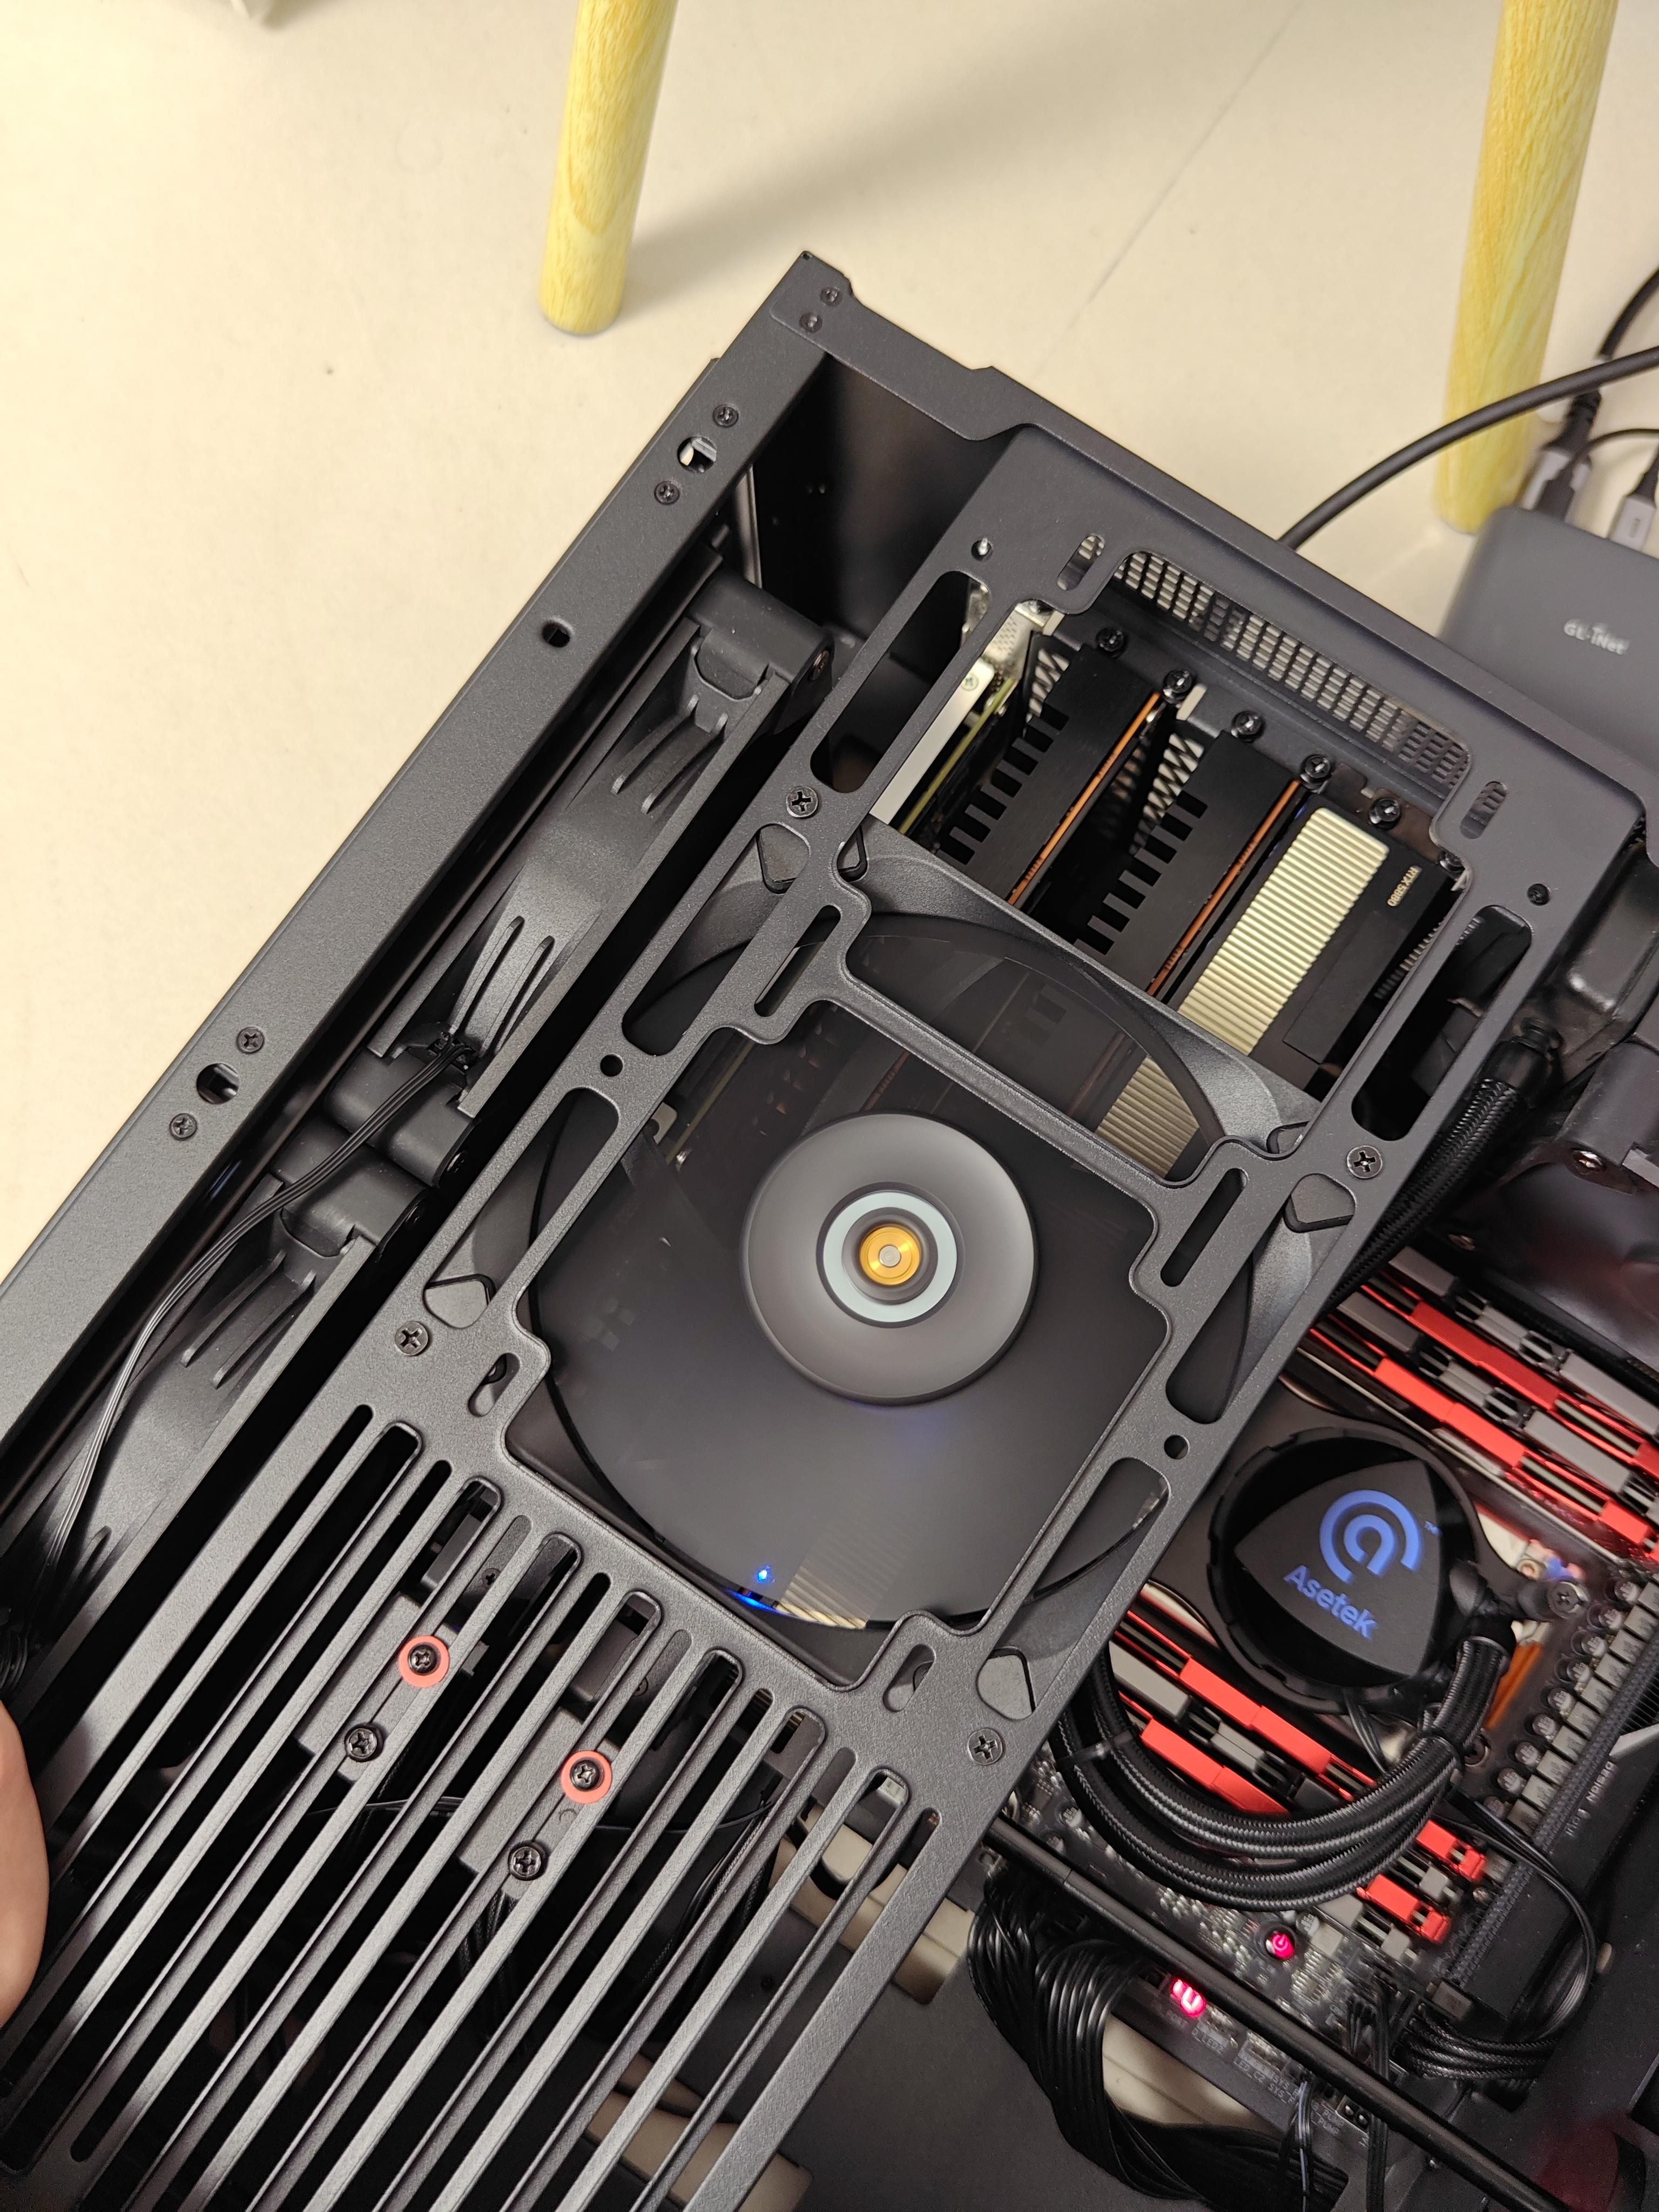
刚看过油管视频,过来分享一下我的双卡硬件思路。要同时解决体积和散热还是得改液冷,广东室温30度,两张A卡跑满,结温不高于80度。冷排风扇和侧板风扇都是160的,恒定700转,距离1米以上听不到任何声音。当然改液冷对咱们普通消费者来说往往意味着丧失质保,这一点需要取舍,但是使用感受真的是比风冷好太多了。顺带提醒一个坑,冷板一定要全铜焊接的,不要用其他材质,也不要用密封圈锁固的密封方式,现在配件价格这么高,一旦漏液就不值当了。 -
m920x这个pcie是复合插槽,可以拆分为一个cpu直通的16x加一个走南桥pch的4x,雷电模块走的就是这个pch 4x。网上有卖转接卡,支持同时输出这2个插槽。一般玩法是pcie 16x通过oculink接显卡坞,pch这个转雷电3再接一个雷电显卡坞,不过成本比较好,推荐接m2硬盘就行了。