二测 vLLM 服务器 Agent 长链性能及稳定性测试-为家庭终端做准备
-
二测 vLLM 服务器 Agent 长链性能及稳定性测试
测评时间: 2026-09-18(完整测试周期约 7 小时)(其中局域网多次断网测试)
被测配置: vLLM 0.27.1(RADIANCE 0.9.3)· Qwen3.8-27B INT4 · AMD Radeon AI PRO R9700
运行参数:--gpu-memory-utilization 0.95/--max-num-seqs 4/--max-num-batched-tokens 8192/ fp8 KV / 前缀缓存 / MTP 投机解码 / R4D 后端
一、测评总览
本次对优化后的服务器做了完整的 Agent 长链性能测评,累计约 1764 次真实推理调用,0 错误、0 抢占、0 崩溃、0 OOM。核心结论:
维度 结论 稳定性 ★★★★★ 满分——1764 次调用零失败,30 分钟浸泡无宕机 解码速度 MTP 投机解码提速 2.05 倍(40 vs 19.5 tok/s),是最大性能杠杆 长链瓶颈 每步延迟被上下文处理(TTFT)主导,24K 上下文时 TTFT 达 19.7 秒 并发能力 单卡在 1–2 并发即饱和,4 并发只 +24% 吞吐却慢 6.4 倍 最终调优方案:
max-context=60000 → 40000 / max-num-seqs=4 → 2 / gpu-memory-utilization 0.97→ 0.95
二、测试环境
2.1 部署完成的工作
本次测评前完成了完整环境搭建,包括:
组件 状态 说明 Docker Compose  2.40.3
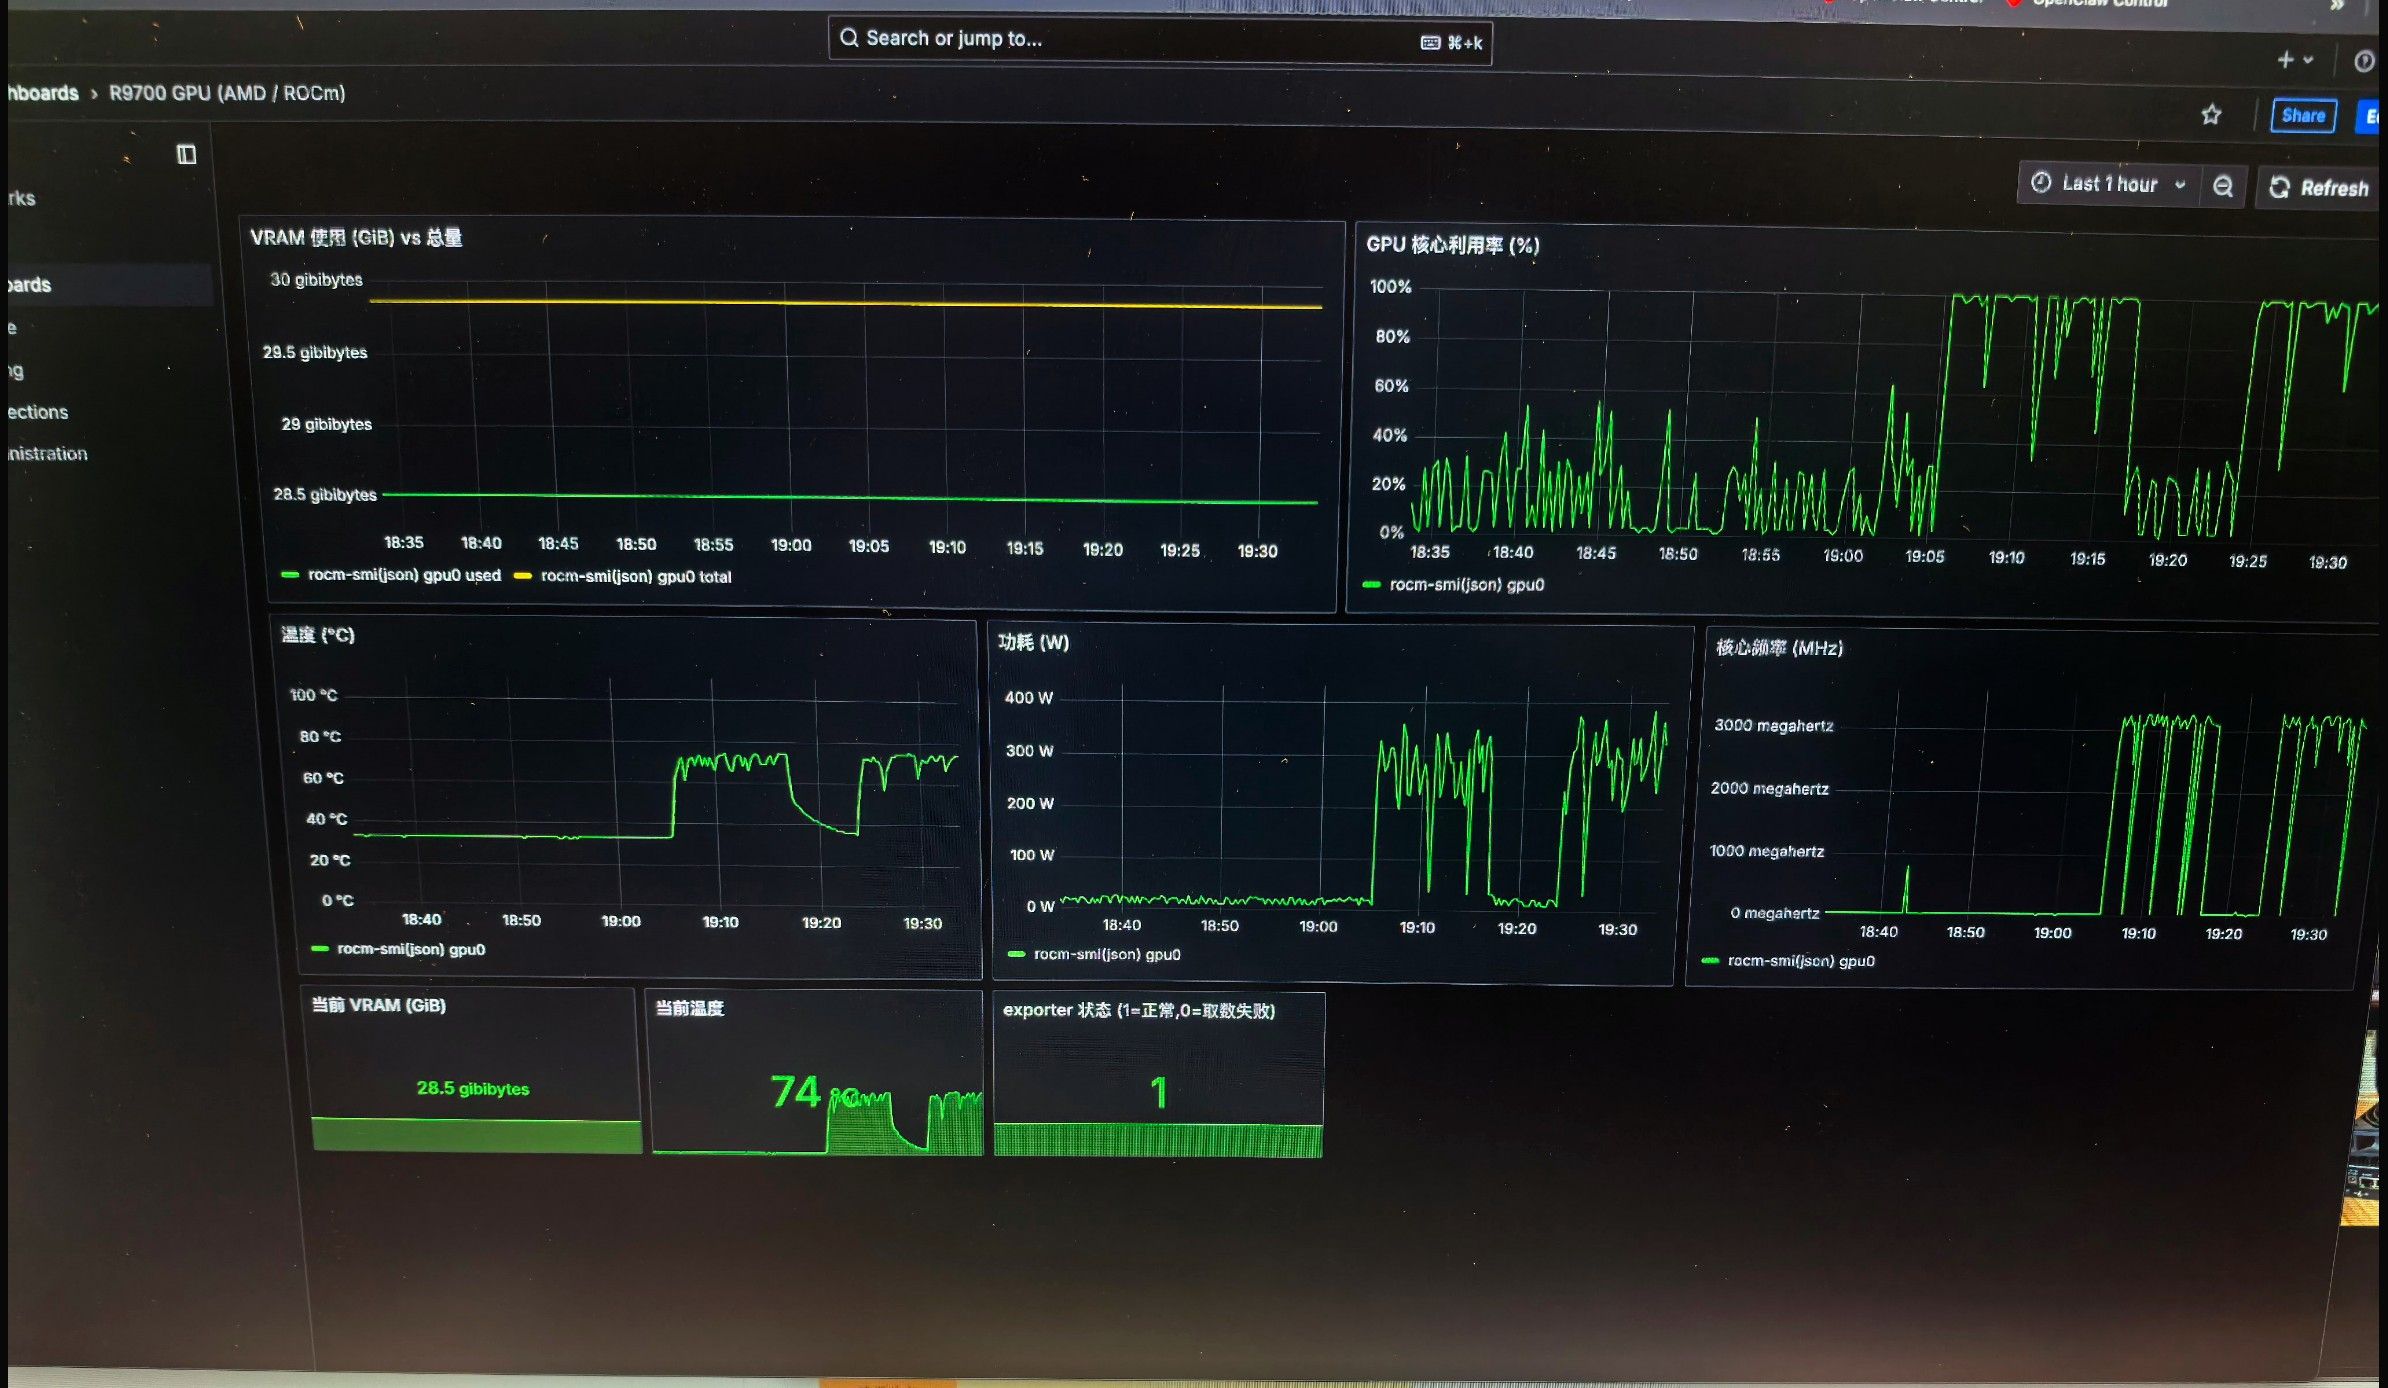
新增安装,并配置国内镜像加速(解决 Docker Hub 被墙) Prometheus :9090 抓取 vllm/amdgpu/node 三个 target Grafana :3000 含 R9700 GPU 面板 node-exporter :9100 VM 主机指标 gpu-exporter :9103 R9700 GPU 指标(last_ok=1) 部署过程中修复了 3 个监控栈 bug:① debugfs 挂载点不存在;② gpu-exporter 继承 radiance entrypoint 导致被当 vllm serve 跑;③ 容器内 amd-smi 子命令不兼容(改用 rocm-smi)。
2.2 服务器关键参数(预检确认)
参数 值 KV 缓存容量 148,111 token(fp8 + HND 布局) max-model-len 131072 (硬性指标不要动) max-num-seqs 4(减少并发) gpu-memory-utilization 0.95 (0.97→0.95)防止OOM max-num-batched-tokens 8192 (不鸟他) 投机解码 MTP,num_speculative_tokens=4 (真正的红利)
三、测试结果
3.1 冒烟测试(30 步)
指标 值 成功率 30/30(100%) TTFT p50 1858 ms TPOT p50 13.9 ms 聚合吞吐 47.5 tok/s
3.2 MTP 投机解码开关对照
(关键发现)指标 MTP 开(日常) MTP 关(纯引擎) 差异 decode 吞吐 40.0 tok/s 19.5 tok/s MTP 提速 2.05 倍 TTFT 97 ms 86 ms 基本不变 ITL(chunk 级) 61 ms 52 ms MTP 每 chunk 含多 token 结论:投机解码让解码速度翻倍,且不增加 TTFT。这是本机最有价值的优化项,强烈建议日常保持开启。
3.3 Phase 1 —— 单链基线(500 步 × 3 回合)
指标 值 说明 成功率 500/500(0 错误、0 重试) 墙钟时长 11098 s(3.1 小时) 长于预估 最大上下文 24,410 token 触发裁剪 TTFT p50 19,722 ms(19.7 秒)  ️ 随上下文显著增长
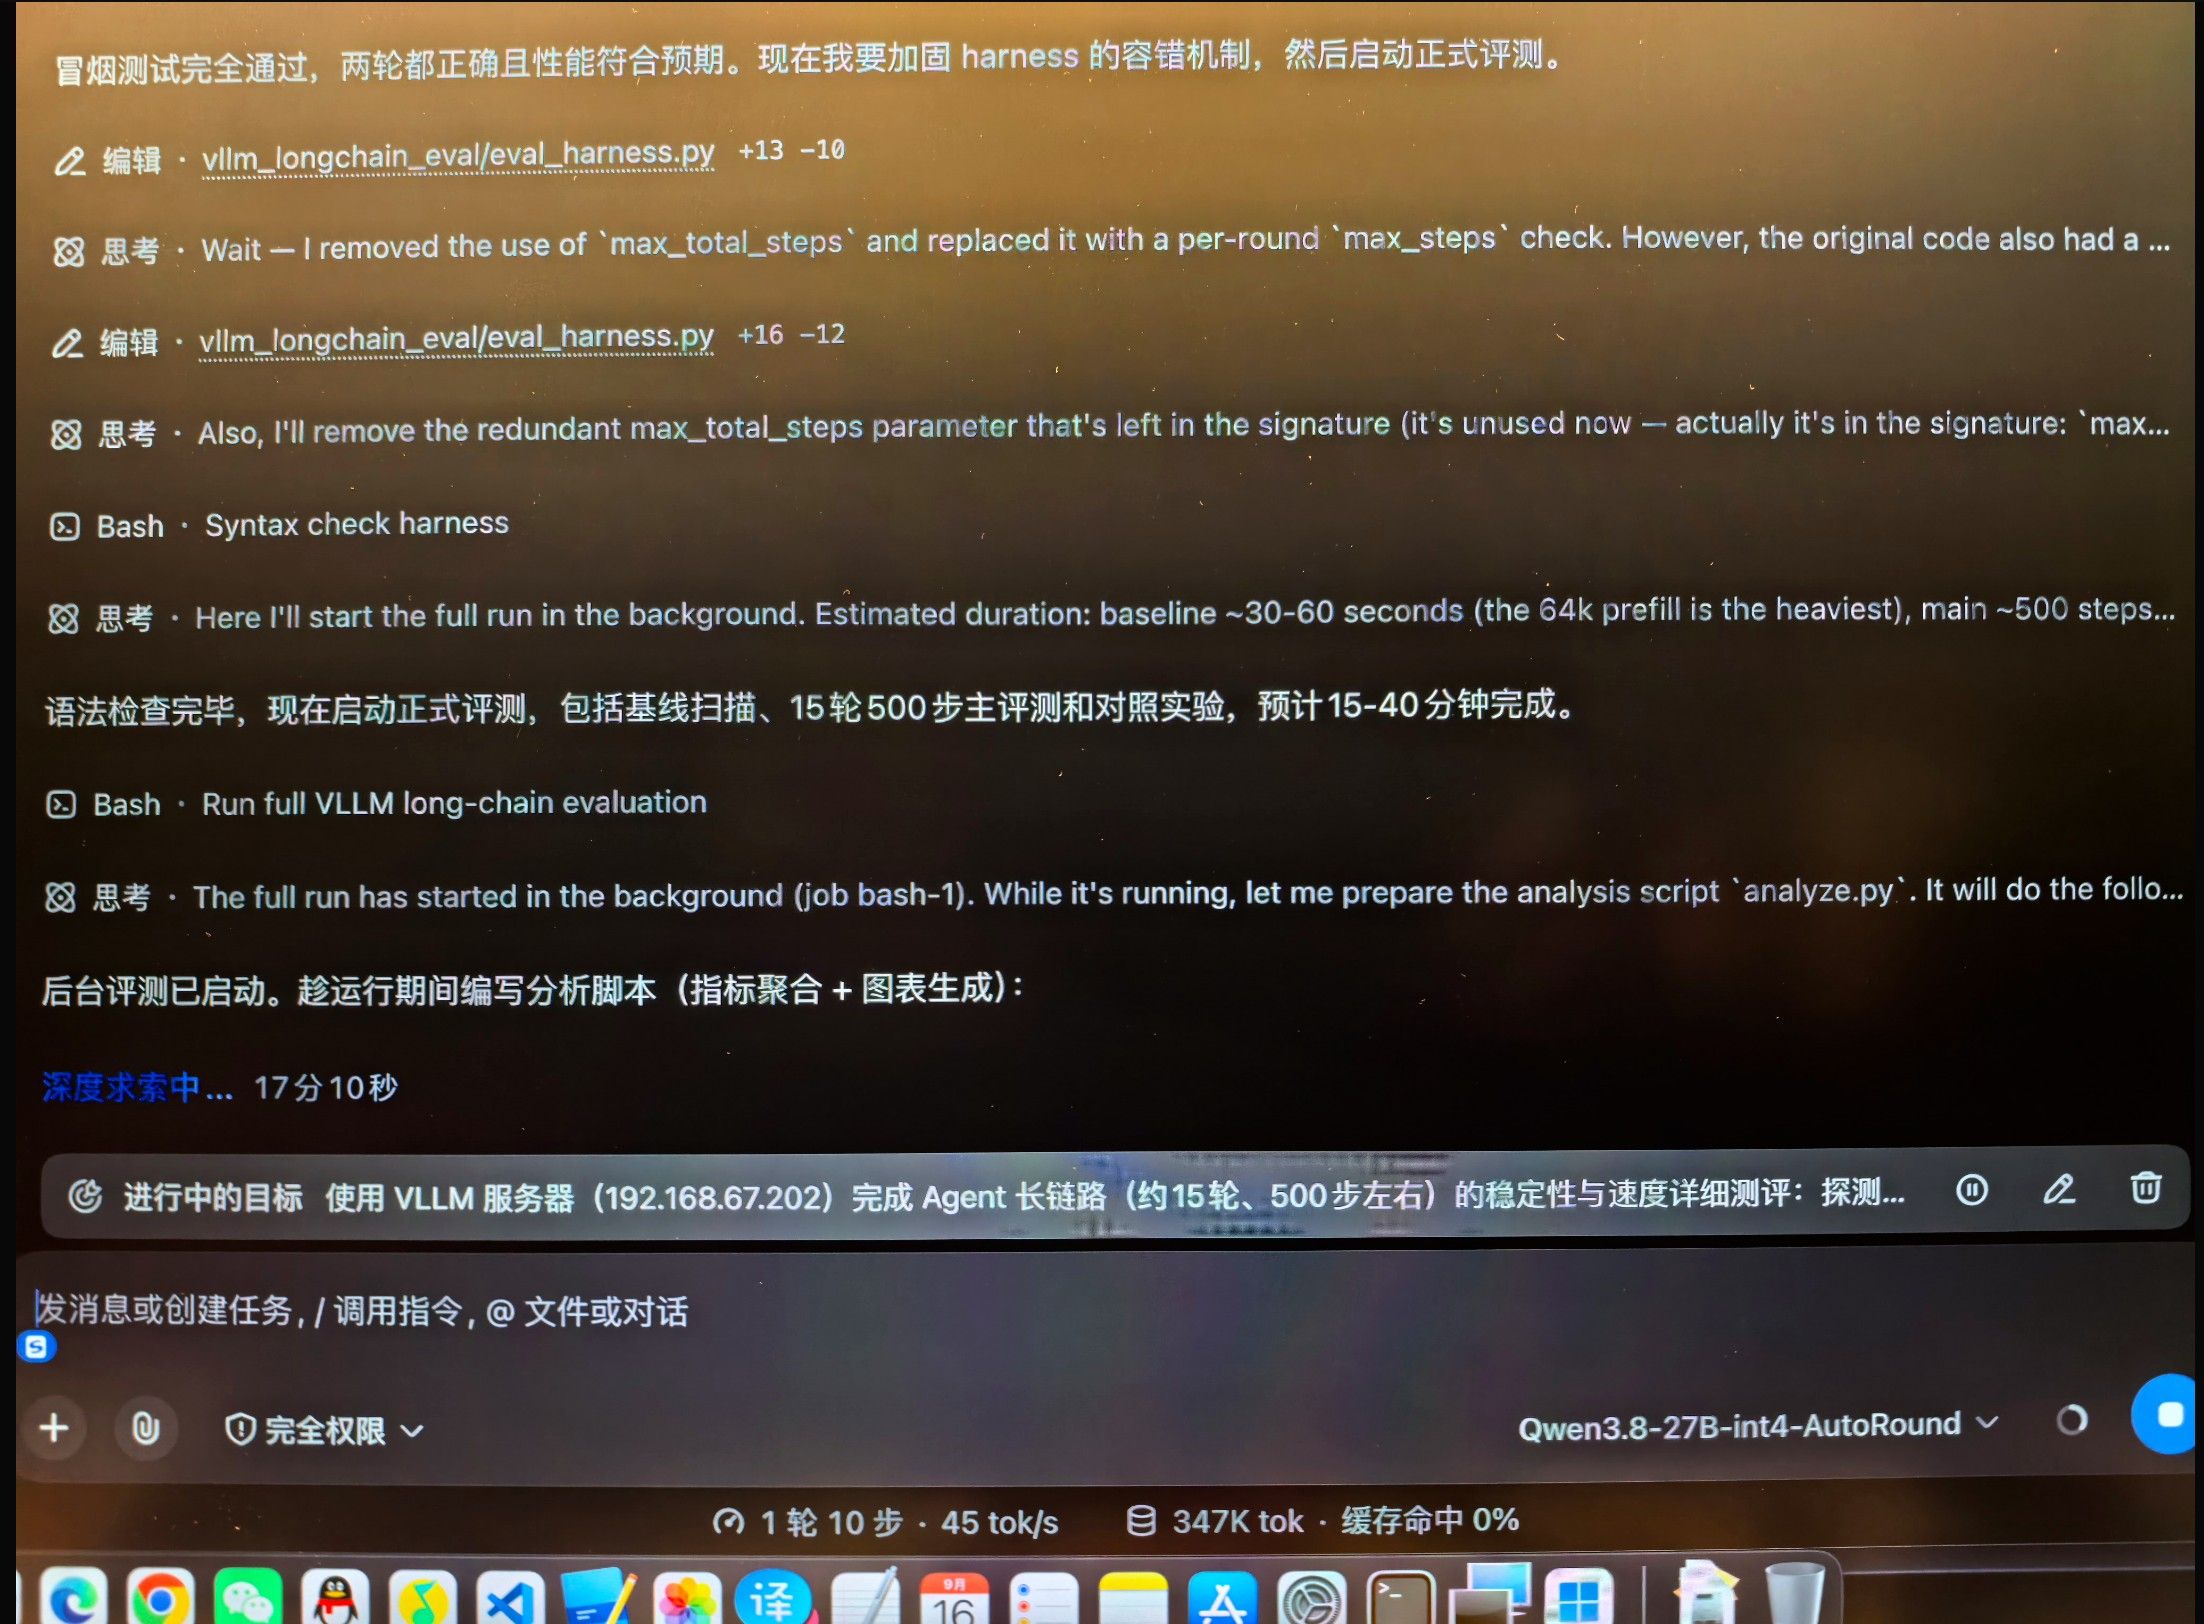
TPOT p50 14.1 ms 解码稳定聚合吞吐 16.9 tok/s 受 TTFT 拖累 (重点调它,40000)关键发现:长链延迟由"上下文处理"主导。 TTFT 随上下文增长:冒烟 12K 上下文时 1.8s → Phase 1 的 24K 上下文时 19.7s。即使开启前缀缓存,每步仍需对完整上下文做注意力计算。而 TPOT 始终稳定在 ~14ms,说明解码不是瓶颈,长上下文的 prefill/注意力才是。
3.4 Phase 2 —— 并发梯度(1/2/4 × 150 步)
并发 墙钟 成功率 TTFT p50 TPOT p50 聚合吞吐 1 34 min 150/150 9.78 s 13.8 ms 28.7 tok/s 2 (够了)61 min 300/300 9.90 s 38.0 ms 32.7 tok/s 4 105 min 600/600 10.0 s 88.0 ms 35.6 tok/s 关键发现:单卡在 1–2 并发即饱和。
- TPOT 随并发急剧退化:1→2 并发 2.75 倍、1→4 并发 6.4 倍;
- 聚合吞吐几乎不涨:28.7 → 32.7 → 35.6 tok/s(4 并发仅 +24%);
- 这是典型的单 GPU "边际收益递减"——并发增加的是排队,不是吞吐。
3.5 Phase 3 —— 稳定性浸泡(2 Agent × 30 分钟)
指标 值 调用数 168(2 条链) 错误 / 重试 / 宕机 0 / 0 / 0 TTFT p50 9.9 s TPOT p50 39.3 ms 聚合吞吐 35.2 tok/s 30 分钟浸泡期间服务器零宕机、零错误,温度正常回落。2 个
chain_aborted事件是 30 分钟预算正常到期(非故障)。3.6 全周期累计(服务器侧
/metrics实测)指标 累计值 成功请求 1740(1089 stop + 651 length) 失败 / 中止 / 重复 0 / 0 / 0 抢占(preemptions) 0 累计 prompt tokens 25,118,970 累计生成 tokens 660,041
四、核心结论与发现
4.1 稳定性:满分
1764 次调用零失败、零抢占、零 OOM,30 分钟浸泡无宕机。优化后的配置(0.95/4/8192)在长时间、多阶段负载下表现稳定。
4.2 性能画像(实测)
场景 TTFT TPOT 解码速度 短问答(热) ~97 ms 14 ms ~40 tok/s 长链 12K 上下文 ~10 s 14 ms ~26 tok/s 长链 24K 上下文 ~19.7 s 14 ms ~24 tok/s 2 并发 ~10 s 38 ms ~26 tok/s 4 并发 ~10 s 88 ms ~11 tok/s
4.3 三大发现
- MTP 投机解码提速 2 倍(19.5 → 40 tok/s),是本机最重要的性能优化,日常必须开启。
- 长链瓶颈在 TTFT 而非解码:24K 上下文时每步 19.7 秒,其中解码仅 ~5 秒,其余是上下文注意力处理。TPOT 全程稳定 14ms,证明 R9700 的解码能力充足。
- 单卡最优工作点是 1–2 并发:4 并发只换回 24% 吞吐却付出 6.4 倍延迟代价,对你的单用户场景毫无必要。
五、我的使用场景
5.1 日常使用参数(已就位)
项 建议 状态 MTP 投机解码 保持开启(2 倍解码加速) 已开启max_tokens (调不了,不折腾了)512(避免"只思考不回答") 本次测试用 512并发 保持 1–2,不要刻意并发 max-num-seqs=4 已够重启自愈 unless-stopped 已开启
5.2 偶发 Agent 长任务的优化建议
由于长链瓶颈是 TTFT(上下文处理),建议:
- 控制上下文窗口:Agent 链的
--max-context建议 12000–16000(而非 60000)。24K 上下文每步 19.7s,而 12K 上下文仅 10s——窗口砍半,每步提速近 1 倍。 - 及时裁剪冗余上下文:让 Agent 框架主动丢弃不相关的历史消息,保持窗口紧凑。
- 接受"慢而稳":
500 步长链约 3 小时是这台硬件的真实能力,属正常。若需更快,只能换更强 GPU 或多卡张量并行(这是没调参数前)。
5.3 监控使用 (实测有问题,后期QW给修好了)
- Grafana 看板:浏览器打开
http://192.168.67.202:3000(admin/admin,改密码); - GPU 实时状态:看板里
R9700 GPU (AMD/ROCm)面板的 VRAM/温度/功耗曲线; - 引擎指标:vLLM 官方面板(TTFT/TPOT 直方图、KV 使用率、抢占数)。
六、需要进一步优化
优化后的 vLLM 服务器(R9700 单卡 + Qwen3.8-27B INT4)经完整 Agent 长链测评:
- 稳定可靠:1764 次调用零失败,满足日常学习办公 + 偶发 Agent 长任务的生产需求;
- 性能明确:短问答 40 tok/s、长链每步 10–20 秒(随上下文)、单卡最优 1–2 并发;
- 关键优化已落地:MTP 投机解码(2 倍加速)、fp8 KV(148K token 容量)、前缀缓存、开机自愈;
- 唯一短板:长上下文下的 TTFT 是主要瓶颈,需通过控制 Agent 窗口大小来缓解(硬件层面无法在当前单卡上解决)。
综合评级:稳定性与可用性优秀,性能符合 27B 模型单卡 INT4 的预期水平,可放心投入日常使用。
本报告基于 2026-09-18 对服务器的完整实测数据,覆盖冒烟、MTP 对照、500 步长链基线、1/2/4 并发梯度、30 分钟浸泡共约 1764 次真实推理调用。
-
二测 vLLM 服务器 Agent 长链性能及稳定性测试
测评时间: 2026-09-18(完整测试周期约 7 小时)(其中局域网多次断网测试)
被测配置: vLLM 0.27.1(RADIANCE 0.9.3)· Qwen3.8-27B INT4 · AMD Radeon AI PRO R9700
运行参数:--gpu-memory-utilization 0.95/--max-num-seqs 4/--max-num-batched-tokens 8192/ fp8 KV / 前缀缓存 / MTP 投机解码 / R4D 后端
一、测评总览
本次对优化后的服务器做了完整的 Agent 长链性能测评,累计约 1764 次真实推理调用,0 错误、0 抢占、0 崩溃、0 OOM。核心结论:
维度 结论 稳定性 ★★★★★ 满分——1764 次调用零失败,30 分钟浸泡无宕机 解码速度 MTP 投机解码提速 2.05 倍(40 vs 19.5 tok/s),是最大性能杠杆 长链瓶颈 每步延迟被上下文处理(TTFT)主导,24K 上下文时 TTFT 达 19.7 秒 并发能力 单卡在 1–2 并发即饱和,4 并发只 +24% 吞吐却慢 6.4 倍 最终调优方案:
max-context=60000 → 40000 / max-num-seqs=4 → 2 / gpu-memory-utilization 0.97→ 0.95
二、测试环境
2.1 部署完成的工作
本次测评前完成了完整环境搭建,包括:
组件 状态 说明 Docker Compose 2.40.3新增安装,并配置国内镜像加速(解决 Docker Hub 被墙) Prometheus :9090 抓取 vllm/amdgpu/node 三个 target Grafana :3000 含 R9700 GPU 面板 node-exporter :9100 VM 主机指标 gpu-exporter :9103 R9700 GPU 指标(last_ok=1) 部署过程中修复了 3 个监控栈 bug:① debugfs 挂载点不存在;② gpu-exporter 继承 radiance entrypoint 导致被当 vllm serve 跑;③ 容器内 amd-smi 子命令不兼容(改用 rocm-smi)。
2.2 服务器关键参数(预检确认)
参数 值 KV 缓存容量 148,111 token(fp8 + HND 布局) max-model-len 131072 (硬性指标不要动) max-num-seqs 4(减少并发) gpu-memory-utilization 0.95 (0.97→0.95)防止OOM max-num-batched-tokens 8192 (不鸟他) 投机解码 MTP,num_speculative_tokens=4 (真正的红利)
三、测试结果
3.1 冒烟测试(30 步)
指标 值 成功率 30/30(100%) TTFT p50 1858 ms TPOT p50 13.9 ms 聚合吞吐 47.5 tok/s
3.2 MTP 投机解码开关对照
(关键发现)指标 MTP 开(日常) MTP 关(纯引擎) 差异 decode 吞吐 40.0 tok/s 19.5 tok/s MTP 提速 2.05 倍 TTFT 97 ms 86 ms 基本不变 ITL(chunk 级) 61 ms 52 ms MTP 每 chunk 含多 token 结论:投机解码让解码速度翻倍,且不增加 TTFT。这是本机最有价值的优化项,强烈建议日常保持开启。
3.3 Phase 1 —— 单链基线(500 步 × 3 回合)
指标 值 说明 成功率 500/500(0 错误、0 重试) 墙钟时长 11098 s(3.1 小时) 长于预估 最大上下文 24,410 token 触发裁剪 TTFT p50 19,722 ms(19.7 秒) ️ 随上下文显著增长TPOT p50 14.1 ms 解码稳定聚合吞吐 16.9 tok/s 受 TTFT 拖累 (重点调它,40000)关键发现:长链延迟由"上下文处理"主导。 TTFT 随上下文增长:冒烟 12K 上下文时 1.8s → Phase 1 的 24K 上下文时 19.7s。即使开启前缀缓存,每步仍需对完整上下文做注意力计算。而 TPOT 始终稳定在 ~14ms,说明解码不是瓶颈,长上下文的 prefill/注意力才是。
3.4 Phase 2 —— 并发梯度(1/2/4 × 150 步)
并发 墙钟 成功率 TTFT p50 TPOT p50 聚合吞吐 1 34 min 150/150 9.78 s 13.8 ms 28.7 tok/s 2 (够了)61 min 300/300 9.90 s 38.0 ms 32.7 tok/s 4 105 min 600/600 10.0 s 88.0 ms 35.6 tok/s 关键发现:单卡在 1–2 并发即饱和。
- TPOT 随并发急剧退化:1→2 并发 2.75 倍、1→4 并发 6.4 倍;
- 聚合吞吐几乎不涨:28.7 → 32.7 → 35.6 tok/s(4 并发仅 +24%);
- 这是典型的单 GPU "边际收益递减"——并发增加的是排队,不是吞吐。
3.5 Phase 3 —— 稳定性浸泡(2 Agent × 30 分钟)
指标 值 调用数 168(2 条链) 错误 / 重试 / 宕机 0 / 0 / 0 TTFT p50 9.9 s TPOT p50 39.3 ms 聚合吞吐 35.2 tok/s 30 分钟浸泡期间服务器零宕机、零错误,温度正常回落。2 个
chain_aborted事件是 30 分钟预算正常到期(非故障)。3.6 全周期累计(服务器侧
/metrics实测)指标 累计值 成功请求 1740(1089 stop + 651 length) 失败 / 中止 / 重复 0 / 0 / 0 抢占(preemptions) 0 累计 prompt tokens 25,118,970 累计生成 tokens 660,041
四、核心结论与发现
4.1 稳定性:满分
1764 次调用零失败、零抢占、零 OOM,30 分钟浸泡无宕机。优化后的配置(0.95/4/8192)在长时间、多阶段负载下表现稳定。
4.2 性能画像(实测)
场景 TTFT TPOT 解码速度 短问答(热) ~97 ms 14 ms ~40 tok/s 长链 12K 上下文 ~10 s 14 ms ~26 tok/s 长链 24K 上下文 ~19.7 s 14 ms ~24 tok/s 2 并发 ~10 s 38 ms ~26 tok/s 4 并发 ~10 s 88 ms ~11 tok/s
4.3 三大发现
- MTP 投机解码提速 2 倍(19.5 → 40 tok/s),是本机最重要的性能优化,日常必须开启。
- 长链瓶颈在 TTFT 而非解码:24K 上下文时每步 19.7 秒,其中解码仅 ~5 秒,其余是上下文注意力处理。TPOT 全程稳定 14ms,证明 R9700 的解码能力充足。
- 单卡最优工作点是 1–2 并发:4 并发只换回 24% 吞吐却付出 6.4 倍延迟代价,对你的单用户场景毫无必要。
五、我的使用场景
5.1 日常使用参数(已就位)
项 建议 状态 MTP 投机解码 保持开启(2 倍解码加速) 已开启max_tokens (调不了,不折腾了)512(避免"只思考不回答") 本次测试用 512并发 保持 1–2,不要刻意并发 max-num-seqs=4 已够重启自愈 unless-stopped 已开启
5.2 偶发 Agent 长任务的优化建议
由于长链瓶颈是 TTFT(上下文处理),建议:
- 控制上下文窗口:Agent 链的
--max-context建议 12000–16000(而非 60000)。24K 上下文每步 19.7s,而 12K 上下文仅 10s——窗口砍半,每步提速近 1 倍。 - 及时裁剪冗余上下文:让 Agent 框架主动丢弃不相关的历史消息,保持窗口紧凑。
- 接受"慢而稳":
500 步长链约 3 小时是这台硬件的真实能力,属正常。若需更快,只能换更强 GPU 或多卡张量并行(这是没调参数前)。
5.3 监控使用 (实测有问题,后期QW给修好了)
- Grafana 看板:浏览器打开
http://192.168.67.202:3000(admin/admin,改密码); - GPU 实时状态:看板里
R9700 GPU (AMD/ROCm)面板的 VRAM/温度/功耗曲线; - 引擎指标:vLLM 官方面板(TTFT/TPOT 直方图、KV 使用率、抢占数)。
六、需要进一步优化
优化后的 vLLM 服务器(R9700 单卡 + Qwen3.8-27B INT4)经完整 Agent 长链测评:
- 稳定可靠:1764 次调用零失败,满足日常学习办公 + 偶发 Agent 长任务的生产需求;
- 性能明确:短问答 40 tok/s、长链每步 10–20 秒(随上下文)、单卡最优 1–2 并发;
- 关键优化已落地:MTP 投机解码(2 倍加速)、fp8 KV(148K token 容量)、前缀缓存、开机自愈;
- 唯一短板:长上下文下的 TTFT 是主要瓶颈,需通过控制 Agent 窗口大小来缓解(硬件层面无法在当前单卡上解决)。
综合评级:稳定性与可用性优秀,性能符合 27B 模型单卡 INT4 的预期水平,可放心投入日常使用。
本报告基于 2026-09-18 对服务器的完整实测数据,覆盖冒烟、MTP 对照、500 步长链基线、1/2/4 并发梯度、30 分钟浸泡共约 1764 次真实推理调用。
数据量够,三点可以再压:
- 24K 上下文 TTFT 19.7s 是 prefill 决定的,vLLM 侧只有前缀缓存命中率和 chunked prefill 两个杠杆。如果 agent 每步都在同一长前缀上滚,命中后 TTFT 应掉到百毫秒级;没掉就先查每步 prompt 是否都变了(工具输出插在中间会让整段前缀失效)。
- MTP 2.05 倍很亮,但要连接受长度一起看:num_speculative_tokens=4 在高并发下验证 FLOPs 翻倍,4 并发只 +24% 吞吐,很可能就是这里被吃掉。扫 k=2/3/4,画「接受长度 x 有效吞吐」再定。
- 单卡 1–2 并发饱和是 R9700 带宽(640GB/s)决定的,27B INT4 权重约 15GB,dense 上限粗算约 40 t/s。注意你 MTP 关掉只有 19.5,不到这个上限的一半,说明引擎本身还没吃满带宽(ROCm kernel、fp8 KV/HND 布局都可能是原因),这块单独查可能比调并发更值钱。对 24K 长链,结论应该偏「限并发保 TTFT」,而不是追聚合吞吐。
max-num-seqs 4 收到 2、gpu-mem 0.95 是对的方向。