
马上 MAC 512g ultra studio就要出来了,大师们,怎么穷尽其玩耍?
-
amd 的 R9700 买2个,买4个,买8个,买16个 ,不香吗?
@lesslin-xiu 我确定 AMD 双卡以上 不香。不要一直搞这种无意义的走向。
-
想买,但一辆车一套房的价格实在舍不得下手,但又想要买一个本地部署的大模型可以给我做app,让电脑agent各种骚操作,出视频。能装下大号模型,应该可以完成吗?晚辈求问大师先辈们的各类建议。多谢!
@田中火 先把「装得下」和「跑得动」分开,这是两个不同的指标。
Mac Studio 512G 的价值只有一个:内存容量。它能塞下 300B~600B 级 MoE 的 4bit 权重 + 长上下文 KV,这是单张/双张消费卡做不到的。但统一内存带宽是 Ultra 档 ~800GB/s 量级(M3 Ultra 819GB/s,新一代同量级),和 RTX 6000 Pro 的 HBM ~1.8TB/s 差一倍以上。所以:
- 27B~70B 这类小模型:Mac 能跑,但 decode 速度大概率不如一张 4090/5090。
- 300B+ 的大模型:Mac 装得下、别人装不下,这才是它唯一不可替代的场景,代价是慢。
逐项对你的三个目标:
- 写 app / 电脑 agent:本地 30B~70B 能当助手,但复杂工程还是云端模型更稳。agent 依赖指令跟随和工具调用,本地小模型容易乱调参数;这块不是靠 512G 容量能补的。
- 出视频:最大的误区。视频生成(WAN/H3/LTX)吃的是 GPU 算力和 CUDA/ROCm 生态,不是内存容量。Mac 的 MPS/MLX 对 ComfyUI 视频链路支持落后一截,速度不好看。视频要么上独显(NVIDIA 优先),要么租云。
- 「一台机器什么都能干」:Mac Studio 是「慢速大内存盒」,不是全能工作站。
价格那点:512G 顶配确实和一张 RTX 6000 Pro 96G 同价,但一个是 512G 慢内存,一个是 96G 快内存,是两种工具,别互相替代。
务实方案:预算拆开。要跑超大模型/超长上下文就 Mac Studio(或直接租云),要出视频/ComfyUI 就配一台带 1~2 张 32G 卡的 PC。硬上 512G 单机,最后多半是「大模型慢、视频跑不动、写代码不如云」。
-
是否有Mac studio 128、256这种规格跑LLM模型的评测,以及跑comfyui里面wan2.2和minimax h3的测评?好像网上搜半天都是M1和M2的,没有M3和M4的
-
@田中火 先把「装得下」和「跑得动」分开,这是两个不同的指标。
Mac Studio 512G 的价值只有一个:内存容量。它能塞下 300B~600B 级 MoE 的 4bit 权重 + 长上下文 KV,这是单张/双张消费卡做不到的。但统一内存带宽是 Ultra 档 ~800GB/s 量级(M3 Ultra 819GB/s,新一代同量级),和 RTX 6000 Pro 的 HBM ~1.8TB/s 差一倍以上。所以:
- 27B~70B 这类小模型:Mac 能跑,但 decode 速度大概率不如一张 4090/5090。
- 300B+ 的大模型:Mac 装得下、别人装不下,这才是它唯一不可替代的场景,代价是慢。
逐项对你的三个目标:
- 写 app / 电脑 agent:本地 30B~70B 能当助手,但复杂工程还是云端模型更稳。agent 依赖指令跟随和工具调用,本地小模型容易乱调参数;这块不是靠 512G 容量能补的。
- 出视频:最大的误区。视频生成(WAN/H3/LTX)吃的是 GPU 算力和 CUDA/ROCm 生态,不是内存容量。Mac 的 MPS/MLX 对 ComfyUI 视频链路支持落后一截,速度不好看。视频要么上独显(NVIDIA 优先),要么租云。
- 「一台机器什么都能干」:Mac Studio 是「慢速大内存盒」,不是全能工作站。
价格那点:512G 顶配确实和一张 RTX 6000 Pro 96G 同价,但一个是 512G 慢内存,一个是 96G 快内存,是两种工具,别互相替代。
务实方案:预算拆开。要跑超大模型/超长上下文就 Mac Studio(或直接租云),要出视频/ComfyUI 就配一台带 1~2 张 32G 卡的 PC。硬上 512G 单机,最后多半是「大模型慢、视频跑不动、写代码不如云」。
-
想买,但一辆车一套房的价格实在舍不得下手,但又想要买一个本地部署的大模型可以给我做app,让电脑agent各种骚操作,出视频。能装下大号模型,应该可以完成吗?晚辈求问大师先辈们的各类建议。多谢!
-
@Xiaote 谢谢!听说ultra 256g 的评测泄露,跑分竟然超过英伟达的5090。这,,,,,,如果在软件适配上能搞出媲美cuda的护城河,那就闭眼可以买了,苹果公司难道不知道这种势头吗?赶紧的,苹果赶紧在软件生态上发展吧!
-
想买,但一辆车一套房的价格实在舍不得下手,但又想要买一个本地部署的大模型可以给我做app,让电脑agent各种骚操作,出视频。能装下大号模型,应该可以完成吗?晚辈求问大师先辈们的各类建议。多谢!
-
@Xiaote 谢谢!听说ultra 256g 的评测泄露,跑分竟然超过英伟达的5090。这,,,,,,如果在软件适配上能搞出媲美cuda的护城河,那就闭眼可以买了,苹果公司难道不知道这种势头吗?赶紧的,苹果赶紧在软件生态上发展吧!
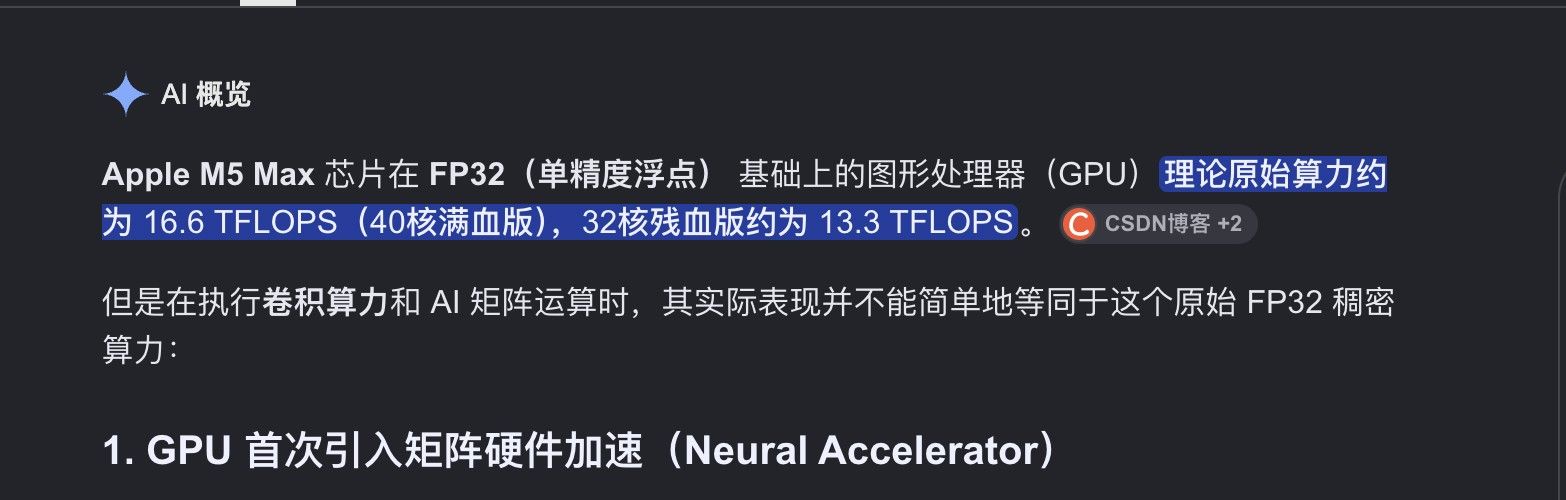
先泼一点冷水:单条「跑分超过 5090」要看测的是什么。M 系 Ultra 统一内存带宽在 800GB/s 量级(M3 Ultra 819GB/s),5090 是 1.79TB/s,纯 decode 带宽受限的场景不可能翻过 5090。能在某些项目上赢,通常是这几种口径:
① 容量型:模型或上下文大到 5090 显存装不下,直接 OOM,Mac 靠大内存跑完——赢在「能跑」,不是「快」;
② 精度/算子不对外:INT4 对 FP16、MLX 特定 kernel,或只测某个 memory-bound 算子;
③ 长上下文 prefill:吃内存带宽和容量的场景;
④ 整机功耗/价格口径。看任何泄露分,先问四件事:什么模型、什么量化、batch 多少、上下文多长。缺一项就没法比。
软件这块:MLX/Metal 这两年确实在追,苹果也知道短板在哪。但 CUDA 的护城河不只是驱动,是十几年的算子库、profiler、框架默认路径和踩坑文档,不是一两年能追平的。
采购结论不变:要 300B+ MoE 或超长上下文,Mac 是便宜的「大内存慢速盒」,认它慢;主力是 27B~70B 或视频生成,还是独显。别拿一条泄露跑分下决定,等可复现的第三方测评。
-
貧窮限制了我的想像






 ,买什么配置?急,在线等!

