跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI危机
  4. 英伟达DGX Station 748G统一内存,10万美元售价打造本地AI算力王座。大多数程序员都无法对抗AI淘汰大潮,早做打算!

英伟达DGX Station 748G统一内存,10万美元售价打造本地AI算力王座。大多数程序员都无法对抗AI淘汰大潮,早做打算!

已定时 已固定 已锁定 已移动 AI危机
nvidia服务器
14 帖子 6 发布者 791 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 番茄胡萝卜番
    番茄胡萝卜番
    番茄胡萝卜
    发表于 最后由 编辑
    #3

    卖肾都已经无法解决算力的问题了

    七月又七七 1 条回复 最后回复
    0
    • 番茄胡萝卜番 番茄胡萝卜

      卖肾都已经无法解决算力的问题了

      七月又七七
      七月又七七
      七月又七
      发表于 最后由 编辑
      #4

      @番茄胡萝卜 😁 只能学谷歌走手机版的算力集群了,等等把。类似于猫池一样的算力集群。坐等华强北的大佬开发

      1 条回复 最后回复
      0
      • Alexander LeeA
        Alexander LeeA
        Alexander Lee
        体面乡绅
        编写于 最后由 编辑
        #5

        太穷了,已经跟不过富哥的节奏了

        1 条回复 最后回复
        0
        • lunarmoon26L
          lunarmoon26L
          lunarmoon26
          体面乡绅
          编写于 最后由 编辑
          #6

          补充一个我觉得这台机器最有意思的地方:不只是内存容量大,而是它把 GPU、网卡和存储连起来的拓扑,很像把数据中心的一部分搬到了桌边。

          拿技嘉这台 W775-V10-L01 来说,ConnectX-8 SuperNIC 不只是一张双 400G 网卡,它本身还集成了 PCIe Gen6 交换功能。
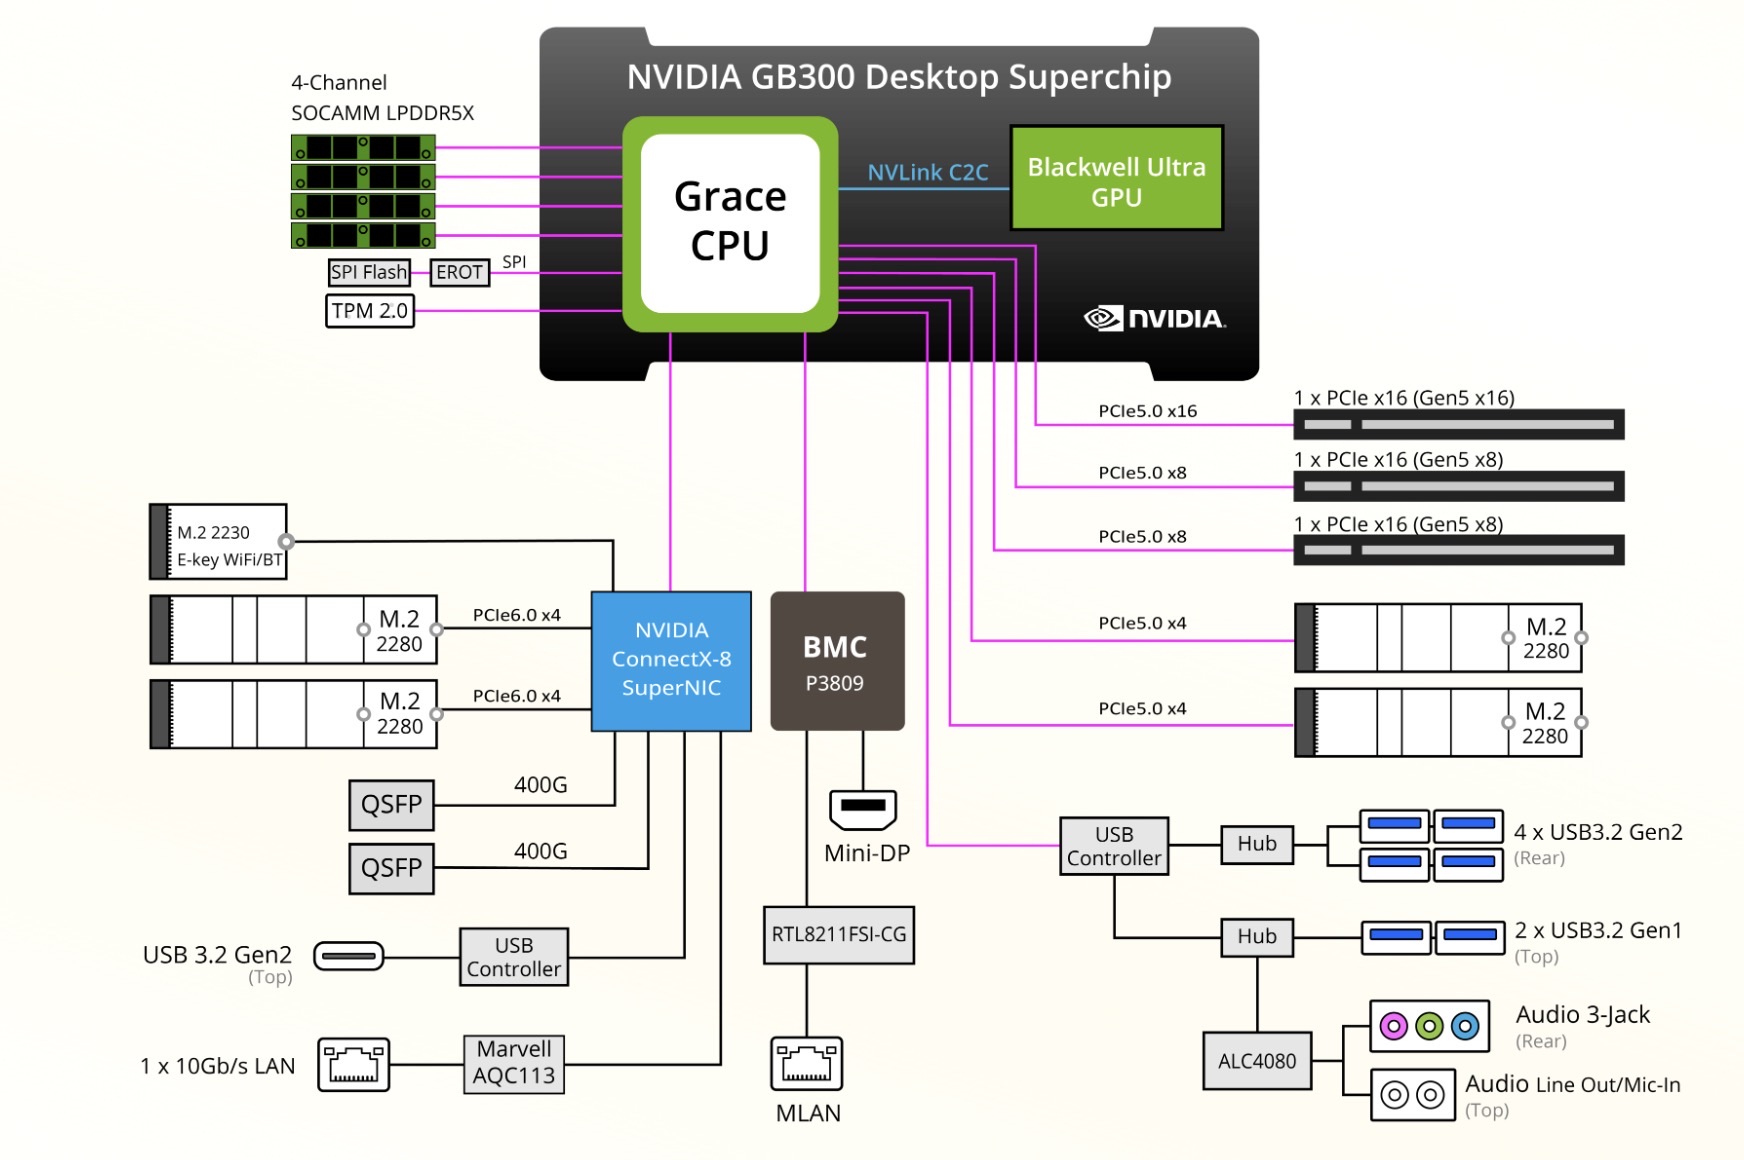
          技嘉系统框图,经 ServeTheHome 引用

          不过这张厂商简图没有明确画出 GPU 到 ConnectX-8 的连接,STH 的拓扑分析和实测补上了这一点。

          这里有三条不同的路,不能混在一起看:

          • Grace CPU ↔ Blackwell Ultra GPU:NVLink-C2C,负责本机 CPU/GPU 的一致性互联。
          • GPU ↔ ConnectX-8:PCIe Gen6 x16,Data Direct 提供了 NIC 直接访问 GPU 的数据路径,配合 GPUDirect RDMA,不必先把传输数据搬到 CPU 内存中转。
          • Grace CPU ↔ ConnectX-8:PCIe Gen5 x8,这条反而窄得多。

          STH 实测两台 Station 用两条 400GbE 链路连接,GPU 到 GPU 的 RDMA payload 达到约 784.3 Gb/s,CPU 到 CPU 则只有约 229 Gb/s。前者折合约 98 GB/s,注意不是 784 GB/s。也就是说,“有 800G 网口”不等于机器里所有数据都能按 800G 往外搬,得看数据在哪里、实际走哪条路。
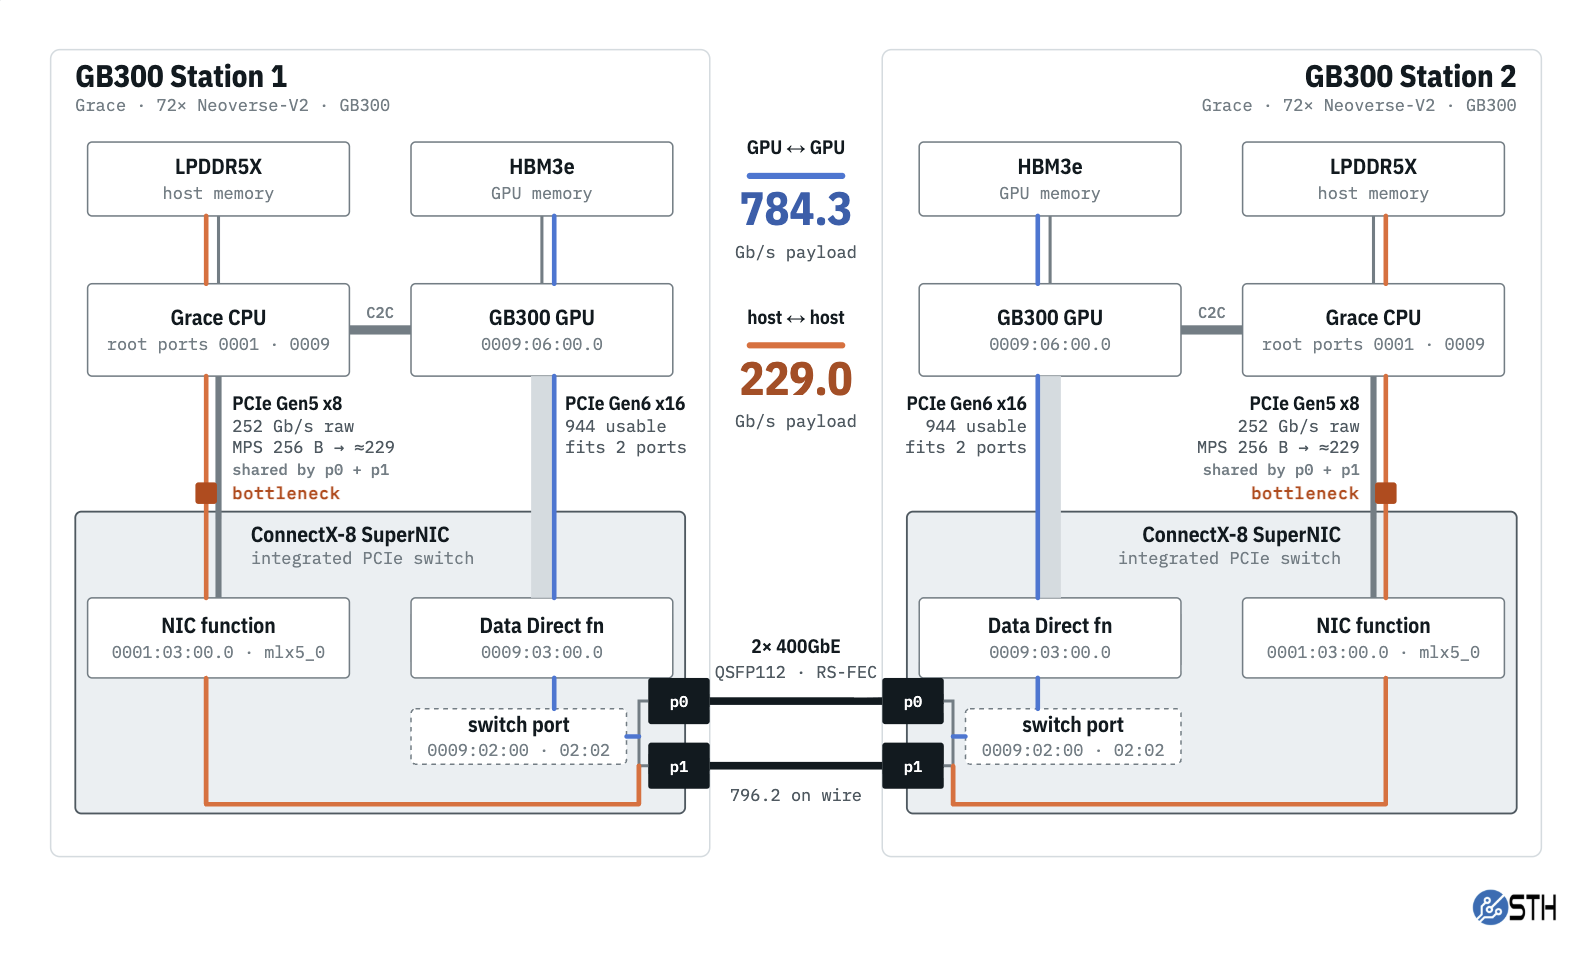
          STH 双 Station 互联拓扑及测速,来源 ServeTheHome

          我感兴趣的是它对多节点推理、Prefill/Decode 分离的意义。 比如一台做 Prefill、处理输入,另一台做 Decode、持续生成 Token,中间要把 KV cache 传过去。这时候 GPU 显存之间能直接通过 RDMA 高速搬数据,就比只盯着单机算力和总内存容量更值得研究。

          这里跨机器走的是 Ethernet/RDMA,不是把本机 NVLink-C2C 延伸到另一台,也不会自动把两台机器变成一块统一显存。真正做 P/D 分离,还需要 Dynamo、SGLang 等软件栈配合;能否抵消 KV 传输和调度开销,得看模型、上下文长度、并发和实际测试。上面的数字是网络传输测试,不是 P/D 分离加速的实测结果。

          存储这边也有个细节:它的两条 Gen6 x4 M.2 插槽挂在 ConnectX-8 下面,另外两条 Gen5 x4 才挂在 Grace CPU 下面。连 SSD 放在哪个 PCIe 分支上都有区分,不是普通工作站插张大显卡、再插张高速网卡这么简单。

          所以我觉得它有意思的地方,是桌面形态下也提供了围绕 GPU 数据路径设计的 scale-out 条件。不一定每个人都需要买两台,但如果想研究多机推理,这套拓扑本身就很值得看。

          参考:

          • STH:拓扑分析(第 3 页)、网络实测(第 7 页),图和测速来自其评测,不是我的实测。
          • NVIDIA:Data Direct
          • NVIDIA Dynamo:P/D 分离及 RDMA 传 KV cache
          imbiplaza ASUSI terryT 2 条回复 最后回复
          1
          • lunarmoon26L lunarmoon26

            补充一个我觉得这台机器最有意思的地方:不只是内存容量大,而是它把 GPU、网卡和存储连起来的拓扑,很像把数据中心的一部分搬到了桌边。

            拿技嘉这台 W775-V10-L01 来说,ConnectX-8 SuperNIC 不只是一张双 400G 网卡,它本身还集成了 PCIe Gen6 交换功能。

            技嘉系统框图,经 ServeTheHome 引用

            不过这张厂商简图没有明确画出 GPU 到 ConnectX-8 的连接,STH 的拓扑分析和实测补上了这一点。

            这里有三条不同的路,不能混在一起看:

            • Grace CPU ↔ Blackwell Ultra GPU:NVLink-C2C,负责本机 CPU/GPU 的一致性互联。
            • GPU ↔ ConnectX-8:PCIe Gen6 x16,Data Direct 提供了 NIC 直接访问 GPU 的数据路径,配合 GPUDirect RDMA,不必先把传输数据搬到 CPU 内存中转。
            • Grace CPU ↔ ConnectX-8:PCIe Gen5 x8,这条反而窄得多。

            STH 实测两台 Station 用两条 400GbE 链路连接,GPU 到 GPU 的 RDMA payload 达到约 784.3 Gb/s,CPU 到 CPU 则只有约 229 Gb/s。前者折合约 98 GB/s,注意不是 784 GB/s。也就是说,“有 800G 网口”不等于机器里所有数据都能按 800G 往外搬,得看数据在哪里、实际走哪条路。

            STH 双 Station 互联拓扑及测速,来源 ServeTheHome

            我感兴趣的是它对多节点推理、Prefill/Decode 分离的意义。 比如一台做 Prefill、处理输入,另一台做 Decode、持续生成 Token,中间要把 KV cache 传过去。这时候 GPU 显存之间能直接通过 RDMA 高速搬数据,就比只盯着单机算力和总内存容量更值得研究。

            这里跨机器走的是 Ethernet/RDMA,不是把本机 NVLink-C2C 延伸到另一台,也不会自动把两台机器变成一块统一显存。真正做 P/D 分离,还需要 Dynamo、SGLang 等软件栈配合;能否抵消 KV 传输和调度开销,得看模型、上下文长度、并发和实际测试。上面的数字是网络传输测试,不是 P/D 分离加速的实测结果。

            存储这边也有个细节:它的两条 Gen6 x4 M.2 插槽挂在 ConnectX-8 下面,另外两条 Gen5 x4 才挂在 Grace CPU 下面。连 SSD 放在哪个 PCIe 分支上都有区分,不是普通工作站插张大显卡、再插张高速网卡这么简单。

            所以我觉得它有意思的地方,是桌面形态下也提供了围绕 GPU 数据路径设计的 scale-out 条件。不一定每个人都需要买两台,但如果想研究多机推理,这套拓扑本身就很值得看。

            参考:

            • STH:拓扑分析(第 3 页)、网络实测(第 7 页),图和测速来自其评测,不是我的实测。
            • NVIDIA:Data Direct
            • NVIDIA Dynamo:P/D 分离及 RDMA 传 KV cache
            imbiplaza ASUSI
            imbiplaza ASUSI
            imbiplaza ASUS
            谪仙人
            编写于 最后由 imbiplaza ASUS 编辑
            #7

            @lunarmoon26

            其实不是这样玩得。。。。
            因为本身bg300并没有单卖,他一开始就是几十个gb300得rack...

            这源于我开始在网上咨询那些组装4x rtxpro 6000 得时候,我问过nvidia 怎样才可以买到gb300,他们说并没有单卖。。。

            后来,他们可能看到越来越多ai业者去组装4x rtxpro 6000

            后来,就冒出单卖得gb300 workstation了。。。

            4x rtxpro6000 +套机等于10万美金,差不多也是gb300 workstation一开始nvidia 标出来得价格

            当今一个rack里面最低可以组装得gb300 是2个,
            GB300 Desktop Superchip,HGX B300
            supermicro在卖着

            lunarmoon26L 1 条回复 最后回复
            2
            • imbiplaza ASUSI imbiplaza ASUS

              @lunarmoon26

              其实不是这样玩得。。。。
              因为本身bg300并没有单卖,他一开始就是几十个gb300得rack...

              这源于我开始在网上咨询那些组装4x rtxpro 6000 得时候,我问过nvidia 怎样才可以买到gb300,他们说并没有单卖。。。

              后来,他们可能看到越来越多ai业者去组装4x rtxpro 6000

              后来,就冒出单卖得gb300 workstation了。。。

              4x rtxpro6000 +套机等于10万美金,差不多也是gb300 workstation一开始nvidia 标出来得价格

              当今一个rack里面最低可以组装得gb300 是2个,
              GB300 Desktop Superchip,HGX B300
              supermicro在卖着

              lunarmoon26L
              lunarmoon26L
              lunarmoon26
              体面乡绅
              编写于 最后由 编辑
              #8

              @imbiplaza-ASUS 啊 4x RTX 6000 Pro 要10万刀的话 GB300 DGX Station不要太超值 算力甩8卡都几条街。

              imbiplaza ASUSI 1 条回复 最后回复
              0
              • lunarmoon26L lunarmoon26

                @imbiplaza-ASUS 啊 4x RTX 6000 Pro 要10万刀的话 GB300 DGX Station不要太超值 算力甩8卡都几条街。

                imbiplaza ASUSI
                imbiplaza ASUSI
                imbiplaza ASUS
                谪仙人
                编写于 最后由 编辑
                #9

                @lunarmoon26

                gb300 单机版本肯定吃炒价

                lunarmoon26L 1 条回复 最后回复
                0
                • imbiplaza ASUSI imbiplaza ASUS

                  @lunarmoon26

                  gb300 单机版本肯定吃炒价

                  lunarmoon26L
                  lunarmoon26L
                  lunarmoon26
                  体面乡绅
                  编写于 最后由 编辑
                  #10

                  @imbiplaza-ASUS 但我看了下Alex Ziskind和Level1Techs他们实机测试 这个内部走线和配色实在是喜欢不起来(其实也是没钱)

                  imbiplaza ASUSI 1 条回复 最后回复
                  0
                  • lunarmoon26L lunarmoon26

                    @imbiplaza-ASUS 但我看了下Alex Ziskind和Level1Techs他们实机测试 这个内部走线和配色实在是喜欢不起来(其实也是没钱)

                    imbiplaza ASUSI
                    imbiplaza ASUSI
                    imbiplaza ASUS
                    谪仙人
                    编写于 最后由 编辑
                    #11

                    @lunarmoon26

                    售卖得对象应该是那些每年产值6000万至1亿的小型企业

                    lunarmoon26L 1 条回复 最后回复
                    0
                    • imbiplaza ASUSI imbiplaza ASUS

                      @lunarmoon26

                      售卖得对象应该是那些每年产值6000万至1亿的小型企业

                      lunarmoon26L
                      lunarmoon26L
                      lunarmoon26
                      体面乡绅
                      编写于 最后由 lunarmoon26 编辑
                      #12

                      @imbiplaza-ASUS 我算了下这玩意儿一个20人团队用大概每人5000刀 绰绰有余。我们很多时候一个月就1000-2000刀token 虽然是SOTA但确实也是贵。
                      大部分任务开元模型都可以跑,这玩意儿5个月就回本了。

                      imbiplaza ASUSI 1 条回复 最后回复
                      1
                      • lunarmoon26L lunarmoon26

                        @imbiplaza-ASUS 我算了下这玩意儿一个20人团队用大概每人5000刀 绰绰有余。我们很多时候一个月就1000-2000刀token 虽然是SOTA但确实也是贵。
                        大部分任务开元模型都可以跑,这玩意儿5个月就回本了。

                        imbiplaza ASUSI
                        imbiplaza ASUSI
                        imbiplaza ASUS
                        谪仙人
                        编写于 最后由 编辑
                        #13

                        @lunarmoon26

                        好像可以顺便架设虚拟机。。。到时候,连电脑也省下了,人手一部最基础的苹果电脑就可以执行惯用的win 老程式

                        1 条回复 最后回复
                        1
                        • lunarmoon26L lunarmoon26

                          补充一个我觉得这台机器最有意思的地方:不只是内存容量大,而是它把 GPU、网卡和存储连起来的拓扑,很像把数据中心的一部分搬到了桌边。

                          拿技嘉这台 W775-V10-L01 来说,ConnectX-8 SuperNIC 不只是一张双 400G 网卡,它本身还集成了 PCIe Gen6 交换功能。

                          技嘉系统框图,经 ServeTheHome 引用

                          不过这张厂商简图没有明确画出 GPU 到 ConnectX-8 的连接,STH 的拓扑分析和实测补上了这一点。

                          这里有三条不同的路,不能混在一起看:

                          • Grace CPU ↔ Blackwell Ultra GPU:NVLink-C2C,负责本机 CPU/GPU 的一致性互联。
                          • GPU ↔ ConnectX-8:PCIe Gen6 x16,Data Direct 提供了 NIC 直接访问 GPU 的数据路径,配合 GPUDirect RDMA,不必先把传输数据搬到 CPU 内存中转。
                          • Grace CPU ↔ ConnectX-8:PCIe Gen5 x8,这条反而窄得多。

                          STH 实测两台 Station 用两条 400GbE 链路连接,GPU 到 GPU 的 RDMA payload 达到约 784.3 Gb/s,CPU 到 CPU 则只有约 229 Gb/s。前者折合约 98 GB/s,注意不是 784 GB/s。也就是说,“有 800G 网口”不等于机器里所有数据都能按 800G 往外搬,得看数据在哪里、实际走哪条路。

                          STH 双 Station 互联拓扑及测速,来源 ServeTheHome

                          我感兴趣的是它对多节点推理、Prefill/Decode 分离的意义。 比如一台做 Prefill、处理输入,另一台做 Decode、持续生成 Token,中间要把 KV cache 传过去。这时候 GPU 显存之间能直接通过 RDMA 高速搬数据,就比只盯着单机算力和总内存容量更值得研究。

                          这里跨机器走的是 Ethernet/RDMA,不是把本机 NVLink-C2C 延伸到另一台,也不会自动把两台机器变成一块统一显存。真正做 P/D 分离,还需要 Dynamo、SGLang 等软件栈配合;能否抵消 KV 传输和调度开销,得看模型、上下文长度、并发和实际测试。上面的数字是网络传输测试,不是 P/D 分离加速的实测结果。

                          存储这边也有个细节:它的两条 Gen6 x4 M.2 插槽挂在 ConnectX-8 下面,另外两条 Gen5 x4 才挂在 Grace CPU 下面。连 SSD 放在哪个 PCIe 分支上都有区分,不是普通工作站插张大显卡、再插张高速网卡这么简单。

                          所以我觉得它有意思的地方,是桌面形态下也提供了围绕 GPU 数据路径设计的 scale-out 条件。不一定每个人都需要买两台,但如果想研究多机推理,这套拓扑本身就很值得看。

                          参考:

                          • STH:拓扑分析(第 3 页)、网络实测(第 7 页),图和测速来自其评测,不是我的实测。
                          • NVIDIA:Data Direct
                          • NVIDIA Dynamo:P/D 分离及 RDMA 传 KV cache
                          terryT
                          terryT
                          terry
                          易有太极
                          编写于 最后由 编辑
                          #14

                          @lunarmoon26 其实就你最懂这个,这个资料比我搜到的好看多了,😂

                          油管:https://www.youtube.com/@抡锤者

                          1 条回复 最后回复
                          0

                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                          有了你的建议,这篇帖子会更精彩哦 💗

                          注册 登录
                          回复
                          • 在新帖中回复
                          登录后回复
                          • 从旧到新
                          • 从新到旧
                          • 最多赞同


                          • 登录

                          • 登录或注册以进行搜索。
                          • 第一个帖子
                            最后一个帖子
                          0
                          • 版块
                          • 最新
                          • 标签
                          • 热门
                          • 用户
                          • 群组