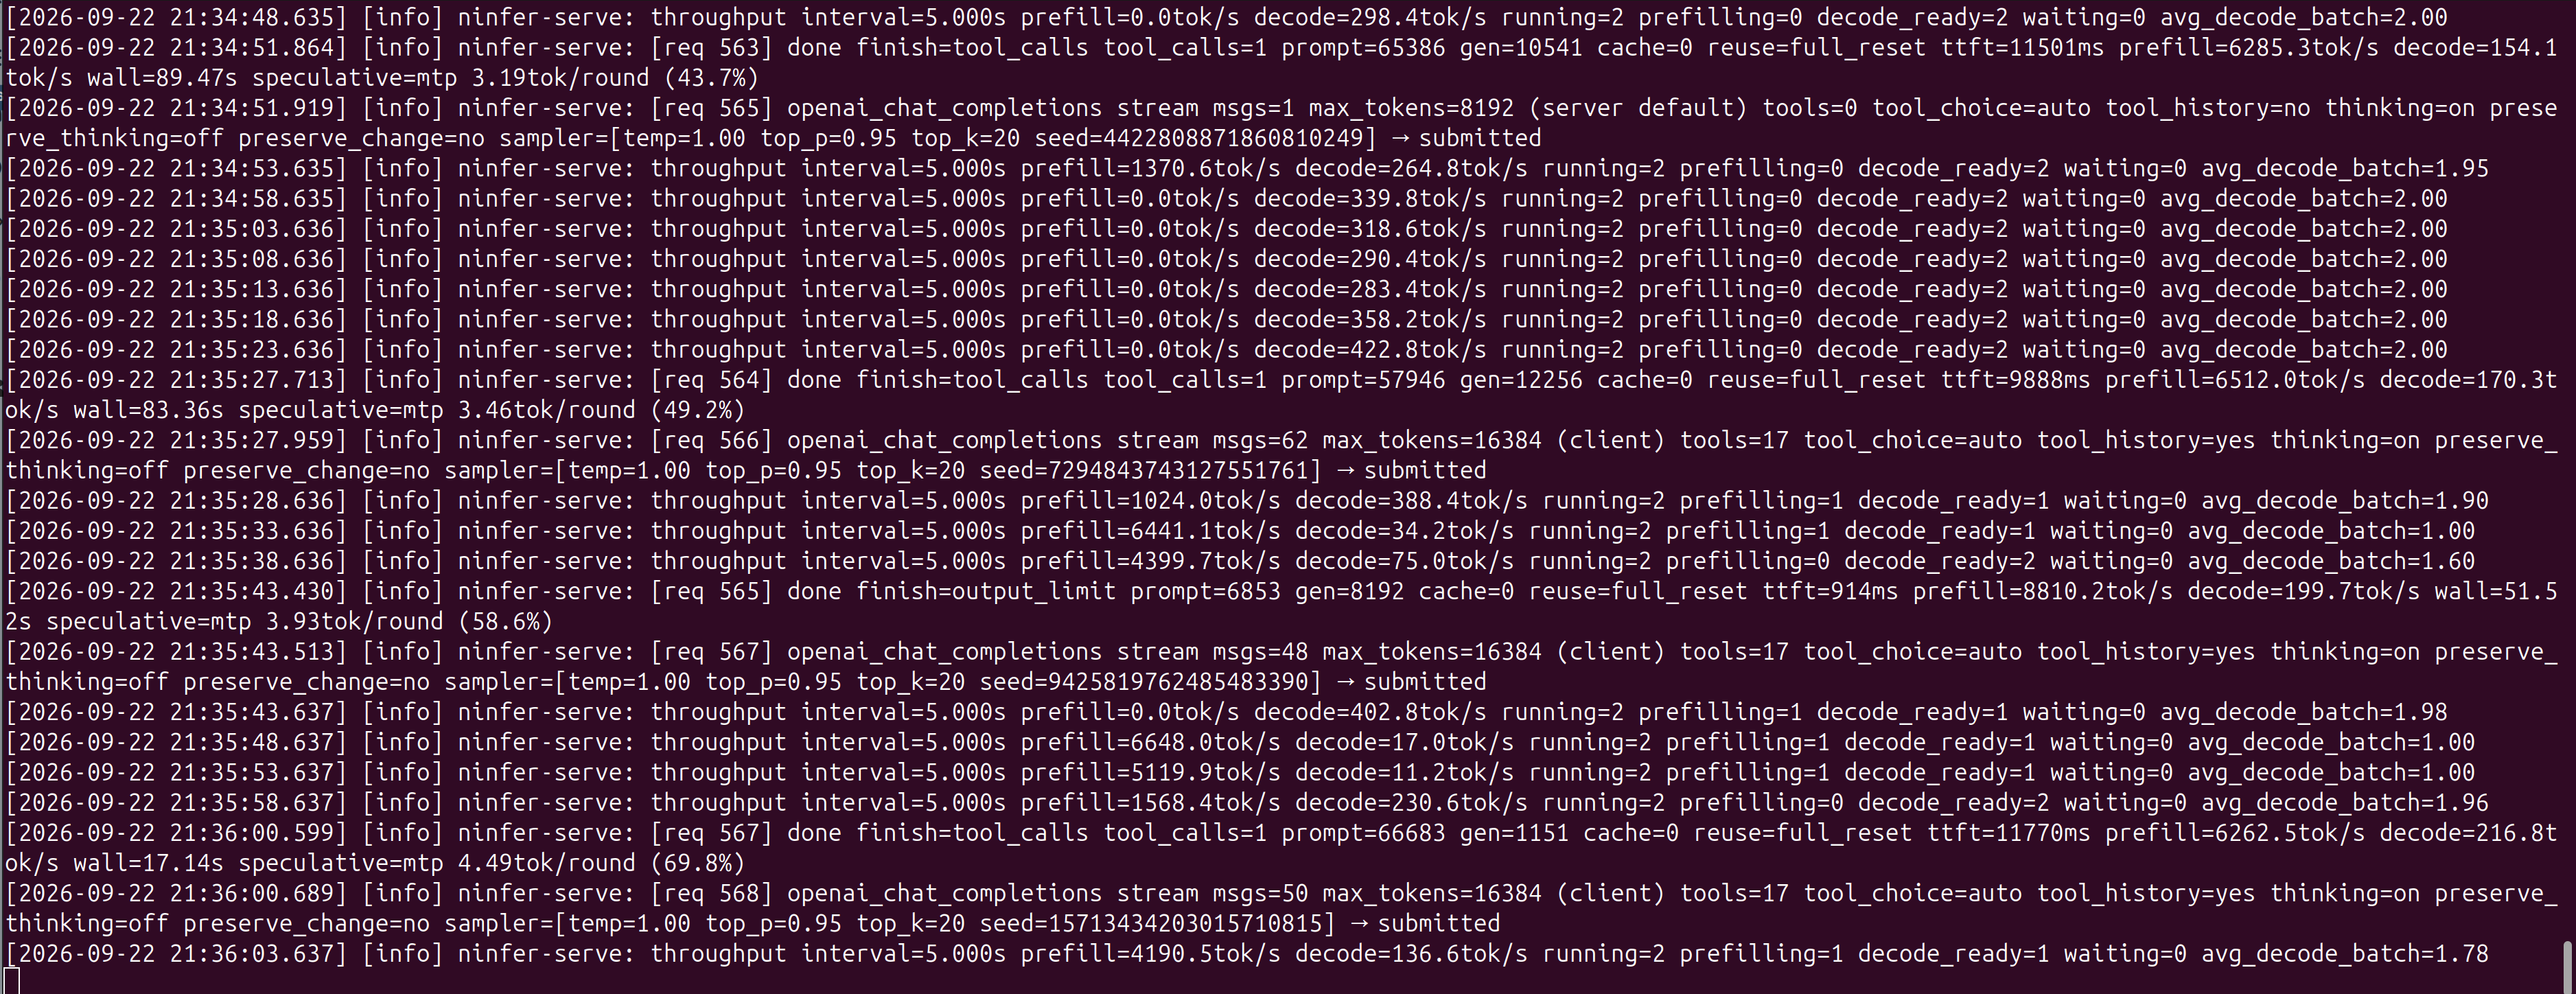
Ninfer -> Qwen3.8 27B nvfp4 改雙卡 -> 改uncensored 但支援ninfer模型 -> 覺的TP2 + MTP不夠快 -> 改支援 df2(終於中招了)
-
-
-
我的Agent (GPT6.0-Luna + Qwen3.8-27B-Q4)今天終於成功了!! 雙卡 RTX 5070 Ti => Ninfer -> Qwen3.8 27B nvfp4 改雙卡
速度大大提升 Prefill/Decode效能 大約是雙5090的一半 -
我的Agent (GPT6.0-Luna + Qwen3.8-27B-Q4)今天終於成功了!! 雙卡 RTX 5070 Ti => Ninfer -> Qwen3.8 27B nvfp4 改雙卡
速度大大提升 Prefill/Decode效能 大約是雙5090的一半 -
-
@he-luo
NInfer 這個多併發Prefill 速度不會掉, C是併發數,
實際使用單發 寫文章文字約100 tok/s, 解題速度約 140 tok/s雙RTX5070 Ti 16GB 結果(MTP3, 335-token fixture, 8192 decode tokens/req, stochastic, TP2 GPU0+1)
C 系統 Decode tok/s Prompt Proc (per-req prefill, tok/s) avg batch tok/round Accept % Makespan (s) Per-req elapsed (s) TTFT (ms, per req) vs C=1 1 114.5 3295.4 1.00 2.417 47.4% 71.5 71.5 103 1.00x 2 202.9 3311 / 3349 2.00 4.731 45.7% 80.9 80.5–80.9 102, 244 1.77x 4 342.2 3307 / 3334 / 3342 / 3345 4.00 9.484 45.8% 96.7 95.4–96.7 102, 244, 390, 541 2.99x 8 567.0 3298–3354 (8 req) 8.00 19.016 46.1% 117.8 113.4–117.8 102–1181 (每 req ~+142ms) 4.95x