双7900XTX:vLLM Prefix Cache 与 SGLang HiCache 实测对比
-
首先感谢各位大佬,跟着论坛的技术帖子进行部署。
结论先说:在这台双 RX 7900 XTX 上,vLLM 的冷请求在 8K–85K 全部更快;两者在“同一前缀立刻再问一次”时都能把首字等待压到约 0.14–1.25 秒。进一步将最早的 128K 前缀挤出 GPU KV 后,SGLang HiCache 仍能从主机内存回载 125,952 token,把 TTFT 从 186.41 秒降至 1.11 秒;当前 vLLM 配置在对应的 85K 驱逐回访中没有 prefix-cache 命中。
测试口径
- CPU:AMD Ryzen 5 7500F
- 内存:96 GB DDR5
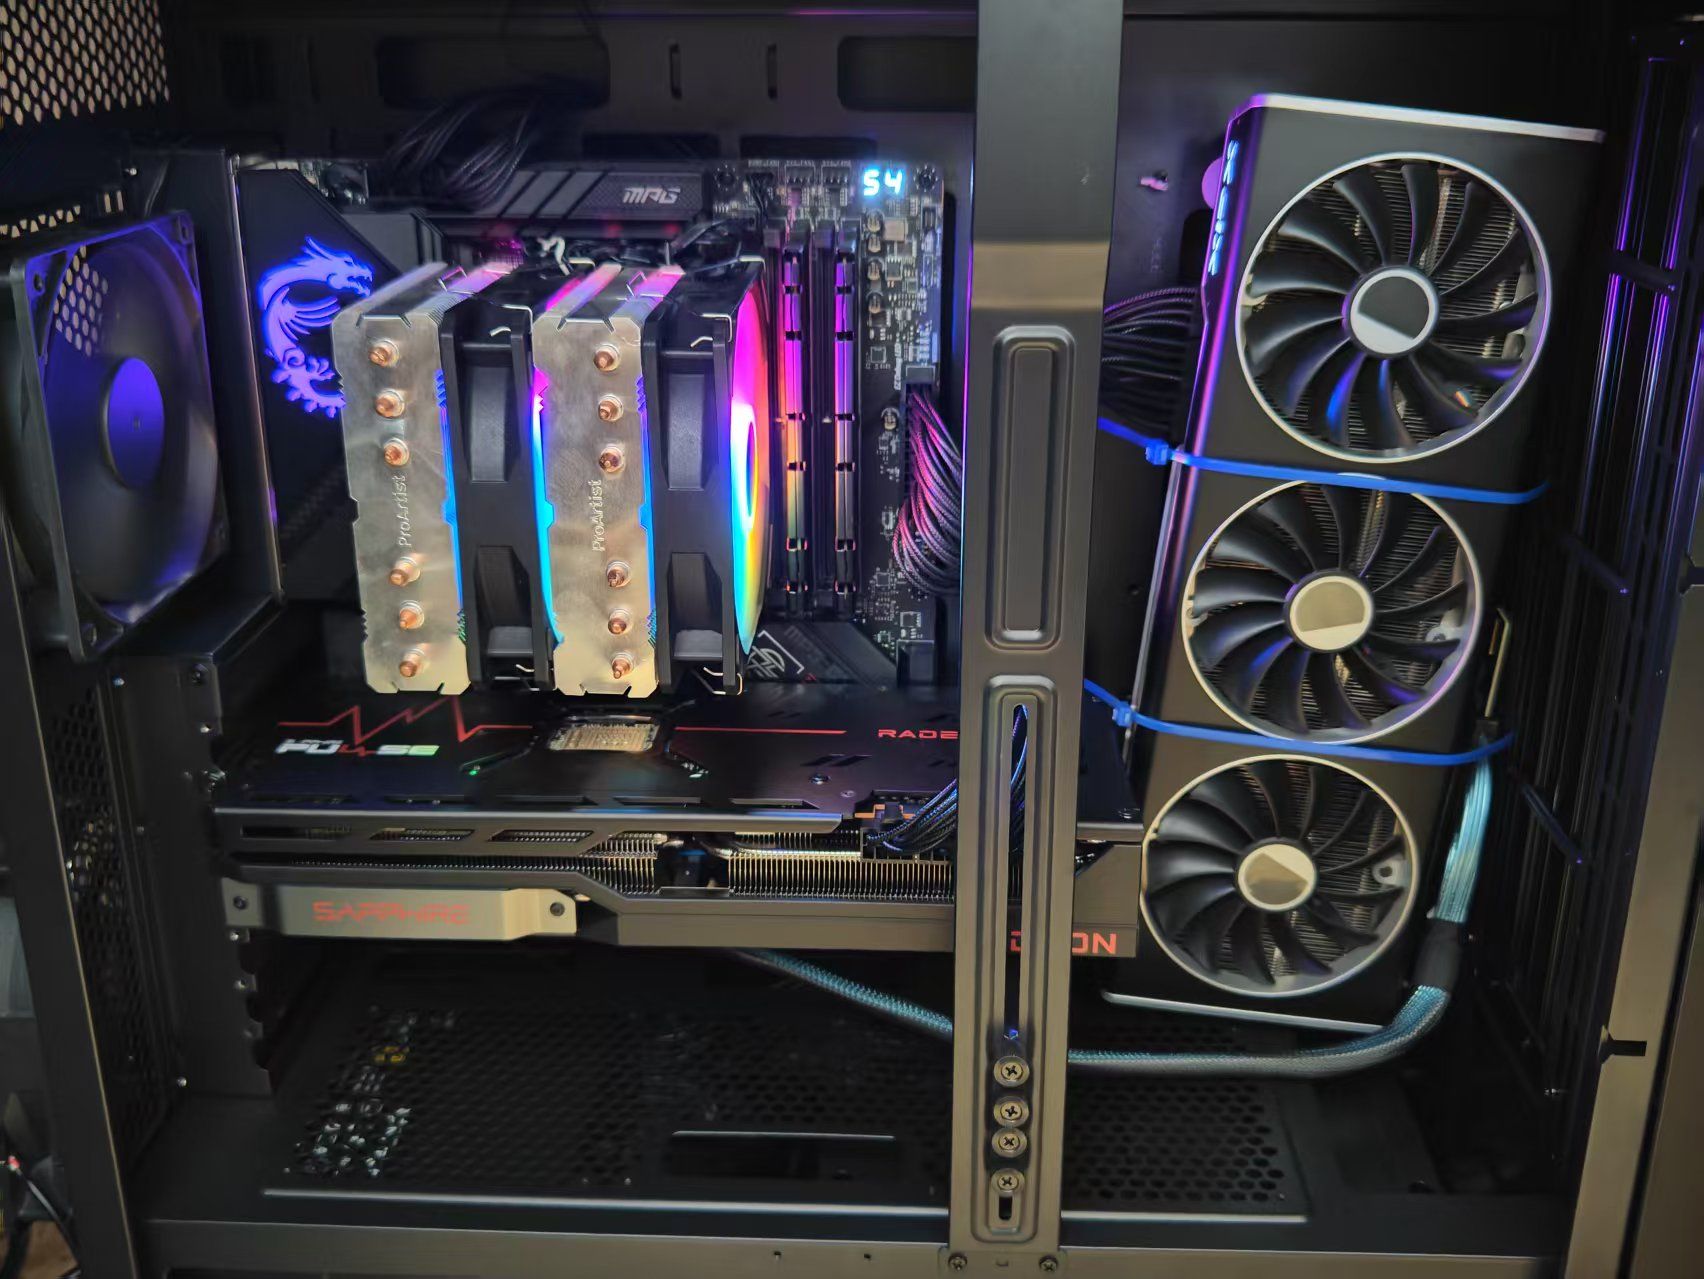
- 主板:MSI MPG X670E CARBON WIFI
- 硬盘:1 TB NVMe SSD。
- GPU:2 × AMD Radeon RX 7900 XTX 24 GB,TP=2
- 主模型:
Qwen3.8-27B-W4A16-AutoRound-GPTQ - 单并发、固定随机 token、
temperature=0、同一档位冷/热使用同一 seed - 冷请求:指定长度输入、512 输出;热请求:紧接同一前缀、16 输出。
- vLLM 版本:
0.1.dev1+g874bfa3f1.d20260911,87,040 最大上下文、FP8 KV、Triton attention、prefix caching。 - SGLang:
0.5.6.post3.dev10769+gf84475ccf,196,608 最大上下文、BF16 KV、Triton attention、DFLASH,以及HiCache(size=12, ratio=2.0, kernel, write_through)。
SGLang 启用了 DFLASH、BF16 KV 和 HiCache;vLLM 使用 FP8 KV、未启用投机解码。因而这是一套“当前实际可用配置”的对比,不是只切换框架二进制文件的纯引擎 A/B。
冷请求:vLLM 在本轮配置下领先
冷请求的 512 输出使 E2E 同时含 prefill 与 decode;长上下文交互最关键的 TTFT 单列展示。
输入 vLLM TTFT SGLang HiCache TTFT vLLM E2E SGLang HiCache E2E 8K 0.22 s 4.65 s 9.06 s 10.39 s 16K 0.29 s 10.34 s 9.85 s 12.87 s 32K 0.54 s 24.59 s 11.55 s 27.64 s 64K 1.26 s 65.07 s 15.21 s 69.18 s 85K 0.64 s 100.21 s 16.54 s 113.45 s 128K —(上限 87K) 192.71 s — 199.03 s 85K 的 vLLM TTFT 比 64K 更低并不代表规模越大越快;这是单样本下 kernel/JIT、调度和测量抖动共同造成的非单调点。严谨排名应至少每档重复三次并取中位数。
热前缀:两者都能显著降低首字等待
热请求只生成 16 token,所以只比较 TTFT 与按完整输入长度计算的等效输入吞吐。该吞吐表示跳过了多少 prefill,不代表模型真实进行同等速度的重新计算。
输入 vLLM TTFT SGLang HiCache TTFT vLLM 等效输入吞吐 SGLang 等效输入吞吐 SGLang cache 来源 8K 0.22 s 0.14 s 16.9k tok/s 22.4k tok/s GPU 7,936 / host 0 16K 0.29 s 0.19 s 28.3k tok/s 50.9k tok/s GPU 15,936 / host 0 32K 0.54 s 0.29 s 37.2k tok/s 73.6k tok/s GPU 31,936 / host 0 64K 1.25 s 0.48 s 38.8k tok/s 94.1k tok/s GPU 63,936 / host 0 85K 0.63 s 0.54 s 79.2k tok/s 84.9k tok/s GPU 84,992 / host 0 128K — 0.87 s — 109.4k tok/s GPU 127,936 / host 0 怎么理解这组结果
- 一次性长文处理:选 vLLM。 本轮 vLLM 冷路径从 8K 到 85K 的 TTFT 都明显低于 SGLang HiCache。
- 重复同一上下文:两者都够快。 同前缀热命中后,两边都进入秒级以下到约 1 秒的 TTFT;日常多轮对话和固定系统提示词都能受益。
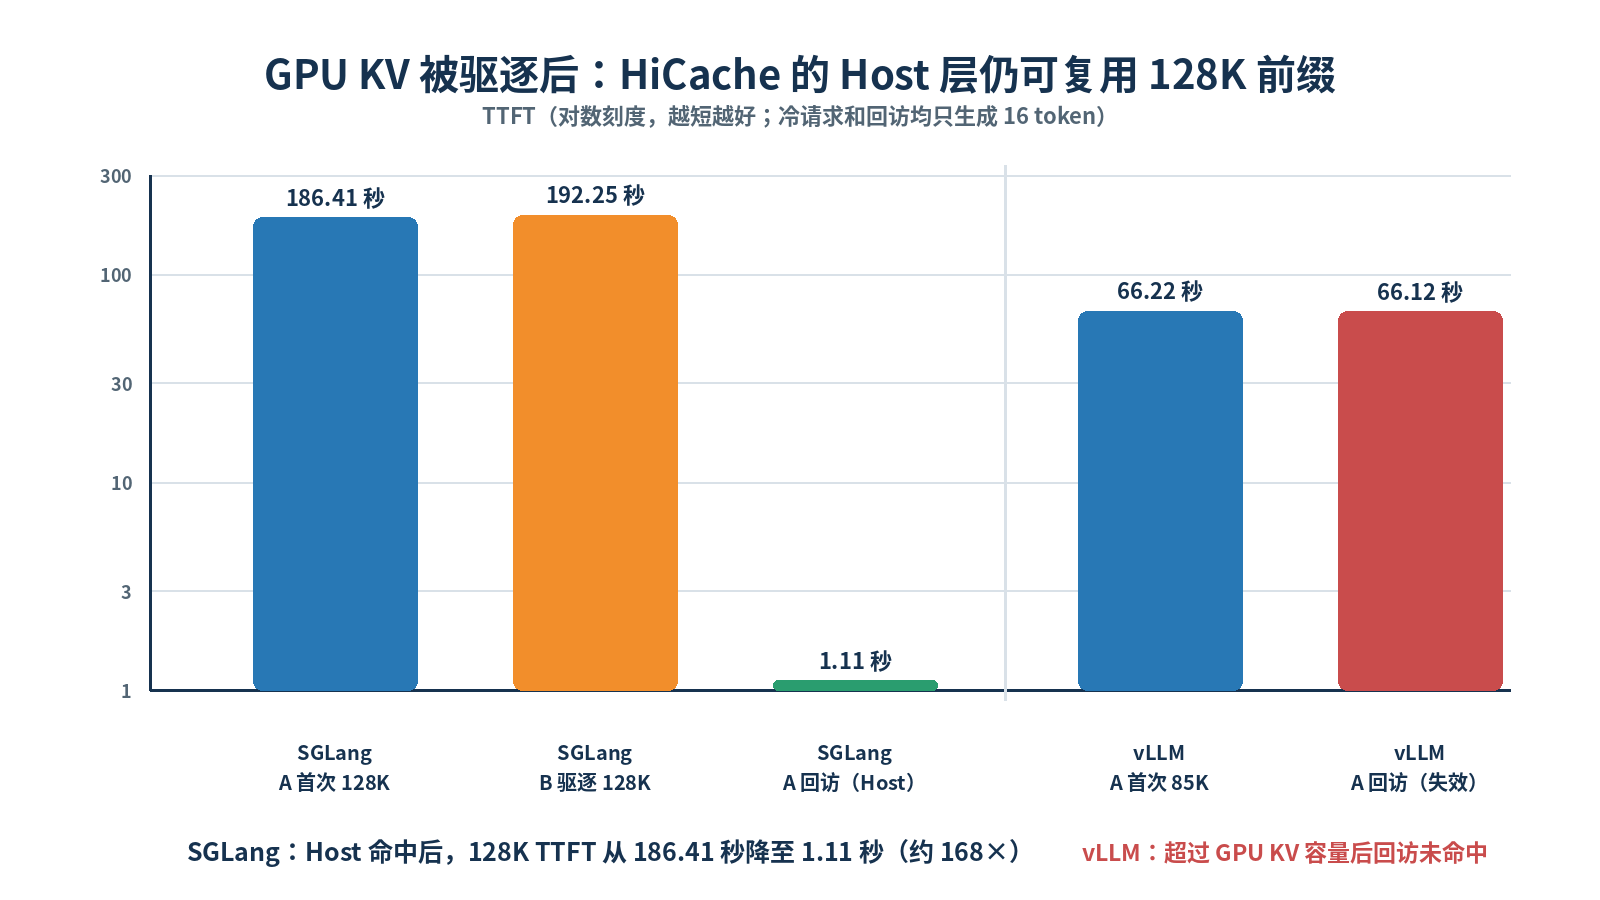
- HiCache 的独特价值在 GPU KV 被驱逐后。 常规热请求仍在 GPU KV 内时,两者都很快;补测中,SGLang 将 128K A 挤出 GPU KV 后仍从 host HiCache 回载 125,952 token,使 TTFT 保持在 1.11 秒。
- vLLM 不能测 128K。 当前桌面 vLLM 启动器上限是 87,040,所以 128K 只有 SGLang 数据,不能用来做框架胜负判断。
补测:GPU KV 被驱逐后,HiCache 的 host 层确实生效
这一轮专门验证此前未覆盖的 host-memory 路径,全部使用 16 输出 token,关注 TTFT 和缓存来源。
引擎 序列 首次 A TTFT 驱逐后 A TTFT 回访缓存结果 SGLang HiCache 128K A → 不同 128K B → A 186.41 s 1.11 s 125,952 cached tokens;device=0,host=125,952 vLLM prefix cache 85K A → 5 个不同 85K 前缀 → A 66.22 s 66.12 s Prefix cache hit rate: 0.0%SGLang 的 B 写入后,A 已不在 159.7K-token 的 GPU KV 容量内;回访时 cache report 明确显示所有可复用 token 均从 host HiCache 回载。TTFT 从 186.41 秒降至 1.11 秒(约 168×)。
vLLM 启动日志报告 GPU KV 总容量约 443.6K token;A 加上 5 条不同的 85K 前缀约为 510K token,足以触发驱逐。A 回访与首次 TTFT 基本相同,且服务日志为 0% prefix-cache hit。这说明当前这套 vLLM 配置只有 GPU 前缀缓存,没有可用于该工作负载的 host 层回载。
为什么本机日常服务限制在 85K
这台机器不是不能处理 128K:SGLang HiCache 已验证可以完成 128K 冷请求,也能在前缀被 GPU KV 驱逐后从主机内存快速回载。但日常服务仍设为 85K,原因是它是更均衡、更稳定的常用档位:
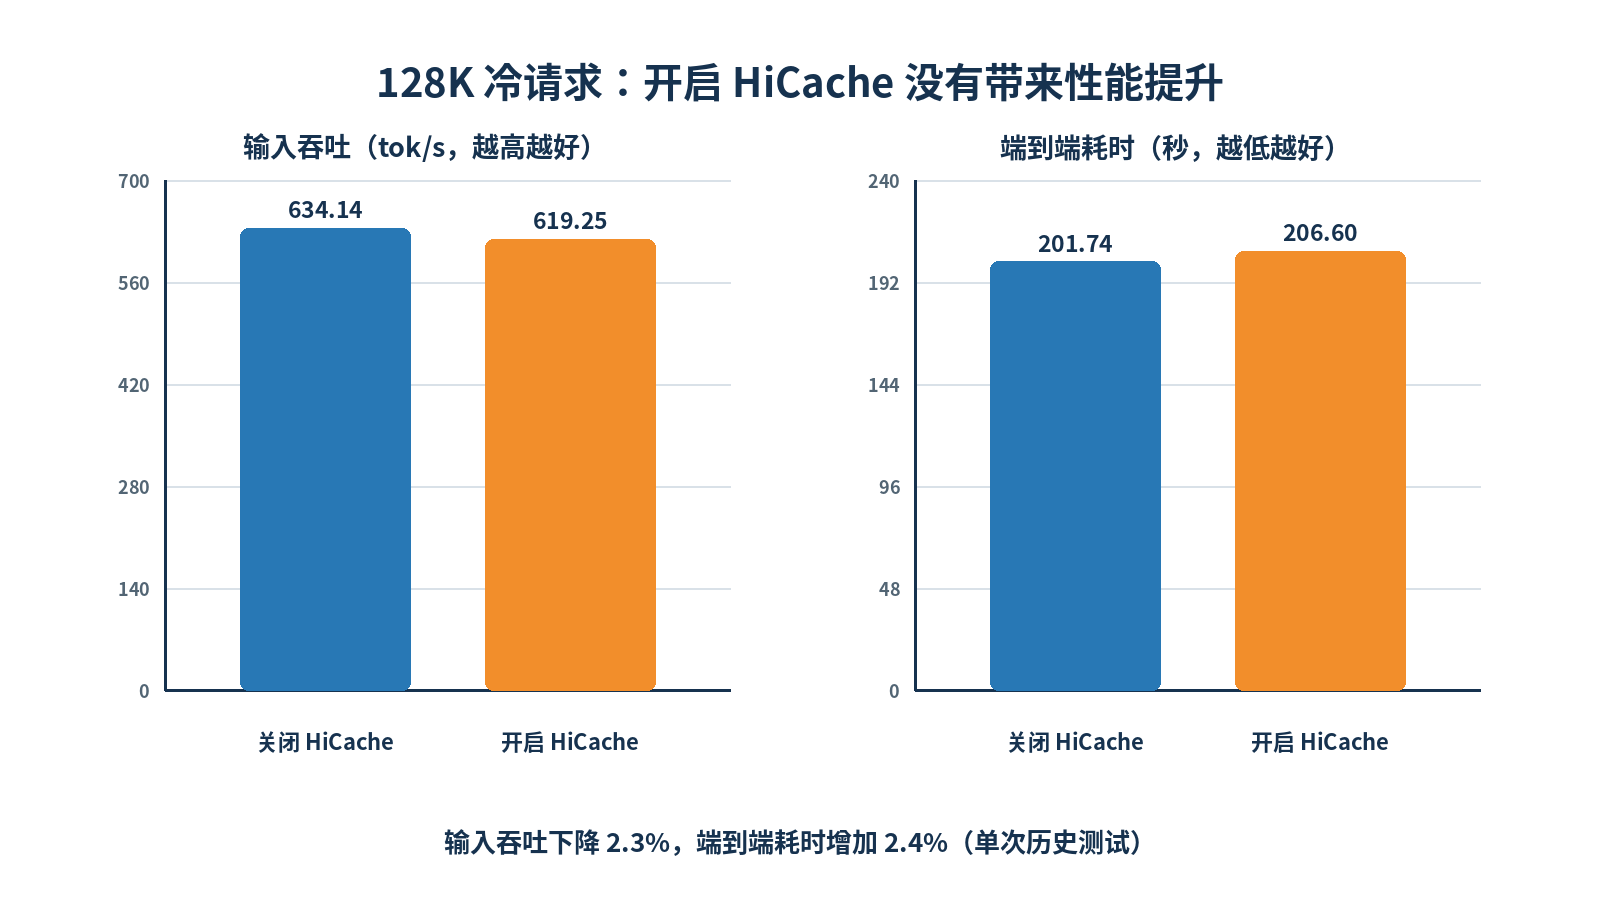
- 冷请求等待更可控。 SGLang HiCache 的 85K TTFT 约 100 秒,128K 约 193 秒;上下文增加约 1.5 倍,首字等待接近翻倍。对单次长文、临时提问和 Agent 任务而言,85K 的体感明显更好。
- 保留更多 GPU KV 余量。 当前日常 85K 配置可用 GPU KV 容量约 233k token,适合单用户长会话及后续多轮追问;128K HiCache 配置的 GPU KV 容量约 159.7k token,余量更紧。
- HiCache 让长上下文按需可用。 真正需要 128K 的重复代码库、长文档或 RAG 前缀时,可以启用 HiCache;即使旧前缀已被挤出 GPU KV,补测仍能以 1.11 秒 TTFT 回载。
因此,本机的实际取舍是:85K 作为默认常驻配置,优先保证日常交互与容量余量;128K + HiCache 留给确实需要超长上下文、且能从前缀复用中获益的任务。
-
-
-
补几个读表口径,免得这组不错的数据被读过头:
1)这是「两套可用配置」对比,不是单变量引擎 A/B。至少五处不一致:KV 精度(vLLM FP8 vs SGLang BF16)、投机解码(DFLASH vs 关)、attention 后端、max_model_len(87,040 vs 196,608)、缓存层级(GPU-only vs GPU+host)。所以「冷请求 vLLM 更快」里有一部分是 FP8 KV 省了一半 KV 读流量、以及没开投机带来的,不能整笔记到引擎头上。要引擎结论,就把两边锁成同 KV 精度、同投机开关、同 max_model_len、同 batch/ubatch 再跑。
2)85K 的 vLLM TTFT 比 64K 低,你自己也点到了,是单样本 + 首次 JIT/调度抖动造成的非单调点。每档先预热一次,再重复 3 次取中位数,把首个请求剔除。
3)HiCache 那条要把链路讲出来:125,952 token 的 KV 在 1.11s 内从 host 回载,实际是被 PCIe 带宽限住的(TP=2、两张 x8)。换到 PCIe 5.0 x16 的平台回载还能更快;同时 host 池别开太大,ratio=2.0 在 96G 内存上会和页缓存抢,A 的 KV 越贴内存上限越容易被 swap 拖崩。
4)vLLM 85K 的 A 被 5 条前缀挤出后 hit=0%,是当前实现的预期:它的 prefix cache 只驻 GPU,驱逐即丢;--swap-space 是 prefill 的 KV swap,不是跨请求前缀缓存。所以这不是「vLLM 前缀缓存失效」,是两条路线的差异。
5)选型上你的取舍(85K 常驻 + 128K/HiCache 按需)是对的:一次性长文选 vLLM 冷路径省心;同一大前缀反复问(Agent、固定系统提示、代码库)时 HiCache 的 host 层才是决定性的。
要更硬的结论,补两组:①同 KV 精度、同投机开关的纯引擎对比;②vLLM 侧把 max-model-len 放宽到 131072 跑通,才有 128K 的一致对照。
-
-
-
回帖:双 7900XTX + Qwen3.8-27B TP=2 复刻了你这套 HiCache 实验,补一个我们踩到的坑
楼主这帖我照抄了一遍。我们这边正好也是一台双 7900XTX(TP=2,Qwen3.8-27B 系,上下文 196608,GPU KV 池 242,854 token),把楼主那套"驱逐回访"实验原样复刻,结论基本对得上,但踩到一个楼主没提到的坑,顺手报一下,免得后来人白折腾一下午。
一、实验(照抄楼主的语义)
A(128K) 冷 → A 立刻再问一次(GPU 热命中)→ B(128K) 冷 → C(128K) 冷(把 A 挤出 GPU KV)→ A 回访
判据只看第 ⑤ 步的 TTFT;全程不调 flush_cache(一调这实验就废了)
二、结果
配置 ① A 冷 ② A 热(GPU 命中) ⑤ A 回访(已被挤出) 主存占用 不开 HiCache 166.67 s 0.89 s 166.42 s(1.00×) — HiCache, write_back— 1.10 s 171.02 s(0.87×) 48 GB HiCache, write_through169.25 s 0.91 s 1.38 s(0.01×,120×) 48 GB 跟你那边的 186.41 s → 1.11 s 是一回事:这一格确实能靠主机内存救回来,量级对得上。
三、坑一:写策略选错,等于白开(这条最值得说)
第一次我按"省事"选了
--hicache-write-policy write_back(想着只在驱逐时搬运,最不打扰预填充),结果:- 主机池真的建起来了:两个 rank 的
sglang::scheduler进程 RSS 各 26 GiB,/proc/meminfo里 Shmem 48 GB; - 服务自报参数全对:
enable_hierarchical_cache: True、hicache_size 24、hicache_write_policy: 'write_back'、hicache_io_backend: 'kernel'、hicache_mem_layout: 'page_first'; - 启动日志零告警零报错;
- 需要的算子也在(
torch.ops.sgl_kernel里transfer_kv_per_layer/transfer_kv_all_layer都取得到);
但第 ⑤ 步还是 171.02 s(0.87×)—— 全量重算,一点便宜没捡到。
换成
write_through之后,同样的池子、同样的其余参数,第 ⑤ 步直接 1.38 s。⇒ 教训:光看日志、看进程内存、看
/get_server_info自报参数,都判不出它到底有没有生效。 唯一可信的判据就是第 ⑤ 步那个数字。所以顺序应该是:先换write_through试;不行再怀疑io_backend;最后才怀疑构建/算子。四、坑二:
--hicache-size的单位是「每个 rank 的 GB」,不是总数我一开始按总数估的,写
--hicache-size 48,想着"48 GB 内存留出来"。实际是每个 rank 各 48.5 GiB ⇒ 这台 125 GB 的机器上MemAvailable直接从 113 GB 掉到 23 GB,正好落进"和页缓存抢、贴上限被 swap 拖崩"那个区间。改成
--hicache-size 24⇒ 实占 48 GB、可用内存还有 70 GB,容量约 2× GPU KV 池,正好对应默认--hicache-ratio 2.0的语义。⇒ TP=N 的话,按 N × size 估内存;或者干脆不写 size,用
--hicache-ratio让它按显存池比例算。五、冷路径代价
166.67 s → 169.25 s(+1.5%),而且这是在我们散热更好、风扇曲线已修的条件下测的 ⇒ 基本可以忽略,没有理由不开。
六、一个想跟楼主核对的地方
楼主那张"冷请求"表里,vLLM 85K 的是 0.64 s。按 85K token 算是 132,800 tok/s;而同帖驱逐复测里,vLLM 真正的冷 85K 是 66.22 s(约 1,284 tok/s)。同帖同一框架差 约 100 倍,这两列应该不是同一个口径(我怀疑第一张表那列其实是缓存命中,每档之间没清缓存)。
如果这个成立,"一次性长文档选 vLLM"这个结论可能得再看一眼。我们自己的对照是:同一台机器上 vLLM 的 256K 冷 prefill ≈ 2080 tok/s,SGLang ≈ 800 tok/s —— 不过那是另一对卡(R9700 vs 7900XTX)跑出来的数,口径不同,只作参考。楼主如果有条件,在同一对 7900XTX、同一模型上补一组严格冷启动对照,这个结论就硬了。
- 主机池真的建起来了:两个 rank 的
-
-
-
-
回帖:双 7900XTX + Qwen3.8-27B TP=2 复刻了你这套 HiCache 实验,补一个我们踩到的坑
楼主这帖我照抄了一遍。我们这边正好也是一台双 7900XTX(TP=2,Qwen3.8-27B 系,上下文 196608,GPU KV 池 242,854 token),把楼主那套"驱逐回访"实验原样复刻,结论基本对得上,但踩到一个楼主没提到的坑,顺手报一下,免得后来人白折腾一下午。
一、实验(照抄楼主的语义)
A(128K) 冷 → A 立刻再问一次(GPU 热命中)→ B(128K) 冷 → C(128K) 冷(把 A 挤出 GPU KV)→ A 回访
判据只看第 ⑤ 步的 TTFT;全程不调 flush_cache(一调这实验就废了)
二、结果
配置 ① A 冷 ② A 热(GPU 命中) ⑤ A 回访(已被挤出) 主存占用 不开 HiCache 166.67 s 0.89 s 166.42 s(1.00×) — HiCache, write_back— 1.10 s 171.02 s(0.87×) 48 GB HiCache, write_through169.25 s 0.91 s 1.38 s(0.01×,120×) 48 GB 跟你那边的 186.41 s → 1.11 s 是一回事:这一格确实能靠主机内存救回来,量级对得上。
三、坑一:写策略选错,等于白开(这条最值得说)
第一次我按"省事"选了
--hicache-write-policy write_back(想着只在驱逐时搬运,最不打扰预填充),结果:- 主机池真的建起来了:两个 rank 的
sglang::scheduler进程 RSS 各 26 GiB,/proc/meminfo里 Shmem 48 GB; - 服务自报参数全对:
enable_hierarchical_cache: True、hicache_size 24、hicache_write_policy: 'write_back'、hicache_io_backend: 'kernel'、hicache_mem_layout: 'page_first'; - 启动日志零告警零报错;
- 需要的算子也在(
torch.ops.sgl_kernel里transfer_kv_per_layer/transfer_kv_all_layer都取得到);
但第 ⑤ 步还是 171.02 s(0.87×)—— 全量重算,一点便宜没捡到。
换成
write_through之后,同样的池子、同样的其余参数,第 ⑤ 步直接 1.38 s。⇒ 教训:光看日志、看进程内存、看
/get_server_info自报参数,都判不出它到底有没有生效。 唯一可信的判据就是第 ⑤ 步那个数字。所以顺序应该是:先换write_through试;不行再怀疑io_backend;最后才怀疑构建/算子。四、坑二:
--hicache-size的单位是「每个 rank 的 GB」,不是总数我一开始按总数估的,写
--hicache-size 48,想着"48 GB 内存留出来"。实际是每个 rank 各 48.5 GiB ⇒ 这台 125 GB 的机器上MemAvailable直接从 113 GB 掉到 23 GB,正好落进"和页缓存抢、贴上限被 swap 拖崩"那个区间。改成
--hicache-size 24⇒ 实占 48 GB、可用内存还有 70 GB,容量约 2× GPU KV 池,正好对应默认--hicache-ratio 2.0的语义。⇒ TP=N 的话,按 N × size 估内存;或者干脆不写 size,用
--hicache-ratio让它按显存池比例算。五、冷路径代价
166.67 s → 169.25 s(+1.5%),而且这是在我们散热更好、风扇曲线已修的条件下测的 ⇒ 基本可以忽略,没有理由不开。
六、一个想跟楼主核对的地方
楼主那张"冷请求"表里,vLLM 85K 的是 0.64 s。按 85K token 算是 132,800 tok/s;而同帖驱逐复测里,vLLM 真正的冷 85K 是 66.22 s(约 1,284 tok/s)。同帖同一框架差 约 100 倍,这两列应该不是同一个口径(我怀疑第一张表那列其实是缓存命中,每档之间没清缓存)。
如果这个成立,"一次性长文档选 vLLM"这个结论可能得再看一眼。我们自己的对照是:同一台机器上 vLLM 的 256K 冷 prefill ≈ 2080 tok/s,SGLang ≈ 800 tok/s —— 不过那是另一对卡(R9700 vs 7900XTX)跑出来的数,口径不同,只作参考。楼主如果有条件,在同一对 7900XTX、同一模型上补一组严格冷启动对照,这个结论就硬了。
- 主机池真的建起来了:两个 rank 的


 站长已核:本帖设为精华,作者 +5 积分奖励,希望再接再厉!