跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI Agent
  4. 7900 XTX 的可能性探索|单卡篇(四):魔法打败魔法 - 7900XTX Strata 引擎跑Qwen3.8 Flash-Next 快得让我怀疑人生

7900 XTX 的可能性探索|单卡篇(四):魔法打败魔法 - 7900XTX Strata 引擎跑Qwen3.8 Flash-Next 快得让我怀疑人生

已定时 已固定 已锁定 已移动 精华 热议 AI Agent
7900xtxstrataqwen-flash
26 帖子 10 发布者 1.8k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • PrioP Prio

    好像还是没有3090的decode 输出快

    A
    A
    applejuice
    技术大牛 劳动模范
    编写于 最后由 编辑
    #4

    @Prio 我个人觉得decode 有50+ 就够了

    希望prefill 能上3000,至少有2000 才舒服

    Ben LeeB 1 条回复 最后回复
    0
    • kos orK
      kos orK
      kos or
      超凡大师
      编写于 最后由 编辑
      #5

      我的RX7900 XTX 看到了新希望

      1 条回复 最后回复
      0
      • E
        E
        exllm
        德高望重
        编写于 最后由 编辑
        #6

        ddr3, ddr4 会不会慢很多? 稍后我也试试

        1 条回复 最后回复
        0
        • xiaopbroX
          xiaopbroX
          xiaopbro
          德高望重
          编写于 最后由 编辑
          #7

          这是重大利好啊,R9700怎么样?我现在有2张R9700 和128G ddr4内存,那我是拆成2台独立主机还是并成一台比较好?x99洋垃圾平台我有2套,

          Ben LeeB 1 条回复 最后回复
          0
          • Ben LeeB
            Ben LeeB
            Ben Lee
            超凡大师
            编写于 最后由 编辑
            #8

            补充更新(10 月 1 日):Strata 升级 + RDNA3 WMMA,Prefill提升约 18%

            上一篇测试使用的是:

            Strata v0.1.27

            搜到了一个好东西RDNA3 WMMA 优化。又肝了一晚,把测试环境升级到了:

            Strata v0.1.31 + PR #313

            原来的生产 tree 没动,另外开了独立 worktree 编译测试。

            结果相当直接:

            单卡 RX 7900 XTX,192K Context

            Prefill:1081.3 → 1268.5 t/s

            Decode:58.2 → 58.7 t/s

            也就是说:

            Prefill +17.3%,Decode 基本不变。

            而且这不是某一个短 Context 的偶然高点。

            我按统一口径重新跑了:

            8K / 32K / 64K / 128K / 192K

            每档:

            • 2 次 warmup
            • 3 次正式测试
            • 使用引擎自报纯 Prefill
            • Context 按整数档重新构造
            • 其它运行参数保持一致

            结果如下:

            Context 实际 Prompt 原版 Prefill WMMA Prefill 提升
            8K 8,095 1209.2 1413.6 +16.9%
            32K 32,416 1211.8 1438.9 +18.7%
            64K 64,836 1206.8 1417.8 +17.5%
            128K 129,677 1143.8 1351.6 +18.2%
            192K 194,517 1081.3 1268.5 +17.3%

            五档平均提升大约:

            +17.7%


            这次优化是什么?

            这次用的是 Strata 的:

            RDNA3 WMMA PR #313

            它的前身是 PR #260,后来重新整理并以新的方式实现。

            核心目的很直接:

            把 RX 7900 XTX / gfx1100 上的 RDNA3 v_wmma_* 矩阵指令真正用起来。

            主要包括两条路径:

            • Dense WMMA GEMM
            • WMMA Prompt Attention

            也就是说,这次不是单纯改几个参数,也不是换一个更激进的 benchmark 配置。

            而是:

            让 gfx1100 原本没有充分利用的矩阵计算能力真正参与 Prefill。


            特别感谢这条优化的作者和 Strata 维护者 🙏

            相关项目和 PR:

            • Strata
              https://github.com/Niko1221/Strata

            • RDNA3 WMMA 原始 PR #260
              https://github.com/Niko1221/Strata/pull/260

            • 后续重做版 PR #313
              https://github.com/Niko1221/Strata/pull/313

            特别感谢提交和维护这条 RDNA3 WMMA 优化路线的贡献者。

            这种优化我很喜欢:

            不是“调几个参数跑分快一点”,而是真正把 gfx1100 上原本没有吃满的硬件能力用起来。


            为什么这次 +18% 我觉得很有价值?

            因为我的 baseline 本身已经不是一个没有调过的 Strata。

            上一篇那套已经包括:

            • gfx1100 HIP 编译
            • MMQ
            • Resident CPU Experts
            • 本地 hipBLASLt 100202 tuning table
            • 27 rows 全部校验 PASS
            • Prefill chunk 8192
            • 5 个 CPU worker
            • int8 KV
            • 32K KV resident budget

            也就是说:

            这不是拿一个慢 fallback 去和 WMMA 比。

            而是在我上一篇已经优化过、已经跑到 1000+ Prefill 的配置上:

            再稳定叠加约 18%。

            这个结果比单点高分对我更有意义。


            怎么开启?

            PR #313 的 WMMA 默认关闭。

            需要手动开启:

            export STRATA_WMMA_GEMM=1
            export STRATA_PA_WMMA=1
            

            我最终使用的是:

            STRATA_WMMA_GEMM=1
            STRATA_PA_WMMA=1
            

            在我这套配置上,两个开关必须一起开

            我专门测试过:

            只开:

            STRATA_WMMA_GEMM=1
            

            但不开:

            STRATA_PA_WMMA
            

            32K 反而变慢:

            原版:1211.8 t/s

            只开 GEMM:916 t/s

            所以至少在我当前这套:

            RX 7900 XTX
            Orca IQ3_XXS
            Strata v0.1.31 + PR #313

            上,我最终采用的是:

            WMMA GEMM + WMMA Prompt Attention 两个一起开。

            不要根据“GEMM 是主要优化项”就想当然地只开一个。


            编译

            编译参数和上一篇第 2 节基本一致:

            • HIP
            • gfx1100
            • MMQ
            • ROCm 7.2.3

            区别只是:

            上一篇:Strata v0.1.27

            本次补测:Strata v0.1.31 + PR #313

            我是在独立 worktree 上重新编译测试的。

            原来的生产 tree完全没动。

            1 条回复 最后回复
            2
            • xiaopbroX xiaopbro

              这是重大利好啊,R9700怎么样?我现在有2张R9700 和128G ddr4内存,那我是拆成2台独立主机还是并成一台比较好?x99洋垃圾平台我有2套,

              Ben LeeB
              Ben LeeB
              Ben Lee
              超凡大师
              编写于 最后由 编辑
              #9

              @xiaopbro 抱歉啊我没有R9700,所以没法测试。不过我在我的单PC双卡7900XTX上发现了很有意思的玩法,等我搞清楚了我发给新帖子分享思路哈。

              xiaopbroX 1 条回复 最后回复
              1
              • A applejuice

                @Prio 我个人觉得decode 有50+ 就够了

                希望prefill 能上3000,至少有2000 才舒服

                Ben LeeB
                Ben LeeB
                Ben Lee
                超凡大师
                编写于 最后由 编辑
                #10

                @applejuice 刚发了个更新,现在全线prefill提高到了1250~1450这个区间。

                1 条回复 最后回复
                0
                • Ben LeeB Ben Lee

                  @xiaopbro 抱歉啊我没有R9700,所以没法测试。不过我在我的单PC双卡7900XTX上发现了很有意思的玩法,等我搞清楚了我发给新帖子分享思路哈。

                  xiaopbroX
                  xiaopbroX
                  xiaopbro
                  德高望重
                  编写于 最后由 编辑
                  #11

                  @Ben-Lee 说:

                  @xiaopbro 抱歉啊我没有R9700,所以没法测试。不过我在我的单PC双卡7900XTX上发现了很有意思的玩法,等我搞清楚了我发给新帖子分享思路哈。

                  等着新玩法

                  Ben LeeB 1 条回复 最后回复
                  0
                  • xiaopbroX xiaopbro

                    @Ben-Lee 说:

                    @xiaopbro 抱歉啊我没有R9700,所以没法测试。不过我在我的单PC双卡7900XTX上发现了很有意思的玩法,等我搞清楚了我发给新帖子分享思路哈。

                    等着新玩法

                    Ben LeeB
                    Ben LeeB
                    Ben Lee
                    超凡大师
                    编写于 最后由 编辑
                    #12

                    @xiaopbro 其实就是一个27B一个Flash Next,但是发现了一些问题,正在解决优化。也可以双卡跑Flash Next,但是prefill 升, decode 降,我也再找双提升的办法。

                    1 条回复 最后回复
                    0
                    • xiaopbroX
                      xiaopbroX
                      xiaopbro
                      德高望重
                      编写于 最后由 编辑
                      #13

                      R9700失败了,
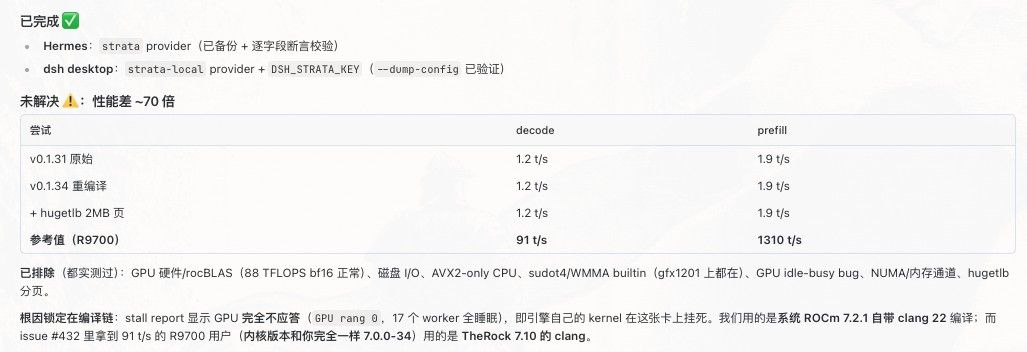
                      image.jpeg

                      Ben LeeB 1 条回复 最后回复
                      0
                      • K
                        K
                        kenshin
                        编写于 最后由 编辑
                        #14

                        能用,但还是尴尬,64G内存不够霍霍。继续跑27B了。

                        A Ben LeeB 2 条回复 最后回复
                        0
                        • K kenshin

                          能用,但还是尴尬,64G内存不够霍霍。继续跑27B了。

                          A
                          A
                          applejuice
                          技术大牛 劳动模范
                          编写于 最后由 applejuice 编辑
                          #15

                          @kenshin 我的64gb内存也不够了
                          买了显卡 现在到内存不够

                          3090x2 + r9700

                          1 条回复 最后回复
                          0
                          • K kenshin

                            能用,但还是尴尬,64G内存不够霍霍。继续跑27B了。

                            Ben LeeB
                            Ben LeeB
                            Ben Lee
                            超凡大师
                            编写于 最后由 编辑
                            #16

                            @kenshin 我也是64G内存,我这边在 7900 XTX + Strata 跑 Flash-Next 也踩过这个坑, 一开始测试的时候也是报内存不够,调整了几次就好了。

                            Strata 的 --resident-cpu-experts 模式启动时对 系统 RAM 可用量要求很高,不是看你“装了多少 RAM”,而是看启动瞬间还有多少 available memory。
                            我这边 Orca IQ3_XXS 的实测大概是:

                            • expert resident RAM:约 31.95 GiB
                            • prefill borrow:约 3.92 GiB
                            • 再加模型运行、page cache、Strata 本身以及安全余量
                              实际建议启动前至少留出 约 50 GiB 可用 RAM。
                              我这台机器只有 64GB RAM,所以如果另一张卡上的 27B 服务、Hermes 或其他进程也在吃内存,Strata 就很容易在加载阶段失败,或者退回 mmap 路径,性能会明显掉。

                            我最后的办法不是乱调参数,而是:

                            1. 先看 MemAvailable,不要只看总内存。
                            2. 启动 Strata 前先卸载/停掉占系统 RAM 很多的其他模型。
                            3. 确保 swap 不在疯狂工作;能启动但一直 swap,速度也会很难看。
                            4. 如果要跑我们那套高性能配置,尽量保留:
                              --resident-cpu-experts
                            5. 实在内存不够,可以不用 resident CPU experts、改走 mmap/streaming,但这是“能跑”的方案,不是我们测到 1000+ Prefill 的那套性能方案。

                            其实都是我的本地Agent在搞,我就是一直给它鼓励和压力,它就自己搞出来了,哈哈

                            1 条回复 最后回复
                            1
                            • xiaopbroX xiaopbro

                              R9700失败了,
                              image.jpeg

                              Ben LeeB
                              Ben LeeB
                              Ben Lee
                              超凡大师
                              编写于 最后由 编辑
                              #17

                              @xiaopbro 这个看起来不像是 R9700 跑不了 Strata。我问了下 AI,更可能是 gfx1201 这边的编译 / ROCm 环境有问题。

                              Strata 现在已经正式支持 R9700 / gfx1201,官方也有 R9700 实机跑通的记录。现在比较靠谱的路线,一个是 system ROCm 7.14,另一个就是直接走 Strata setup 自带的 TheRock 7.10 gfx120X。

                              你现在这套是 ROCm 7.2.1 + clang 22,而且 stall report 已经显示 GPU kernel 基本没正常跑起来。要不要考虑先换到 Strata 官方推荐的 TheRock / gfx120X 环境再重新编一次试试?

                              对了,我的 7900 XTX 那套手工 ROCm / hipBLASLt / WMMA 参数别原样照搬过去,那套是针对 gfx1100 调的,gfx1201 不是一回事。

                              xiaopbroX 1 条回复 最后回复
                              1
                              • Ben LeeB Ben Lee

                                @xiaopbro 这个看起来不像是 R9700 跑不了 Strata。我问了下 AI,更可能是 gfx1201 这边的编译 / ROCm 环境有问题。

                                Strata 现在已经正式支持 R9700 / gfx1201,官方也有 R9700 实机跑通的记录。现在比较靠谱的路线,一个是 system ROCm 7.14,另一个就是直接走 Strata setup 自带的 TheRock 7.10 gfx120X。

                                你现在这套是 ROCm 7.2.1 + clang 22,而且 stall report 已经显示 GPU kernel 基本没正常跑起来。要不要考虑先换到 Strata 官方推荐的 TheRock / gfx120X 环境再重新编一次试试?

                                对了,我的 7900 XTX 那套手工 ROCm / hipBLASLt / WMMA 参数别原样照搬过去,那套是针对 gfx1100 调的,gfx1201 不是一回事。

                                xiaopbroX
                                xiaopbroX
                                xiaopbro
                                德高望重
                                编写于 最后由 编辑
                                #18

                                @Ben-Lee 已经跑起来了, 就是用你说的TheRock 7.10 gfx120X这个

                                Ben LeeB 1 条回复 最后回复
                                0
                                • xiaopbroX xiaopbro

                                  @Ben-Lee 已经跑起来了, 就是用你说的TheRock 7.10 gfx120X这个

                                  Ben LeeB
                                  Ben LeeB
                                  Ben Lee
                                  超凡大师
                                  编写于 最后由 编辑
                                  #19

                                  @xiaopbro 哦太好了,恭喜恭喜!我最近注意到,R9700 这条 RDNA4 / gfx1201 线的优化进展,感觉明显比 RDNA3 / gfx1100 快不少。很多新 kernel、WMMA、ROCm 适配好像都是先照顾 RDNA4。你这边如果把编译环境理顺,后面应该还有不少性能可以挖。

                                  xiaopbroX 1 条回复 最后回复
                                  0
                                  • Ben LeeB Ben Lee

                                    @xiaopbro 哦太好了,恭喜恭喜!我最近注意到,R9700 这条 RDNA4 / gfx1201 线的优化进展,感觉明显比 RDNA3 / gfx1100 快不少。很多新 kernel、WMMA、ROCm 适配好像都是先照顾 RDNA4。你这边如果把编译环境理顺,后面应该还有不少性能可以挖。

                                    xiaopbroX
                                    xiaopbroX
                                    xiaopbro
                                    德高望重
                                    编写于 最后由 编辑
                                    #20

                                    @Ben-Lee 哈哈,主要还是感谢大佬帖子的启发

                                    1 条回复 最后回复
                                    0
                                    • K
                                      K
                                      kenshin
                                      编写于 最后由 编辑
                                      #21

                                      这个方案出来后,内存又有理由再涨一波了。哈哈哈(苦笑······)

                                      Ben LeeB 1 条回复 最后回复
                                      0
                                      • Ben LeeB
                                        Ben LeeB
                                        Ben Lee
                                        超凡大师
                                        编写于 最后由 编辑
                                        #22

                                        @xiaopbro 我是纯小白!跟着真大佬在这个论坛里混,然后剽窃我的本地AI的成果发表论文😂

                                        1 条回复 最后回复
                                        0
                                        • K kenshin

                                          这个方案出来后,内存又有理由再涨一波了。哈哈哈(苦笑······)

                                          Ben LeeB
                                          Ben LeeB
                                          Ben Lee
                                          超凡大师
                                          编写于 最后由 编辑
                                          #23

                                          @kenshin 其实27B已经很好了,24G以上显存都能跑,看在钱的份上,本地跑慢点就慢点,总归能熬到显卡和内存价格回归理性的一天。另外,类似turboQ这种KV压缩技术最近又有新的创新,硬件的潜力还能被社区大神们进一步挖掘。

                                          1 条回复 最后回复
                                          0
                                          • ,terryT terry 固定了此主题

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组