
gufo對決Halogen 實測Qwen3.8-Flash-Next (AMD AI Max+395)
-
gufo 跑 Qwen3.8-Flash-Next 完整設定與實測
halogen 的對家來了:開源引擎gufo、HF 公開 GGUF 104G
實測環境:AMD Strix Halo(Ryzen AI MAX+ 395,Radeon 8060S),2026-10。
目標讀者:同架構想抄作業的人。照貼可跑。
姊妹篇:
halogen-flash-server 跑 Qwen3.8-Flash-Next 完整設定與實測
新的推論引擎gufo 速度可比Halogen 還開源
在reddit的strixhalo社群中,最近很紅的開源框架gufo出來幾天了,很快的版本來到v0.4.0,
於此同時halogen 也很快更新到0.16.0版,這兩個都標榜Strix Halo專機設計的推論框架,今天同場競技吧~1. 案例系統
項目 值 APU AMD Strix Halo gfx1151,32 thread統一記憶體 128 GB 資料碟 2 TB NVMe Gen4(模型+cache 全放這) OS Nobara 44(Fedora 系) ROCm host 7.2.4;gufo 診斷自報 pinned 7.2.3(相容跑得動, gufo diagnose全綠)Engine gufo-org/gufov0.4.0(commitd7cf7ee),原始碼 build,單行程:8741模型 Qwen3.8 Flash Next/Unsloth UD-Q4_K_XL4 shards 103.7 GiB + MTP sidecar(shared Q8_0)+ mmproj(BF16)
2. 特別項目與特殊量化模型介紹
2.1 gufo 是什麼(開源、通用 ROCm 引擎,不是私有 checkpoint)
gufo-org 開源推論引擎(Apache/MIT 類,README 有 docs 全套),v0.4.0。跟 halogen 最大的不同:它是通用引擎,吃 HF 公開 GGUF,不綁自家量化。重點能力:
- serve llm:
gufo serve llm --model ... --served-model-name ... -i -p,OpenAI 相容(/v1/chat/completions、/v1/models、tool calling) - 原生關思考:
--think off(server log 自報thinking=off),不用 per-request flag - adaptive MTP 投機:
--speculative mtp --mtp-model <sidecar>,實測draft_limit=7;另有off/dspark/dflash2模式 - ContinuationCache 兩層:記憶體層永遠開(
snapshot_cache_configured entries=128 capacity≈16.7GiB),disk 層--cache-disk選配;存的是「prompt+回覆」整段快照,只能整段當精確前綴續用(見 §3.4,測錯方法會誤判沒 cache) - 原生 JSON 約束:
response_format: json_object走引擎內建約束(會扣 ~26% 速度,見 §4.1) - vision:掛
--mmproj即可(/v1/models顯示 text+image) - 262144 ctx;
max_connections=16、max_body=8MB
2.2 模型:HF 公開 GGUF,不是私有 checkpoint
Unsloth
Qwen3.8-Flash-Next-UD-Q4_K_XL,4 shards 共 103.7 GiB(du104G)+MTP/mtp-...-shared-Q8_0.gguf+mmproj-BF16.gguf。跟 halogen 的 5.53bpw 專屬算法(118G)相比:任何人在 HF 隨手可抓、可驗、可換 quant——這是開源生態 vs 專屬 checkpoint 的根本差異。2.3 跟 llama.cpp 系/halogen 的差異
維度 gufo halogen flash llama.cpp 模型來源 HF 公開 GGUF(Unsloth) 專屬 checkpoint(5.53bpw) HF 公開 GGUF 投機解碼 adaptive MTP(官方質量實證) serial greedy+MTP+51B n-gram 表 MTMD/DFlash 等 prefix cache 機制 ContinuationCache 記憶體層永開:live frontier 原地續用+快照「整段精確前綴」才續用(128 條、16.7GiB 預算);不能修剪,短 prompt 打長快照天然 miss slot KV pool 跨請求複用(實測:同源前綴命中、同 prompt ×9.7);pool 本身就是 prefix cache 容器 三層:① RAM prompt cache( --cache-ram 8192+--cache-idle-slots,跨請求跨 session)② KV shifting(--cache-reuse 1024,非前綴的重複 chunk 也 shift 重用)③ slot 接續SSD 落盤機制 --cache-disk選配 disk 層:快照跨重啟留存、還能「學對話邊界」(共享前綴的不同對話也能切開;本測disk_cache=off未開)HALOGEN_CACHE_DIR=/cache(unit 持久掛/mnt/nvme-data/halogen-cache、health 有cache_counters);n-gram 47G 模型表本體放 SSD 走 page cache;KV 是否落盤待驗--slot-save-path DIR+/slots/{id}?action=save\|restore:跨重啟、跨模型切換保留 KV(本機帶上游 #26676 修補丁,wrapper 自動存還)多會話機制 max_connections=16,per-session 快照各自續用;官方 C1–C8 實測(8 用者 MTP 合計 106–157 tok/s 疊加)4 slot 共用 524288 positions 預算池( HALOGEN_KV_POOL_FIT=1自適應縮水並印決定)slots( --parallel N)各持 KV;多模型走 router 動態互斥(models-preset)+wrapper 自動存還同捆模型 同引擎 7 模型族:Flash-Next、27B、DeepSeek-V4-Flash、MiniMax-H3(文字進影音出)、Qwen3-ASR、Qwen3-TTS、Qwen-Image-2.1;但一行程一模型,切換=重啟 同端口同時:LLM+NPU 小模(0.16.0版後新增decider-0.8b、embedding-0.6b、reranker-0.6b) 多模型 
關思考 --think off原生env 原生 per-request flag 部署 原始碼 build+手動參數 容器映像+自動下載 preset ini+systemd 同捆的差別在形態:halogen 是「一個行程同時端出多種能力」(文字+NPU 小模,適合 agent 直接調 embedding/rerank);gufo 是「同一引擎吃得下 7 個模型族」(多模態全家餐,但一次一個,切換要重啟);llama.cpp 靠 router 層拼裝。
3. gufo配置流程
3.1 建置+診斷
cd ~/git/gufo && # 照官方 README build(BUILD_EXIT=0)
# 診斷必須帶 ROCm lib 路徑,不然找不到 libhipblas.so.3:
LD_LIBRARY_PATH=/opt/rocm/lib ./build/release/gufo diagnose   # 全綠
3.2 啟動(正式參數:MTP 開、思考關、全量 ctx)
export LD_LIBRARY_PATH=/opt/rocm/lib
./build/release/gufo serve llm \
  --model /mnt/nvme-data/gufo-models/qwen3.8-flash-next/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf \
  --mmproj /mnt/nvme-data/gufo-models/qwen3.8-flash-next/mmproj-BF16.gguf \
  --mtp-model /mnt/nvme-data/gufo-models/qwen3.8-flash-next/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf \
  --speculative mtp --think off \
  --served-model-name gufo-qwen3.8-flash-next -i 0.0.0.0 -p 8741
驗證:
curl :8741/health→{"status":"ok"};log 要看到event=load_completed ... speculative=mtp draft_limit=7與listening address=http://0.0.0.0:8741。載入時間:頁快取熱+RAM 乾淨只要 13 秒(官方 C1 基準 15.45s,llama.cpp 117.8s);第一次冷載(daily 服務還在跑)675 秒 — 差在頁快取與 swap 壓力,不是引擎慢。
3.3 GTT 設定(整份文件的關鍵,不修直接 OOM)
翻車現場:104G 模型載到一半
hipMalloc failed for blk.38.ffn_up_exps.weight (471859200 bytes)— AMD 內建 carve 512MiB GTT 上限不夠 MoE 專家分塊。HSA_FORCE_FINE_GRAIN_PCI=1無效。修法(持久化,重開機有效):
# /etc/modprobe.d/ttm-limit.conf
options ttm pages_limit=31457280
options ttm page_pool_size=31457280
# 31457280 頁 × 4KiB = 120 GiB GTT;並同步進 BLS 與 /etc/default/grub:
# ttm.pages_limit=31457280 ttm.page_pool_size=31457280(舊參數 amdgpu.gttsize 刪掉)
重開驗證:dmesg 出
122880M of GTT memory ready,64 GiBhipMalloc成功。3.4 ContinuationCache 語義(測錯會誤判沒 cache)
gufo 快照 = prompt+回覆的整段狀態(Flash-Next 還含 GDN recurrent/indexer/sampling 狀態),續用條件是「快照 tokens 是新 prompt 的精確前綴」。所以:
 「同一個 prompt 打兩次」→ 第二次比快照短,天然 miss(我第一次就測出滿盤 miss,文件讀完才懂是方法錯)
- 「對話式第二輪」→ turn1 prompt+回覆正是 turn2 的前綴 → hit
記憶體層永遠開;disk 層(
--cache-disk)測試未開。3.5 地雷(全踩過)
LD_LIBRARY_PATH=/opt/rocm/lib少了就死在libhipblas.so.3。- GTT 沒修 →
blk.38.ffn_up_expshipMalloc 失敗(§3.3)。 - screen 手動跑重開機即失;正式化要 systemd(含
LD_LIBRARY_PATH)。 - prefill 用「同源文字取前綴」測,大點位可能被前綴快取污染(§4.2 有雷標記)。
4. 實測速度(對標 halogen flash-next 0.16.0,同機同題,2026-10-02 更新後重測)
llama.cpp就不測了、沒有競爭力,以下都是開mtp測試
4.1 Decode
口徑 gufo halogen 0.16.0 同題 備註 temp 0.4、250 out、MTP 開 ×3 47.5/48.3/48.2 → 48.0 50.4 掛 MTP 也只到 95%;另注意 halogen 0.16.0 同題改自然停(ct 124–150,finish=stop),舊版是砍滿 250 greedy tg128(官方口徑) fib 49.3、coding 53.1、json 50.0、repetitive ~74 fib 64.1、coding 56.8、json 60.8、repetitive 78.2 halogen 全面領先(fib +30%;coding/json 首發冷,暖跑 63/68) json 原生約束 response_format36.9 tok/s、JSON_VALID ✓ 49.7 tok/s、147 tok finish=stop、JSON_VALID ✓ 兩台約束稅都 ~25%,halogen 級距高一檔 官方 d0 基準對照:AR tg 25.87、MTP mixed 32.20、repetitive 59.30 — 兩台的 greedy 都高於官方 mixed;repetitive 上 gufo ~74、halogen 78.2 都贏官方 59.30。
4.2 Prefill階層速度
prompt(actual) gufo halogen 0.16.0 差 ~1.5K 1020.9(1,539) 1139.3(1,509) halogen +12% ~3K 1162.8(3,042) 1366.4(2,961) halogen +18% ~6K 1345.9(6,077) 1528.5(5,895) halogen +14% ~12K 1391.3(12,135) 1597.5(11,746) halogen +15% ~18K 1400.1(18,135) 1704.8(17,543,峰值) halogen +22% ~38K 1393.3(38,474) 1684.0(37,192) halogen +21% ~104–107K 1303.4(107,248,82.3s) 1594.8(103,632,65.0s) halogen +22%,wall 快 17 秒 ~185–191K 1268.3(191,307,150.8s) 1518.7(184,837,121.7s) halogen +20%,wall 快 29 秒 0.16.0 反轉:舊版 16K 只有 1219.5、198K 1320.9;新版全程 1139→1705→1519,每一階都贏 gufo 12–22%,185K 只花 122 秒。
 ️ gufo MTP 開的階梯有同源前綴污染(103K 點噴 5051 tok/s),gufo 欄採非 MTP 乾淨版;MTP 版待重測。
4.3 Cache(16K 級長 prompt)
gufo halogen 0.16.0 舊 halogen(0.6.1) 對話式第二輪 冷 13.36s → 暖 0.29s(×46) 冷 11.24s → 暖 0.398s(×28.3) — 相同 prompt 兩發 設計上天然 miss(快照含回覆) 冷 10.89s → 暖 1.118s(×9.7) 冷 10.7s → 暖 0.2s(×50) gufo 對話續用更快;halogen 兩種測法都命中,但 identical 暖端從 0.2s 退到 1.1s(restore 路徑變貴,語義待查)。快照語義見 §3.4。
4.4 Agentic(自寫 ReAct harness t1–t8,工具全開)
gufo halogen 0.16.0(同 harness) 分數 8/8,迴圈 0、核彈 0 8/8,迴圈 0、核彈 0 tps 範圍 27.7–37.4 21.7–43.2(t6 一發直拒 rm -rf /)兩台全過;halogen 天花板高(43.2)、地板低(21.7),gufo 穩在 28–37。
5. 測速總表
項目 gufo flash-next(Q4 104G) halogen flash-next 0.16.0(179B 5.53bpw) decode greedy tg128 fib 49.3/coding 53.1/repetitive ~74 fib 64.1/coding 56.8/repetitive 78.2 json 約束(JSON_VALID 兩台 ✓) 36.9 49.7 prefill 16K 附近 1391.3 1597.5 prefill 111K 附近 1303.4(107K,82.3s) 1594.8(104K,65.0s) prefill 198K 附近 1268.3(191K,150.8s) 1518.7(185K,121.7s) cache 對話第二輪 0.29s(×46) 0.398s(×28.3) cache 相同 prompt 兩發 設計上 miss 1.118s(×9.7) agentic 8/8(27.7–37.4 tps) 8/8(21.7–43.2 tps) 載入 13s 熱 幾分鐘(68G 冷載) ctx 上限 262144 262144 體重 104G 磁碟/官方 peak 85.55G 118G 磁碟/95G 常駐(0.6.1 时代數字,0.16.0 待重測) vision (mmproj)(0.6+)多模型 模型來源 HF 公開 GGUF 專屬 checkpoint
6. 結論:兩台專用推論引擎的優缺取捨
一句話(0.16.0 更新後):halogen 今天這版把速度面全面拉開 — decode 與 prefill 每一項都贏 gufo 12–30%;gufo 剩下的牌是開源模型自由度、官方品質實證、對話 cache 續用、13 秒熱啟動。純比快,選 halogen;要折騰權力,選 gufo。
取捨軸 gufo(開源系) halogen 0.16.0(專屬系) decode(兩口徑) 48.0 MTP/greedy 49.3–74 50.4/greedy 56.8–78.2,全面 +12~30%prefill(1.5K→185K) 1021→1400→1268 1139→1705→1519,每階 +12~22%、185K 只要 122scache 對話第二輪 0.29s(×46)0.398s(×28.3) cache 相同 prompt 設計上天然 miss 命中(×9.7,但比舊版 0.2s 退步)模型自由度 HF 公開 GGUF,可換 quant、可審計 5.53bpw 專屬 checkpoint品質保證 官方 QUALITY 全套實證(63 項比對+公開基準)temperature 0 byte-identical 保證 agentic 8/8,tps 穩 27.7–37.4 8/8,tps 21.7–43.2(浮動較大) json 原生約束 36.9(JSON_VALID) 49.7(JSON_VALID)部署整合 ️ 原始碼 build+手動參數+GTT 手修;screen 非持久 容器映像、env 全配、auto-download、watchdog、NPU 小模型同端口載入 13s 熱十幾秒(68G 冷載) 怎麼選:
- 純速度(日常 agent+長文):halogen 0.16.0 全面贏 — 16K 開局快 15%、185K 快 20%、fib decode 快 30%。
- 生態與折騰權力:gufo — HF 公開模型隨你換、原始碼可讀、官方基準持續追蹤、
--speculative四種投機模式可玩;halogen 綁定它家 checkpoint。 - cache 型工作流:對話式續用 gufo 快一截(0.29 vs 0.398);但 halogen 兩種測法都命中、gufo 只吃對話式 — 看你的請求形狀。
這次對決非常驚人,halogen你怎麼可以愈進化愈快,之前說好的開源呢?
我應該會使用gufo體驗幾天啦
- serve llm:
-
-
-
@fcys 天啊~prefill 2080是單路還是多路併發?
這已經摸到DGX Spark用vllm多路併發的速度了
可以分享一下嗎? 有特別調了啥?@dardeaw-feng 先回答:全部是單路(一次一個請求、串行跑)。2080 / 1850 那些數字都是單請求測出來的。
看到你問,我順手補測了 4 路併發(服務
KV_SLOTS=4,4 路同時打 8K 提示詞、max_tokens=256、temp 0):口徑 單路 4 路併發(每路) 聚合 prefill 4.37 s(1830 tok/s) 4.26 / 4.35 / 4.40 s(1877 / 1840 / 1823 tok/s) prefill 不掉 decode 43.2 tok/s 4.4 / 4.9 / 21.4 / 9.3 tok/s 4 路之和 ≈ 40 tok/s 4 路裡有 1 路是同一條提示詞、命中了剛才單路測試留下的前綴快取(
prompt_n=0),所以 prefill 只列另外 3 路;decode 四路都是真實數據。兩個結論:
- prefill 併發幾乎不掉(每路仍 ~1830–1877 tok/s);
- decode 會塌:單路 43.2 → 每路 4–21 tok/s,四路加起來 ≈ 40 tok/s,跟單路同級。
原因寫在引擎自己的啟動日誌裡:
flash_serve: listening on 127.0.0.1:8730, 4 slots over ONE 262144-position KV pool ...
             MTP depth-2 selectable (drafter 1, speculates while alone)
speculates while alone—— 投機解碼只在「獨占」時開,有人同時生成就退回串行。所以多路併發的意義是「多個會話都要有回應」,不是提高總吞吐。
特別調了什麼
硬體 / 內核層
- BIOS 的 UMA frame buffer 調回最小(只 carve 1 GiB),系統可見 124.4 GiB;
- 內核參數(
GRUB_CMDLINE_LINUX_DEFAULT):
amdgpu.gttsize=126976 ttm.pages_limit=32505856 ttm.page_pool_size=32505856 amd_iommu=off開機後
mem_info_gtt_total出 124.0 GiB。(amd_iommu=off是早期做過 A/B 後留下來的設定,這一輪沒有重測。)- 功耗:PBO 開啟,滿載穩定 ~153 W(跑滿 AMD 的 PPT slow 上限);CPU governor 是
powersave。
引擎層(
HALOGEN_*,跟預設不同的就這幾個)參數 我設 官方預設 為什麼 HALOGEN_MAX_TOK16384 32768 prefill arena 減半。0.16.0 上兩者速度在噪聲內(@32K:2001 vs 1957),但 working memory 從 12.5 → 8.1 GiB HALOGEN_KV_POOL_POSITIONS262144 2×CTX = 524288 同理,省下 7.2 GiB 給頁快取 HALOGEN_HOST_RESERVE_GIB24 20 同上,留更多給頁快取 HALOGEN_COMPOSABLE_CONTEXT0 0 實測開著在 8K 提示詞上慢 16.7% HALOGEN_REASONING_EFFORTlow 模板 xhigh 預設在 agent 長鏈上思考過久(慢約 3 倍) HALOGEN_PROMPT_CACHE2 2 resume-anywhere HALOGEN_CACHE_DIR/cache未設 快取落盤,重啟後續聊 HALOGEN_CACHE_BRANCHES3 2 父會話分叉出子代理時保住 resume point HALOGEN_CACHE_PRUNE_OLD1 0 升級時清掉舊 build 殘留子樹 HALOGEN_VISION_TOWER1 未設 開視覺 核心邏輯一句話:
MAX_TOK與KV_POOL_POSITIONS都往小調,把 RAM 讓給那張 47.7 GiB 的 n-gram 查找表(它不常駐,全靠 page cache)。checkpoint
用 v2(
qwen38-flash-next-v2.hgn62.11 GiB + 獨立ngram.hgn47.68 GiB),不是舊的 w4b。常駐從 87.0 → 78.3 GiB(多出 8.7 GiB 給頁快取),同題 ppl 好 1.9%。容器啟動參數
podman run --rm --name halogen-flash -p 8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host --ulimit memlock=-1:-1 \
  -v <models>:/models:ro -v <cache>:/cache \
  -e HALOGEN_KV_POOL_POSITIONS=262144 -e HALOGEN_PROMPT_CACHE=2 \
  -e HALOGEN_HOST_RESERVE_GIB=24 -e HALOGEN_VISION_TOWER=1 \
  -e HALOGEN_COMPOSABLE_CONTEXT=0 -e HALOGEN_CACHE_DIR=/cache \
  -e HALOGEN_REASONING_EFFORT=low -e HALOGEN_MAX_TOK=16384 \
  -e HALOGEN_PREFILL_CHUNK=16384 -e HALOGEN_CACHE_PRUNE_OLD=1 \
  -e HALOGEN_CACHE_BRANCHES=3 \
  ghcr.io/peonist-ai/halogen-flash-server:0.16.0
啟動後記憶體實測行:
memory: 62.9 GiB of weights locked in RAM (0.8 of them the vision tower's),
        7.2 GiB of KV pool, 8.1 GiB of working memory, 78.3 GiB in all
單路完整數據(0.16.0 + v2,temp 0、effort low)
prefill 隨深度
深度 / 規模 prefill 速度 4K 1960 tok/s 32K 2080 tok/s 64K 2042 tok/s 128K 1991 tok/s 192K 1850 tok/s 244K 1848 tok/s 256K 1824 tok/s 260K 1836 tok/s 4K → 260K 只掉 6%,沒有「越長越慢」。
decode(與深度無關)
口徑 decode 512 token 樣本 @32K(樣本最大) 44.1 tok/s niah 檢索(每次只生成 32 token) 36.4 – 37.9 tok/s 長上下文 API(每次 187–200 token) 28 – 53 tok/s decode 速度不隨上下文深度變化 —— 48/64 層沒有 KV cache。
它主要由投機解碼命中率(生成內容的可預測性)與樣本長度決定:
同一種任務在 192K / 244K / 256K 上分別測到 52.2 / 28.1 / 53.1 tok/s,
散布這麼大是短樣本的起停開銷造成的,不是「越長越快」。檢索完整性(引擎
niah,深度 × 位置)深度 p05 p50 p95 合計 4,096 3/3 3/3 3/3 9/9(100%) 32,768 3/3 3/3 3/3 9/9(100%) 65,536 3/3 3/3 3/3 9/9(100%) 131,072 3/3 2/3 3/3 8/9(88.9%) 總計 35/36(97.2%) prompt cache
口徑 冷 暖 128K 前綴第二輪 58.5 s 0.0 s( prompt_n=0,端到端 2.9 s)259K 前綴命中 — 端到端 3.7 s 上限
prompt + max_tokens ≤ 262,144,用同一條 259,474 token 的提示詞卡過邊界:max_tokens合計 結果 2,670 262,144 2002,671 262,145 400(leaving room for 2670) -
-
-
@dardeaw-feng 先回答:全部是單路(一次一個請求、串行跑)。2080 / 1850 那些數字都是單請求測出來的。
看到你問,我順手補測了 4 路併發(服務
KV_SLOTS=4,4 路同時打 8K 提示詞、max_tokens=256、temp 0):口徑 單路 4 路併發(每路) 聚合 prefill 4.37 s(1830 tok/s) 4.26 / 4.35 / 4.40 s(1877 / 1840 / 1823 tok/s) prefill 不掉 decode 43.2 tok/s 4.4 / 4.9 / 21.4 / 9.3 tok/s 4 路之和 ≈ 40 tok/s 4 路裡有 1 路是同一條提示詞、命中了剛才單路測試留下的前綴快取(
prompt_n=0),所以 prefill 只列另外 3 路;decode 四路都是真實數據。兩個結論:
- prefill 併發幾乎不掉(每路仍 ~1830–1877 tok/s);
- decode 會塌:單路 43.2 → 每路 4–21 tok/s,四路加起來 ≈ 40 tok/s,跟單路同級。
原因寫在引擎自己的啟動日誌裡:
flash_serve: listening on 127.0.0.1:8730, 4 slots over ONE 262144-position KV pool ...
             MTP depth-2 selectable (drafter 1, speculates while alone)
speculates while alone—— 投機解碼只在「獨占」時開,有人同時生成就退回串行。所以多路併發的意義是「多個會話都要有回應」,不是提高總吞吐。
特別調了什麼
硬體 / 內核層
- BIOS 的 UMA frame buffer 調回最小(只 carve 1 GiB),系統可見 124.4 GiB;
- 內核參數(
GRUB_CMDLINE_LINUX_DEFAULT):
amdgpu.gttsize=126976 ttm.pages_limit=32505856 ttm.page_pool_size=32505856 amd_iommu=off開機後
mem_info_gtt_total出 124.0 GiB。(amd_iommu=off是早期做過 A/B 後留下來的設定,這一輪沒有重測。)- 功耗:PBO 開啟,滿載穩定 ~153 W(跑滿 AMD 的 PPT slow 上限);CPU governor 是
powersave。
引擎層(
HALOGEN_*,跟預設不同的就這幾個)參數 我設 官方預設 為什麼 HALOGEN_MAX_TOK16384 32768 prefill arena 減半。0.16.0 上兩者速度在噪聲內(@32K:2001 vs 1957),但 working memory 從 12.5 → 8.1 GiB HALOGEN_KV_POOL_POSITIONS262144 2×CTX = 524288 同理,省下 7.2 GiB 給頁快取 HALOGEN_HOST_RESERVE_GIB24 20 同上,留更多給頁快取 HALOGEN_COMPOSABLE_CONTEXT0 0 實測開著在 8K 提示詞上慢 16.7% HALOGEN_REASONING_EFFORTlow 模板 xhigh 預設在 agent 長鏈上思考過久(慢約 3 倍) HALOGEN_PROMPT_CACHE2 2 resume-anywhere HALOGEN_CACHE_DIR/cache未設 快取落盤,重啟後續聊 HALOGEN_CACHE_BRANCHES3 2 父會話分叉出子代理時保住 resume point HALOGEN_CACHE_PRUNE_OLD1 0 升級時清掉舊 build 殘留子樹 HALOGEN_VISION_TOWER1 未設 開視覺 核心邏輯一句話:
MAX_TOK與KV_POOL_POSITIONS都往小調,把 RAM 讓給那張 47.7 GiB 的 n-gram 查找表(它不常駐,全靠 page cache)。checkpoint
用 v2(
qwen38-flash-next-v2.hgn62.11 GiB + 獨立ngram.hgn47.68 GiB),不是舊的 w4b。常駐從 87.0 → 78.3 GiB(多出 8.7 GiB 給頁快取),同題 ppl 好 1.9%。容器啟動參數
podman run --rm --name halogen-flash -p 8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host --ulimit memlock=-1:-1 \
  -v <models>:/models:ro -v <cache>:/cache \
  -e HALOGEN_KV_POOL_POSITIONS=262144 -e HALOGEN_PROMPT_CACHE=2 \
  -e HALOGEN_HOST_RESERVE_GIB=24 -e HALOGEN_VISION_TOWER=1 \
  -e HALOGEN_COMPOSABLE_CONTEXT=0 -e HALOGEN_CACHE_DIR=/cache \
  -e HALOGEN_REASONING_EFFORT=low -e HALOGEN_MAX_TOK=16384 \
  -e HALOGEN_PREFILL_CHUNK=16384 -e HALOGEN_CACHE_PRUNE_OLD=1 \
  -e HALOGEN_CACHE_BRANCHES=3 \
  ghcr.io/peonist-ai/halogen-flash-server:0.16.0
啟動後記憶體實測行:
memory: 62.9 GiB of weights locked in RAM (0.8 of them the vision tower's),
        7.2 GiB of KV pool, 8.1 GiB of working memory, 78.3 GiB in all
單路完整數據(0.16.0 + v2,temp 0、effort low)
prefill 隨深度
深度 / 規模 prefill 速度 4K 1960 tok/s 32K 2080 tok/s 64K 2042 tok/s 128K 1991 tok/s 192K 1850 tok/s 244K 1848 tok/s 256K 1824 tok/s 260K 1836 tok/s 4K → 260K 只掉 6%,沒有「越長越慢」。
decode(與深度無關)
口徑 decode 512 token 樣本 @32K(樣本最大) 44.1 tok/s niah 檢索(每次只生成 32 token) 36.4 – 37.9 tok/s 長上下文 API(每次 187–200 token) 28 – 53 tok/s decode 速度不隨上下文深度變化 —— 48/64 層沒有 KV cache。
它主要由投機解碼命中率(生成內容的可預測性)與樣本長度決定:
同一種任務在 192K / 244K / 256K 上分別測到 52.2 / 28.1 / 53.1 tok/s,
散布這麼大是短樣本的起停開銷造成的,不是「越長越快」。檢索完整性(引擎
niah,深度 × 位置)深度 p05 p50 p95 合計 4,096 3/3 3/3 3/3 9/9(100%) 32,768 3/3 3/3 3/3 9/9(100%) 65,536 3/3 3/3 3/3 9/9(100%) 131,072 3/3 2/3 3/3 8/9(88.9%) 總計 35/36(97.2%) prompt cache
口徑 冷 暖 128K 前綴第二輪 58.5 s 0.0 s( prompt_n=0,端到端 2.9 s)259K 前綴命中 — 端到端 3.7 s 上限
prompt + max_tokens ≤ 262,144,用同一條 259,474 token 的提示詞卡過邊界:max_tokens合計 結果 2,670 262,144 2002,671 262,145 400(leaving room for 2670)@dardeaw-feng 先回答:全部是單路(一次一個請求、串行跑)。2080 / 1850 那些數字都是單請求測出來的。
看到你問,我順手補測了 4 路併發(服務
KV_SLOTS=4,4 路同時打 8K 提示詞、max_tokens=256、temp 0):口徑 單路 4 路併發(每路) 聚合 prefill 4.37 s(1830 tok/s) 4.26 / 4.35 / 4.40 s(1877 / 1840 / 1823 tok/s) prefill 不掉 decode 43.2 tok/s 4.4 / 4.9 / 21.4 / 9.3 tok/s 4 路之和 ≈ 40 tok/s 4 路裡有 1 路是同一條提示詞、命中了剛才單路測試留下的前綴快取(
prompt_n=0),所以 prefill 只列另外 3 路;decode 四路都是真實數據。兩個結論:
- prefill 併發幾乎不掉(每路仍 ~1830–1877 tok/s);
- decode 會塌:單路 43.2 → 每路 4–21 tok/s,四路加起來 ≈ 40 tok/s,跟單路同級。
原因寫在引擎自己的啟動日誌裡:
flash_serve: listening on 127.0.0.1:8730, 4 slots over ONE 262144-position KV pool ...
             MTP depth-2 selectable (drafter 1, speculates while alone)
speculates while alone—— 投機解碼只在「獨占」時開,有人同時生成就退回串行。所以多路併發的意義是「多個會話都要有回應」,不是提高總吞吐。
特別調了什麼
硬體 / 內核層
- BIOS 的 UMA frame buffer 調回最小(只 carve 1 GiB),系統可見 124.4 GiB;
- 內核參數(
GRUB_CMDLINE_LINUX_DEFAULT):
amdgpu.gttsize=126976 ttm.pages_limit=32505856 ttm.page_pool_size=32505856 amd_iommu=off開機後
mem_info_gtt_total出 124.0 GiB。(amd_iommu=off是早期做過 A/B 後留下來的設定,這一輪沒有重測。)- 功耗:PBO 開啟,滿載穩定 ~153 W(跑滿 AMD 的 PPT slow 上限);CPU governor 是
powersave。
引擎層(
HALOGEN_*,跟預設不同的就這幾個)參數 我設 官方預設 為什麼 HALOGEN_MAX_TOK16384 32768 prefill arena 減半。0.16.0 上兩者速度在噪聲內(@32K:2001 vs 1957),但 working memory 從 12.5 → 8.1 GiB HALOGEN_KV_POOL_POSITIONS262144 2×CTX = 524288 同理,省下 7.2 GiB 給頁快取 HALOGEN_HOST_RESERVE_GIB24 20 同上,留更多給頁快取 HALOGEN_COMPOSABLE_CONTEXT0 0 實測開著在 8K 提示詞上慢 16.7% HALOGEN_REASONING_EFFORTlow 模板 xhigh 預設在 agent 長鏈上思考過久(慢約 3 倍) HALOGEN_PROMPT_CACHE2 2 resume-anywhere HALOGEN_CACHE_DIR/cache未設 快取落盤,重啟後續聊 HALOGEN_CACHE_BRANCHES3 2 父會話分叉出子代理時保住 resume point HALOGEN_CACHE_PRUNE_OLD1 0 升級時清掉舊 build 殘留子樹 HALOGEN_VISION_TOWER1 未設 開視覺 核心邏輯一句話:
MAX_TOK與KV_POOL_POSITIONS都往小調,把 RAM 讓給那張 47.7 GiB 的 n-gram 查找表(它不常駐,全靠 page cache)。checkpoint
用 v2(
qwen38-flash-next-v2.hgn62.11 GiB + 獨立ngram.hgn47.68 GiB),不是舊的 w4b。常駐從 87.0 → 78.3 GiB(多出 8.7 GiB 給頁快取),同題 ppl 好 1.9%。容器啟動參數
podman run --rm --name halogen-flash -p 8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host --ulimit memlock=-1:-1 \
  -v <models>:/models:ro -v <cache>:/cache \
  -e HALOGEN_KV_POOL_POSITIONS=262144 -e HALOGEN_PROMPT_CACHE=2 \
  -e HALOGEN_HOST_RESERVE_GIB=24 -e HALOGEN_VISION_TOWER=1 \
  -e HALOGEN_COMPOSABLE_CONTEXT=0 -e HALOGEN_CACHE_DIR=/cache \
  -e HALOGEN_REASONING_EFFORT=low -e HALOGEN_MAX_TOK=16384 \
  -e HALOGEN_PREFILL_CHUNK=16384 -e HALOGEN_CACHE_PRUNE_OLD=1 \
  -e HALOGEN_CACHE_BRANCHES=3 \
  ghcr.io/peonist-ai/halogen-flash-server:0.16.0
啟動後記憶體實測行:
memory: 62.9 GiB of weights locked in RAM (0.8 of them the vision tower's),
        7.2 GiB of KV pool, 8.1 GiB of working memory, 78.3 GiB in all
單路完整數據(0.16.0 + v2,temp 0、effort low)
prefill 隨深度
深度 / 規模 prefill 速度 4K 1960 tok/s 32K 2080 tok/s 64K 2042 tok/s 128K 1991 tok/s 192K 1850 tok/s 244K 1848 tok/s 256K 1824 tok/s 260K 1836 tok/s 4K → 260K 只掉 6%,沒有「越長越慢」。
decode(與深度無關)
口徑 decode 512 token 樣本 @32K(樣本最大) 44.1 tok/s niah 檢索(每次只生成 32 token) 36.4 – 37.9 tok/s 長上下文 API(每次 187–200 token) 28 – 53 tok/s decode 速度不隨上下文深度變化 —— 48/64 層沒有 KV cache。
它主要由投機解碼命中率(生成內容的可預測性)與樣本長度決定:
同一種任務在 192K / 244K / 256K 上分別測到 52.2 / 28.1 / 53.1 tok/s,
散布這麼大是短樣本的起停開銷造成的,不是「越長越快」。檢索完整性(引擎
niah,深度 × 位置)深度 p05 p50 p95 合計 4,096 3/3 3/3 3/3 9/9(100%) 32,768 3/3 3/3 3/3 9/9(100%) 65,536 3/3 3/3 3/3 9/9(100%) 131,072 3/3 2/3 3/3 8/9(88.9%) 總計 35/36(97.2%) prompt cache
口徑 冷 暖 128K 前綴第二輪 58.5 s 0.0 s( prompt_n=0,端到端 2.9 s)259K 前綴命中 — 端到端 3.7 s 上限
prompt + max_tokens ≤ 262,144,用同一條 259,474 token 的提示詞卡過邊界:max_tokens合計 結果 2,670 262,144 2002,671 262,145 400(leaving room for 2670)非常感謝分享調校細節,看來關鍵不是功耗、你開PBO影響應該不大、因為我也設了CO -20,是halogen的參數,你這多路prefill數字非常的暴力
-
@dardeaw-feng 先回答:全部是單路(一次一個請求、串行跑)。2080 / 1850 那些數字都是單請求測出來的。
看到你問,我順手補測了 4 路併發(服務
KV_SLOTS=4,4 路同時打 8K 提示詞、max_tokens=256、temp 0):口徑 單路 4 路併發(每路) 聚合 prefill 4.37 s(1830 tok/s) 4.26 / 4.35 / 4.40 s(1877 / 1840 / 1823 tok/s) prefill 不掉 decode 43.2 tok/s 4.4 / 4.9 / 21.4 / 9.3 tok/s 4 路之和 ≈ 40 tok/s 4 路裡有 1 路是同一條提示詞、命中了剛才單路測試留下的前綴快取(
prompt_n=0),所以 prefill 只列另外 3 路;decode 四路都是真實數據。兩個結論:
- prefill 併發幾乎不掉(每路仍 ~1830–1877 tok/s);
- decode 會塌:單路 43.2 → 每路 4–21 tok/s,四路加起來 ≈ 40 tok/s,跟單路同級。
原因寫在引擎自己的啟動日誌裡:
flash_serve: listening on 127.0.0.1:8730, 4 slots over ONE 262144-position KV pool ...
             MTP depth-2 selectable (drafter 1, speculates while alone)
speculates while alone—— 投機解碼只在「獨占」時開,有人同時生成就退回串行。所以多路併發的意義是「多個會話都要有回應」,不是提高總吞吐。
特別調了什麼
硬體 / 內核層
- BIOS 的 UMA frame buffer 調回最小(只 carve 1 GiB),系統可見 124.4 GiB;
- 內核參數(
GRUB_CMDLINE_LINUX_DEFAULT):
amdgpu.gttsize=126976 ttm.pages_limit=32505856 ttm.page_pool_size=32505856 amd_iommu=off開機後
mem_info_gtt_total出 124.0 GiB。(amd_iommu=off是早期做過 A/B 後留下來的設定,這一輪沒有重測。)- 功耗:PBO 開啟,滿載穩定 ~153 W(跑滿 AMD 的 PPT slow 上限);CPU governor 是
powersave。
引擎層(
HALOGEN_*,跟預設不同的就這幾個)參數 我設 官方預設 為什麼 HALOGEN_MAX_TOK16384 32768 prefill arena 減半。0.16.0 上兩者速度在噪聲內(@32K:2001 vs 1957),但 working memory 從 12.5 → 8.1 GiB HALOGEN_KV_POOL_POSITIONS262144 2×CTX = 524288 同理,省下 7.2 GiB 給頁快取 HALOGEN_HOST_RESERVE_GIB24 20 同上,留更多給頁快取 HALOGEN_COMPOSABLE_CONTEXT0 0 實測開著在 8K 提示詞上慢 16.7% HALOGEN_REASONING_EFFORTlow 模板 xhigh 預設在 agent 長鏈上思考過久(慢約 3 倍) HALOGEN_PROMPT_CACHE2 2 resume-anywhere HALOGEN_CACHE_DIR/cache未設 快取落盤,重啟後續聊 HALOGEN_CACHE_BRANCHES3 2 父會話分叉出子代理時保住 resume point HALOGEN_CACHE_PRUNE_OLD1 0 升級時清掉舊 build 殘留子樹 HALOGEN_VISION_TOWER1 未設 開視覺 核心邏輯一句話:
MAX_TOK與KV_POOL_POSITIONS都往小調,把 RAM 讓給那張 47.7 GiB 的 n-gram 查找表(它不常駐,全靠 page cache)。checkpoint
用 v2(
qwen38-flash-next-v2.hgn62.11 GiB + 獨立ngram.hgn47.68 GiB),不是舊的 w4b。常駐從 87.0 → 78.3 GiB(多出 8.7 GiB 給頁快取),同題 ppl 好 1.9%。容器啟動參數
podman run --rm --name halogen-flash -p 8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host --ulimit memlock=-1:-1 \
  -v <models>:/models:ro -v <cache>:/cache \
  -e HALOGEN_KV_POOL_POSITIONS=262144 -e HALOGEN_PROMPT_CACHE=2 \
  -e HALOGEN_HOST_RESERVE_GIB=24 -e HALOGEN_VISION_TOWER=1 \
  -e HALOGEN_COMPOSABLE_CONTEXT=0 -e HALOGEN_CACHE_DIR=/cache \
  -e HALOGEN_REASONING_EFFORT=low -e HALOGEN_MAX_TOK=16384 \
  -e HALOGEN_PREFILL_CHUNK=16384 -e HALOGEN_CACHE_PRUNE_OLD=1 \
  -e HALOGEN_CACHE_BRANCHES=3 \
  ghcr.io/peonist-ai/halogen-flash-server:0.16.0
啟動後記憶體實測行:
memory: 62.9 GiB of weights locked in RAM (0.8 of them the vision tower's),
        7.2 GiB of KV pool, 8.1 GiB of working memory, 78.3 GiB in all
單路完整數據(0.16.0 + v2,temp 0、effort low)
prefill 隨深度
深度 / 規模 prefill 速度 4K 1960 tok/s 32K 2080 tok/s 64K 2042 tok/s 128K 1991 tok/s 192K 1850 tok/s 244K 1848 tok/s 256K 1824 tok/s 260K 1836 tok/s 4K → 260K 只掉 6%,沒有「越長越慢」。
decode(與深度無關)
口徑 decode 512 token 樣本 @32K(樣本最大) 44.1 tok/s niah 檢索(每次只生成 32 token) 36.4 – 37.9 tok/s 長上下文 API(每次 187–200 token) 28 – 53 tok/s decode 速度不隨上下文深度變化 —— 48/64 層沒有 KV cache。
它主要由投機解碼命中率(生成內容的可預測性)與樣本長度決定:
同一種任務在 192K / 244K / 256K 上分別測到 52.2 / 28.1 / 53.1 tok/s,
散布這麼大是短樣本的起停開銷造成的,不是「越長越快」。檢索完整性(引擎
niah,深度 × 位置)深度 p05 p50 p95 合計 4,096 3/3 3/3 3/3 9/9(100%) 32,768 3/3 3/3 3/3 9/9(100%) 65,536 3/3 3/3 3/3 9/9(100%) 131,072 3/3 2/3 3/3 8/9(88.9%) 總計 35/36(97.2%) prompt cache
口徑 冷 暖 128K 前綴第二輪 58.5 s 0.0 s( prompt_n=0,端到端 2.9 s)259K 前綴命中 — 端到端 3.7 s 上限
prompt + max_tokens ≤ 262,144,用同一條 259,474 token 的提示詞卡過邊界:max_tokens合計 結果 2,670 262,144 2002,671 262,145 400(leaving room for 2670)非常感謝分享調校細節,看來關鍵不是功耗、你開PBO影響應該不大、因為我也設了CO -20,是halogen的參數,你這多路prefill數字非常的暴力
-
@dardeaw-feng 我跑满153w没有任何掉功耗,用的一套液冷,性能释放很充分
更新了0.16.2,解码速度又有了一点提升。
我现在挺满意这台机器,放家里做个服务器用,不占地方也不吵,功耗比较低。
其他机器我基本上就是各种折腾,这台基本是稳定使用@dardeaw-feng 我跑满153w没有任何掉功耗,用的一套液冷,性能释放很充分
更新了0.16.2,解码速度又有了一点提升。
我现在挺满意这台机器,放家里做个服务器用,不占地方也不吵,功耗比较低。
其他机器我基本上就是各种折腾,这台基本是稳定使用哇 迷你機用上液冷 能分享照片出來嗎
我之前把TDP上調到160W那噪音我受不了
還能上液冷可真是新鮮 -
@dardeaw-feng 我跑满153w没有任何掉功耗,用的一套液冷,性能释放很充分
更新了0.16.2,解码速度又有了一点提升。
我现在挺满意这台机器,放家里做个服务器用,不占地方也不吵,功耗比较低。
其他机器我基本上就是各种折腾,这台基本是稳定使用哇 迷你機用上液冷 能分享照片出來嗎
我之前把TDP上調到160W那噪音我受不了
還能上液冷可真是新鮮@dardeaw-feng 我就不发图了,怕被判定成广告
 。可以去搜搜液冷的395,要140液冷的那个,还有双8cm的就不太强了。
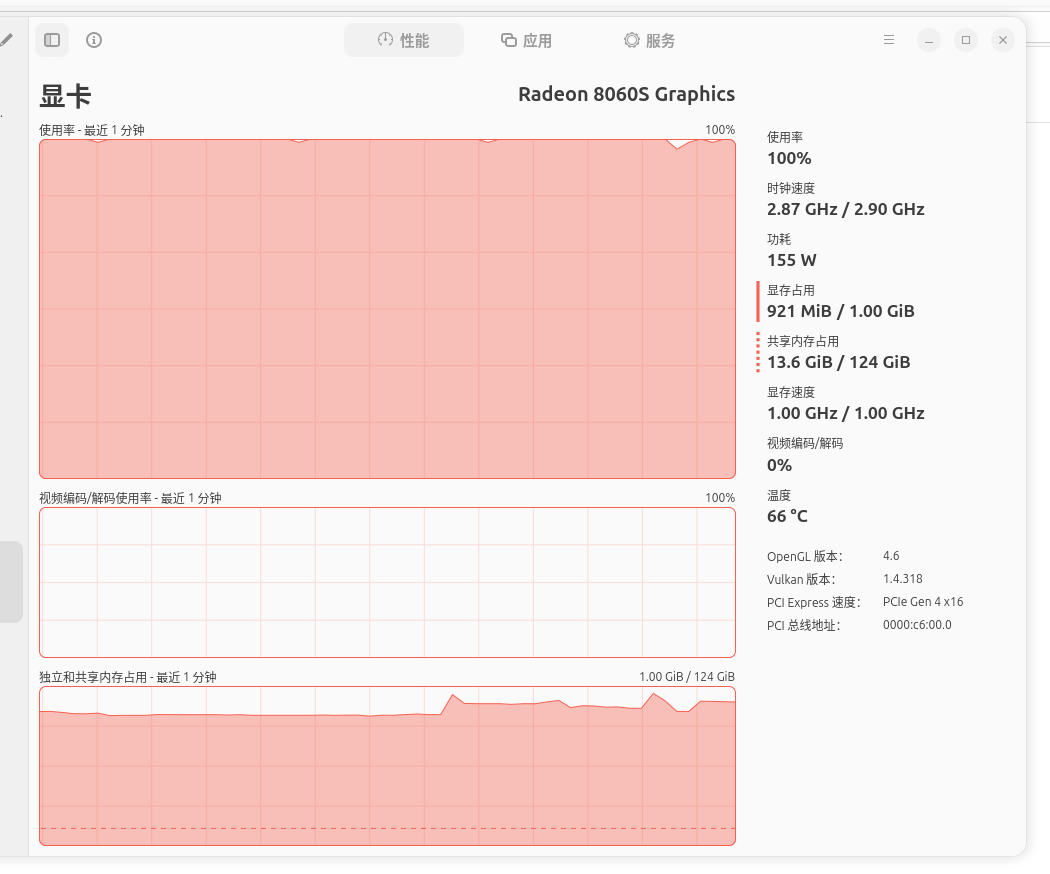
你设置160,但是要看功率是否往下掉,到目前为止风冷的395好像没有能顶住长时间120w的。
395这东西的TDP AMD已经限制死了。我没记错的话,60s的173w fast ppt,然后600s的154w slow ppt。跑模型只要散热够153w是可以常驻的,如果温度压不住,撞了温度墙就开始掉频率(不断降功耗)。
液冷的优势就太大了,单140mm风扇,风扇转速12xx声音基本听不到,温度也就不到70度,跑满slow ppt不要太轻松。双8cm的冷排散热面积小风扇转速高,就会差不少。
-
@dardeaw-feng 我就不发图了,怕被判定成广告
。可以去搜搜液冷的395,要140液冷的那个,还有双8cm的就不太强了。你设置160,但是要看功率是否往下掉,到目前为止风冷的395好像没有能顶住长时间120w的。
395这东西的TDP AMD已经限制死了。我没记错的话,60s的173w fast ppt,然后600s的154w slow ppt。跑模型只要散热够153w是可以常驻的,如果温度压不住,撞了温度墙就开始掉频率(不断降功耗)。
液冷的优势就太大了,单140mm风扇,风扇转速12xx声音基本听不到,温度也就不到70度,跑满slow ppt不要太轻松。双8cm的冷排散热面积小风扇转速高,就会差不少。
-
-
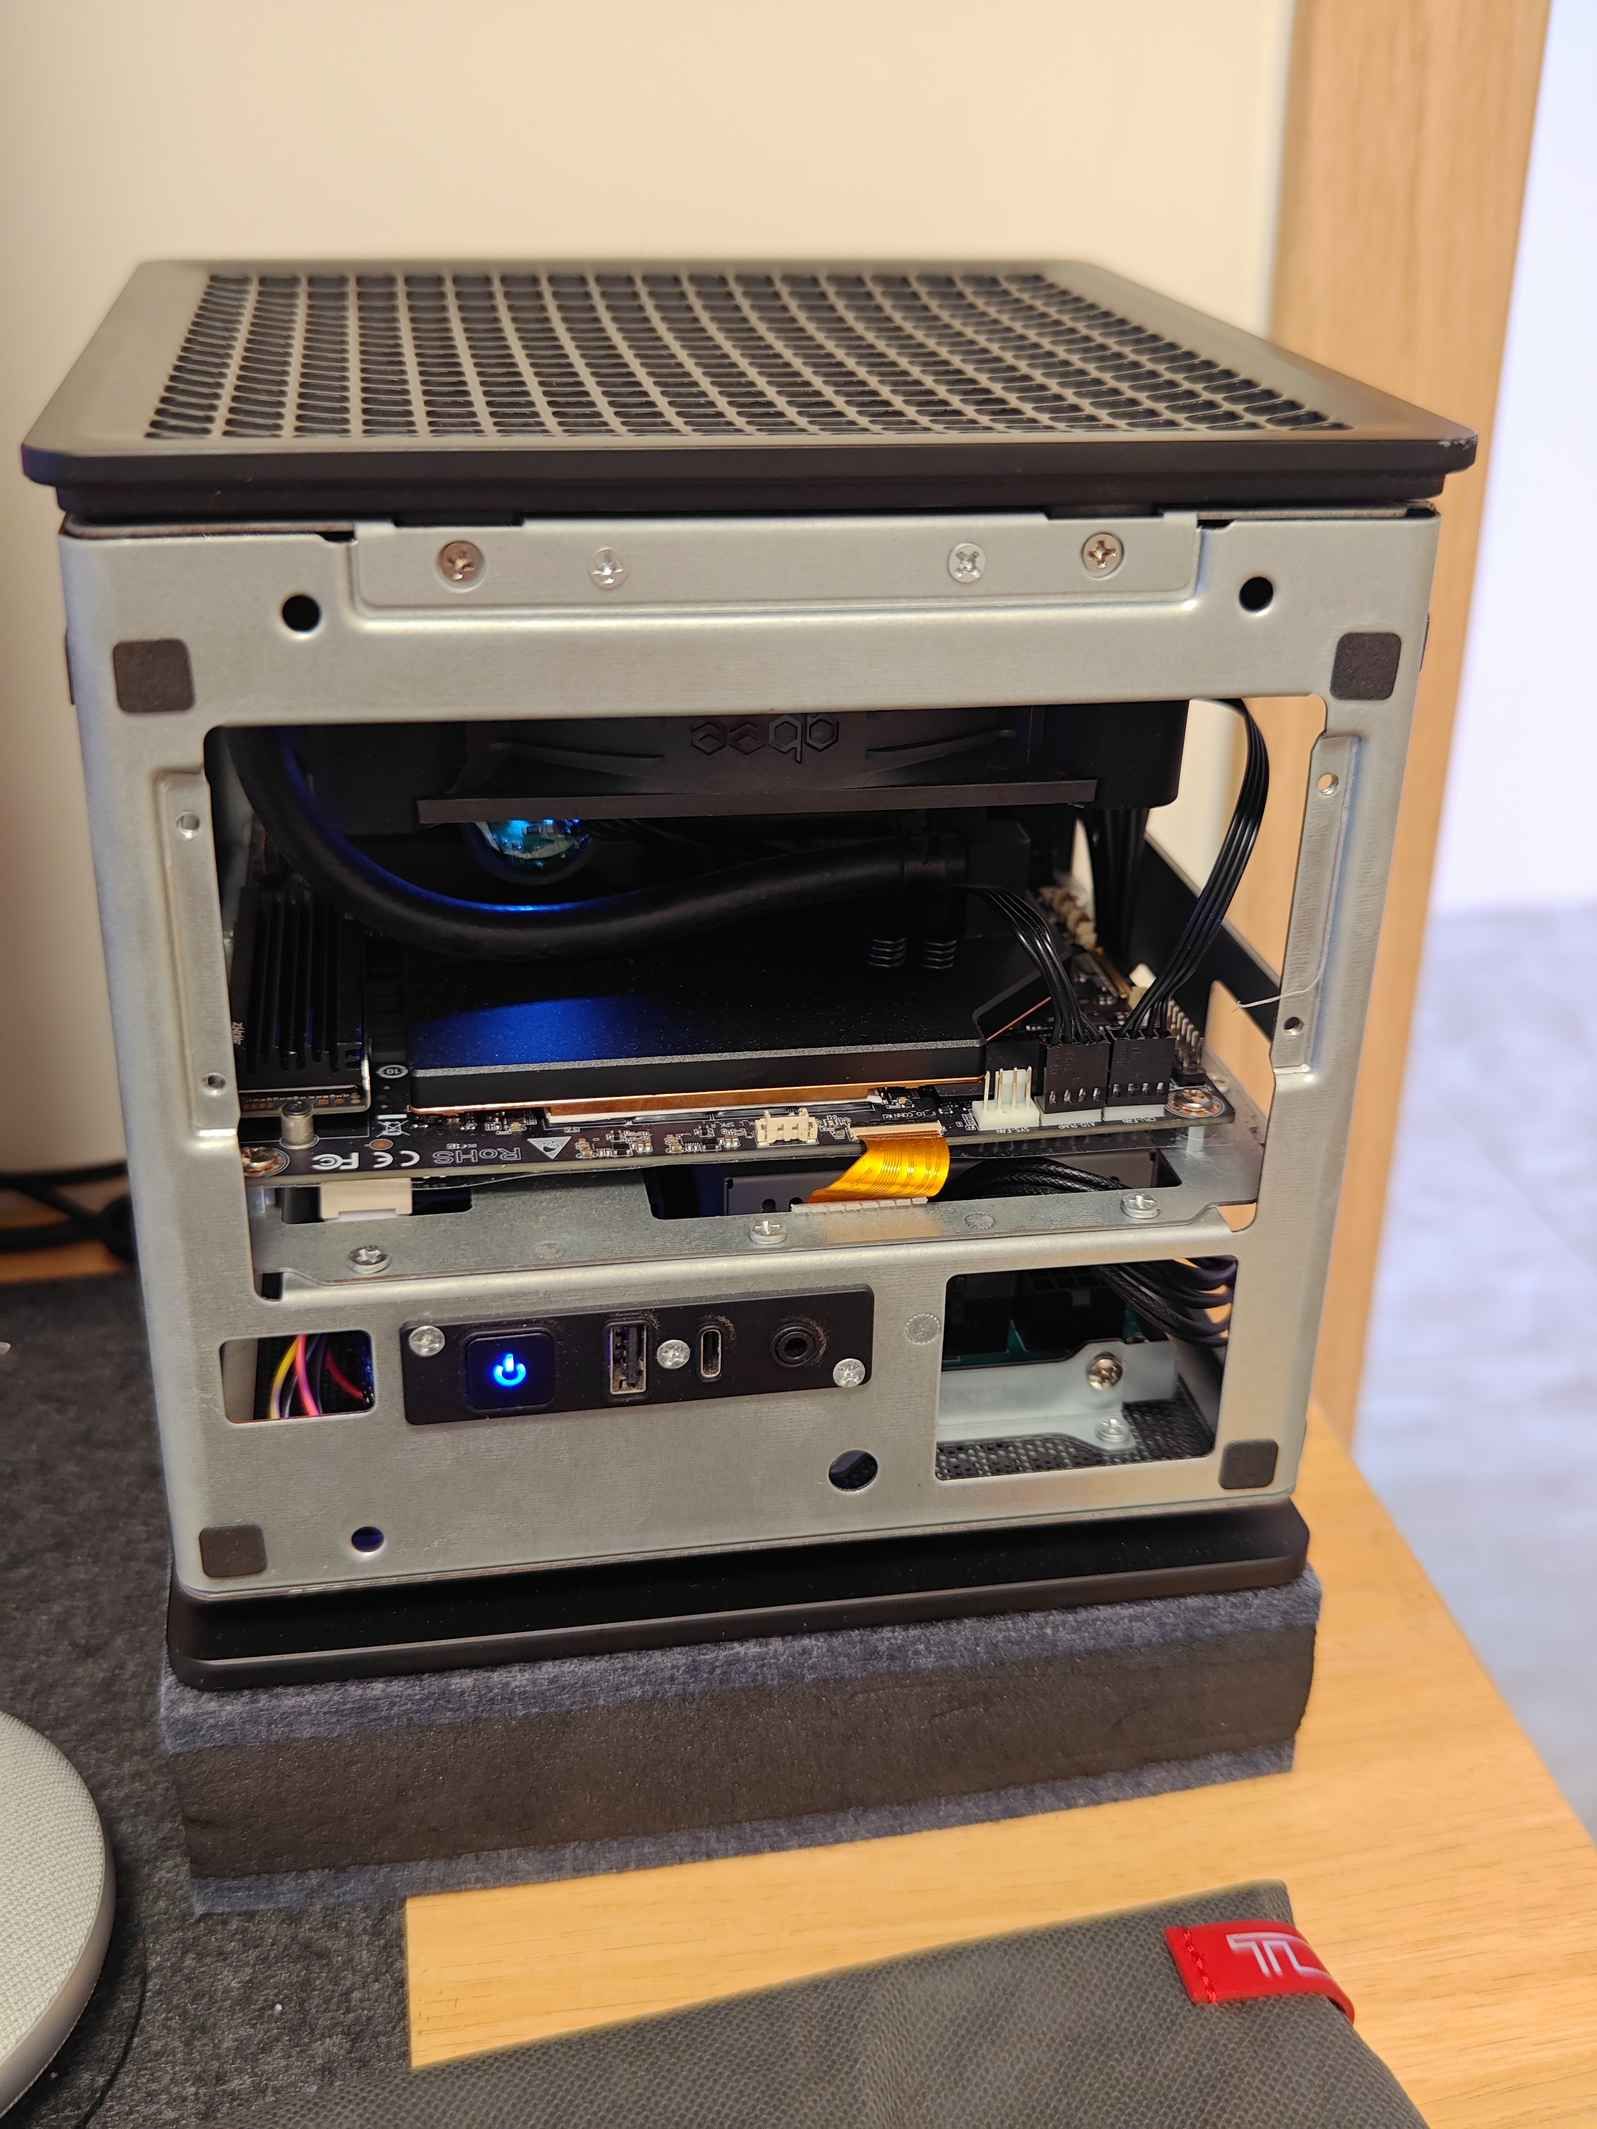
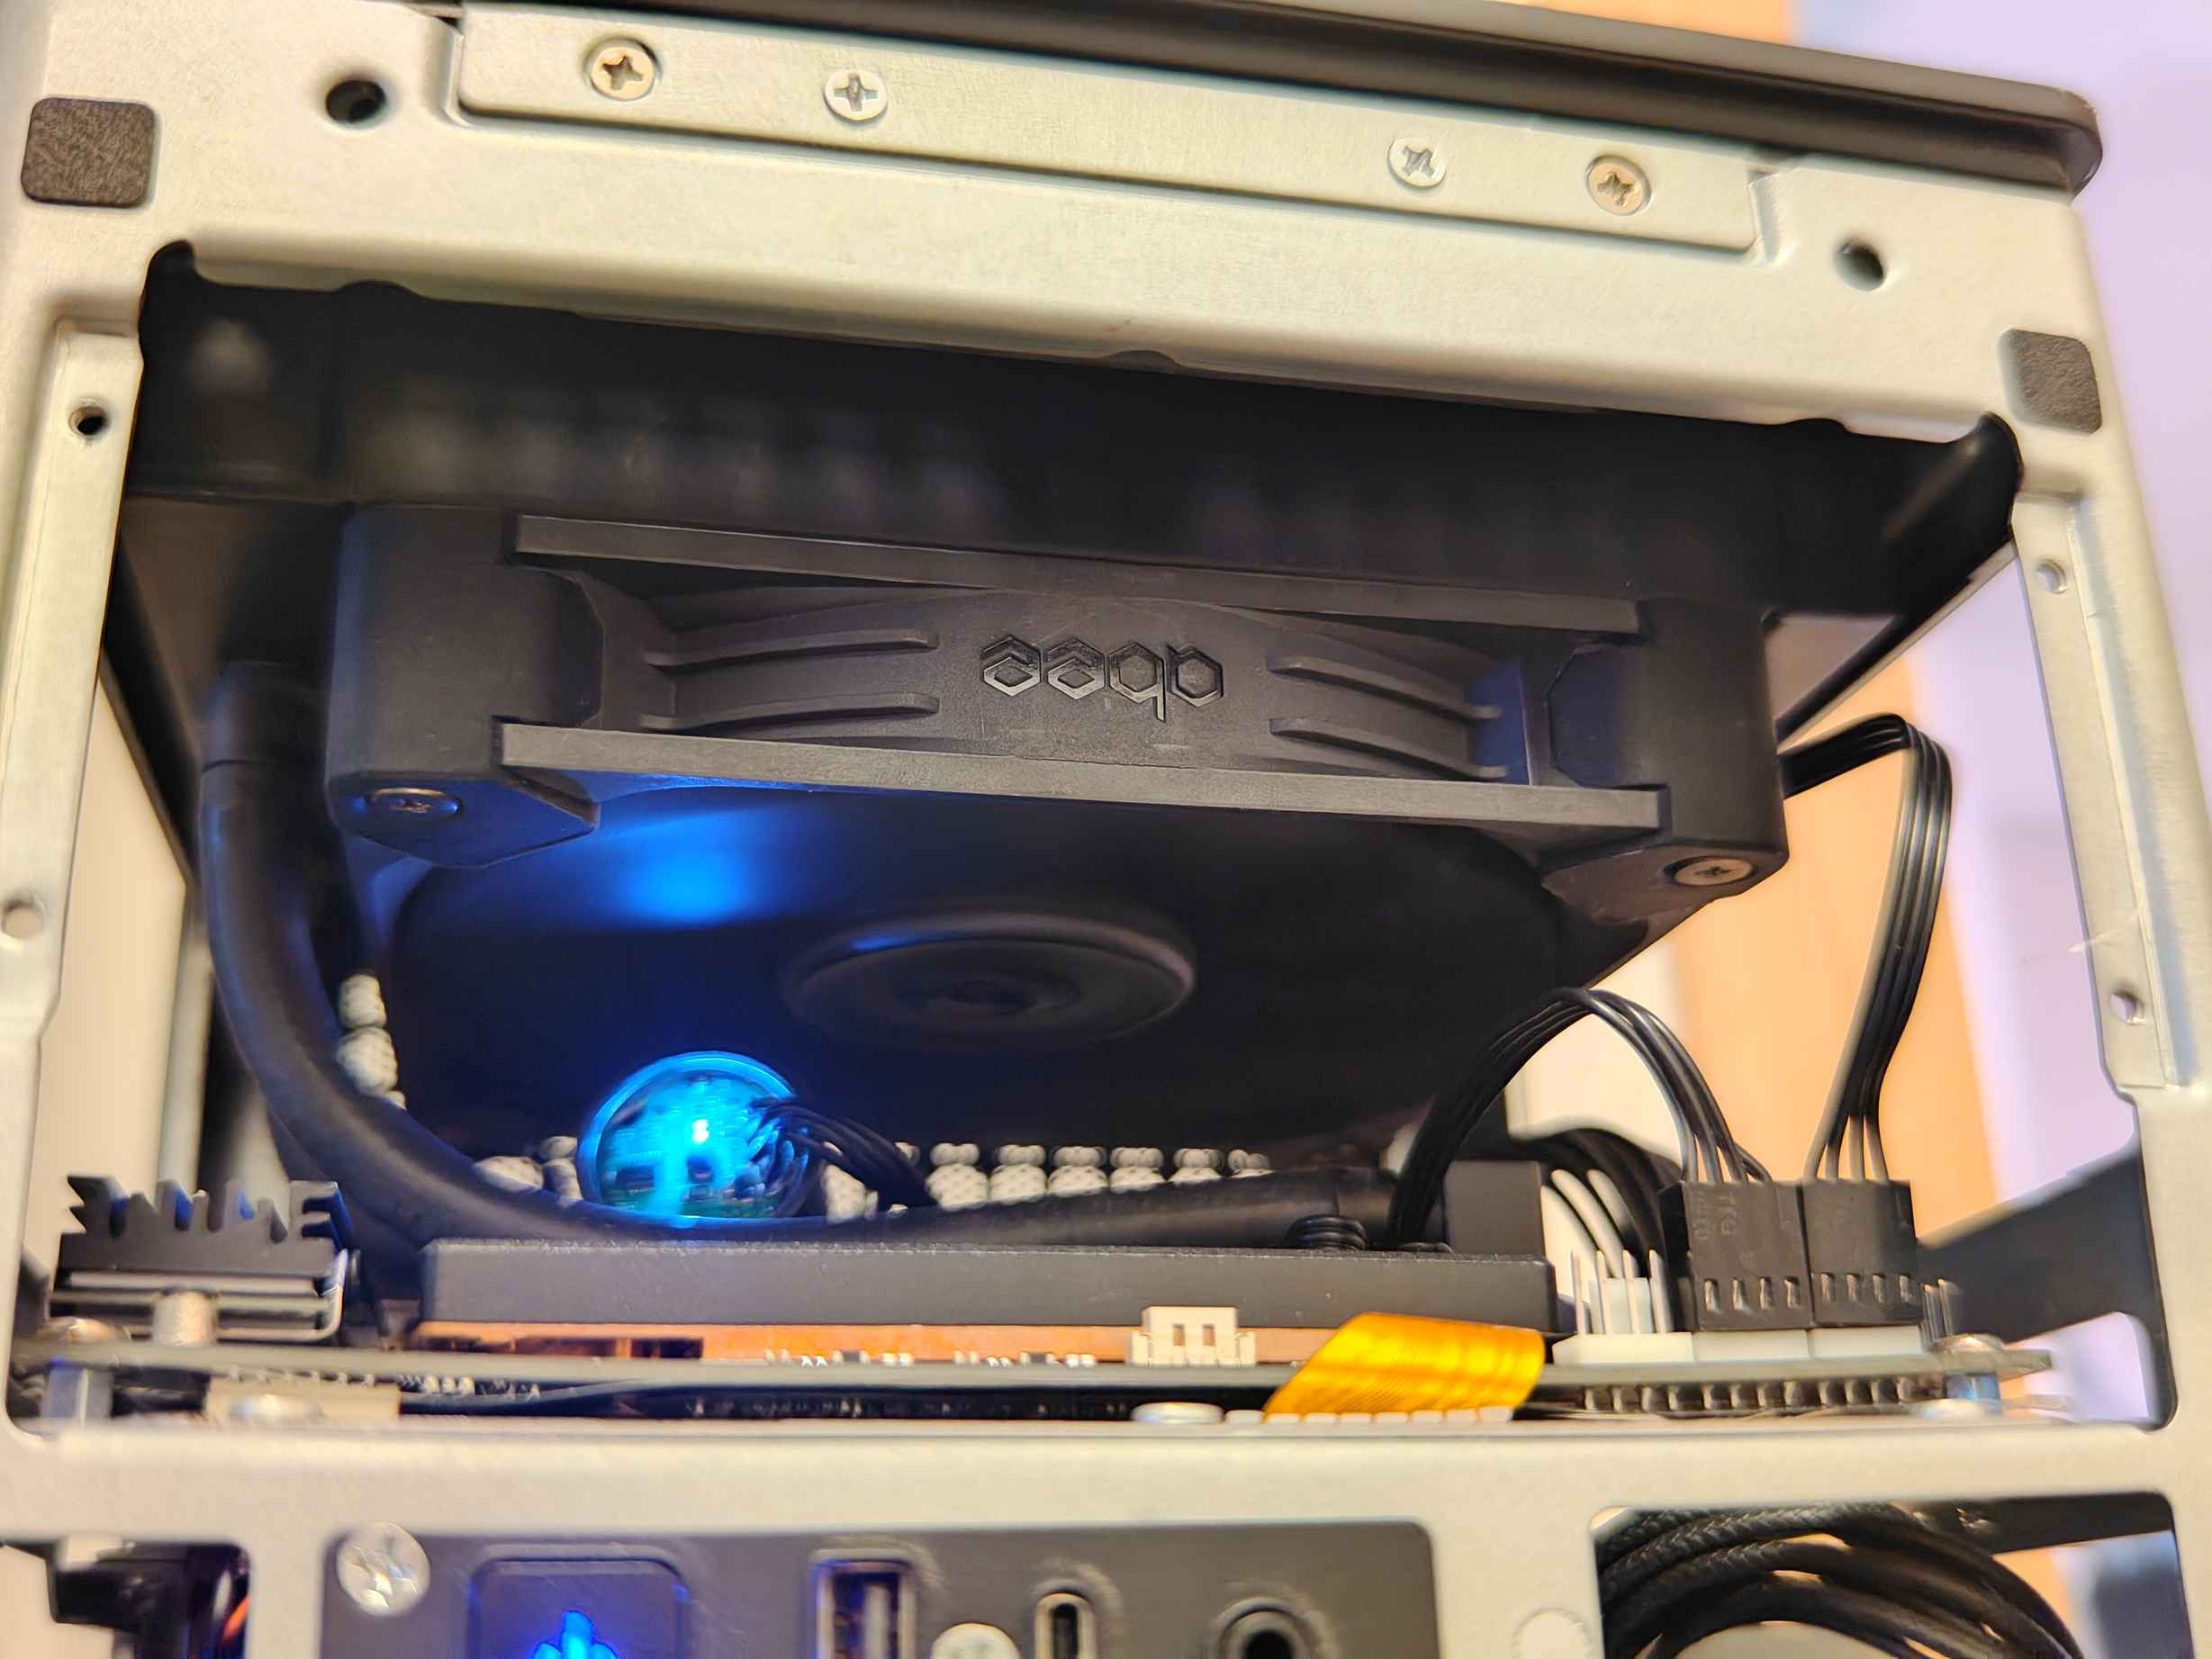
@terry 哈哈,主要是我现在人在外地。刚从手机翻出来两张以前拍的。
液冷冷板几乎覆盖了PCB,一把140mm风扇把冷排的热风从顶部排出。满载时转速也不高,哪怕在深更半夜,一两米外就听不到了。
我入手比较早,当时 18k,到现在来看性价比相当高。当然从综合的使用感受上来看,哪怕是现在价格涨了不少,我觉得也可以考虑,放家里跑着基本上是无感的,能效比还高。除了本地的机器,我办公室的pc和笔电也通过Tailscale连了进来。这个还真得感谢halogen,一个月之前还只是玩具。
-
@terry 哈哈,主要是我现在人在外地。刚从手机翻出来两张以前拍的。
液冷冷板几乎覆盖了PCB,一把140mm风扇把冷排的热风从顶部排出。满载时转速也不高,哪怕在深更半夜,一两米外就听不到了。
我入手比较早,当时 18k,到现在来看性价比相当高。当然从综合的使用感受上来看,哪怕是现在价格涨了不少,我觉得也可以考虑,放家里跑着基本上是无感的,能效比还高。除了本地的机器,我办公室的pc和笔电也通过Tailscale连了进来。这个还真得感谢halogen,一个月之前还只是玩具。
-
,
D dardeaw feng 引用了 此主题
