X99 + 7900XTX 24G:四通道内存 + 14 核 CPU + 独立亮机卡,单卡跑 Qwen3.8-Flash-Next 预填充 1500+ / 解码 40-55 tok/s
-
-
-
,
D Data Wu 引用了 此主题
-
-
-
给大家提个醒,如果是7900XTX,暂时就保留在0.1.39版本(24G显存也不要开多并发),因为最新的0.1.40速度并没有提升而且如果你开并发时会直接挂起死掉,这应该是个BUG,要等官方更新了!以下是我实测的结果:
配置 b15k(15K) 结果
0.1.40 + parallel:2 挂起 GPU 挂起,稳定复现
0.1.40 + parallel:2 + STRATA_RING_BYTES=0 挂起 仍挂起
0.1.40 + parallel:1 1578 正常但比 0.1.39 慢 ~7-8%
0.1.40 + parallel:1 + STRATA_WMMA_GEMM=1 1411 更慢(上游默认关是对的)挂起特征:reading the prompt (batched): waiting for the GPU ... no progress for 60s(issue #29)→ released the verify window's GPU waits (#267) → 引擎自停 exit -6。0.1.40 的批量提示路径在 gfx1100 上有回归,b15k 每次必挂、b32k 不挂。
官方 release 也明说 AMD 基本未测(只测了 gfx1151)。 -
X99 + 7900XTX 24G:四通道内存 + 14 核 CPU + 独立亮机卡,单卡跑 Qwen3.8-Flash-Next 预填充 1500+ / 解码 40-55 tok/s(附升级前![4通道内存的完整插法.jpg]
分类:AI硬件
标签:7900xtx、x99、内存通道、ddr4、qwen-flash、strata
一句话:同一张 7900 XTX,硬件上做三件便宜事(内存双通道→四通道、CPU 6 核→14 核、加一张亮机卡让 XTX 的 24G 全部用于计算),再换用 Strata 引擎,单卡 24G 本地大模型辅助编程就从"能玩"变成了"有生产力"。
0. 结论先行
硬件党先看:本文最有价值的不是软件配置,而是三个便宜且立竿见影的硬件点——
- 内存四个通道插满(原来是双通道,MoE 解码吃内存带宽);
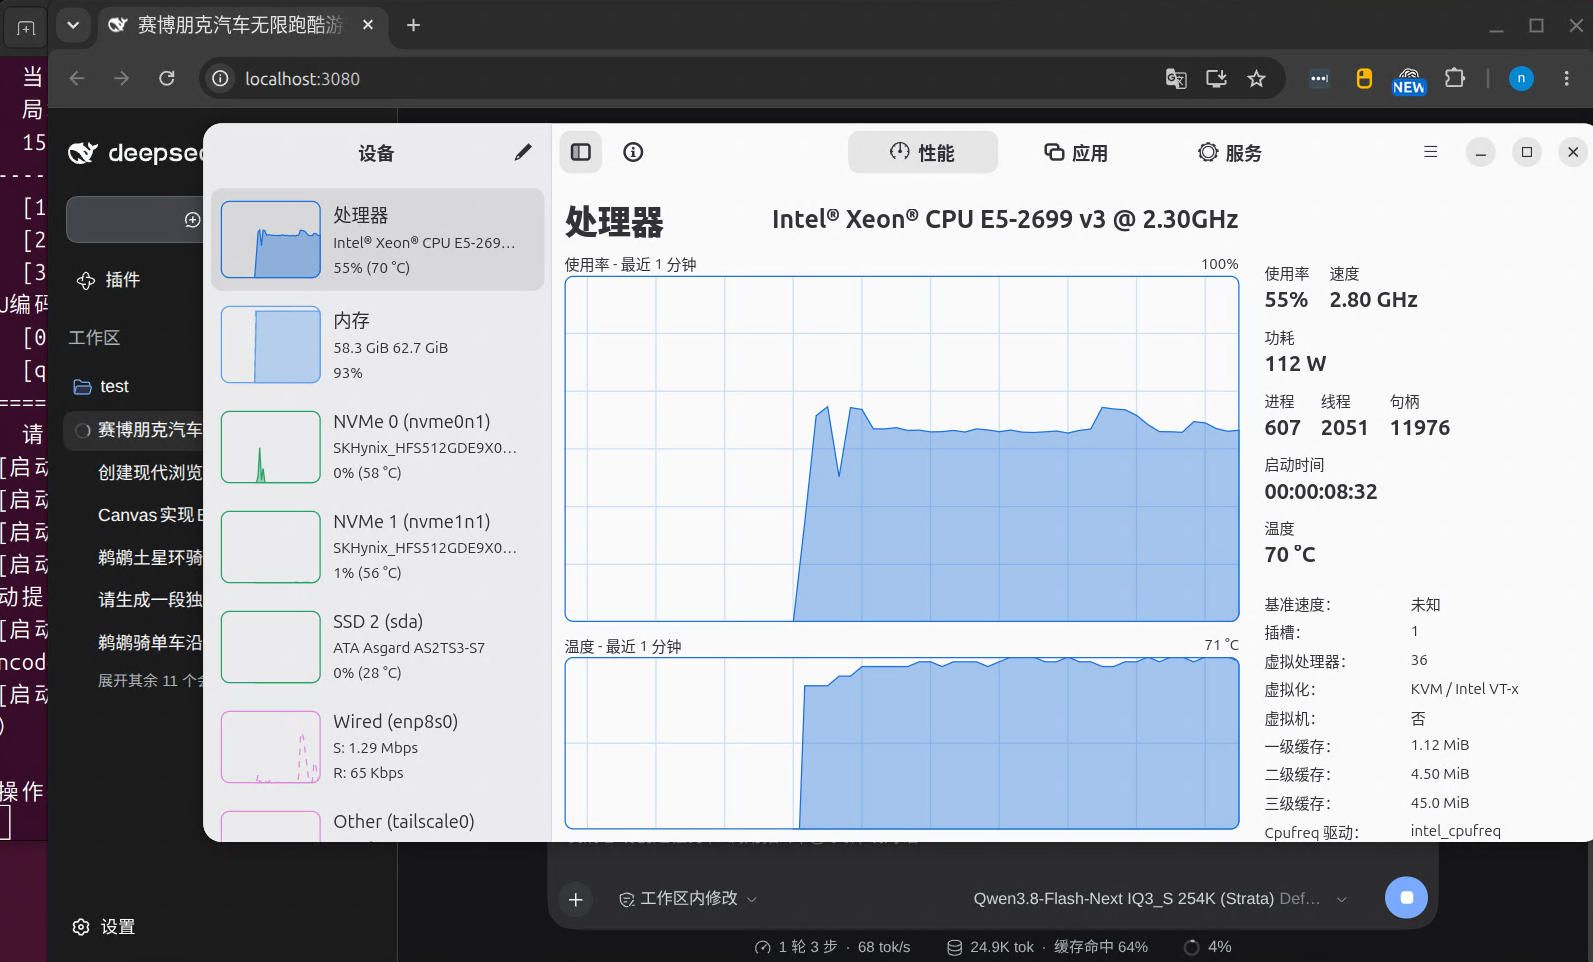
- CPU 换多核(6 核 → 14 核,未命中显存的专家由 CPU 并行算);
- 加一张亮机卡(便宜的 R7 240 接显示器,7900 XTX 的 24G 全部留给计算)。
三项叠加 + 引擎优化后,单卡 24G 实测:预填充 1460-1614 tok/s、解码 40-55 tok/s,还能看图、跑 262K、切无审查。下面给出每一步的实测数据。
- 单卡 RX 7900 XTX 24G + 64G DDR4(四通道)+ 14 核 Xeon,跑 Qwen3.8-Flash-Next(125B 总参 / 6B 激活 / +51B n-gram 表 / +4B MTP),本机实测:
- 预填充:1460-1614 tok/s(15K-32K 提示词,冷启动)
- 解码:40-55 tok/s(常规思考负载)
- 原生 262,144 上下文可用,视觉可用,KV 占用极小
- 引擎:这个模型必须用专为它写的 Strata;llama.cpp 只能到 10 tok/s(详见第 3 节,主因是 CPU/GPU 顺序执行,叠加当时内存双通道的带宽瓶颈)。
- 硬件三个关键点:内存四通道、CPU 多核、独立亮机卡(第 1 节,附本机升级前后实测)。
- 引擎三个必须自己补的点:gfx11 WMMA 内核、hipBLASLt 本机调优表、CPU 视觉助手(第 6/7 节)。
- 主力量化选 官方 IQ3_S:不是看参数拍脑袋,而是用四个一次性生成任务 + 多轮改错实测挑出来的(第 4 节)。
- 编程主力选 Flash-Next 而不是 27B:编程实测 Flash-Next(MoE)明显优于 27B(稠密)——MoE 每 token 只激活 6B,速度与质量兼得;27B 留给需要严密逻辑推理的场景。两者配合,单机单卡 24G 跑本地 LLM 辅助编程已具备真实生产力(第 4.4 节)。
1. 硬件配置与三个关键细节(附实测对比)
1.1 配置清单(当前)
部件 型号 备注 GPU AMD RX 7900 XTX 24G(Navi31) 计算主力 亮机卡 AMD R7 240/340 2G 只接显示器,见 1.4 CPU Intel Xeon E5-2683 v3(14C/28T @2.0G) 原为 E5-1650 v3(6C/12T) 内存 64G DDR4-2133(4×16G,四通道) 原为双通道,见 1.2 存储 NVMe 512G 专用数据盘(ext4) 模型/Pack 全放这里 系统 Linux + ROCm 10.0(/opt/rocm) 系统 ROCm 直接编译,无需 TheRock 1.2 细节一:内存从双通道改成四通道
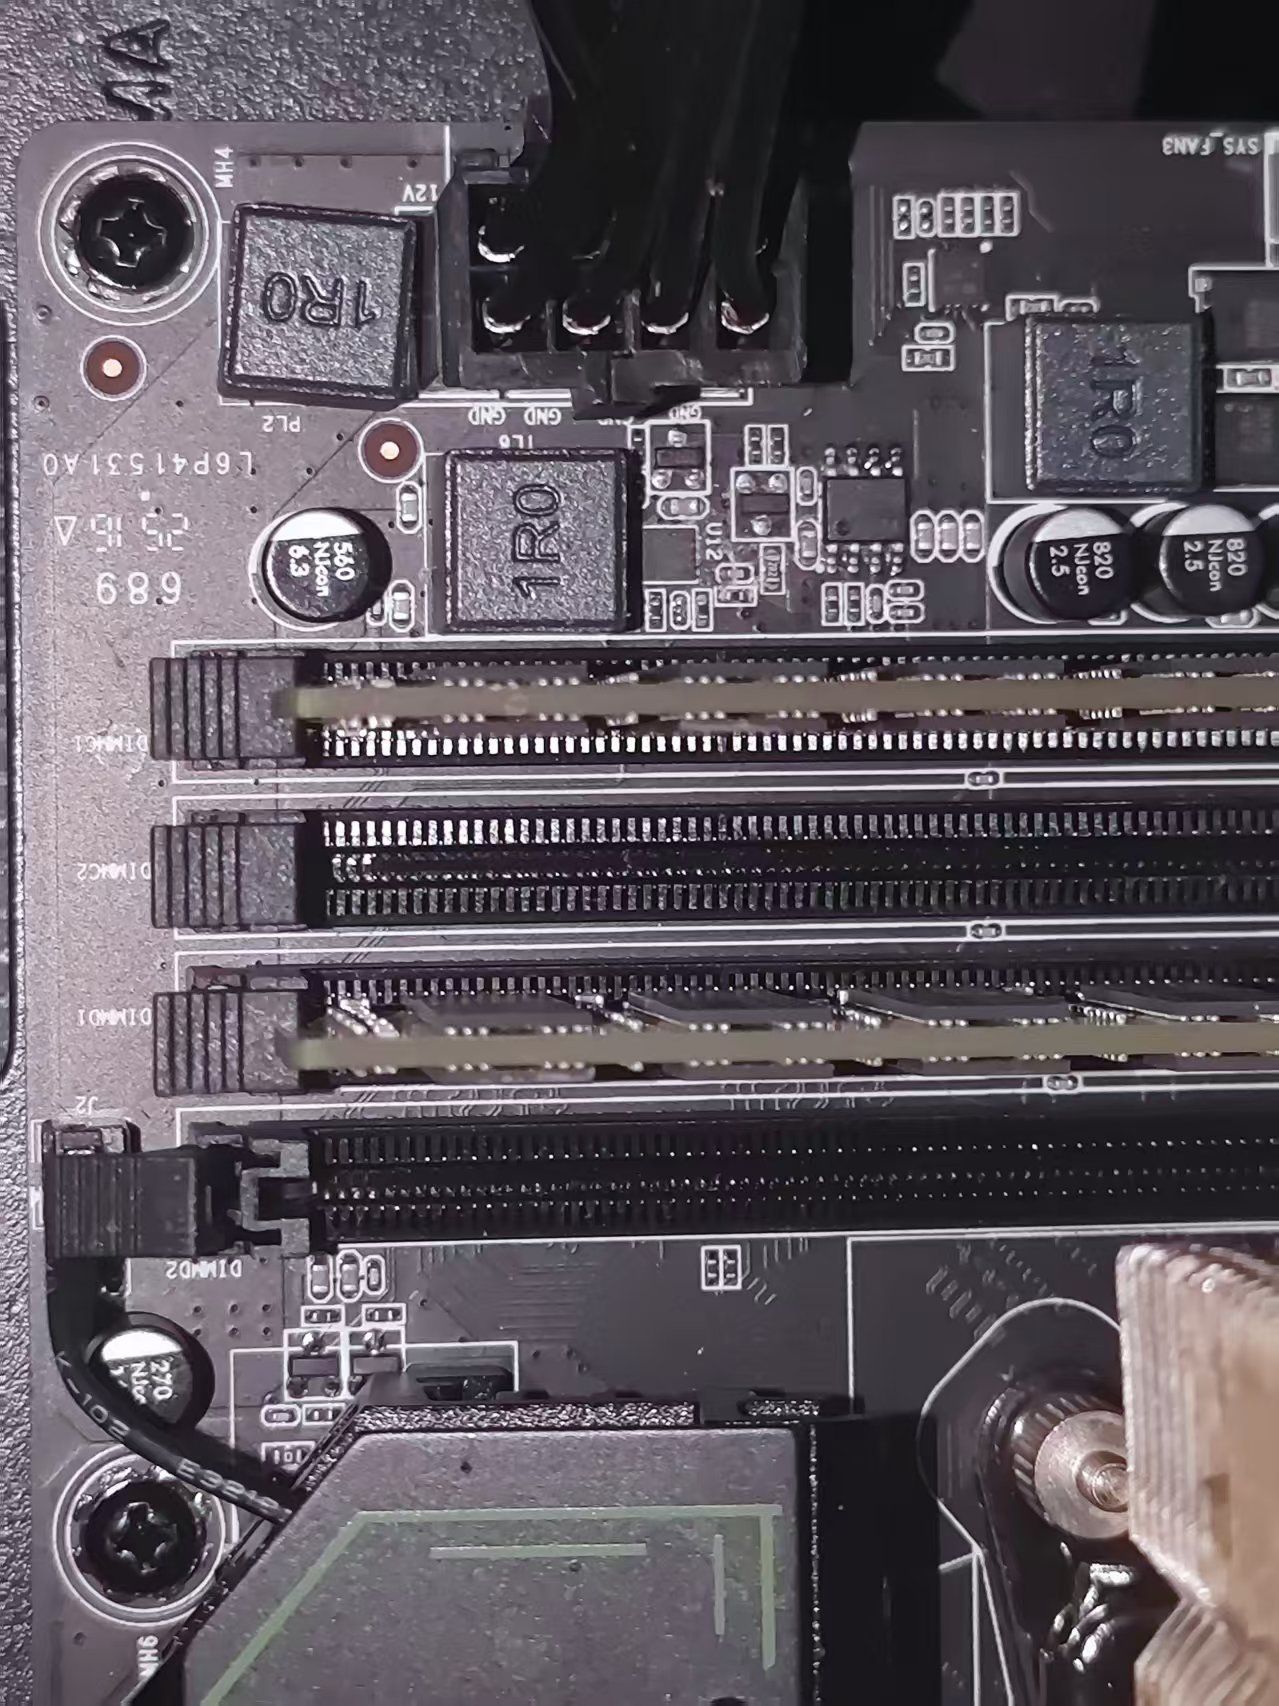
- 这台机器一开始内存插错了,把4根16G-DDR4的插满在CPU的同一侧结果就成了双通道,这时的内存带宽就少了一半,后来发现这问题后才改成了正确的如下面附图中的插法,所有4根内存要插到8根内存插槽的A1、B1、C1和D1处才能形成4通道,内存带宽就几近翻倍。MoE 模型每 token 只激活 6B,但解码时要流式读大量专家权重,是典型的内存带宽敏感负载。
- DDR4-2133 双通道理论约 34 GB/s,四通道约 68 GB/s,直接翻倍。
- 反推当时的瓶颈:llama.cpp 时代 10.3 tok/s × 每 token 约 3.2GB(6B 激活 @4.27bpw)≈ 33 GB/s,几乎正好贴着双通道 DDR4-2133 的实际带宽上限;同时 CPU 满载、GPU 空闲——即"CPU 在等内存"。
- 结论:跑 MoE 先把四个通道插满,比换显卡便宜得多。
![四通道内存的完整插法]
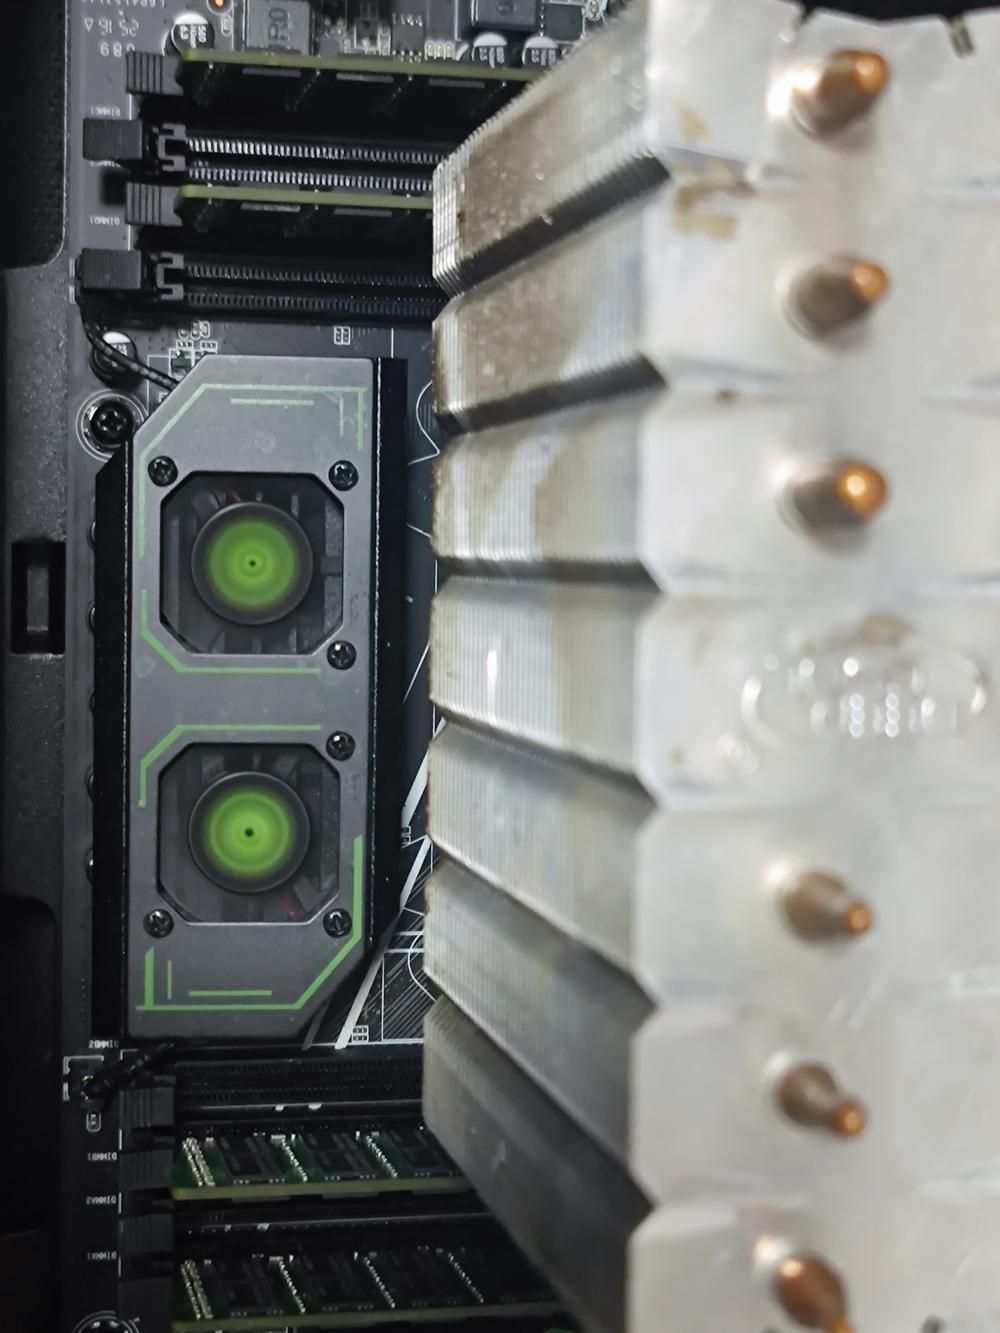
![内存通道 A1 和 B1]
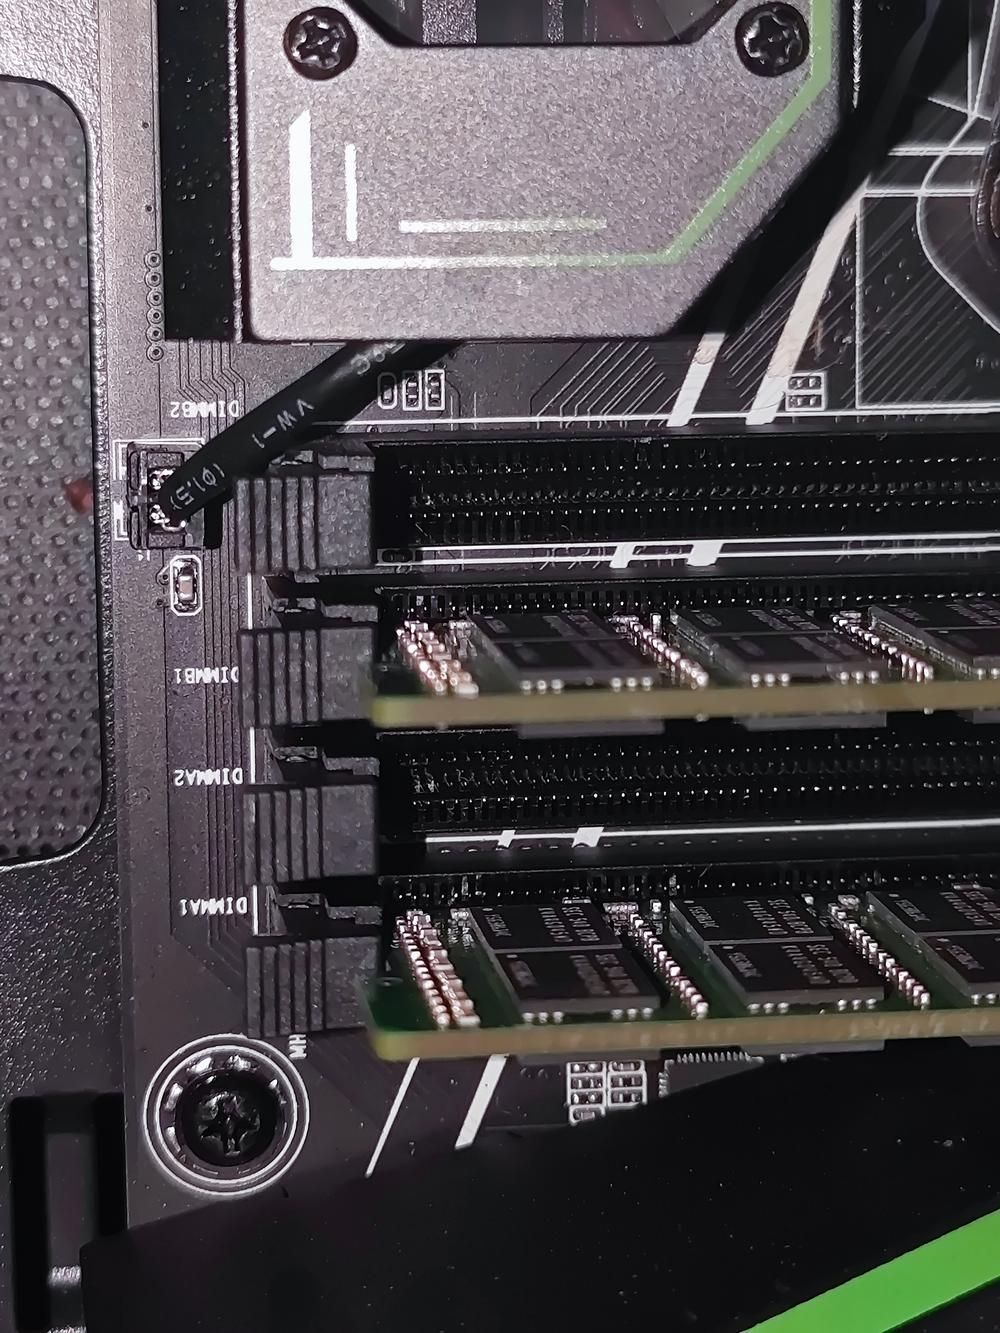
![内存通道 C1 和 D1]
1.3 细节二:CPU 从 6 核换成 14 核
- Strata 默认 CPU 线程 = 物理核数 − 1(6 核时 5 个 worker,14 核时 13 个)。
- 未命中 GPU 缓存的专家由 CPU 并行计算,核数直接决定这部分吞吐。
- 本机实测(同一引擎、同一模型 IQ3_XXS,短提示解码最吃 CPU):25.6-29.4 tok/s(6C/12T)→ 47.0 tok/s(14C/28T)。
- 注意要用物理核:全开超线程反而争用。
1.4 细节三:独立亮机卡,让 7900 XTX 的 24G 全部用于计算
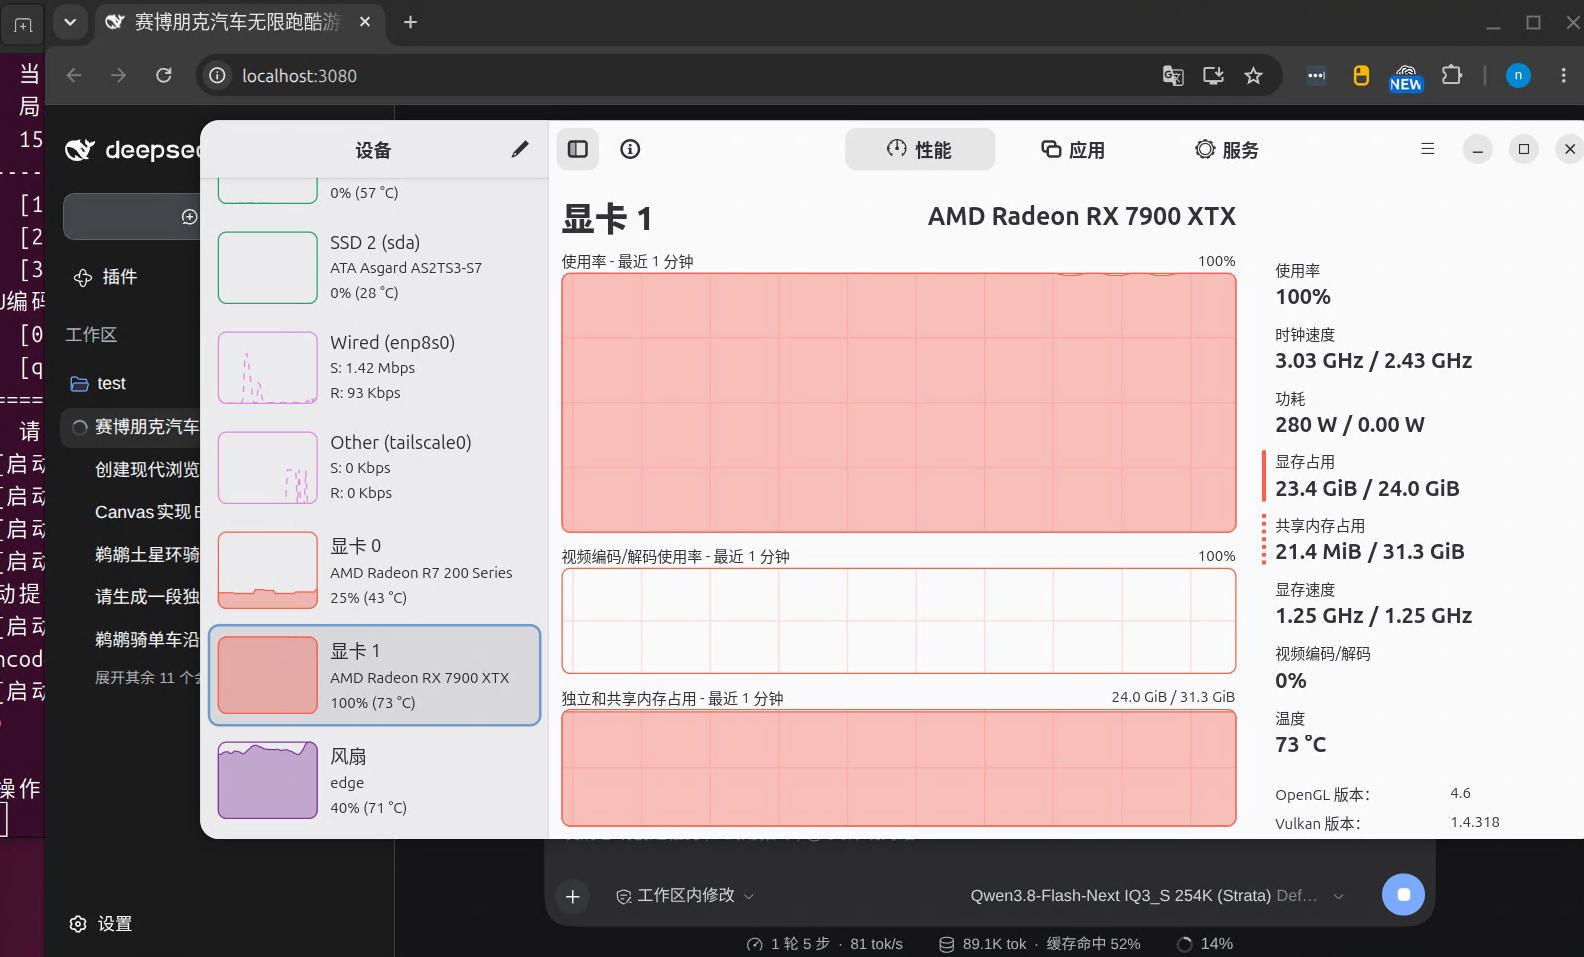
- XTX 若同时驱动桌面/浏览器,桌面合成、浏览器 GPU 进程、CEF 会吃掉 1-3G 显存;而我们要缓存 8700-10500 个专家槽,显存本就紧张。
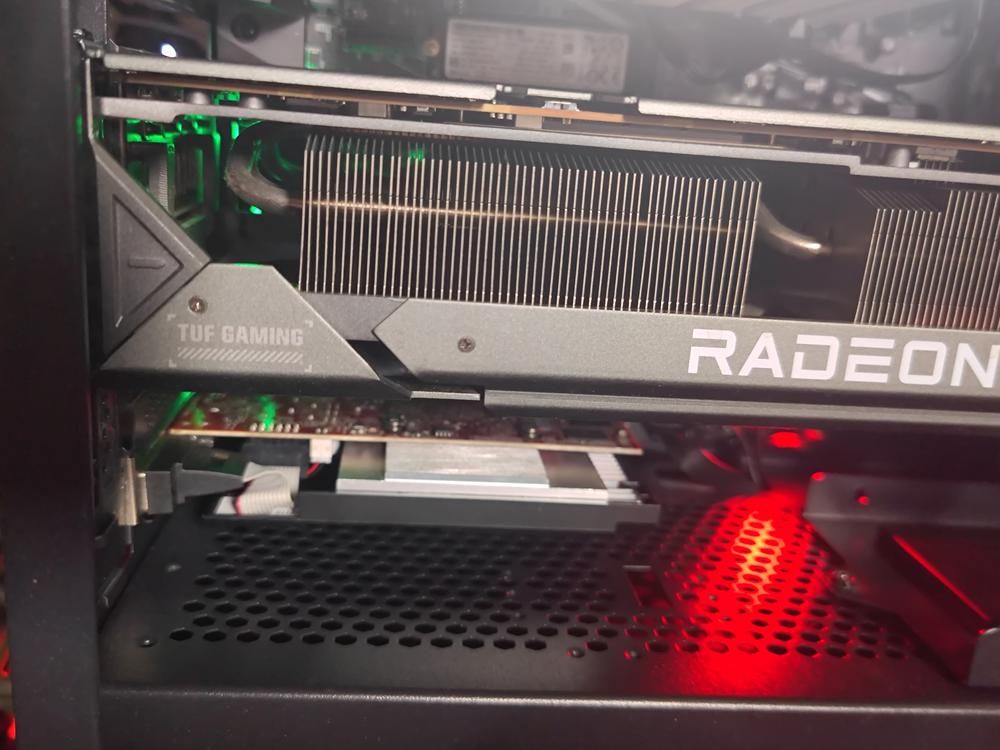
- 做法:一张便宜的 R7 240 接显示器,XTX 只做计算(设备列表
Vulkan0=R7 200、Vulkan1=7900 XTX,启动显式指定计算卡)。 - 收益:24G 几乎全部给专家缓存 + KV + 计算缓冲,长上下文更稳。
![7900 XTX 与亮机卡]
1.5 硬件/引擎升级前后对比(本机实测)
阶段 硬件 + 引擎 模型 15K 预填充 短提示解码 15K / 32K 解码 A 6C/12T + 双通道 + llama.cpp AD-4.27bpw 120-142 10.3 8.4 / - B 6C/12T + 双通道 + Strata 0.1.28(mmap+pageable) IQ3_XXS 968-975 25.6-29.4 34-43.5 / - C 14C/28T + 四通道 + Strata 0.1.34(arena) IQ3_XXS 1477 47.0 39.5 / 48.3 - A→B:换引擎是主因(同硬件同内存下解码 10.3 → 34-43,约 3-4 倍)。
- B→C:硬件升级 + 引擎调优叠加(短提示解码 +60~80%)。
- 说明:本次升级同时改了 CPU 核数、内存通道、引擎版本和专家模式,无法完全解耦;但两项硬件升级方向明确、收益立竿见影。
2. 模型与原理:为什么它能把 51B 的表放 SSD、KV 还极小
特性 说明 对我们的意义 125B MoE / 6B 激活 48 层,512 专家、每 token 激活 10+1 计算量小,权重总量大 51B n-gram 表(PLE) 每层预测性嵌入,本质是稀疏查表,不参与矩阵乘 每 token 只随机读约 2.7KB,可常驻 SSD(mmap + TENSOR_READ_LAZY 懒加载) GDN + QSA 混合注意力 3/4 层是 Gated DeltaNet 线性注意力(状态恒定),1/4 层是 QSA 稀疏注意力 KV 极小:220K int8 KV 仅约 3G,不需要 KVMem 换页 4B MTP 草稿头 自带投机解码 解码吞吐提升(本机接受率 60-87%) 原生 262,144 上下文 官方支持 配合小 KV,长会话便宜 核心:正是"51B 表在 SSD + KV 极小",让 64G 内存的消费级平台能跑 176B 存储量的模型。
3. 引擎选型:llama.cpp vs Strata(本机实测)
指标 llama.cpp(主线 ROCm) Strata(HIP) 专家执行方式 CPU 层与 GPU 层顺序执行 CPU 专家池与 GPU 并行 GPU 专家缓存 无 有(热专家自动缓存) 大块预填充 普通 8K 大块 MTP 投机 qwen4exp 无 MTP 图 内置 15K 预填充 120-142 tok/s 1460-1614 tok/s 短提示解码 10.3 tok/s 40-47 tok/s 262K 上下文 可加载 可加载(KV 流式更省显存) 视觉 支持(mmproj) 官方 HIP 不支持 → 自己补(第 7 节) 量化适配 任意 GGUF GSQ-RCO / compat-bf16 打包 结论:llama.cpp 是"能跑",Strata 才是"能用";10 t/s 的锅主要是引擎(顺序执行),当时双通道内存又雪上加霜。
4. 量化选择:为什么主力是官方 IQ3_S
4.1 三套量化(本机实测)
档位 来源 体积 用途 IQ3_S ISTA-DASLab GSQ-RCO(官方) 83.6G 编程/复杂任务主力 IQ3_XXS ISTA-DASLab GSQ-RCO(官方) 75.8G 长上下文/速度备选 SC117 IQ3_S(无审查) 官方 GSQ-RCO + 144 个消融张量移植 83.9G 需要无审查时 4.2 选择依据:四个一次性任务 + 多轮改错实测(不是看参数)
- 一次性生成任务(都是"一次成型"的硬活):
- 复合弓射箭 SVG 动画(拉弓-瞄准-放弦-箭矢抛物线-命中特效)
- 鹈鹕土星环骑自行车 SVG 动画(椭圆轨道、端点不翻车、动作连贯)
- MACOS 浏览器内操作系统(单文件 HTML/JS 复刻桌面交互)
- 3D 赛博朋克风格赛车游戏
- 评判标准:① 一次写出的完成度与可运行性;② 出错后经多轮修改时,对问题的理解力与修正质量(能不能抓住根因、改对地方)。
- 实测结论:IQ3_S 最好,一次成型率高、改错能抓住根因 → 定为主力;IQ3_XXS 略逊但仍可用;无审查版(Orca/RVN)编程明显偏弱,只能当无审查用途,不能当编程主力。
4.3 模型选型踩坑:我们实际下载/试过哪些,哪些不能用
核心经验:只认官方发布或社区反馈好的;来源不明的消融/微调版,很多下载下来就是坑。
模型(Flash-Next 125B) 来源/类型 体积 实际结果 AD-4.27bpw-Q4_K_M-M64 AtomicChat(社区,SSD-PLE 设计) 94.5G llama.cpp 可跑、质量好、有视觉;但引擎慢(10 t/s);后删除 IQ3_S ISTA-DASLab(官方 GSQ-RCO) 83.6G 最可靠,编程主力 IQ3_XXS ISTA-DASLab(官方 GSQ-RCO) 75.8G 可靠,长上下文备选 Orca 无审查 IQ3_XXS orcarouter(整模微调,门控仓库) 85.2G 需 HF token 才能下;能跑但编程明显弱;删 RVN 消融 IQ4_XS 0bserverx(重度消融) 97.5G 能跑但编程弱、且慢 20-25%(专家大 40%);删 SC117 消融 IQ3_S SC117(官方量化 + 消融张量移植) 83.9G 速度=官方 IQ3_S、无审查;当前第 3 档 huihui 消融 UD-Q4_K_XL huihui-ai(社区) 111G 未下:AMD 提示词内核 NVIDIA-only、无视觉 mradermacher 无审查 i1 社区(Orca 基) 90G+ 未下:同 Orca 基,编程弱 windowsxp / UltimateIntent 消融 社区 98-119G 未下:体积过大,64G 内存装不下 Baekpica SSD-PLE MQ-Q5 社区 83.3G 未下:需专用 ds4 loader,不通用 Navin AD-4.27 社区(Orca 基) ~95G 未下:同 Orca 基 jimmy31chen RVN IQ3_S Strata 版 社区 88.9G 未下:新仓未验证(备选) 模型(27B,早期项目) 来源/类型 体积 结果 --- --- ---: --- Qwen3.8-27B-UD-Q4_K_M unsloth UD(官方基座) 16.4G 27B 日常主力 Swift-1.5-27B-Uncensored IQ4_XS 社区(编程特化无审查) 14.25G 27B 无审查可用 DFlash2-Q4_K_M(草稿) 社区 1.14G 投机解码草稿 选型四条铁律
- 官方 > 社区 > 未知:官方 ISTA-DASLab 量化零坑;新仓库/0 下载的先观望。
- 无审查版要分类型:整模微调(Orca)会伤编程;消融(abliterated)本身也有能力回退,再叠加低比特量化更明显(RVN 就是典型)。目前最优解是"官方量化 + 消融张量移植"(SC117),而不是整模微调或重度消融。
- 下载前查四件事:底模是谁、格式是否兼容(是否需要专用 loader)、体积/内存能否装下、社区反馈如何;门控仓库还要 HF token(匿名直接 401)。
- 平台限制:AMD 上要确认量化的提示词内核是否支持(huihui UD-Q4_K_XL 就是 NVIDIA-only)。
4.4 编程主力:为什么是 Flash-Next(MoE)而不是 27B(稠密)
- 编程实测:Qwen3.8-Flash-Next 明显优于 Qwen3.8-27B——一次成型率更高,多轮改错时更能抓住根因、改对地方。
- 原因:Flash-Next 是 MoE 专家模型,每 token 只激活 6B,不是稠密全量计算,所以又快又好;27B 是稠密模型,每 token 全量参与。
- 速度对比(本机实测):Flash-Next 预填充 1460-1614 tok/s、解码 40-55 tok/s;27B 常规解码约 27-34 tok/s。
- 定位:Flash-Next = 编程主力;个别需要特别严密逻辑推理的任务,可用 27B 作为补充。
- 意义:MoE 的"小激活 + 大容量"让消费级 24G 单卡同时拿到速度和智能——单机单卡 24G 跑本地 LLM 辅助编程,已经从"能玩"变成"有生产力"。
5. 实测数据(本机、同题、冷启动)
5.1 三套配置横向对比(Strata 0.1.34 + arena + 14C/28T + 四通道)
指标 IQ3_S IQ3_XXS SC117 IQ3_S(无审查) 体积 83.6G 75.8G 83.9G GPU 专家槽 8903 10505 8700 15K 预填充 1460 t/s 1477 t/s 1564 t/s 32K 预填充 1552 t/s 1566 t/s 1614 t/s 短提示解码 40.8 t/s 47.0 t/s 45.0 t/s 15K 解码 44.8 t/s 39.5 t/s 42.1 t/s 32K 解码 43.6 t/s 48.3 t/s 55.6 t/s 视觉 支持 支持 支持 无审查 否 否 是 (解码数值随草稿接受率波动,同题对比即可;预填充为冷启动首次读取。)
5.2 优化项收益(本机 A/B)
优化 本机实测 收益 WMMA 内核(gfx11 矩阵核,PR #260) IQ3_XXS 15K:698-774 → 968-975 +35~39% hipBLASLt 本机调优表(38 行,回退 0 次) 612 → 737 +20% pinned 专家 arena(替代 mmap+pageable) IQ3_XXS 15K 1071 → 1452;32K 1124 → 1571 +36% / +40% kv-resident + resident-cpu-experts + 静态 profile 短提示解码 25.2 → 29.4 +15% 采样固定 0.6/0.95/20 思考死循环 → 正常收敛 决定可用性 引擎升级 0.1.34 客户端 5 秒断开 → 立即 cancel=True不再空烧 GPU --mtp-window 65536采用(社区实测长上下文有效;本机未单独 A/B) - 5.3 视觉(CPU 编码器)
- 整请求(图像编码 + 识别 + 生成)约 9 秒,LLM 生成速度不变(图像编码在 CPU,不占显存)。
- 实测能正确读出图中文字并完成计算题。
6. 关键优化:引擎侧
- WMMA 内核:上游主线 0.1.34 的 WMMA 只支持 gfx12(RDNA4),gfx1100 没有;我们把 gfx11 的 WMMA(PR #260)合并进来,预填充 +35~39%。
- hipBLASLt 调优表:ROCm 的 hipBLASLt 版本与官方表对不上会整体回退到慢路径。用仓库自带
tools/hip/tune_hipblaslt.cpp在本机现场生成 38 行表(覆盖官方全部形状),实测回退 0 次,预填充 +20%。 - pinned 专家 arena:默认 mmap+pageable 慢;改 pinned arena(
cudaHostRegister PORTABLE)后预填充 +36%。 - KV 流式:
--kv-resident 32768(32K 在显存,其余进内存)+ 静态专家 profile +--adapt-every 0。 - 采样必须设:Strata 在客户端不给温度时默认贪心,长思考任务会陷入同一段分析无限重复;固定
temperature 0.6 / top_p 0.95 / top_k 20解决。 - MTP 窗口:
--mtp-window 65536(长上下文草稿接受率不再掉)。
7. AMD 能力补齐:两个补丁
7.1 CPU 视觉助手(让 AMD 也能看图)
- 官方 Strata 的 AMD/HIP 后端不编译视觉(文档写死 "no images"),但引擎本身支持
--vision+ GENI 协议,视觉是独立助手进程(llama.cpp mtmd)。 - 做法:把
tools/vision用 CPU 模式单独编译出strata-vision,配置里加--vision和 vision 块。三套模型都能识图,且不占显存。
7.2
ple_key类型补丁(让消融量化能加载)- 普通 Qwen4Exp GGUF(Orca/RVN/SC117)的
blk.1.ple_key.weight是 IQ3_XXS/IQ4_XS 类型,引擎原生路径误判,报incompatible matrix blk.1.ple_key.weight。 - 补丁:
native_dense.cpp的eligible()只接受 type 42(Q2_0),其余走 compat-bf16 打包的 BF16 回退。官方 GSQ-RCO 的 ple_key 本就是 BF16,不受影响。
8. 避坑清单
坑 现象 结论 用 llama.cpp 跑 只有 10 tok/s 换 Strata(主因是顺序执行) 内存只插双通道 CPU 满载在等内存 先插满四通道 unsloth 预编译 fork 同模型只有 3.55 tok/s CPU 路径慢 3 倍,弃用 官方主线 WMMA 只支持 gfx12 gfx1100 没有矩阵核 手动合并 gfx11 WMMA hipBLASLt 表不全 大量回退、预填充腰斩 本机现场生成完整表 专家模式用 mmap+pageable 预填充只有一半 改 pinned arena --prefill 2048403 tok/s(对比 968) 保持 auto(8K) --pool-workers 10(超线程)变慢 用默认(物理核−1) ngram-mod 投机 自由生成无增益 保留无害,不必强求 KVMem 对本模型无意义 KV 本就极小,Strata 已内置流式 fork hip-gfx1100A/B 解码反而更慢 上游 + 自合并已足够 huihui UD-Q4_K_XL AMD 提示词内核 NVIDIA-only、无视觉 不选 RVN IQ4_XS 消融+量化双重损伤,编程弱且慢 已删;要无审查选 SC117 标签与实际档位不一致 opencode 以为 236K、服务端只有 131K,请求被拒 启动器按档位同步窗口 下载来源不明的消融/微调版 编程弱、格式不兼容、门控 401、需专用 loader 只认官方或社区验证版(见 4.3) 用整模微调的无审查版当编程主力 编程能力明显下降 选"官方量化 + 消融张量移植"(SC117)
9. 工程化:让它好用
-
三合一启动器:一个菜单切换三套配置(IQ3_S / IQ3_XXS / SC117),自动停旧服务、启动新服务、打开页面、同步 opencode 默认模型;带桌面快捷方式。
-
局域网网关:监听 0.0.0.0:8180,不校验 API key,单并发;第二个人访问立即收到 503 + 中文提示(含当前阶段与已运行秒数)+
Retry-After,而不是静默排队。本机 8080 直连不受限。 -
opencode 适配:每个模型独立声明窗口;启动器切档时只改对应模型的窗口,不会互相覆盖;全局自动压缩预留 64K,长会话自动总结,不撞服务端上限。
-
SSD 上的 PLE:分片设计把 51B n-gram 表单独放一个分片(28.8G),配合懒加载常驻 SSD,不占内存。
10. 附录:关键参数与仓库
核心启动参数(Strata)
--pack <pack 目录> --native <shard1> --ple-gguf <含 PLE 的分片>
--expert-profile data/expert-profile.bin --expert-cache auto
--prefill auto --spec 4 --spec-min-p 0.5 --mtp <mtp/rt>
--max-context 262144 --kv int8 --kv-resident 32768
--mtp-window 65536 --adapt-every 0
--vision --vram-reserve-mib 1024
环境:STRATA_HIPBLASLT_TUNING=<本机 38 行表>
采样:temperature 0.6 / top_p 0.95 / top_k 20
用到的仓库/资源
- 引擎:
Niko1221/Strata(0.1.34;gfx11 WMMA 来自 PR #260) - 量化:
ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF(IQ3_S / IQ3_XXS) - 无审查:
SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF - 基座/视觉/MTP:
Qwen/Qwen3.8-Flash-Next(官方 mmproj BF16)
致谢:hipBLASLt 调优表与 gfx11 WMMA 是社区贡献;坛内 Strata/AMD 主题帖给了大量参数参考。本文所有数据均为本机实测,不同硬件/驱动会有差异,仅供参考。
本文由本人整理,数据来自本机实际测试日志。欢迎交流指正。
-
,
 T terry 固定了此主题
-
@guonetnet
感谢测试这么多模型,我现在使用官方的ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF( IQ3_XXS)模型,感觉过度思考比较严重,虽然开了128K上下文,有时还是会被截断,思考模式切到中,又会感觉智力不够。使用ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF的微调版本是否有改善。 -
@perter 首先建议模型用iq3_s的版本,它的能力更强,幻觉会更少;其实我是不建议用DSH的客户端,它到目前为止都没有解决超过输出上下文长度后就会被硬截断而停止输出的问题!我建议用opencode或pi这样的智能编程体,它们会比较智能地处理快超输出上下文时,它们会自动压缩并继续。
-
,系统 取消固定了此主题
-
-
--pool-workers 15→11,解码提升 6~24% 这个值得尝试 我的也是 x99 2686v4 ddr3 7900xtx 这个有个甜点位置自己多测试下 不同设备可能不一样 我是 11 最佳
-
--pool-workers 15→11,解码提升 6~24% 这个值得尝试 我的也是 x99 2686v4 ddr3 7900xtx 这个有个甜点位置自己多测试下 不同设备可能不一样 我是 11 最佳
@Grayson-Ren
我自己测试了一下--pool-workers参数的问题:pool-workers decode t/s 相对默认
17(默认) 129.4 基准
15 128.1 -1.0%
13 129.3 -0.1%
11 128.2 -0.9%
9 126.7 -2.1%
7 123.4 -4.6%
长提示词 b15k/b32k(warm):预填充 917 全在 ±3% 内无趋势;解码差异与各轮 MTP 命中率(6282%)强相关,是投机噪声。 多样低命中(~87.5%)pass2 解码均值:17→74.7、11→75.0、9→72.9。结论:
在11-17 之间解码无差异,≤9 才明显变慢。
默认 17(=18 物理核 −1 + host 线程,正好占满物理核、无 SMT 超订)已是最优/并列最优。你用11的收益更像其特定平台/配置(缓存命中率、内存时序)所致,不一定普遍,其他有兴趣的朋友也可以自己测试对比一下!