
R9700 + Strata 实测:双卡 128K Prefill 3708 tok/s,兼测 IQ3_XXS / IQ3_S
-
最近在 X99 平台上集中测试了 Strata,主要看两个问题:
- 单张和双张 Radeon AI PRO R9700 跑 Qwen3.8-Flash-Next GSQ-RCO GGUF,性能能到什么水平;
- 在我的平台上,IQ3_XXS 和 IQ3_S 的性能差异有多大。
先说结论
- 单卡 R9700 + IQ3_XXS:128K Prefill 约 2168 tok/s,Decode 约 62 tok/s。
- 双 R9700 + Layer Split + IQ3_XXS:128K Prefill 约 3708 tok/s,双卡扩展比约 1.71×;TTFT 从约 59.6 秒降到 35.1 秒。
- 双卡后 24,576 个 experts 可以全部驻留 GPU,Host Resident Expert 从 18.63 GiB 降到 0。
- 在我的 X99 平台上,Layer Split 明显优于 Peer Device。
- IQ3_S 即使双卡实现 100% expert 显存驻留,128K Prefill 仍比 IQ3_XXS 慢约 15.9%。
- 性能方面目前明显更适合 IQ3_XXS;质量方面,IQ3_S 和 IQ3_XXS 还没有做足够完善的高难度 Agent/Coding 对比,因此暂不下结论。
一、IQ3_XXS:单 R9700 与双 R9700
测试平台与关键参数
项目 配置 主板 / CPU X99-TF / Xeon E5-2697A v4 内存 128GB DDR4 GPU 2 × AMD Radeon AI PRO R9700 32GB PCIe X99 / PCIe 3.0,P2P、HIP IPC 已验证 OS Ubuntu 24.04 Server Strata v0.1.38, 99f3dbd0b21d1401b3769e0c0d963913607f380bROCm 10.2.0a20260914 模型 Qwen3.8-Flash-Next-GSQ-RCO-GGUF 主要量化 IQ3_XXS 关键设置 STRATA_RESIDENT_PIN=1、STRATA_HIP_WMMA=1、STRATA_SELECT_WMMA=1、pcie-frac=0、hipBLASLt tuning OFF前期探索里影响最大的是 Resident Expert Pinning:pageable resident memory 改为 pinned 后,128K Prefill 从约 1506 tok/s 提升到约 2177 tok/s。后续单、双卡测试都以这条内存路径作为基线。
单卡 vs 双卡结果

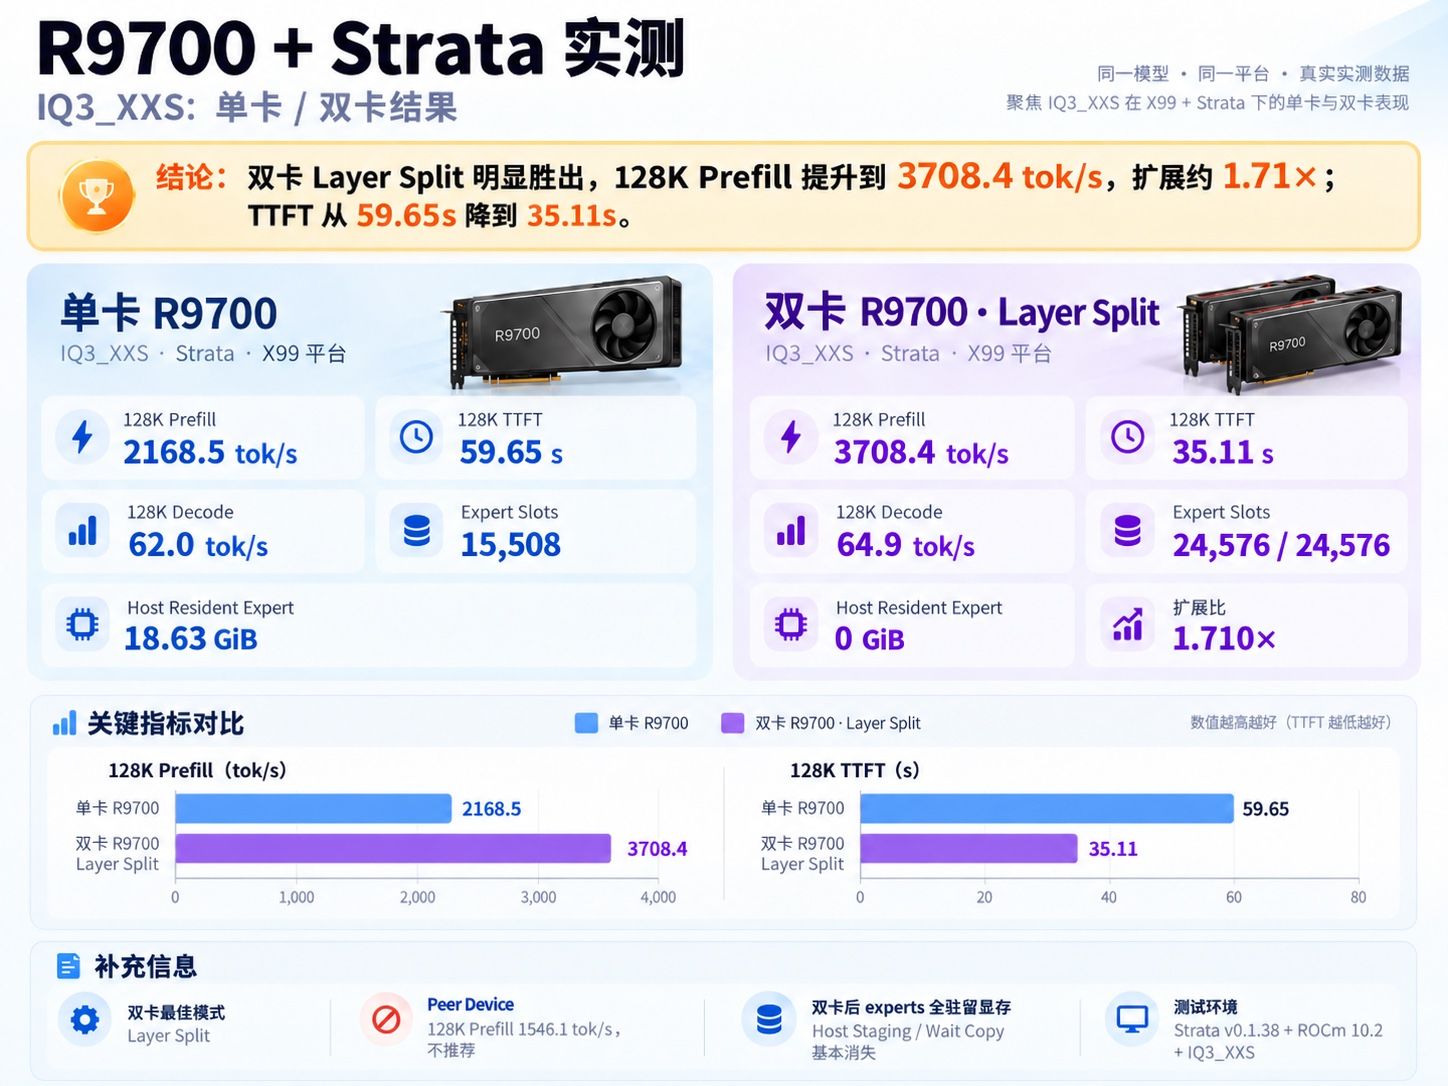
最直观的结果: 15K 下双卡提升约 20%,到了 128K,Prefill 从 2168.5 tok/s 提升到 3708.4 tok/s,扩展约 1.71×。
128K 下 TTFT 从 59.65 秒降到 35.11 秒,少了约 24.5 秒。对于需要不断追加上下文、反复 Tool Calling 的 Agent 工作流,这个变化比单纯 Decode 快几 tok/s 更有意义。
指标 单 R9700 双 R9700 / Layer Split 变化 15K Prefill ≈2140 tok/s 2586 tok/s ≈+20% 128K Prefill 2168.5 tok/s 3708.4 tok/s 1.710× 128K TTFT 59.65 s 35.11 s -24.54 s 128K Decode 62.0 tok/s 64.9 tok/s 基本无损 Expert Slots 15,508 24,576 / 24,576 100% 驻留 GPU Expert ≈25.15 GiB 39.96 GiB ↑ Host Resident Expert 18.63 GiB 0 GiB 完全消除 Host Staging ≈1.5 s 0 消失 Wait Copy ≈1.8 s 0 消失 128K Multi-Needle 5/5 PASS 5/5 PASS 一致 C1 / C2 / C3 PASS PASS 一致 当前 Layer Split 为 0–20 层 / 21–47 层。
这个 1.71× 不能简单理解成传统 TP2 的扩展效率。更准确地说,收益来自三部分叠加:更多 experts 驻留 GPU、Host 搬运基本消失、Layer Split 带来的跨卡流水执行。
Layer Split 与 Peer Device
两种双卡模式都做了实际测试:
模式 128K Prefill 相对单卡 Single 2170.3 tok/s 1.000× Layer Split 3699.3 tok/s 1.704× Peer Device 1546.1 tok/s 0.712× Peer Device 在我的平台上反而比单卡慢,因此后续双卡路线直接选择 Layer Split。
二、IQ3_XXS 与 IQ3_S 对比
这里主要想验证一个问题:IQ3_S 单卡更慢,是因为它占用更大、更多 experts 落到 Host,还是当前 Strata / ROCm / gfx1201 路径下本身就有更高的执行成本?
单卡与双卡的 128K 性能

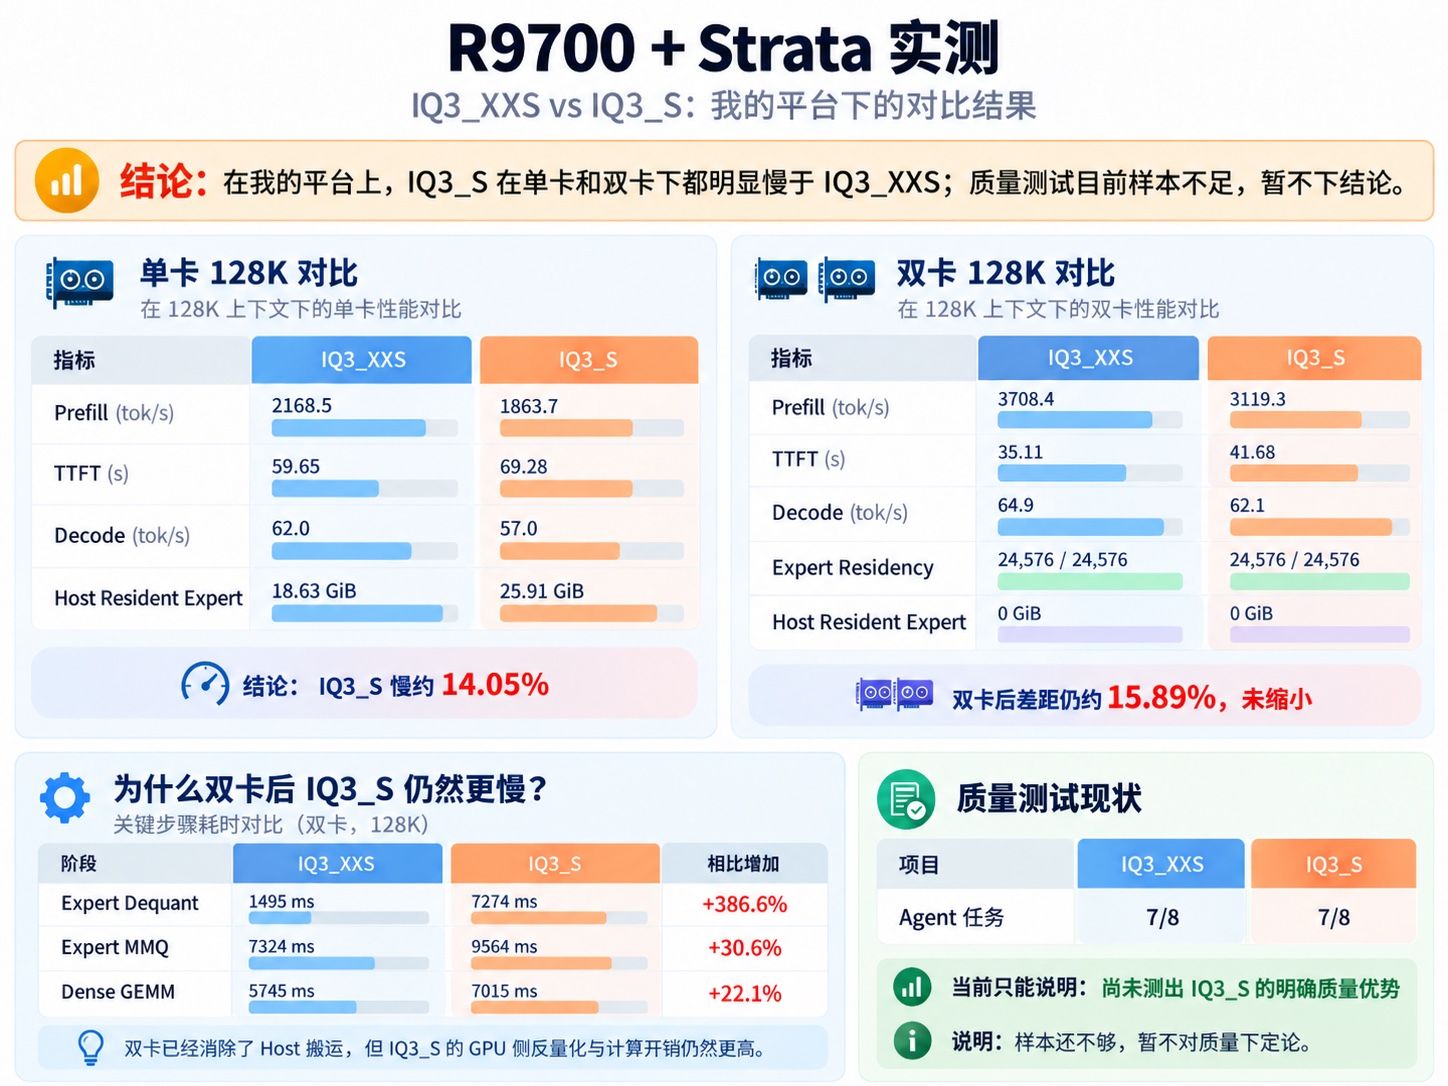
单卡时:
指标 IQ3_XXS IQ3_S IQ3_S 相对变化 15K Prefill 2140.2 tok/s 1833.9 tok/s -14.31% 128K Prefill 2168.5 tok/s 1863.7 tok/s -14.05% 128K TTFT 59.65 s 69.28 s +16.14% 128K Decode 62.0 tok/s 57.0 tok/s -8.06% Host Resident Expert 18.63 GiB 25.91 GiB IQ3_S 更高 单卡时 IQ3_S 的 Host Resident 更大,因此一开始的假设是:双卡如果把 IQ3_S 的 experts 全部放进显存,性能差距也许会明显缩小。
但双卡结果没有支持这个假设:
指标 Dual IQ3_XXS Dual IQ3_S IQ3_S 相对变化 15K Prefill 2586.1 tok/s 2182.0 tok/s -15.63% 128K Prefill 3708.4 tok/s 3119.3 tok/s -15.89% 128K TTFT 35.11 s 41.68 s +18.71% 128K Decode 64.9 tok/s 62.1 tok/s -4.39% Dual Scaling 1.710× 1.674× IQ3_S 略低 Expert Slots 24,576 / 24,576 24,576 / 24,576 均 100% GPU Expert 39.96 GiB 46.83 GiB +6.87 GiB Host Resident 0 GiB 0 GiB 一致 128K 最小可用显存 1.6 / 9.2 GiB 3.2 / 3.2 GiB 均安全 双卡已经把两种量化的 experts 都全部放进 GPU,IQ3_S 仍然慢约 15.9%。
Timing:差距主要出现在哪里
128K Timing IQ3_XXS IQ3_S 变化 Expert Dequant 1495 ms 7274 ms +386.6% Expert MMQ 7324 ms 9564 ms +30.6% Dense GEMM 5745 ms 7015 ms +22.1% Wait Copy 0 ms 100 ms 基本可忽略 因此目前可以确认的是:在 Strata v0.1.38 + ROCm 10.2 + gfx1201 这套实现下,IQ3_S 的 GPU-side execution path 存在明显更高的执行成本。
至于更底层究竟主要来自 quant format、packing、dequant、MMQ kernel、memory traffic 还是其他因素,目前没有继续做 kernel profiling,所以这里不做过度归因。
关于 IQ3_XXS 和 IQ3_S 的质量
这一部分目前测试还不够完善,我不打算下确定结论。
项目 IQ3_XXS IQ3_S Agent 任务 7/8 7/8 C1 Strict JSON PASS PASS C2 Tool Calling PASS PASS C3 Python Coding PASS PASS 128K Multi-Needle 5/5 5/5 这些结果只能说明:目前没有测出 IQ3_S 明显的质量优势。
但 8 个 Agent 任务样本太少,也不足以证明两者质量相同。真正可能拉开差距的,应该是复杂代码修复、多文件依赖、长链路推理、失败后的自我修正、复杂 Tool Calling、长上下文约束保持等更困难任务。
所以目前我的结论只限定在:
性能:IQ3_XXS 明显更好。
质量:证据不足,暂不判断 IQ3_S 是否更好。以后如果继续比较质量,会单独设计更大的高难度 Agent / Coding 测试集。
最终结果
项目 当前结果 单卡性能量化 IQ3_XXS 双卡性能量化 IQ3_XXS 双卡模式 Layer Split 单卡 128K Prefill ≈2168.5 tok/s 双卡 128K Prefill ≈3708.4 tok/s 双卡 128K TTFT ≈35.11 s 双卡 128K Decode ≈64.9 tok/s 双卡扩展比 ≈1.71× 双卡 Expert Residency 24,576 / 24,576 Host Resident 0 GiB Peer Device 当前平台不推荐 IQ3_S 性能 明显慢于 IQ3_XXS IQ3_S vs IQ3_XXS 质量 目前证据不足,暂不下结论 从这次测试来看,X99 虽然只有 PCIe 3.0,但在双 R9700、P2P / HIP IPC 正常、使用 Strata Layer Split 的情况下,128K Prefill 仍然从约 2168 tok/s 提升到 3708 tok/s。
对 Flash-Next 这种 expert residency 很重要的模型来说,第二张卡的价值并不只是增加算力,更重要的是把单卡放不下的 experts 从 Host 搬进 GPU。
以上数据仅代表我的 X99 + 双 R9700 + Strata v0.1.38 + ROCm 10.2 环境。不同 PCIe 拓扑、驱动、Strata 版本、ROCm 版本以及量化文件,结果都可能不同。
-
坐等双卡进一步优化
r9700含金量还在进一步上升

