7900XTX 单卡部署哪家强?llama.cpp 27b vs strata flash next 大比拼!
-
这几天折腾了好一阵单卡strata,终于调优到了理想水平(pp1800, tg60-90)之后,略感空虚,整了点活,水一篇哈哈。
TDLR:单卡内存够的情况下,在视觉相关任务上(前端、客户端开发),strata生成质量明显高于27b,无脑选择IQ3_S。
量化更激进的模型跑的更快,但实际执行任务的时间更长,原因包括雷霆大思考流口水,不断返工等等,不值得为了点pp/tg的提升。此外,量化的确牺牲了不少模型对事物的认知和细节,具体可以从下文的报告里看到。
本地模型 vs 在线模型:鹈鹕骑自行车 SVG 生成评测
评测日期: 2026-10-04
测试方式: DeepSeek Harness (DSH) agent,同一句 prompt:Generate an SVG of a pelican riding a bicycle.
硬件: AMD Radeon RX 7900 XTX 24 GB (gfx1100/RDNA3),Ryzen 5 9600X (6C/12T),92 GiB RAM本文回答两个问题:
- 本地模型比在线模型差了些什么?可用性如何?
- 更 aggressive 的量化损失了什么?
1. 结论
问题一:本地模型差了"速度",但没差"质量"
本地模型在质量上不落后。 IQ3_S(7.9 KB)产出的鹈鹕在解剖准确性上优于两个在线模型中的阿里官方,仅次于 DeepSeek v4.1-flash。三者在"能否画出正确的鹈鹕骑自行车"这一核心判据上处于同一档。
差距集中在延迟和吞吐,且分布不均:
维度 本地最优 在线最优 差距 冷启动 TTFT 7,643 ms 807 ms 9.5× 预热 TTFT 411 ms 750 ms 本地反超 1.8× decode 吞吐 88 tok/s 279 tok/s 3.2× 短 prompt prefill 1,195 tok/s 不可比(缓存) — 关键发现:预热之后,本地模型的 TTFT 反而比在线更快(411 ms vs 750 ms),因为本地没有网络往返。真正输的只有 decode 吞吐(约 1/3.2)和冷启动的首次加载。
可用性判断:
- 交互式使用:可用。 预热 TTFT 0.4–0.8 s、decode 44–88 tok/s,与在线模型的体验差距主要在长输出的生成速度上(等 30 s vs 等 10 s 量级),而非响应手感。
- 冷启动:唯一的硬伤。 首次请求需 7.6–9.8 s,之后不再出现。
- 质量:完全可用。 本地模型产出与在线旗舰同档,且本轮没有任何一个模型出现明显错误。
问题二:更 aggressive 的量化,损失的主要是"推理节制性"
IQ3_S → IQ3_XXS 是同一模型的两次量化,构成直接对照组。体积只小 10%,但行为差异显著:
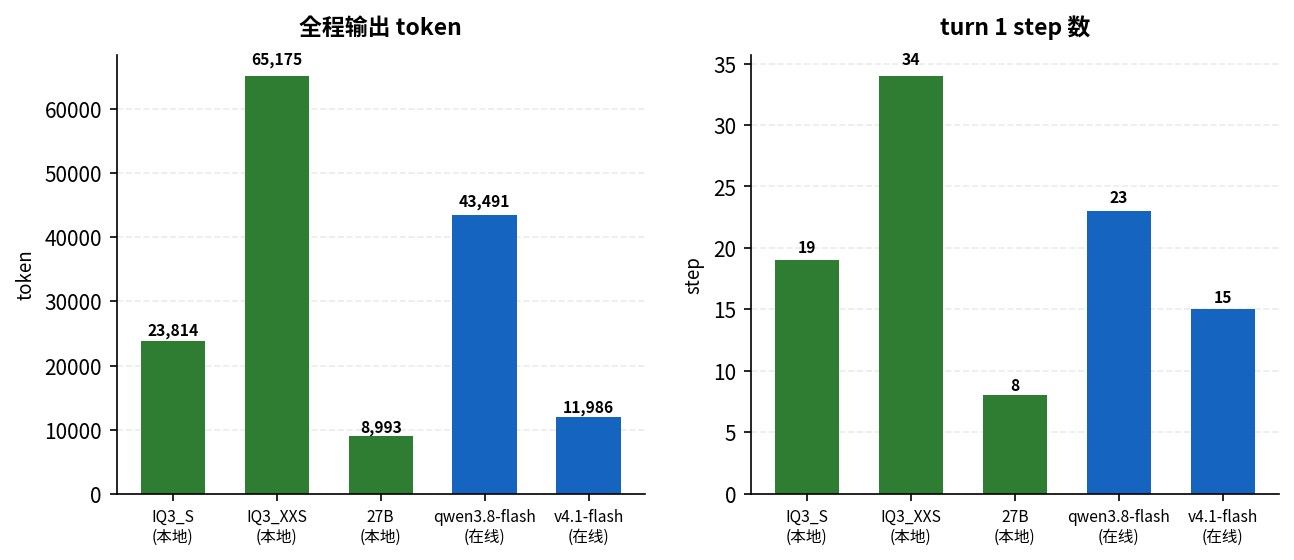
指标 IQ3_S IQ3_XXS 变化 权重体积 ~79 GB ~71 GB −10% decode 吞吐 71.8 tok/s 88.0 tok/s +23% 短 prompt prefill 1,044 tok/s 1,195 tok/s +14% 冷启动 TTFT 8,745 ms 7,643 ms −13% 全程 output token 23,814 65,175 +174% thinking 占比 51.6% 64.3% +12.7 pt SVG 自纠正编辑 2 次 4 次 +2 SVG 渲染验证 6 次 11 次 +5 量化省下 10% 的体积,换来 14–23% 的速度提升 —— 但代价是推理变得不节制: IQ3_XXS 输出了 2.7 倍的 token,其中 thinking 占比升到 64.3%。它单独产出的 41,921 个 thinking token 比 IQ3_S 的全部输出(23,814)还多 76%。
净效果是负的: IQ3_XXS 的 turn 1 端到端耗时 741.5 s,是 IQ3_S(307.5 s)的 2.4 倍。速度提升被过度推理完全吃掉。
产出质量没有损失 —— 两者同级,IQ3_XXS 的打磨次数甚至更多(自纠正 4 次 vs 2 次、渲染验证 11 次 vs 6 次),说明它更愿意反复迭代,但多花的成本没有转化为可见的质量收益。
这是单次运行的观察,n=1。 "IQ3_XXS 更啰嗦"可能是量化导致的系统性行为偏移,也可能是本次采样偶然。要确认需要多次重复实验。
2. 被测模型
# 模型 部署 量化 HuggingFace 仓库 / 权重 artifact 1 Qwen3.8-Flash-Next 本地 Strata (HIP/gfx1100) IQ3_S ISTA-DASLab/…-GSQ-RCO-GGUF @ 2a55d759<br>…IQ3_S-00001/00002-of-00002.gguf/tmp/local_iq3/2 Qwen3.8-Flash-Next 本地 Strata (HIP/gfx1100) IQ3_XXS 同上仓库 @ 2a55d759<br>…IQ3_XXS-00001/00002-of-00002.gguf/tmp/iq3_xxs/3 Unsloth Qwen3.8-27B 本地 llama.cpp UD-Q4_K_S(14.3 GiB)unsloth/Qwen3.8-27B-GGUF @ 14370d1b/tmp/27b/4 阿里官方 qwen3.8-flash 在线 API — 阿里云百炼 qwen3.8-flash/tmp/qwen-official/5 DeepSeek v4.1-flash 在线 API — deepseek-official/deepseek-flash(1M ctx)/tmp/deepseekv41/模型 1/2 是同一模型的不同量化,构成本文问题二的对照组。
3. 问题一:本地 vs 在线
3.1 延迟
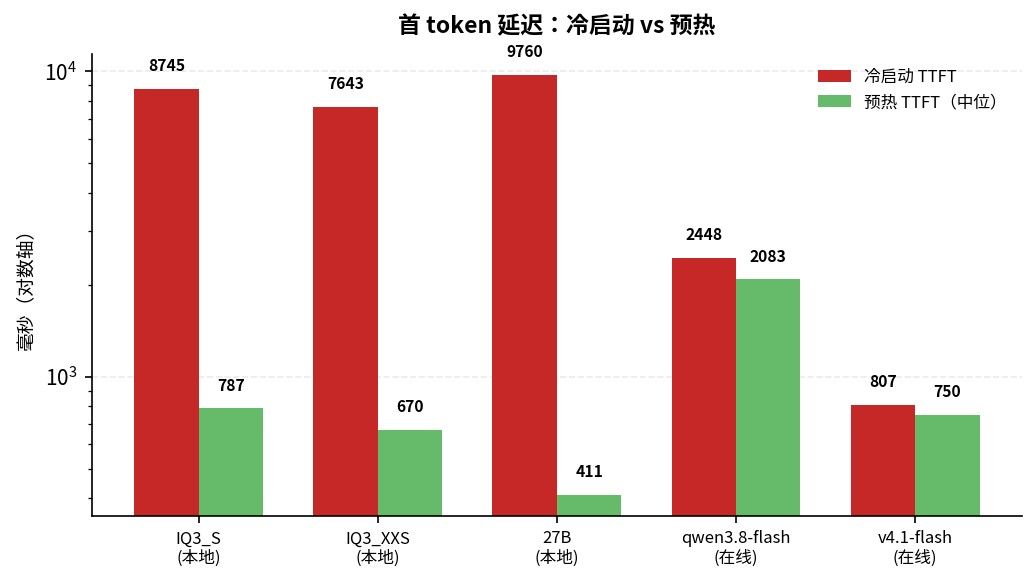
冷启动本地慢 3–4 倍,预热后本地反超。 本地三个模型的预热 TTFT(411–787 ms)全部优于阿里官方(2,083 ms),27B 甚至优于 DeepSeek(411 vs 750 ms)。原因是本地无网络往返,而在线模型每次请求都要跑完整 RTT。
本地模型的冷启动降幅达 11–24 倍,说明主要成本是首次加载(expert cache 预热、首个 verify window 建立),而非推理本身。在线模型冷/预热差异仅 1.1–1.2 倍,因其服务端始终处于热态。
3.2 吞吐
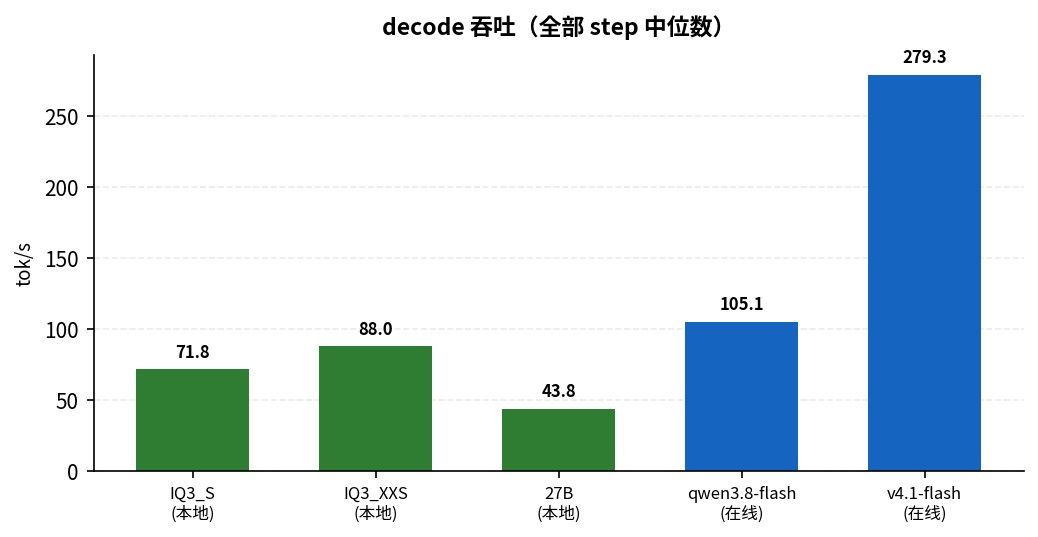
decode 是本地唯一稳定落后的维度:44–88 tok/s vs 在线 105–279 tok/s。差距比 prefill 小得多,且对交互体验的影响主要是长输出时的等待时长。但是考虑到一个27G的本地显卡可以达到阿里官方API 70%的速度,可以说并不差了。
prefill 无法公平比较: 两个在线模型的首步输入分别有 98% 和 86% 命中服务端缓存,其 TTFT 反映缓存读取而非计算。三个本地模型无缓存命中,是真实 prefill:
模型 prefill 说明 IQ3_S 1,044 tok/s 真实(短 prompt) IQ3_XXS 1,195 tok/s 真实(短 prompt) 27B Q4_K_S 991 tok/s 真实(短 prompt) 阿里官方  ️ 不可比
98% 缓存命中 DeepSeek v4.1 ️ 不可比86% 缓存命中 长 prompt(33K 全新)下本地可达 1,856–1,980 tok/s,为短 prompt 值的 1.8–2.0 倍。
3.3 质量
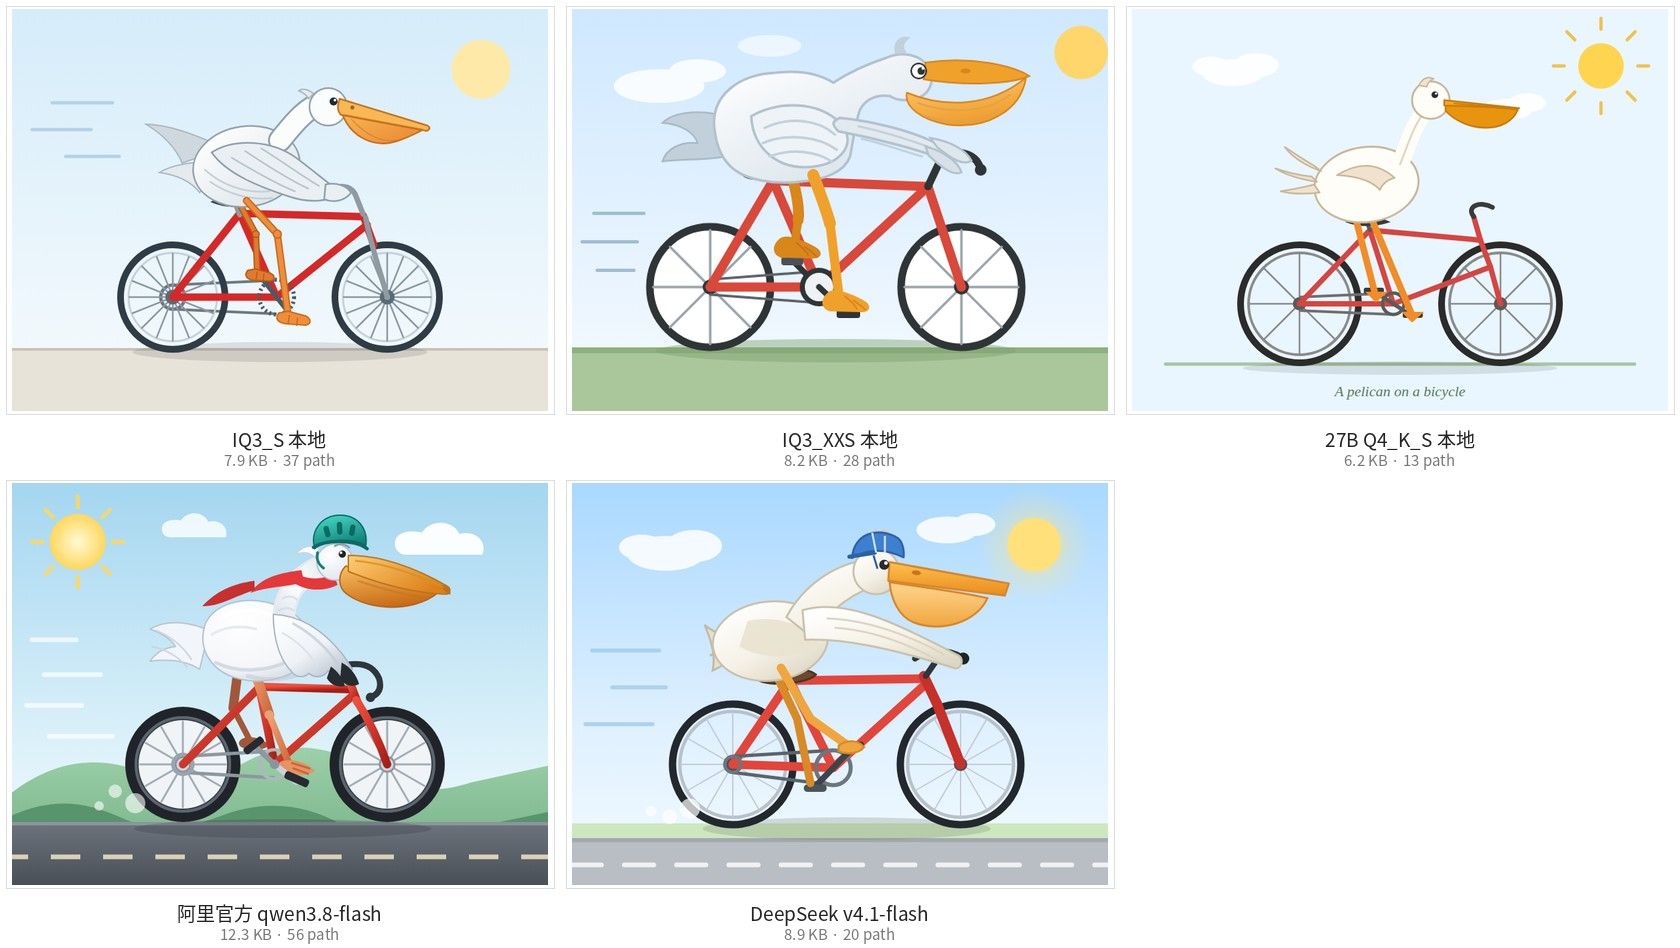
五个 artifact 并排对比(上排为本地模型,下排为在线模型;按各自原生画布尺寸渲染):
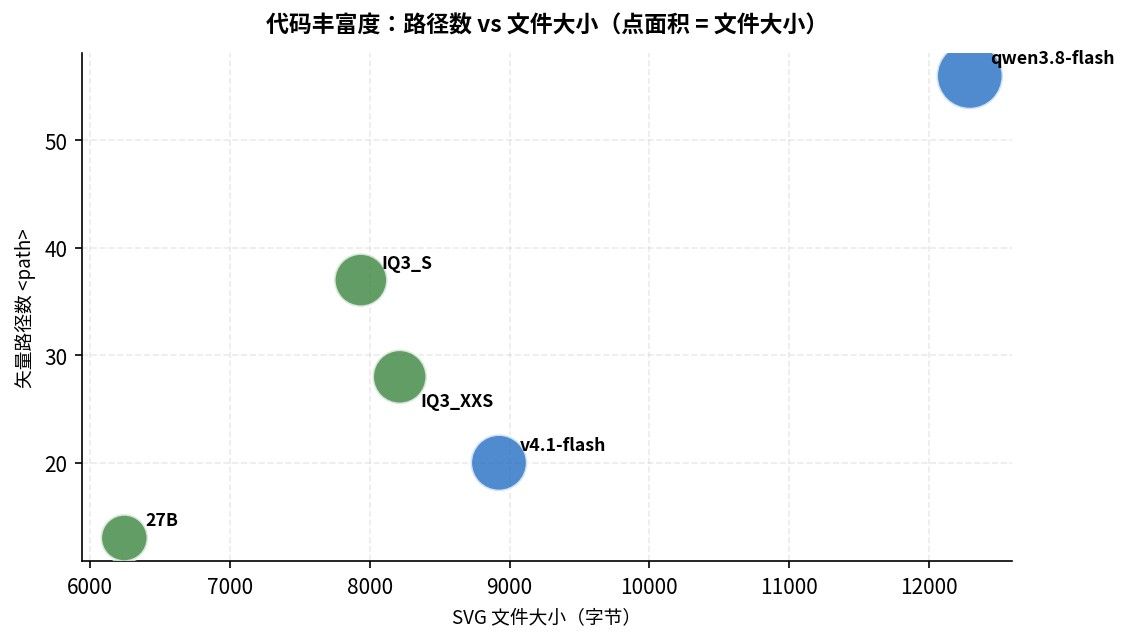
模型 字节 元素 <path>transform可访问性 IQ3_S 本地 7,936 89 37 3 
IQ3_XXS 本地 8,214 86 28 0 27B Q4_K_S 本地 6,244 86 13 1 
阿里官方 12,292 120 56 10 DeepSeek v4.1 8,924 90 20 9 所有 artifact 按各自原生画布尺寸渲染(IQ3_XXS 640×480,其余 800×600),不作缩放比较。
目视评估:
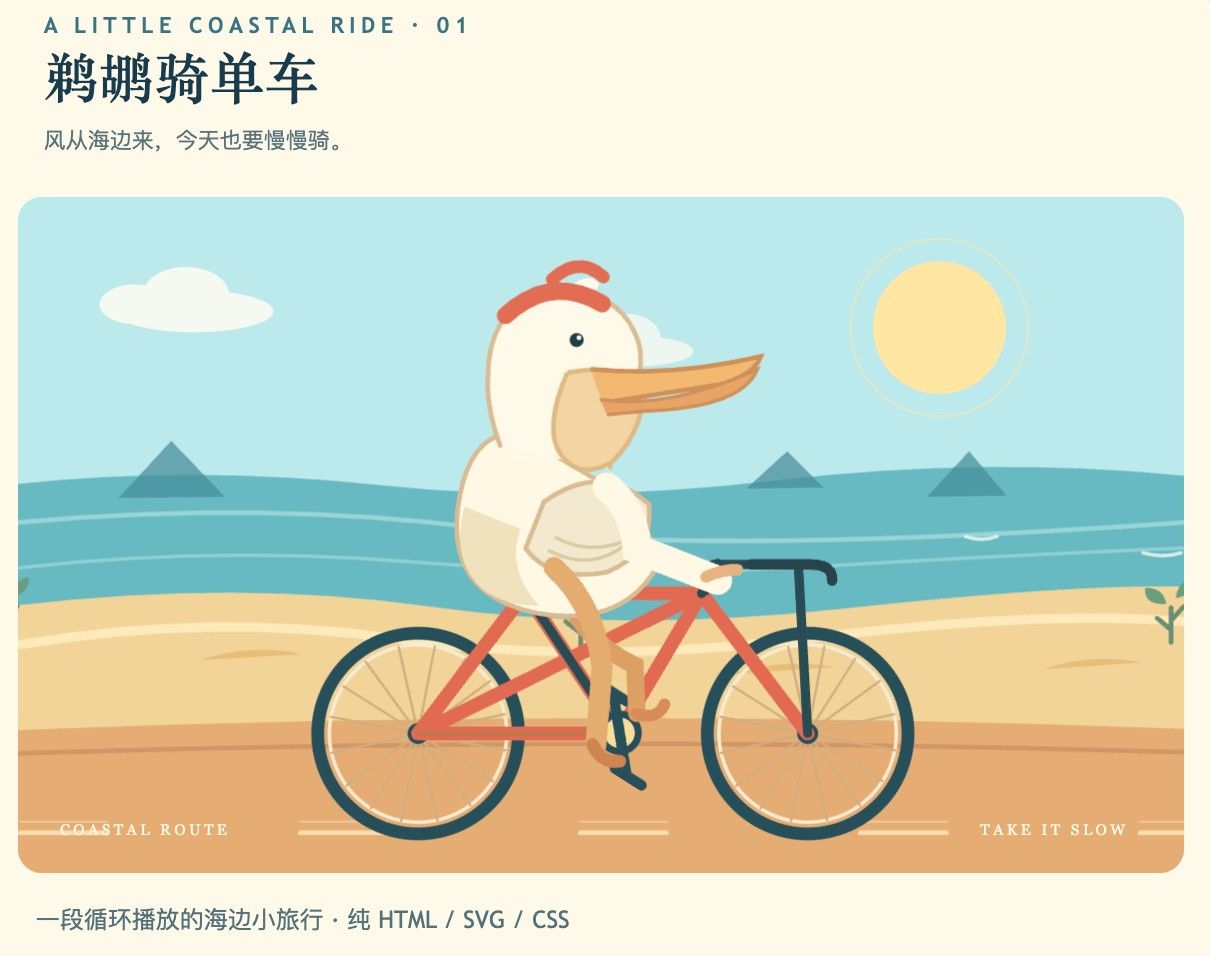
- IQ3_S(本地) — 毫无疑义本地最优,自行车细节准确,翅膀扶车把,但没有掌握前后遮盖关系。
- IQ3_XXS(本地) — 细节明显更少,似乎掌握了鹈鹕嘴的特征,但也没画合上,勉强及格。
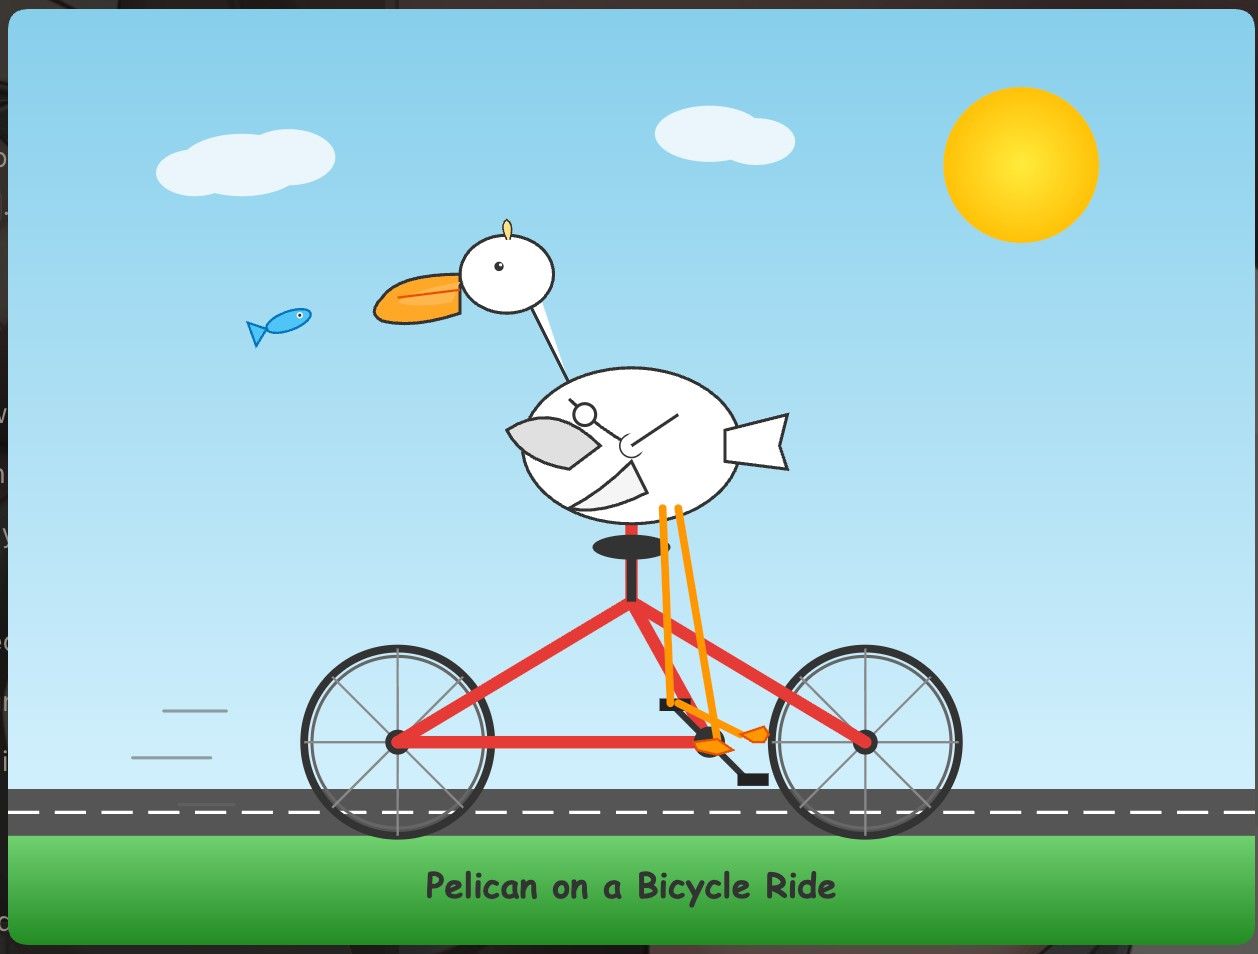
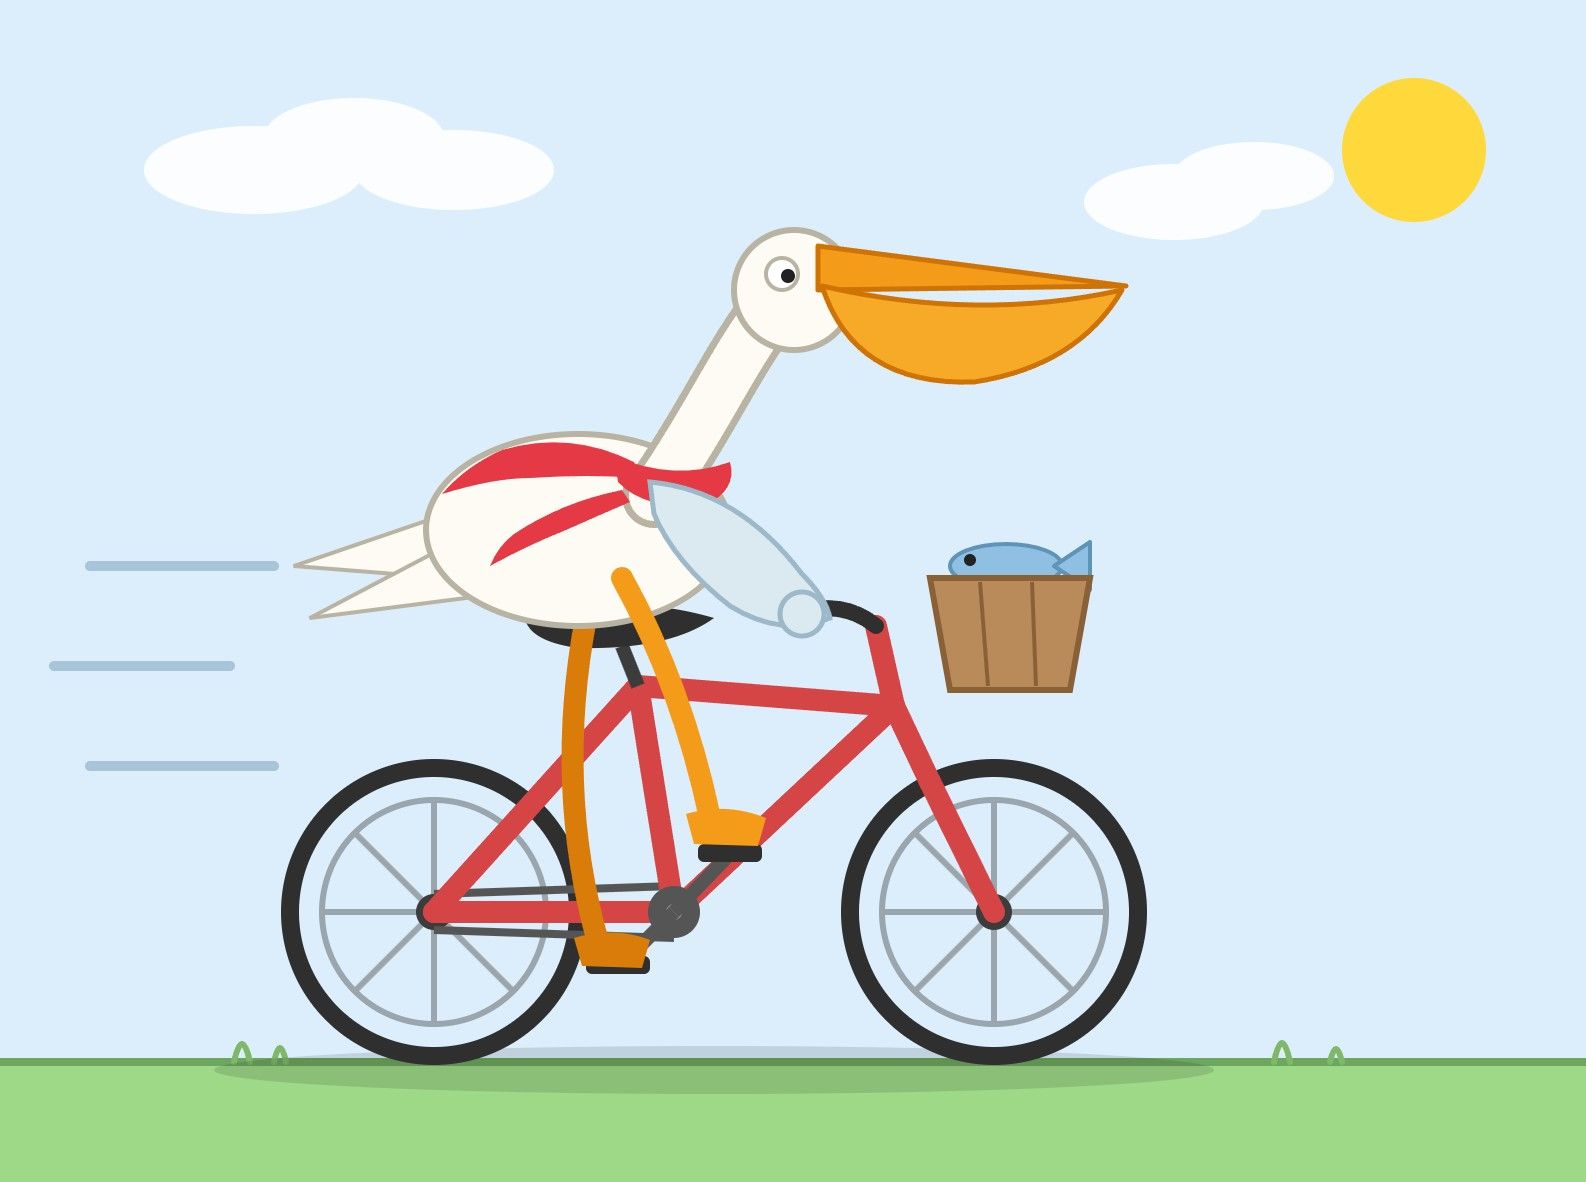
- 27B Q4_K_S(本地) — 干净克制、构图居中、带文字标题。
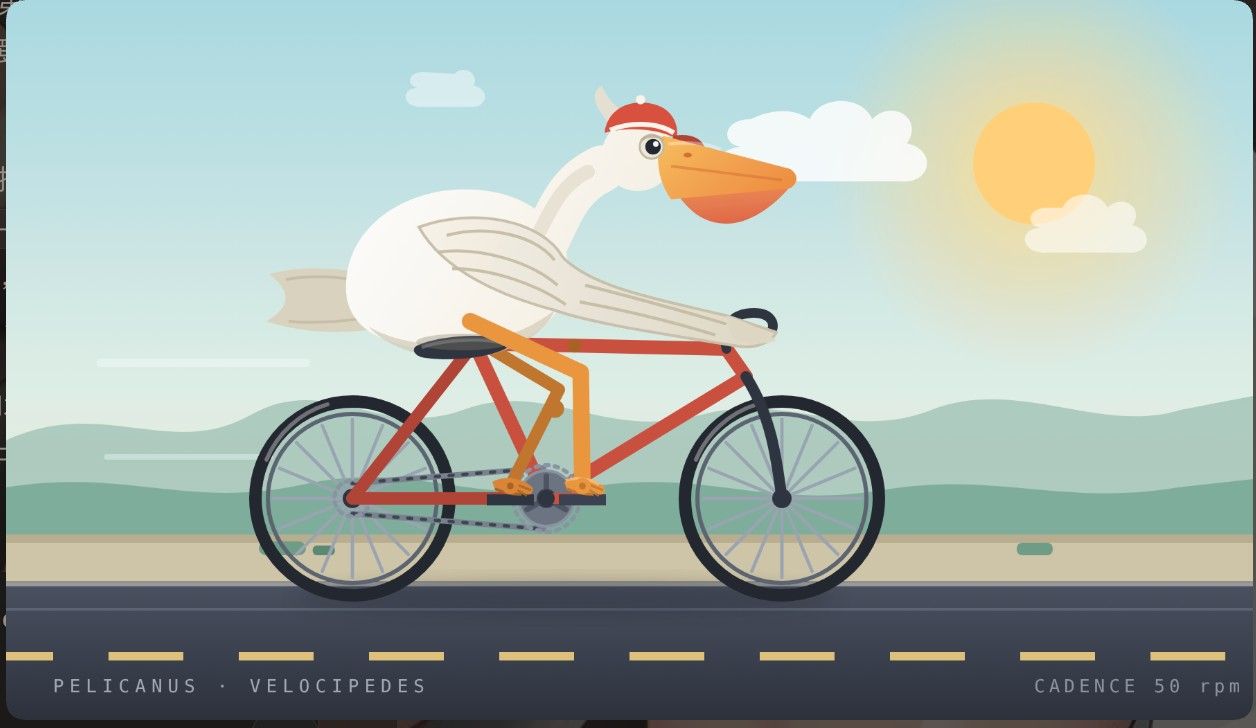
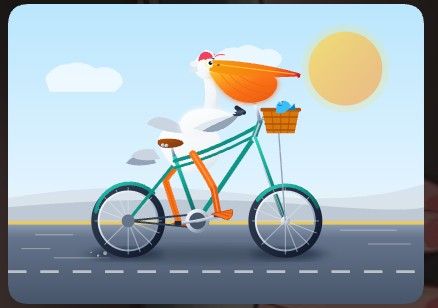
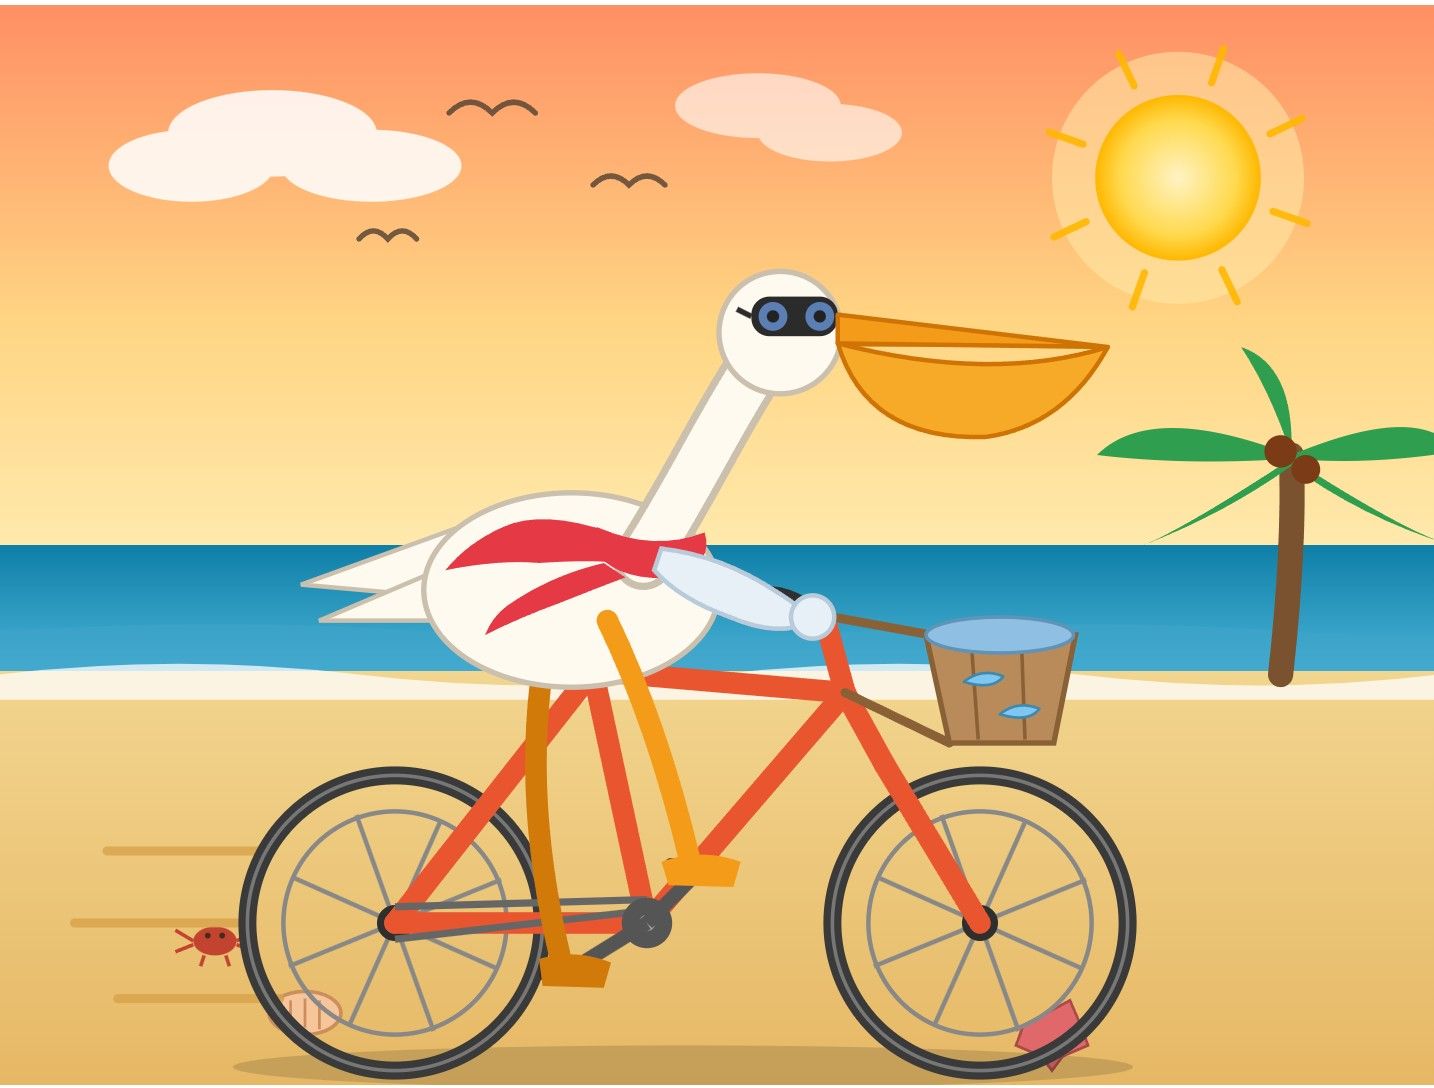
<path>仅 13 个,细节最少,脚与脚踏关系含糊。勉强能算“鸟骑自行车”吧。 - 阿里官方(在线) — 全场最强,细节最丰富:戴头盔、红围巾、远山、云、虚线柏油路、扬尘。缺点:整了些莫名其妙的,帽子红领巾之类,属实是自行发挥了。
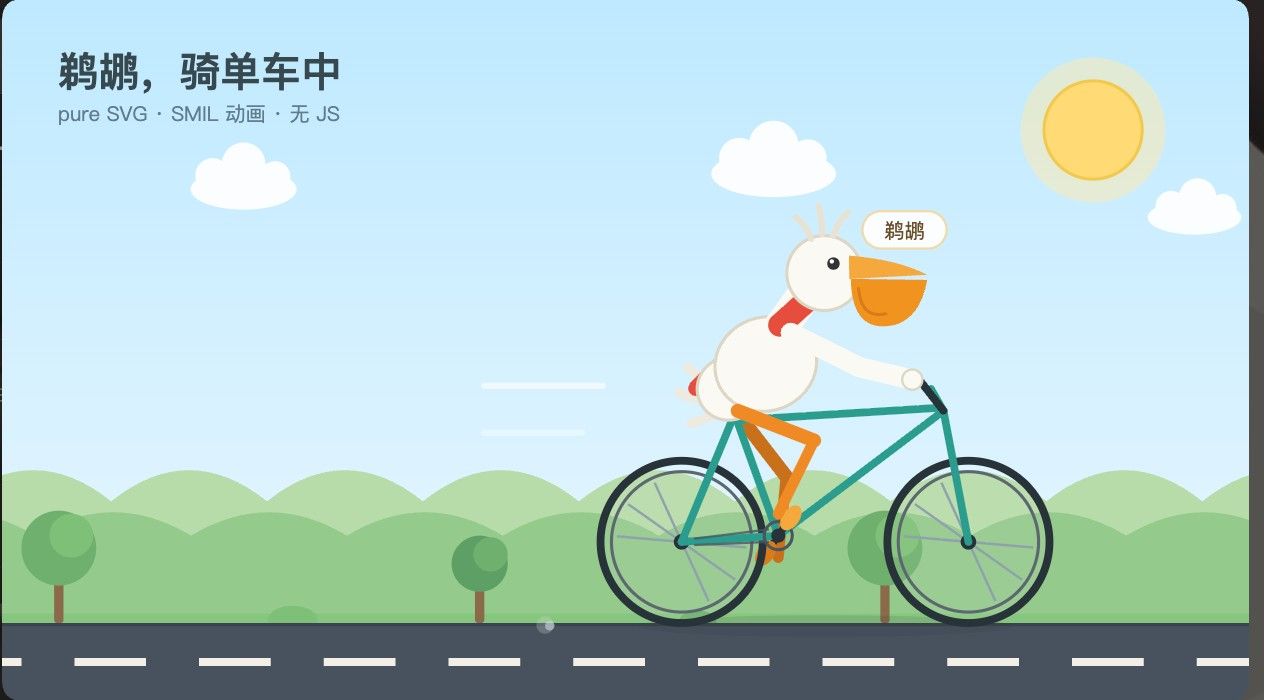
- DeepSeek v4.1(在线) — 可能是deepseek搞多模态比较晚,训练预料不够的原因,细节偏简单,比27b稍强,勉强跟iq3_xxs坐一桌。
3.4 token 构成
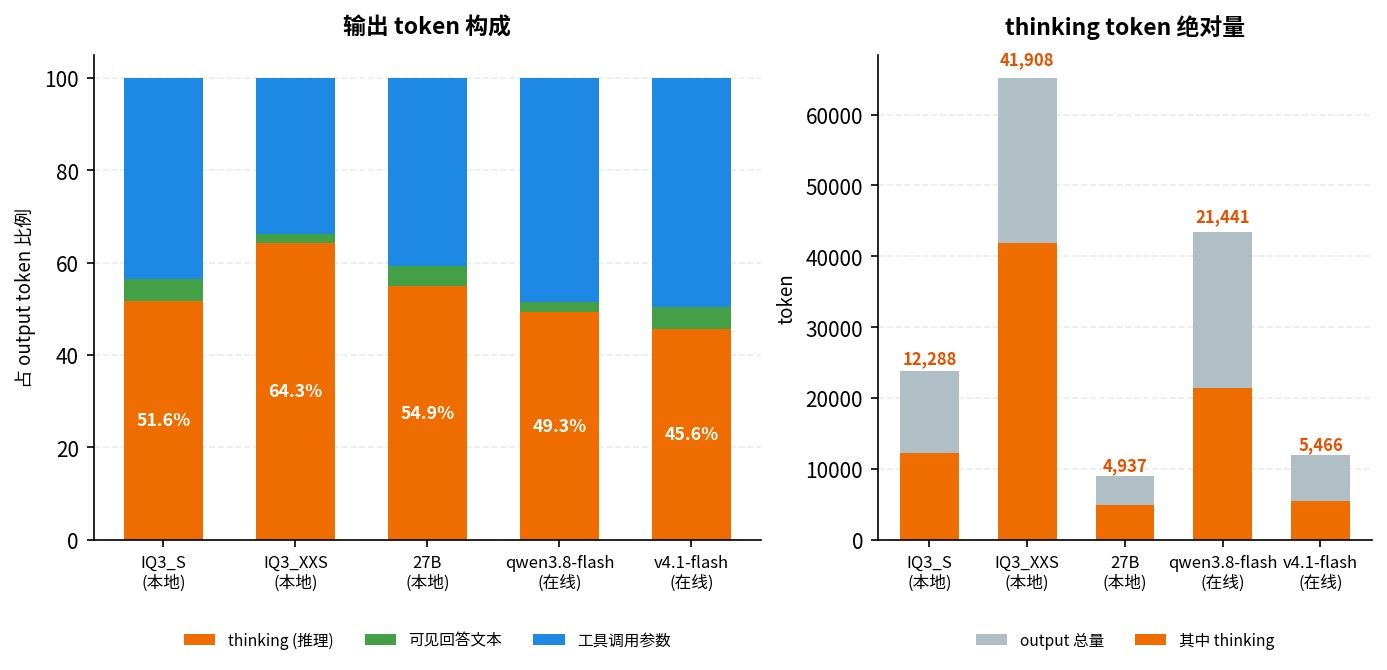
模型 turn 1 耗时 step 数 工具调用 全程 input 全程 output IQ3_S 本地 307.5 s 19 21 16,755 23,814 IQ3_XXS 本地 741.5 s 34 36 17,365 65,175 27B Q4_K_S 本地 202.2 s 8 8 11,144 8,993 阿里官方 489.5 s 23 27 81,170 43,491 DeepSeek v4.1 56.4 s 15 17 6,073 11,986 端到端耗时由输出长度主导,而非速度。 本地最慢的 IQ3_XXS 不是因为卡慢,而是因为它写了 2.7 倍的 token。
4. 问题二:量化的损失
4.1 IQ3_S vs IQ3_XXS:同模型对照
指标 IQ3_S IQ3_XXS 解读 权重体积 ~79 GB ~71 GB 省 10% decode 71.8 tok/s 88.0 tok/s 快 23% prefill(短) 1,044 tok/s 1,195 tok/s 快 14% 冷启动 TTFT 8,745 ms 7,643 ms 快 13% 全程 output 23,814 65,175 多 174% thinking 占比 51.6% 64.3% 高 12.7 pt 自纠正编辑 2 4 更多打磨 渲染验证 6 11 更多打磨 turn 1 端到端 307.5 s 741.5 s 慢 2.4× 4.2 三个层次的损失
第一层:推理节制性(最严重)。 IQ3_XXS 输出的 thinking token(41,921)超过 IQ3_S 的全部输出(23,814)达 76%。量化后的模型似乎更难"想够了就停"。这是本轮量化最明确的损失。
第二层:端到端效率(由第一层导致)。 速度提升 14–23%,但输出量增加 174%,净结果是端到端慢 2.5 倍。单看 tok/s 会得出完全错误的结论。
第三层:产出质量(无明显损失)。 两个 artifact 同级,IQ3_XXS 细节甚至略多。量化没有损害产出质量 —— 至少在这个任务上、这一次运行中。
4.3 交叉印证:27B Q4_K_S
另一个 aggressive 量化样本(27B 的 4-bit 版)不支持"量化必然导致啰嗦":
指标 IQ3_XXS 27B Q4_K_S 量化等级 IQ3_XXS(更激进) UD-Q4_K_S 全程 output 65,175 8,993 thinking 占比 64.3% 54.9% 自纠正编辑 4 0 turn 1 耗时 741.5 s 202.2 s 27B Q4 输出最少、几乎不反复打磨(0 次编辑、4 次渲染),一次成型且质量合格。说明"量化导致过度推理"与具体模型/量化方案相关,不是普遍规律。
4.4 对部署的含义
- 不要只看 tok/s 选量化。 IQ3_XXS 每 token 更快,但完成同一任务总耗时是 2.5 倍。
- 10% 的体积换 14–23% 的速度,性价比一般。 24 GB 卡装得下 IQ3_S 时,没必要退到 IQ3_XXS。
- 量化损失的是"行为"而非"能力"。 模型仍然会画鹈鹕,只是话变多了。
5. 局限
- n=1。 每模型单次运行,无法区分系统性行为与采样偶然。§4 关于"量化导致啰嗦"的结论尤其需要重复验证。
- 各会话不可严格横向比较 —— prompt 长度、工具次数、输出长度、并发状况均不同;本地三个模型共享同一张 GPU。
- thinking token 为派生指标 —— 会话按
reasoning/text/tool-call分类存储字符数,token 占比由各模型实测字符/token 比(中位 2.38–2.98)换算,非直接测量。 - 本地 prefill 与本次会话无一一对应 —— 1,856/1,980 tok/s 为同配置独立实测值。
- 在线模型 prefill 不可比 —— 缓存命中率 86–98%。
- TTFT 含首 token 固定开销,不等于纯 prefill 时间。
-
-
,
 T terry 固定了此主题
-
-
这几天折腾了好一阵单卡strata,终于调优到了理想水平(pp1800, tg60-90)之后,略感空虚,整了点活,水一篇哈哈。
TDLR:单卡内存够的情况下,在视觉相关任务上(前端、客户端开发),strata生成质量明显高于27b,无脑选择IQ3_S。
量化更激进的模型跑的更快,但实际执行任务的时间更长,原因包括雷霆大思考流口水,不断返工等等,不值得为了点pp/tg的提升。此外,量化的确牺牲了不少模型对事物的认知和细节,具体可以从下文的报告里看到。
本地模型 vs 在线模型:鹈鹕骑自行车 SVG 生成评测
评测日期: 2026-10-04
测试方式: DeepSeek Harness (DSH) agent,同一句 prompt:Generate an SVG of a pelican riding a bicycle.
硬件: AMD Radeon RX 7900 XTX 24 GB (gfx1100/RDNA3),Ryzen 5 9600X (6C/12T),92 GiB RAM本文回答两个问题:
- 本地模型比在线模型差了些什么?可用性如何?
- 更 aggressive 的量化损失了什么?
1. 结论
问题一:本地模型差了"速度",但没差"质量"
本地模型在质量上不落后。 IQ3_S(7.9 KB)产出的鹈鹕在解剖准确性上优于两个在线模型中的阿里官方,仅次于 DeepSeek v4.1-flash。三者在"能否画出正确的鹈鹕骑自行车"这一核心判据上处于同一档。
差距集中在延迟和吞吐,且分布不均:
维度 本地最优 在线最优 差距 冷启动 TTFT 7,643 ms 807 ms 9.5× 预热 TTFT 411 ms 750 ms 本地反超 1.8× decode 吞吐 88 tok/s 279 tok/s 3.2× 短 prompt prefill 1,195 tok/s 不可比(缓存) — 关键发现:预热之后,本地模型的 TTFT 反而比在线更快(411 ms vs 750 ms),因为本地没有网络往返。真正输的只有 decode 吞吐(约 1/3.2)和冷启动的首次加载。
可用性判断:
- 交互式使用:可用。 预热 TTFT 0.4–0.8 s、decode 44–88 tok/s,与在线模型的体验差距主要在长输出的生成速度上(等 30 s vs 等 10 s 量级),而非响应手感。
- 冷启动:唯一的硬伤。 首次请求需 7.6–9.8 s,之后不再出现。
- 质量:完全可用。 本地模型产出与在线旗舰同档,且本轮没有任何一个模型出现明显错误。
问题二:更 aggressive 的量化,损失的主要是"推理节制性"
IQ3_S → IQ3_XXS 是同一模型的两次量化,构成直接对照组。体积只小 10%,但行为差异显著:
指标 IQ3_S IQ3_XXS 变化 权重体积 ~79 GB ~71 GB −10% decode 吞吐 71.8 tok/s 88.0 tok/s +23% 短 prompt prefill 1,044 tok/s 1,195 tok/s +14% 冷启动 TTFT 8,745 ms 7,643 ms −13% 全程 output token 23,814 65,175 +174% thinking 占比 51.6% 64.3% +12.7 pt SVG 自纠正编辑 2 次 4 次 +2 SVG 渲染验证 6 次 11 次 +5 量化省下 10% 的体积,换来 14–23% 的速度提升 —— 但代价是推理变得不节制: IQ3_XXS 输出了 2.7 倍的 token,其中 thinking 占比升到 64.3%。它单独产出的 41,921 个 thinking token 比 IQ3_S 的全部输出(23,814)还多 76%。
净效果是负的: IQ3_XXS 的 turn 1 端到端耗时 741.5 s,是 IQ3_S(307.5 s)的 2.4 倍。速度提升被过度推理完全吃掉。
产出质量没有损失 —— 两者同级,IQ3_XXS 的打磨次数甚至更多(自纠正 4 次 vs 2 次、渲染验证 11 次 vs 6 次),说明它更愿意反复迭代,但多花的成本没有转化为可见的质量收益。
这是单次运行的观察,n=1。 "IQ3_XXS 更啰嗦"可能是量化导致的系统性行为偏移,也可能是本次采样偶然。要确认需要多次重复实验。
2. 被测模型
# 模型 部署 量化 HuggingFace 仓库 / 权重 artifact 1 Qwen3.8-Flash-Next 本地 Strata (HIP/gfx1100) IQ3_S ISTA-DASLab/…-GSQ-RCO-GGUF @ 2a55d759<br>…IQ3_S-00001/00002-of-00002.gguf/tmp/local_iq3/2 Qwen3.8-Flash-Next 本地 Strata (HIP/gfx1100) IQ3_XXS 同上仓库 @ 2a55d759<br>…IQ3_XXS-00001/00002-of-00002.gguf/tmp/iq3_xxs/3 Unsloth Qwen3.8-27B 本地 llama.cpp UD-Q4_K_S(14.3 GiB)unsloth/Qwen3.8-27B-GGUF @ 14370d1b/tmp/27b/4 阿里官方 qwen3.8-flash 在线 API — 阿里云百炼 qwen3.8-flash/tmp/qwen-official/5 DeepSeek v4.1-flash 在线 API — deepseek-official/deepseek-flash(1M ctx)/tmp/deepseekv41/模型 1/2 是同一模型的不同量化,构成本文问题二的对照组。
3. 问题一:本地 vs 在线
3.1 延迟
冷启动本地慢 3–4 倍,预热后本地反超。 本地三个模型的预热 TTFT(411–787 ms)全部优于阿里官方(2,083 ms),27B 甚至优于 DeepSeek(411 vs 750 ms)。原因是本地无网络往返,而在线模型每次请求都要跑完整 RTT。
本地模型的冷启动降幅达 11–24 倍,说明主要成本是首次加载(expert cache 预热、首个 verify window 建立),而非推理本身。在线模型冷/预热差异仅 1.1–1.2 倍,因其服务端始终处于热态。
3.2 吞吐
decode 是本地唯一稳定落后的维度:44–88 tok/s vs 在线 105–279 tok/s。差距比 prefill 小得多,且对交互体验的影响主要是长输出时的等待时长。但是考虑到一个27G的本地显卡可以达到阿里官方API 70%的速度,可以说并不差了。
prefill 无法公平比较: 两个在线模型的首步输入分别有 98% 和 86% 命中服务端缓存,其 TTFT 反映缓存读取而非计算。三个本地模型无缓存命中,是真实 prefill:
模型 prefill 说明 IQ3_S 1,044 tok/s 真实(短 prompt) IQ3_XXS 1,195 tok/s 真实(短 prompt) 27B Q4_K_S 991 tok/s 真实(短 prompt) 阿里官方 ️ 不可比98% 缓存命中 DeepSeek v4.1 ️ 不可比86% 缓存命中 长 prompt(33K 全新)下本地可达 1,856–1,980 tok/s,为短 prompt 值的 1.8–2.0 倍。
3.3 质量
五个 artifact 并排对比(上排为本地模型,下排为在线模型;按各自原生画布尺寸渲染):
模型 字节 元素 <path>transform可访问性 IQ3_S 本地 7,936 89 37 3 IQ3_XXS 本地 8,214 86 28 0 27B Q4_K_S 本地 6,244 86 13 1 阿里官方 12,292 120 56 10 DeepSeek v4.1 8,924 90 20 9 所有 artifact 按各自原生画布尺寸渲染(IQ3_XXS 640×480,其余 800×600),不作缩放比较。
目视评估:
- IQ3_S(本地) — 毫无疑义本地最优,自行车细节准确,翅膀扶车把,但没有掌握前后遮盖关系。
- IQ3_XXS(本地) — 细节明显更少,似乎掌握了鹈鹕嘴的特征,但也没画合上,勉强及格。
- 27B Q4_K_S(本地) — 干净克制、构图居中、带文字标题。
<path>仅 13 个,细节最少,脚与脚踏关系含糊。勉强能算“鸟骑自行车”吧。 - 阿里官方(在线) — 全场最强,细节最丰富:戴头盔、红围巾、远山、云、虚线柏油路、扬尘。缺点:整了些莫名其妙的,帽子红领巾之类,属实是自行发挥了。
- DeepSeek v4.1(在线) — 可能是deepseek搞多模态比较晚,训练预料不够的原因,细节偏简单,比27b稍强,勉强跟iq3_xxs坐一桌。
3.4 token 构成
模型 turn 1 耗时 step 数 工具调用 全程 input 全程 output IQ3_S 本地 307.5 s 19 21 16,755 23,814 IQ3_XXS 本地 741.5 s 34 36 17,365 65,175 27B Q4_K_S 本地 202.2 s 8 8 11,144 8,993 阿里官方 489.5 s 23 27 81,170 43,491 DeepSeek v4.1 56.4 s 15 17 6,073 11,986 端到端耗时由输出长度主导,而非速度。 本地最慢的 IQ3_XXS 不是因为卡慢,而是因为它写了 2.7 倍的 token。
4. 问题二:量化的损失
4.1 IQ3_S vs IQ3_XXS:同模型对照
指标 IQ3_S IQ3_XXS 解读 权重体积 ~79 GB ~71 GB 省 10% decode 71.8 tok/s 88.0 tok/s 快 23% prefill(短) 1,044 tok/s 1,195 tok/s 快 14% 冷启动 TTFT 8,745 ms 7,643 ms 快 13% 全程 output 23,814 65,175 多 174% thinking 占比 51.6% 64.3% 高 12.7 pt 自纠正编辑 2 4 更多打磨 渲染验证 6 11 更多打磨 turn 1 端到端 307.5 s 741.5 s 慢 2.4× 4.2 三个层次的损失
第一层:推理节制性(最严重)。 IQ3_XXS 输出的 thinking token(41,921)超过 IQ3_S 的全部输出(23,814)达 76%。量化后的模型似乎更难"想够了就停"。这是本轮量化最明确的损失。
第二层:端到端效率(由第一层导致)。 速度提升 14–23%,但输出量增加 174%,净结果是端到端慢 2.5 倍。单看 tok/s 会得出完全错误的结论。
第三层:产出质量(无明显损失)。 两个 artifact 同级,IQ3_XXS 细节甚至略多。量化没有损害产出质量 —— 至少在这个任务上、这一次运行中。
4.3 交叉印证:27B Q4_K_S
另一个 aggressive 量化样本(27B 的 4-bit 版)不支持"量化必然导致啰嗦":
指标 IQ3_XXS 27B Q4_K_S 量化等级 IQ3_XXS(更激进) UD-Q4_K_S 全程 output 65,175 8,993 thinking 占比 64.3% 54.9% 自纠正编辑 4 0 turn 1 耗时 741.5 s 202.2 s 27B Q4 输出最少、几乎不反复打磨(0 次编辑、4 次渲染),一次成型且质量合格。说明"量化导致过度推理"与具体模型/量化方案相关,不是普遍规律。
4.4 对部署的含义
- 不要只看 tok/s 选量化。 IQ3_XXS 每 token 更快,但完成同一任务总耗时是 2.5 倍。
- 10% 的体积换 14–23% 的速度,性价比一般。 24 GB 卡装得下 IQ3_S 时,没必要退到 IQ3_XXS。
- 量化损失的是"行为"而非"能力"。 模型仍然会画鹈鹕,只是话变多了。
5. 局限
- n=1。 每模型单次运行,无法区分系统性行为与采样偶然。§4 关于"量化导致啰嗦"的结论尤其需要重复验证。
- 各会话不可严格横向比较 —— prompt 长度、工具次数、输出长度、并发状况均不同;本地三个模型共享同一张 GPU。
- thinking token 为派生指标 —— 会话按
reasoning/text/tool-call分类存储字符数,token 占比由各模型实测字符/token 比(中位 2.38–2.98)换算,非直接测量。 - 本地 prefill 与本次会话无一一对应 —— 1,856/1,980 tok/s 为同配置独立实测值。
- 在线模型 prefill 不可比 —— 缓存命中率 86–98%。
- TTFT 含首 token 固定开销,不等于纯 prefill 时间。
-
-
-
-
-
-
,系统 取消固定了此主题
-
-
-
-

 我帖子写了一大半,大佬你给整出这么优秀一篇稿子,比我详细,比我彻底,比我科学,还别我的排版好看