
MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现
-
MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现
硬件环境(8×Tesla T10 16GB / RTX 3080 Ti 12GB / RX 7900 XTX 24GB | 双机 10GbE DAC 直连 | ComfyUI + Raylight + xFuser)
MiniMax H3 是目前开源视频生成领域在动态质量、主体一致性与运镜表现上非常亮眼的扩散模型(DiT)。但它的本地部署门槛极高:模型参数量大(主 DiT INT8 约 20GB,Qwen3-VL 32B 条件编码器约 15GB,再加上 VAE 与 LoRA),单张 16GB 显存显卡在长视频或多模型加载时显存容易见顶;即使是 24GB 显存的大卡(例如单张 RX 7900 XTX)虽然跑 10 秒(736×1280)完全不会 OOM,但单卡生成一条往往需要近 14 分钟(实测约 860 秒),单卡串行吞吐遇到明显瓶颈;而如果让没有专用新架构单元的老旧计算卡去硬跑密集的视频 VAE 解码,速度又非常缓慢。
我们在本地通过两台局域网主机搭建了一套**“多卡分布式并行采样 + 10GbE 跨机高速传输 Latent + 独立消费级显卡专用 VAE 解码”**的异构流水线,成功在二手图灵老卡(Tesla T10,单卡仅 16GB 显存,类似半高版 RTX 2080 Ti)与消费级显卡(RTX 3080 Ti 12GB、RX 7900 XTX 24GB)之间实现了高效协同。
完整调度代码、工作流模板与复现补丁已开源:
 GitHub 仓库:https://github.com/peterhon168/h3-multigpu-pipeline
配套离线发布包:h3-multigpu-production-release-20261003.zip
实测视频:https://youtu.be/fUTG5CveZ9k本文记录完整的单任务时延、长视频容量极限、6 任务批处理吞吐矩阵、图灵架构(SM75)补丁细节与踩坑指南。所有命令与数据均来自真实工程实测。
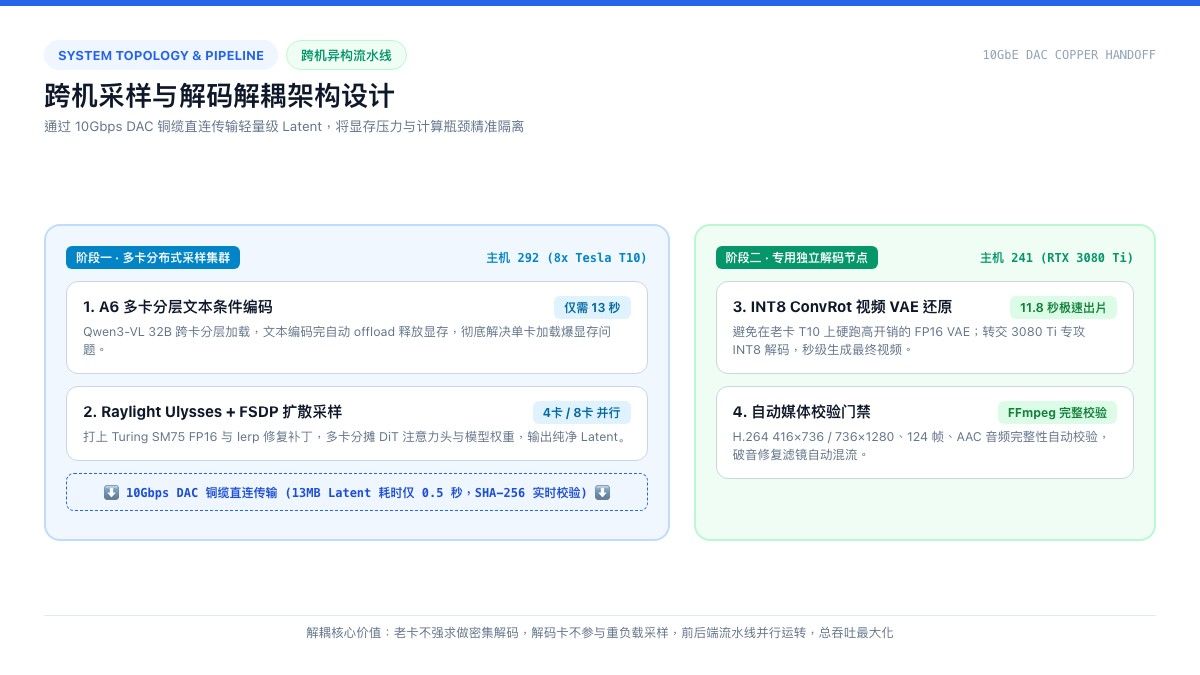
一、先看结果:单任务、长视频容量与批量吞吐数据
0. 为什么必须解耦?对比单机(不带 3080 Ti)历史实测
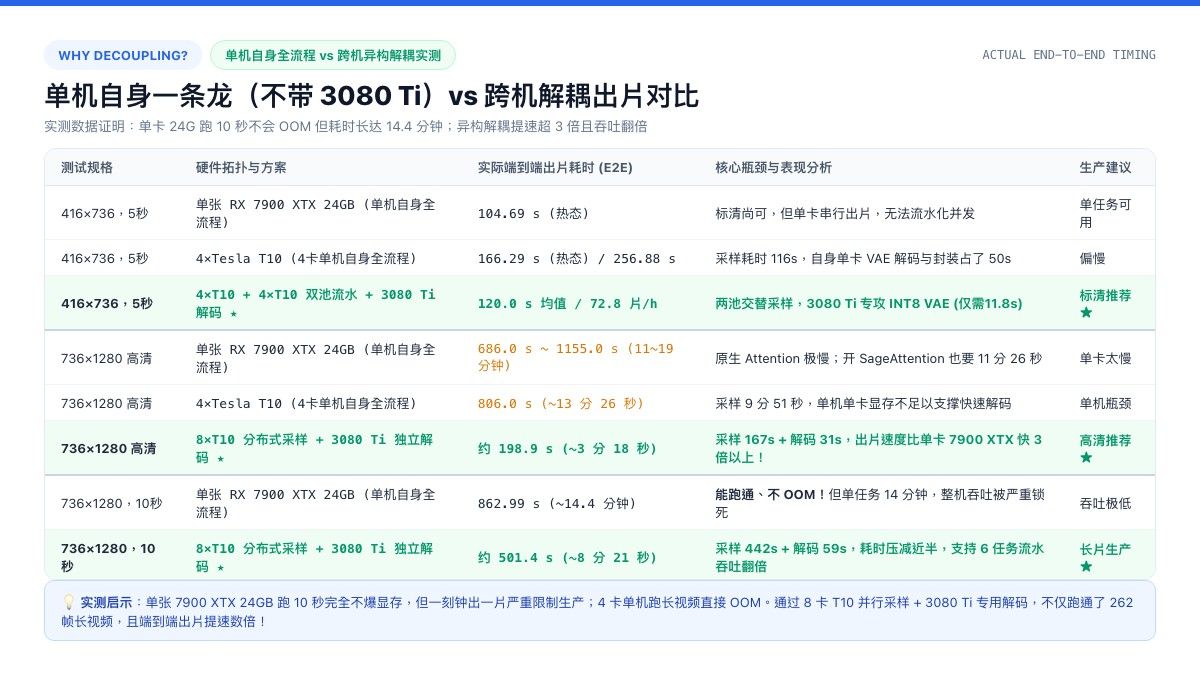
在做这套异构解耦之前,我们在两台主机上分别测过单机跑完全部流程(自身采样 + 自身解码,不接入 3080 Ti)的表现。正是这些痛点数据直接推动了我们做架构分工:
运行平台与方案 视频规格 实际端到端耗时 (E2E) 核心瓶颈与表现 单张 RX 7900 XTX 24GB (单卡自身全流程) 416×736,5 秒 104.69 s (热态) 标清尚可,但无法并行出片 单张 RX 7900 XTX 24GB (单卡自身全流程) 736×1280,5 秒 686.00 s ~ 1155.00 s (11~19 分钟) 原生 Attention 极慢;开启 SageAttention 也要 11 分 26 秒 单张 RX 7900 XTX 24GB (单卡自身全流程) 736×1280,10 秒 (243帧) 862.99 s (~14.4 分钟) 能跑通、不 OOM,但单任务太慢,整机吞吐被严重锁死 G292 4×Tesla T10 (4卡单机自身全流程) 416×736,5 秒 166.29 s (热态) / 256.88 s (冷态) 采样约 116 秒,但单机 VAE 解码与封装占了 50 秒 G292 4×Tesla T10 (4卡单机自身全流程) 736×1280,5 秒 806.00 s (~13 分 26 秒) 采样 9 分 51 秒,单机单卡显存不足以支撑快速解码 G292 8×Tesla T10 (同机单 T10 硬解既有 Latent) 736×1280,5 秒 仅解码尾段就占 72.59 s 缺乏专用量化解码器,单 T10 FP16 VAE 耗时是 3080 Ti 的 2.3 倍 数据对比直观结论:
- 单张 7900 XTX 24GB 跑 10 秒(736×1280)实测需要 14.4 分钟(862.99秒),虽然完全不爆显存,但一个人守在屏幕前等一刻钟出一片,批量生产根本无法维系;
- 4 张 T10 单机自身解码 跑 736×1280 同样长达 13.5 分钟,而且一旦挑战 10 秒长视频在采样阶段就直接 OOM;
- 一旦我们把**“T10 专攻多卡 Ulysses 并行采样 + 3080 Ti 专攻 INT8 VAE 极速解码”**解耦后:
- 5 秒标清端到端直接从 166 秒砍到 120 秒;
- 8 卡跑 736×1280 5 秒采样仅需 167 秒,后方 3080 Ti 解码仅需 31 秒,整条视频出片压到了 3 分多钟(对比单卡 7900 XTX 的 11~19 分钟提速超 3 倍!);
- 10 秒高清视频从单卡 14.4 分钟缩短到 8 分钟出片,并且 6 任务批量出片吞吐直接翻倍。
本轮测试覆盖了单任务冷热启动采样时延、五秒标清六任务吞吐、高档 736×1280 五秒六任务矩阵、15 秒长视频容量边界,以及 10GbE DAC 铜缆直连传输。
采样耗时(提交到 ComfyUI history success)与解码尾段耗时(watcher 接收到 Latent 后到 SaveVideo success)各自独立计时,不能直接混淆或相加。
1. 单任务与长视频容量实测
采样/解码路线 规格尺寸 视频帧数 采样阶段耗时 解码尾段耗时 最终状态与冷热说明 4×T10 采样 → 3080 Ti 416×736,5 秒 124 帧 229.814 s 12.181 s 成功;冷模型首跑 8×T10 采样 → 3080 Ti 416×736,5 秒 124 帧 110.395 s 11.859 s 成功;耗时减少 52.0%(约 2.08× 加速) 8×T10 采样 → 3080 Ti 736×1280,5 秒 124 帧 167.286 s 31.654 s 成功;暖态稳定出片 8×T10 采样 → 3080 Ti 736×1280,10 秒 243 帧 442.110 s 59.319 s 成功;突破旧 4 卡显存极限 8×T10 采样 → 3080 Ti 544×960,15 秒 362 帧 328.725 s 50.405 s 成功;超长视频稳定出片 8×T10 采样 → 3080 Ti 640×1152,15 秒 — 约 204.389 s 后 OOM — 失败;探出当前 8 卡配置的物理容量极限 同机单 T10 硬解既有 Latent 736×1280,5 秒 124 帧 不适用 72.588 s 成功但缓慢;单 T10 FP16 VAE 耗时是 3080 Ti 的 2.3 倍 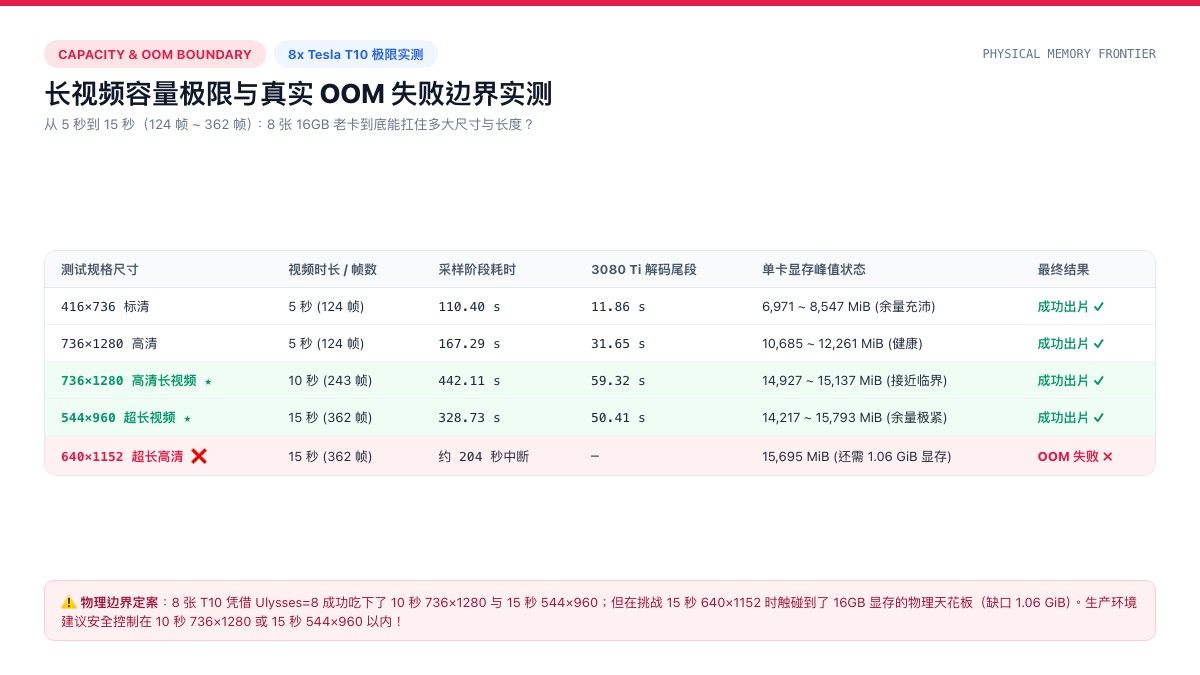
关键容量结论:
- 416×736、5 秒冷模型请求从 4 卡的 229.8 秒降至 8 卡的 110.4 秒,加速约 2.08 倍,证明 8 卡分布式能显著压低单任务等待。
- 8 卡成功拿下了 10 秒 736×1280(243 帧)与 15 秒 544×960(362 帧)长视频,解决了过去 4 卡运行长视频直接 OOM 的痛点。
640×1152 / 15 秒在运行约 204 秒后发生真实的torch.OutOfMemoryError:单卡 rank 还需 1.06 GiB 显存,但当时仅余 558.62 MiB,堆栈位于 MiniMax MLP/LoRA 路径。这划定了当前这套 6 步 Euler/simple 架构的物理显存天花板。
2. 连续 6 任务批处理吞吐矩阵(连续出片拓扑选择)
单任务时延低不代表批量吞吐高。我们固定 6 个随机种子(
987654321123–128),对比了不同集群拓扑在相同任务批次下的表现: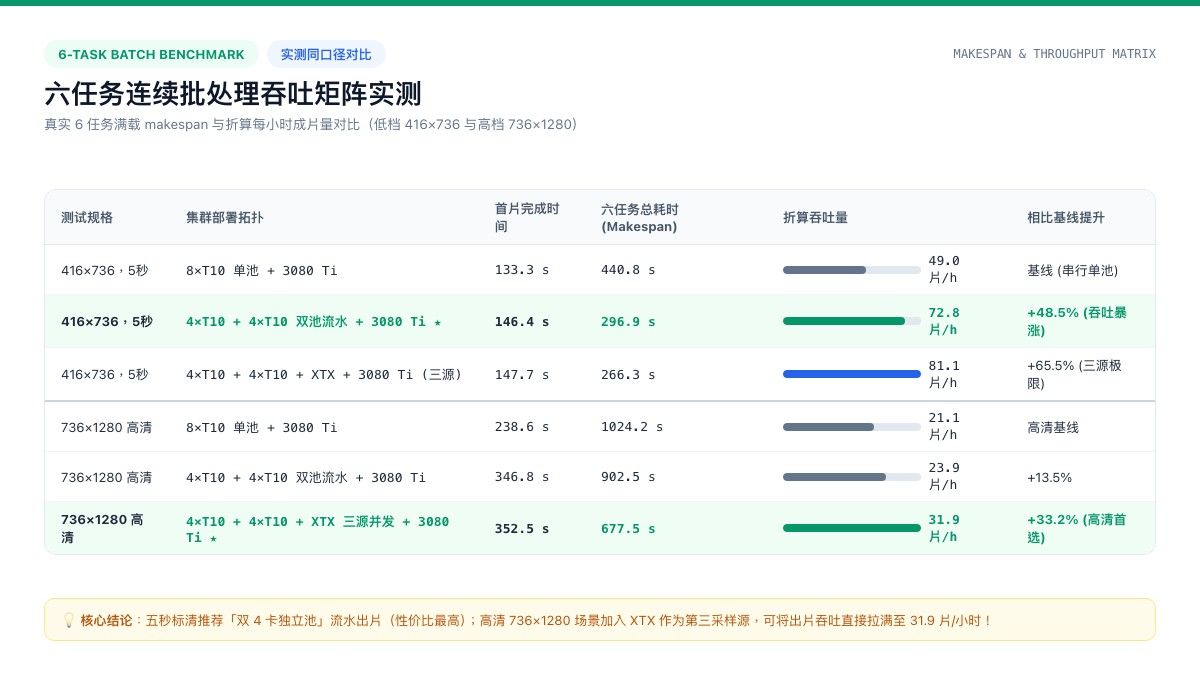
规格 集群部署拓扑 成功数 首片完成时间 六任务总耗时 (Makespan) 折算批次吞吐 416×736,5 秒 8×T10 单池串行 + 3080 Ti 6/6 133.314 s 440.791 s 49.00 片/小时 416×736,5 秒 4×T10 + 4×T10 双池并行流水 + 3080 Ti ★ 6/6 146.396 s 296.917 s 72.75 片/小时 (+48.5%) 416×736,5 秒 4×T10 + 4×T10 + XTX 三源并发 + 3080 Ti 6/6 147.707 s 266.324 s 81.10 片/小时 (+65.5%) 416×736,5 秒 8×T10 + XTX 双源并发 + 3080 Ti 6/6 136.910 s 332.706 s 64.92 片/小时 (+32.5%) 736×1280 高清 8×T10 单池串行 + 3080 Ti 6/6 238.642 s 1024.217 s 21.09 片/小时 736×1280 高清 8×T10 + XTX 双源并发 + 3080 Ti 6/6 241.279 s 945.328 s 22.85 片/小时 736×1280 高清 4×T10 + 4×T10 双池流水 + 3080 Ti 6/6 346.771 s 902.538 s 23.93 片/小时 736×1280 高清 4×T10 + 4×T10 + XTX 三源并发 + 3080 Ti ★ 6/6 352.477 s 677.538 s 31.88 片/小时 (+33.2%) 批量调度核心发现:
- 5 秒低档出片最佳拓扑:双 4 卡独立池流水(4+4+1)。把 8 张 T10 拆成两个独立的 4 卡并行池轮流出片,共用后端的 3080 Ti 解码队列。虽然第一张成片因分片采样略慢了 13 秒,但后续片子实现完美流水交错,6 片总耗时从 440 秒压至 296 秒,吞吐暴涨 48.5%!
- 增加 XTX 带来的收益分水岭:在 5 秒低档下加入 RX 7900 XTX 组成三源并发,吞吐仅从 72.75 提高到 81.10 片/小时(增幅 11.5%,未达到工程上新增硬件复杂度的 15% 准入门槛);但在 736×1280 高清档下,由于 T10 分布式采样时间变长、后方 3080 Ti 产生闲置等待,加入 XTX 采样能把高清出片总耗时从 902 秒大幅缩减至 677 秒,吞吐提升 33.2%(达到 31.88 片/小时),成为高清批量生产的首选方案。
二、架构设计:算力解耦与 10GbE 跨机轻量交接
为什么要把“采样”和“解码”拆到不同物理主机上跑?除了算力特征的互补,还有一个非常现实且棘手的硬件物理插槽与改造成本约束:
1. 物理层限制:普通平台根本插不下这么多卡
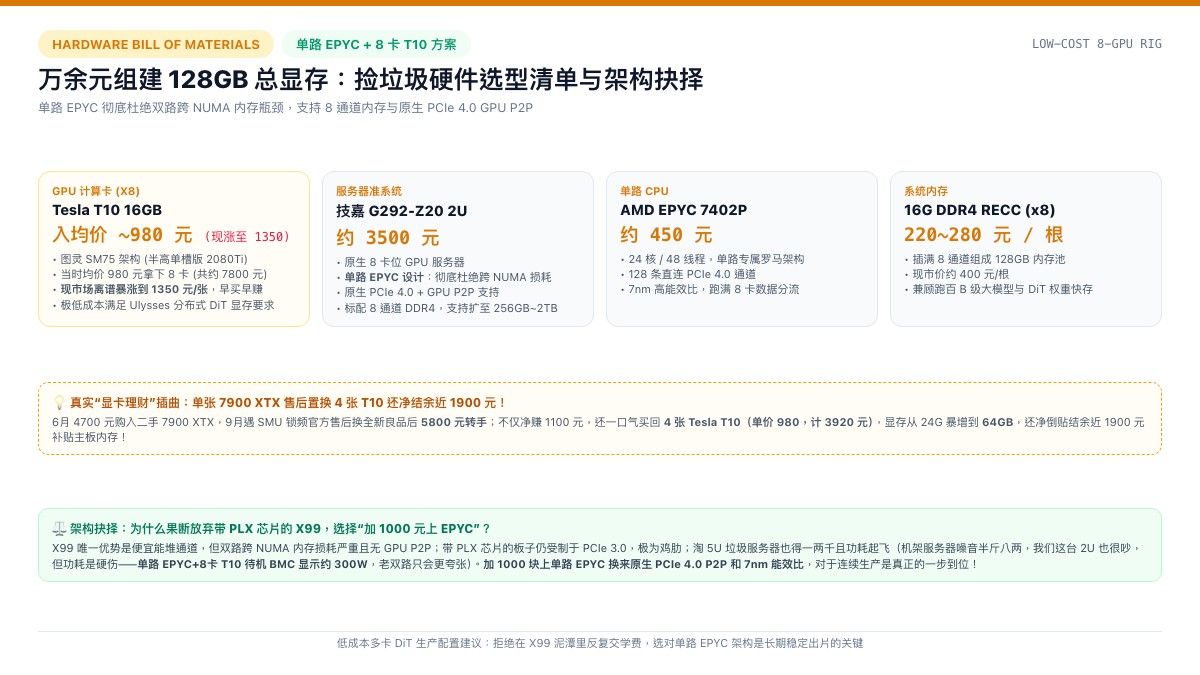
- 关于双路 X99 的真实性价比与选型权衡:
- X99 的唯一核心优势:在于白菜价的同时,能用极低成本堆出相对最多的 PCIe 物理通道(双路至强 v3/v4 理论上总计能提供 80 条 PCIe 3.0 通道);
- 但弊端也极其明显且致命:
- 插槽捉襟见肘:哪怕买到极限的 6 槽直通双路 X99 矿板,通常也就是 4 根 x16 + 2 根 x8,依然插不满 8 卡;
- 跨 NUMA 性能损耗灾难:双路 CPU 之间通过 QPI 总线通信,一旦涉及跨节点的 GPU 显存搬运与内存读取,时延与带宽断崖式下跌;
- 不支持 GPU P2P:图灵卡跑 Ulysses 分布式序列并行时,卡间频繁需要 All-to-All 交换通信,没有点对点硬件支持效率大打折扣;
- 带 PLX 芯片的 X99 板子极其鸡肋:市场上那些卖 800、900 甚至上千元、带 PLX 交换芯片的魔改 X99 家用/矿板,我个人觉得意义非常微弱——底层依然受制于老旧的 PCIe 3.0 协议和高发热的 14nm 至强架构;要是退一步去淘 4U/5U 级的洋垃圾服务器,准系统本身也得一两千,功耗更是直接起飞(要说风扇噪音,机架服务器半斤八两,我们这台 2U 的 G292 准系统也吵得不行,没资格说别人,但双路至强老架构的功耗确实更加爆炸——我们现在这套单路 7nm EPYC + 8 卡 T10,光是开机待机状态,BMC 监控显示功耗就已经在 300W 上下了,要是换老双路洋垃圾只会更夸张)。
- 为什么最终拍板“加 1000 上 EPYC 准系统”:综合算下来,只要多花大约 1000 元(技嘉 G292 二手准系统 3500 元),就能直接跃升到 单路 AMD 罗马架构 EPYC:原生 128 条满血 PCIe 4.0 直连、原生支持 GPU P2P、纯粹的单路单 NUMA 节点、8 通道完整内存吞吐、以及 7nm 带来的极佳待机与满载能效比。这 1000 元的溢价换来的长期稳定性与扩展性,对于要做连续批量视频生产的工程平台来说,性价比远超在 X99 泥潭里打滚折腾!
- 这套极具性价比的“捡垃圾”方案清单:
- 服务器准系统:技嘉 G292-Z20(2U 8卡位 GPU 服务器),二手准系统约 3500 元。它的最大卖点是 单路 AMD EPYC 设计,从物理上杜绝了多 CPU 跨 NUMA 节点的内存搬运痛点;全机原生支持 PCIe 4.0 与 GPU P2P,支持完整的 8 通道内存,标配 8 条内存插槽(普通可上 256GB,特殊配置最高可上 2TB 内存,兼顾了后续跑 120B/百 B 级大语言模型的扩展性)。
- 计算卡选型 (Tesla T10 16GB) 与一段“显卡理财”插曲:
- 我的购买均价大概 980 元/张(图灵架构,类似半高单槽版 RTX 2080 Ti 16G,成色相当不错)。不过现在海鲜市场行情非常离谱,T10 目前已经一路涨价暴涨到了 1350 元/张,简直魔幻!我当时趁着均价 980 的时候 8 张全部拿下也才 7800 元出头,相比买单张全新 4090 或昂贵的专业计算卡,用极低成本直接拉平了 128GB 的巨大分布式显存池。
- 这里还有一个挺有意思的真实回血插曲:我原本在 6 月 3 日以 4700 元收了一张二手 RX 7900 XTX,到了 9 月份碰上经典的 AMD SMU 锁频故障,走官方售后换回了一张全新的官方良品卡。正好碰上行情波动,转手以 5800 元 卖掉。这一进一出不仅白玩了 3 个月还净赚 1100 元,转头拿着这笔钱一口气买回来 4 张 Tesla T10(单价 980,4 张约 3920 元),手里居然还净倒贴结余了近 1900 元!
- 显存与生产力账本算下来非常夸张:一张原本 24GB 显存的消费级单卡,通过这波理财直接置换成了 4×16GB = 64GB 的纯正多卡计算池,甚至还补贴了主板和内存。
- 预判某些杠精可能会杠:“老卡算力弱,你 4 张 T10 能打得赢 1 张满血 7900 XTX 吗?折腾半天是不是负优化?”
- 我们早就拿实测数据正面对比过,事实会狠狠打脸:
- 在 416×736 标清 5 秒下:单张 7900 XTX 跑原生 attention 端到端确实更快(热态约 105 秒 vs 4 卡 T10 的 166 秒,单卡强 1.59 倍);
- 但在 736×1280 近 720p 分辨率下,攻守彻底易形:单张 7900 XTX 跑原生 PyTorch attention 耗时直接暴增至 19 分 15 秒(采样本体 18 分 19 秒)!哪怕强开实验性的 SageAttention,端到端也要 11 分 26 秒,而且显存温度直接飙到 94°C,还伴随同种子构图漂移问题;
- 反观 4 张 T10 单机自身跑 736×1280:采样本体仅需 9 分 51 秒,四卡采样本体速度直接反超单张 7900 XTX 约 3.6%(哪怕对比开 Sage 的 XTX),而且四卡温度稳定在 82°C,构图严密对齐;
- 更致命的降维打击是显存容量与并发:单张 7900 XTX 就算再快,24GB 显存同一时间也只能串行跑一个任务;而置换出的 4 张 T10(64GB 显存池)不仅可以在高分辨率下靠 Ulysses 序列并行把采样本体压进 10 分钟以内,更关键的是——当 8 张 T10 就位后,我们能直接拉起**“双 4 卡独立池”**实现多任务轮流流水线出片,或者直接拼成 8 卡把 5 秒标清采样砍进 110 秒、把 736×1280 采样砍进 167 秒!
- 结论很残酷:只盯单卡单任务的低分辨率跑分,是典型的小白思维;在工业化连续出片的场景下,总显存容量(64G vs 24G)、卡间序列并行通道和多池流水化并发能力,才是决定每天能产出多少条视频的核心胜负手!
- 我们早就拿实测数据正面对比过,事实会狠狠打脸:
- CPU 选型:AMD EPYC 7402P(24核/48线程,单路专属),二手海鲜市场约 450 元,性价比拉满。
- 内存配置:丰俭由人。我们当时装机是均价 220~280 元/根收的单根 16G DDR4 2133/2400 RECC 内存(目前市场价约 400 元/根)。
- 为什么暂时双机解耦:其实 G292-Z20 主板后部还预留了 2 条全高的 PCIe 4.0 插槽,理论上完全能把 241 的两张大卡(RX 7900 XTX / 3080 Ti)也塞进同一台机器。但涉及到机架服务器定制 8pin 供电线改造、重型显卡固定支架和高功耗散热重构,有点折腾且需要额外采购线材。而手头刚好有一条闲置的 10Gbps DAC 铜缆直连线,顺理成章就采用了双机解耦的轻量化方案。
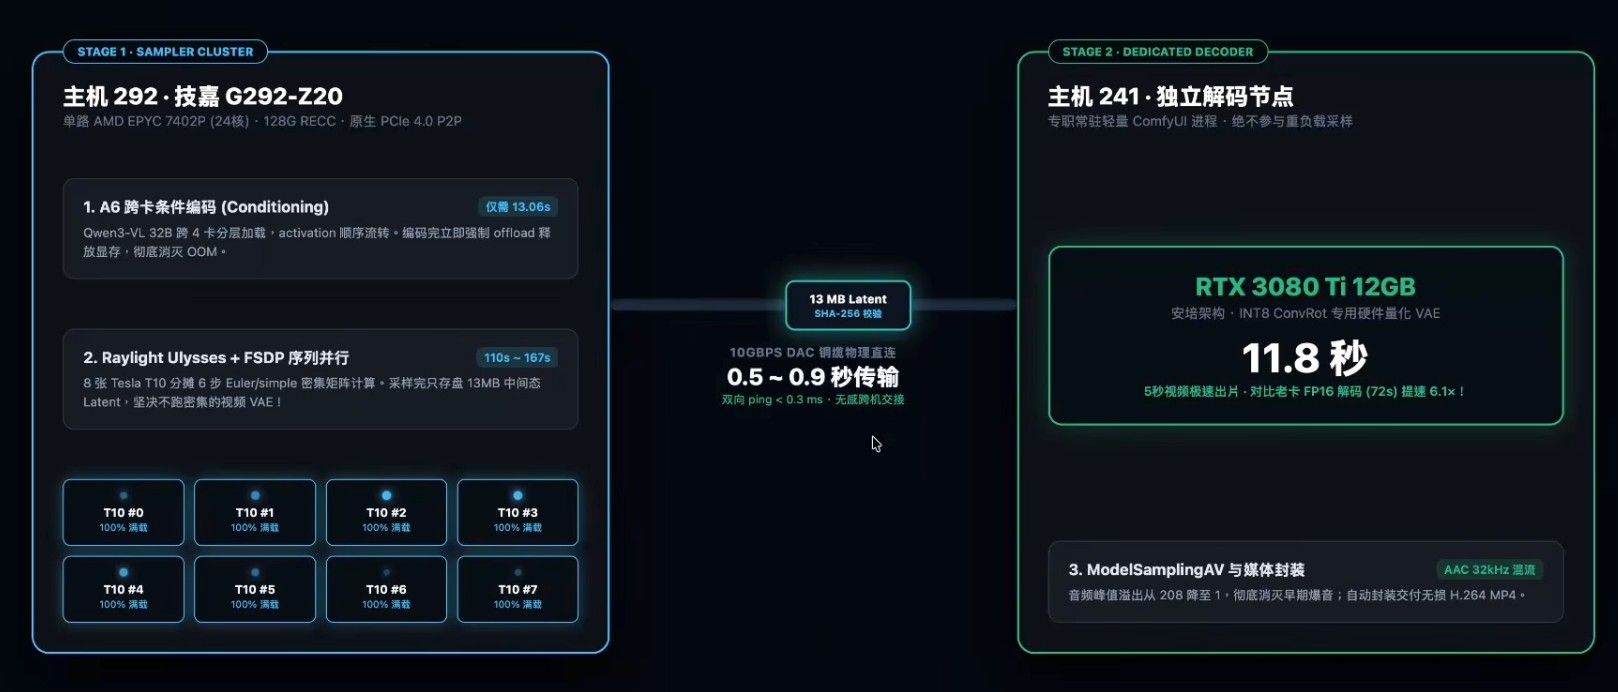
2. 算力与存储架构层面的精准解耦
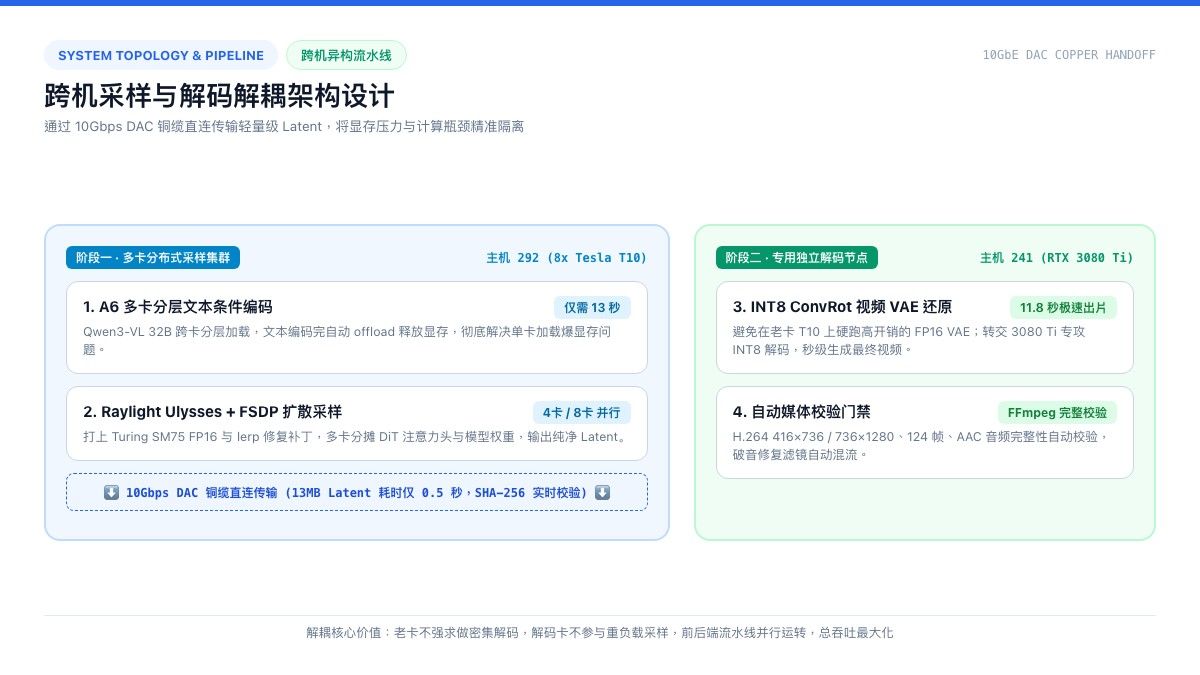
- 图灵老卡(T10)专注于 DiT 张量并行计算:
8 张 Tesla T10(16GB,SM75)通过 Raylight 跑序列并行(Ulysses=4 或 8,FSDP=true)。T10 在密集矩阵计算上效率可观,且通过序列切分避开了大尺寸显存瓶颈。采样结束后,它不需要在本地执行极其耗时、容易引起显存溢出的视频 VAE 还原,而是直接将中间态的 Latent 张量(视频与音频特征,体积仅约 13 MB)存盘。 - 10Gbps DAC 铜缆高速无感交接:
两台主机之间通过专属 10GbE 网卡直连(双向 ping < 0.3 ms)。13 MB 的 Latent 文件通过 SCP/Socket 传输仅需 0.5 ~ 0.9 秒,且附带实时的 SHA-256 完整性哈希校验,通信开销在几十秒的视频生成周期中微乎其微。 - 消费级单卡(RTX 3080 Ti)专精快速 VAE 解码:
后端的 3080 Ti(12GB,安培架构)不需要加载几十 GB 的 DiT 主模型,它只维持一个轻量级的 ComfyUI 实例,专职加载minimax_h3_video_vae_int8_convrot.safetensors。接收到 Latent 后,仅需 11.8 秒 即可完成 5 秒视频的高清解码与 AAC 音视频封装。相比老卡单跑 FP16 VAE 的 72 秒,速度足足快了 6 倍以上!
三、关键基准与补丁说明(技术背景还原)
为了让复刻者能完全独立理解并在相同硬件环境下避坑,这里对几个核心技术基线做完整解释:
1. 什么是“A6 基线”?
我们在测试文档中多次提及的“A6”,是我们在多轮 A/B 测试中沉淀下来的一套基准生产工作流代号(Profile A6)。其核心技术是集成了开源社区(Eanya-Tonic)的
H3MultiGPUCLIPLoader节点:- 原理:Qwen3-VL 32B 文本条件编码器体积庞大,A6 将其视觉模块、Embedding 以及连续的 Transformer Decoder 层分散跨卡放置到 4 张 T10 上,activation 逐卡流水传递。
- 效果:它让新提示词的条件编码(Conditioning)耗时从单卡的 27 秒砍到了 13.06 秒;同时在编码结束后强制执行
offload_after_encode=true与H3_MP_RETAIN_CPU_WEIGHTS=1自动卸载权重释放显存,把珍贵的 16GB 空间完整腾退给接下来的 Raylight FSDP 采样,彻底消除了显存溢出。
2. 图灵架构(SM75)跑 H3 必备的两大补丁
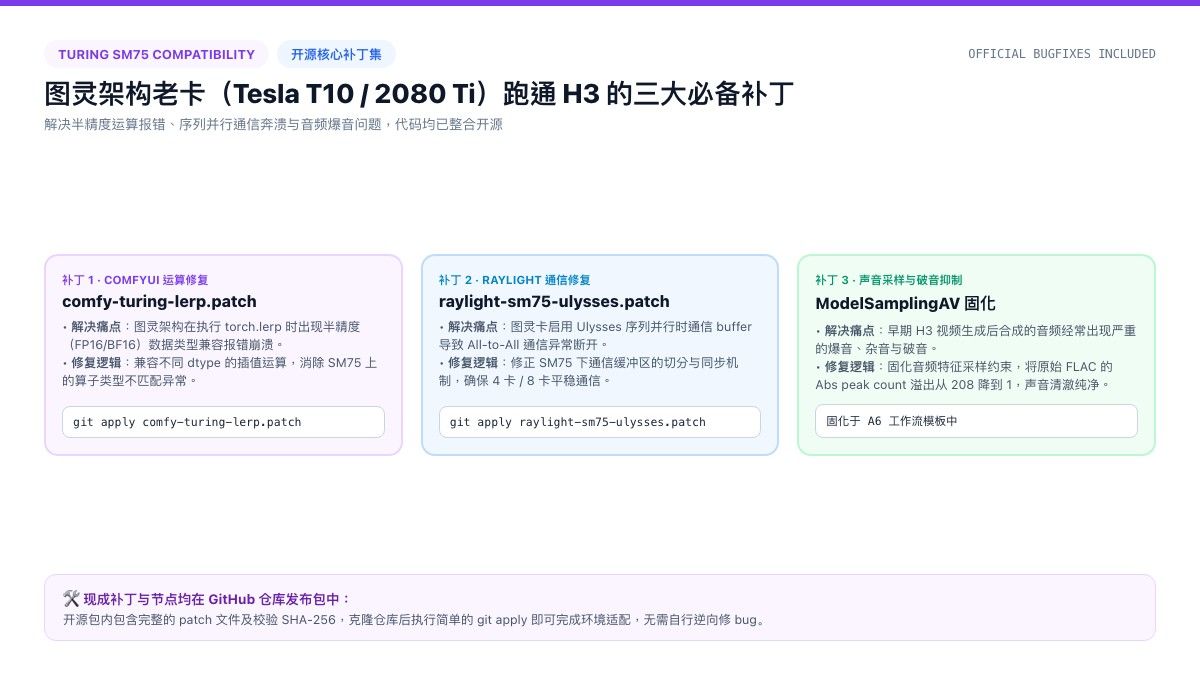
Tesla T10 和 RTX 2080 Ti 属于图灵架构(SM75,计算能力 7.5),直接拉取最新的 ComfyUI 与 Raylight 会遇到半精度运算与序列通信崩溃。开源包中包含了已验证的两项补丁:
comfy-turing-lerp.patch:针对 ComfyUI(基于 commitbdcb886升级到5fa5e05),修复了在 SM75 架构下执行torch.lerp时的半精度(FP16/BF16)数据类型兼容性报错。raylight-sm75-ulysses.patch:针对 Raylight(基于 commit63ae5b8升级到1a4ee4a),修复了图灵卡启用 Ulysses 序列并行时通信 buffer 的 All-to-All 兼容问题。- 音频破音修复:固化了
ModelSamplingAV逻辑,将原始音频 FLAC 的绝对峰值溢出(Abs peak count)从 208 降到 1,彻底解决了早期音频爆音问题。
四、固定配置、环境版本与模型规格
为保证数据可严格复核,测试期间固定的环境基线如下:
- 主模型与 LoRA:
主 DiT:10Eros_Max_h3_TURBO-hybrid_beta4_int8_convrot.safetensors
文本编码器:qwen3vl_32b_minimax_h3_int8_convrot.safetensors
Turbo LoRA:minimax_h3_fl2v_turbo_4step_v0.1_768p_sla_comfyui_bf16.safetensors(实际使用 6 步 Euler/simple 采样) - VAE 选型:
采样端(T10/XTX):minimax_h3_video_vae_fp16.safetensors+minimax_h3_audio_vae_fp32.safetensors
解码端(3080 Ti):minimax_h3_video_vae_int8_convrot.safetensors+minimax_h3_audio_vae_fp32.safetensors - 分布式并行配置:FSDP=true,CPU offload=false,Attention 采用
TORCH_EFFICIENT;4 卡模式 Ulysses=4/Ring=1,8 卡模式 Ulysses=8/Ring=1。XTX 采用 ROCm Comfy Kitchen(CK attention)。 - 运行环境版本:
NVIDIA 端(T10 与 3080 Ti):Python 3.12.3、PyTorch2.13.0+cu130、Ray 2.58.0、xFuser 0.4.4、safetensors 0.8.0、ComfyUI 0.34.0。
AMD 端(RX 7900 XTX):PyTorch2.12.0+rocm7.14.0、comfy-kitchen 0.2.32、safetensors 0.8.0。
五、完整复现指南与一键流水线 CLI
我们已经将整套多机服务拉起、离线规划、队列调度与断线恢复逻辑封装为了 Python 生产 CLI。在克隆项目后即可开箱使用:
 开源仓库:https://github.com/peterhon168/h3-multigpu-pipeline
实测视频:https://youtu.be/fUTG5CveZ9k1. 源码补丁与自定义节点部署
在全新隔离的 ComfyUI 源码树上依次打上补丁并安装节点:
PKG="$(cd ./h3-multigpu-pipeline && pwd)"
COMFYUI_ROOT=/your/path/ComfyUI
RAYLIGHT_ROOT="$COMFYUI_ROOT/custom_nodes/raylight"

# 应用 Turing 架构补丁
git -C "$COMFYUI_ROOT" apply "$PKG/assets/patches/comfy-turing-lerp.patch"
git -C "$RAYLIGHT_ROOT" apply "$PKG/assets/patches/raylight-sm75-ulysses.patch"

# 安装 A6 跨卡文本编码节点与 Latent 跨机交接节点
cp -r "$PKG/assets/comfyui_h3_multigpu_clip" "$COMFYUI_ROOT/custom_nodes/"
cp -r "$PKG/assets/h3_latent_handoff" "$COMFYUI_ROOT/custom_nodes/"
2. 配置主机网络映射(Host Map)
复制配置文件模板,填入你实际的内网 IP、SSH 别名与 Python 虚拟环境路径:
LOCAL_DIR=./h3-local-private
mkdir -p "$LOCAL_DIR"
cp "$PKG/config/host-adapter.example.json" "$LOCAL_DIR/host-map.json"

# 编辑 host-map.json 后自动生成本地适配配置
python3 "$PKG/scripts/pipeline.py" config-adapt \
  --host-map "$LOCAL_DIR/host-map.json" \
  --out "$LOCAL_DIR/local.json"
3. 本地离线任务规划(Plan)
在不联网、不调用 GPU 的情况下模拟排期,校验不同拓扑的调度序列:
# 规划五秒低档双 4 卡独立池(推荐日常吞吐档)
python3 "$PKG/scripts/pipeline.py" plan \
  --mode four_four_plus_one --width 416 --height 736 --seconds 5 \
  --count 6 --seed 987654321123

# 规划高档 736x1280 三源并发(推荐高清批量档)
python3 "$PKG/scripts/pipeline.py" plan \
  --mode four_four_xtx_plus_one --width 736 --height 1280 --seconds 5 \
  --count 6 --seed 987654321123
4. 服务预检、启动与后台批量执行
通过命令行统一拉起远端分布式服务并提交后台作业:
# 服务预检与一键拉起
python3 "$PKG/scripts/pipeline.py" preflight --config "$LOCAL_DIR/local.json" --mode four_four_plus_one
python3 "$PKG/scripts/pipeline.py" start --config "$LOCAL_DIR/local.json" --mode four_four_plus_one

# 后台提交 6 任务生成并获取状态
python3 "$PKG/scripts/pipeline.py" run \
  --config "$LOCAL_DIR/local.json" --mode four_four_plus_one \
  --prompt-file ./private/prompt.txt --reference-file ./private/ref.png \
  --width 416 --height 736 --seconds 5 --count 6 --background

# 查询执行状态与等待出片
RUN_ID="填入输出的run_id"
python3 "$PKG/scripts/pipeline.py" wait "$RUN_ID" --timeout 7200
六、生产排坑与避坑要点
- Ray 临时 Socket 路径长度超限:首轮 8 卡启动时,因 Unix Domain Socket 路径超过 Linux 的 107 字节上限导致进程无报错卡死。解决方案是将临时运行目录显式缩短(如
/tmp/ray),该细节已固化在封装启动脚本中。 - 多池 ComfyUI 数据库冲突:当双 4 卡池在同一台物理机上启动时,多个实例争抢默认的
comfyui.db会触发数据库锁定警告。启动脚本已强制分配独立 SQLite 数据库文件(如comfyui_pool1.db),彻底解决并发冲突。 - 断网与异常状态恢复:CLI 工具内置了断点恢复机制(
pipeline.py resume <RUN_ID>)。如果协调进程异常中断,再次执行 resume 会扫描远端已有 Latent 并仅补偿缺失的解码或采样动作,避免重复计算浪费电费。 - 单解码器队列控制:3080 Ti 作为单一解码卡,在面对三源并发时队列最大 Pending 仅为 1,解码尾段耗时完全能被前置采样时间重叠掩盖,不需要盲目增加解码卡。
总结
多卡本地部署不应局限于“所有卡做一模一样的事情”。让廉价的二手计算卡(如 Tesla T10)通过序列并行专攻分布式 DiT 采样,让消费级单卡(RTX 3080 Ti)专精快速 INT8 VAE 解码,配合局域网 10GbE 轻量级 Latent 交接,是用极低硬件成本实现百片级视频连续生产的黄金组合。
代码与完整资产包已在 GitHub 全量开放,欢迎大家在开源仓库与本帖评论区交流探讨多机异构与视频生成调度心得!
-
,A abaalei 引用了 此主题
-
-
,
 T terry 固定了此主题
-
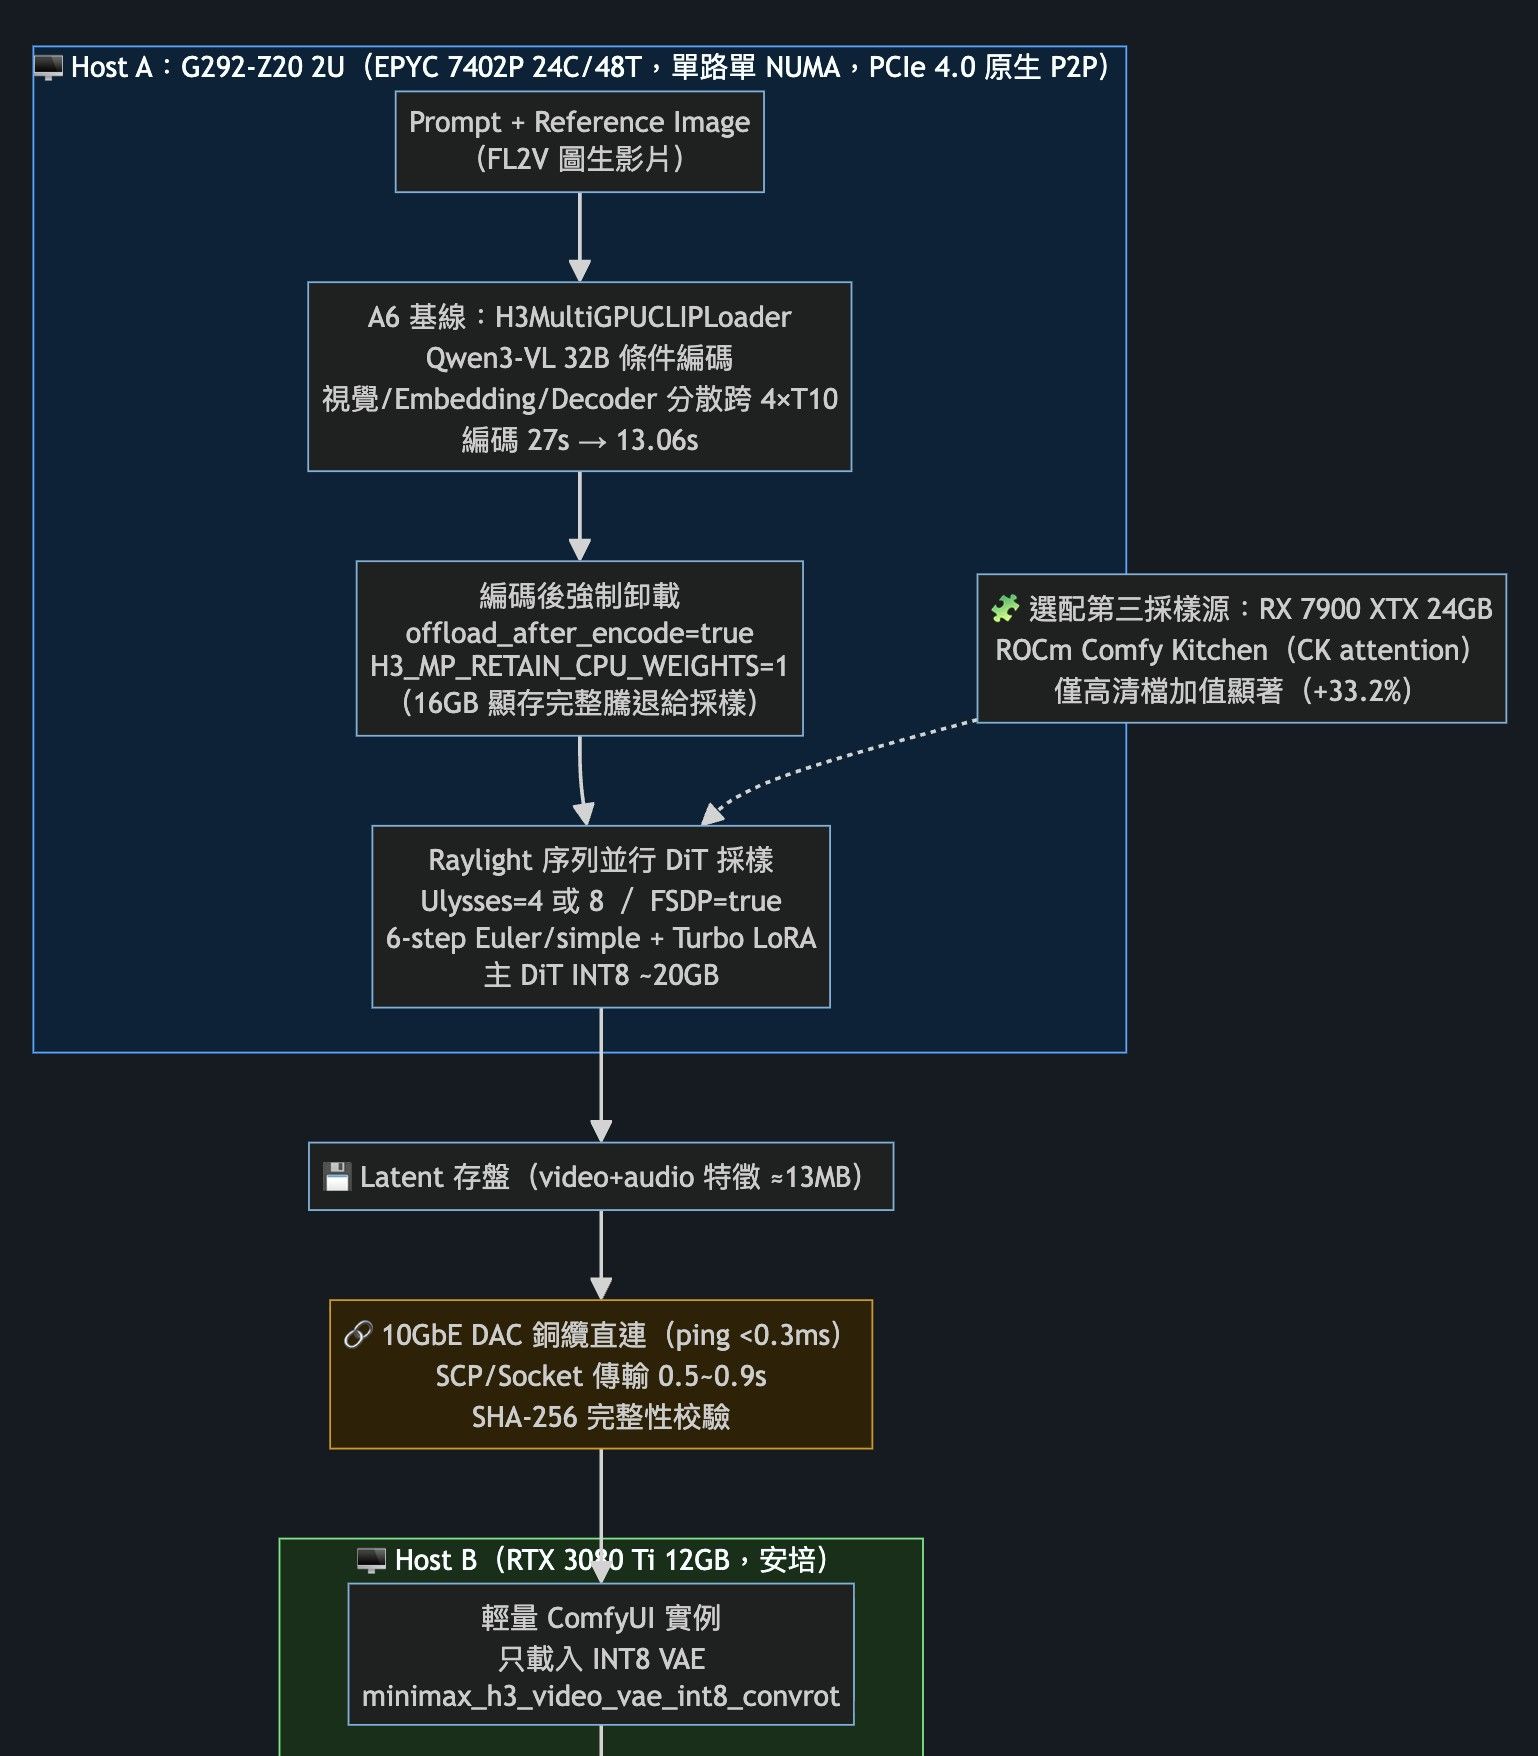
流程圖版 : )
圖太大了 不好安排
這邊Markdown 好像無法渲染 Mermaid SyntaxHTML 版本
LCZ-topic2138-H3多卡异构流水线-workflow_20261006.html① 核心流水線 DAG(單任務:採樣 → 跨機交接 → 解碼出片)
-
-
-
-
我還在學習 以後要看免費的電影 可能要等你了 哈

這產線蠻大的樣子 ComfyUI 還能跨機器生產這影片被藏在一堆文字中 推一下
MiniMax H3 多卡分布式采样 实测视频:https://youtu.be/fUTG5CveZ9k
-
@kos-or
跑了2天全自动产线(hermes agent自动迭代、自动审图,人类只在台本确定阶段、图片转i2v阶段与最后审片阶段介入),单集6分半钟3语种+短视频28秒3语种,也就是全量加起来21分钟的视频(70%是5秒长镜头,30%是10秒长镜头),大概耗时9小时左右的样子。现在产线也正在重构,最近我也在学习其他做短剧的,哈哈,多塞点2 3秒的碎镜头,可以大幅提高产量 -
我很少跑几秒的哦。。。。现在都是45s 单条以上。。。。虽然效果不怎么完美,等我得空我再优化
-
,系统 取消固定了此主题


