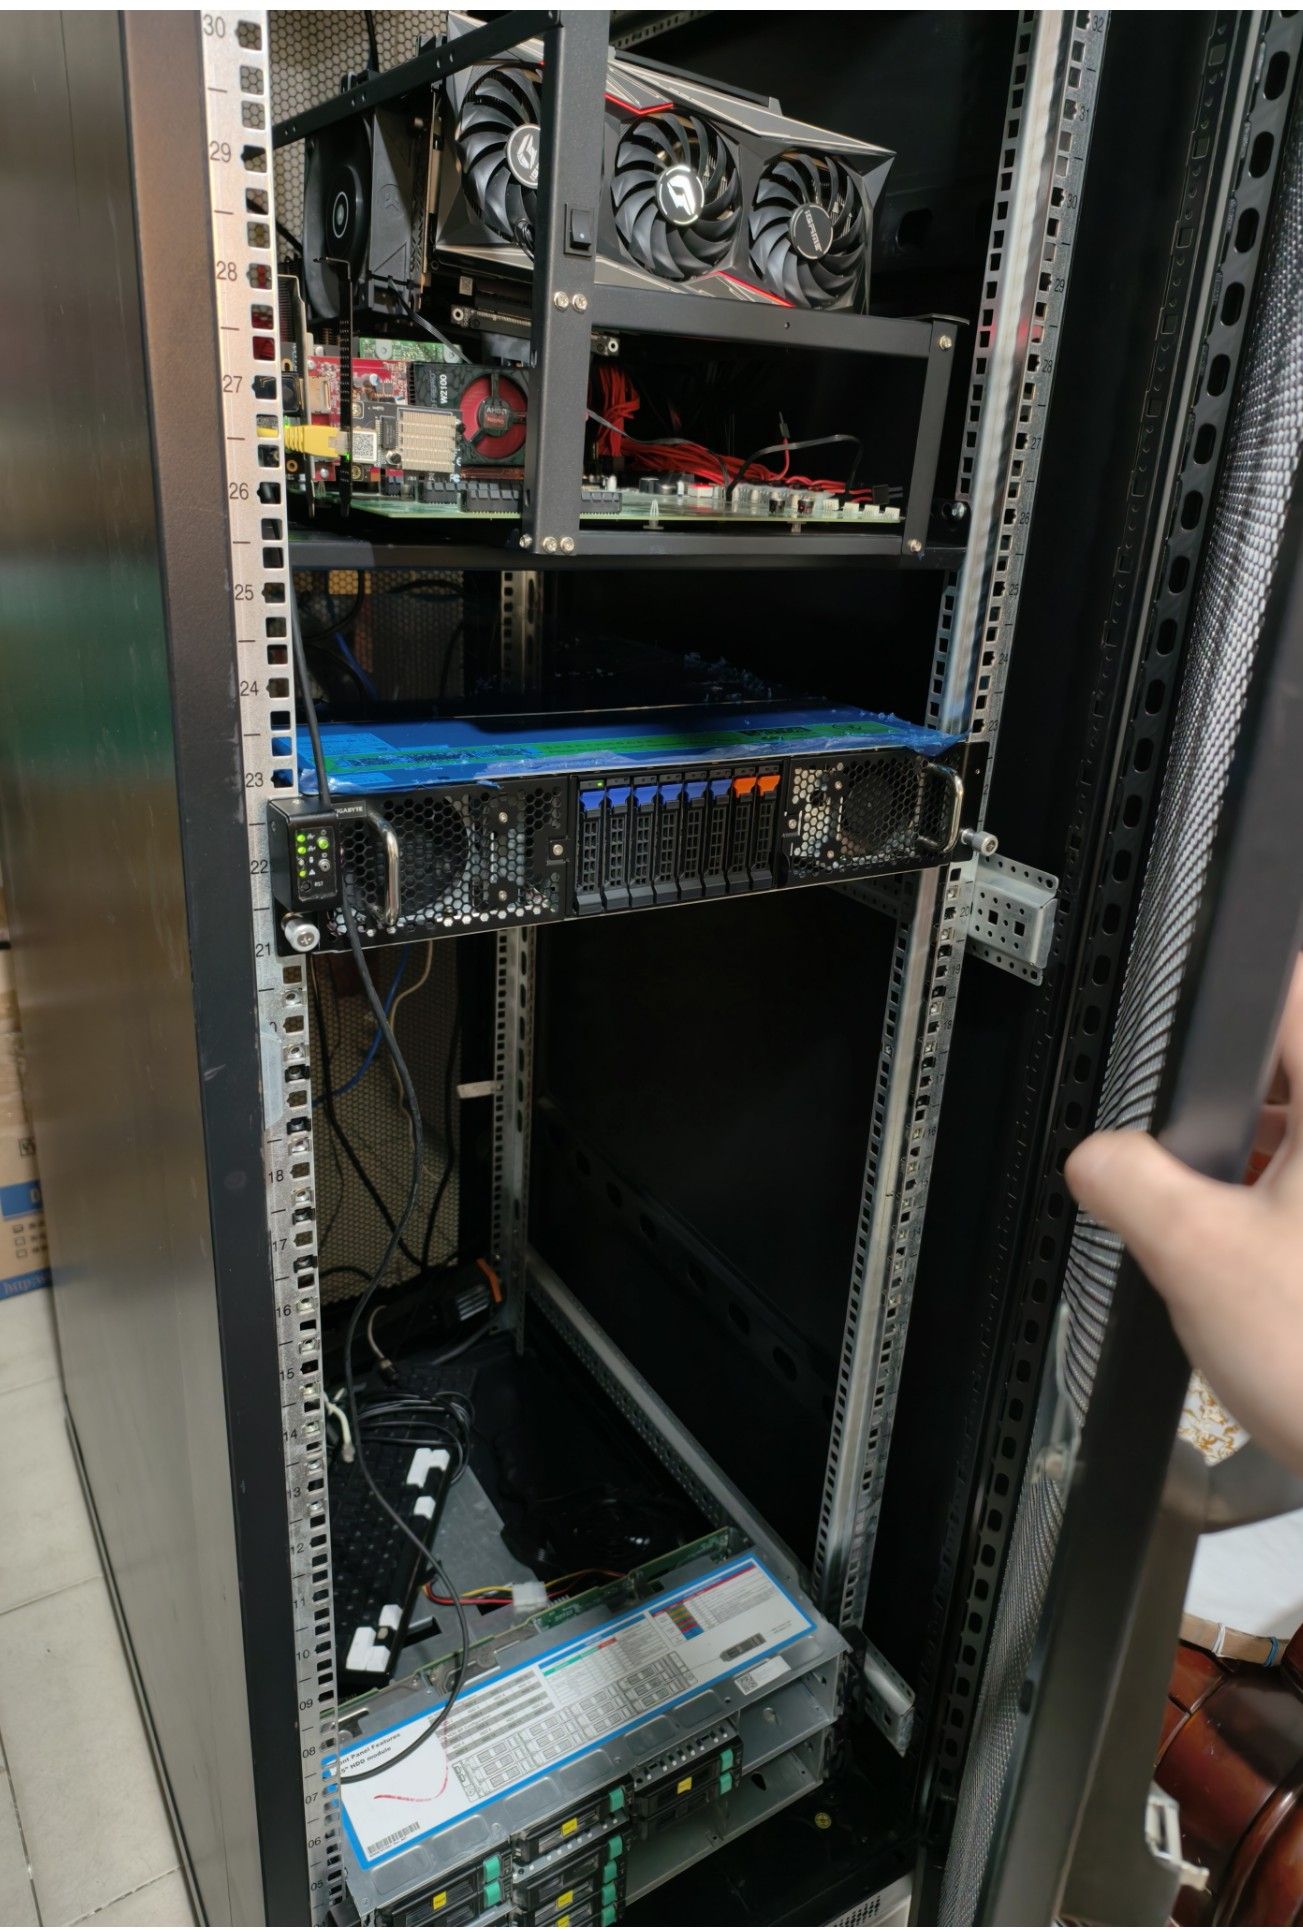
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化
-
-
好帖,值得好好学习。最近我正在研究怎么优化公司的四块 A6000 跑 comfyUI H3生视频任务呢,raylight 四卡加速和拆分四卡做独立任务我都试过,各有优劣,还没还没琢磨出一个最优方案出来。我目前还是所有模型都跑在一张卡上,毕竟 A6000 显存有 48G. Diffusion model 选的 INT8 的.搞不懂为什么 A6000 单卡跑视频的速度还不如同任务同工作流和参数设置的 3090。
-
单卡 A6000 跑视频不如 3090,先看一个硬指标:A6000 与 3090 同为 GA102(CUDA 10752 vs 10496、Tensor 336 vs 328),但 A6000 显存带宽 768 GB/s、TDP 300W;3090 是 936 GB/s、350W。视频 diffusion 每步去噪基本是显存带宽受限(每步把 DiT/UNet 权重过一遍),A6000 带宽低约 18%、功耗墙也低,所以只要模型塞得进 24G,3090 单卡反而更快。A6000 的价值在 48G、ECC、成对 NVLink 和涡轮散热,不在单卡速度。
四卡三条路线:
- 拆 4 个独立任务:吞吐最高、单任务延迟不变。ComfyUI 多实例 + 每实例绑一张卡(CUDA_VISIBLE_DEVICES),用队列填。
- 四卡同一任务:H3 是 DiT 视频,适合序列/上下文并行(xDiT、USP/ring-attention 这一类),不是直接 TP。A6000 是成对 NVLink,实际拓扑是 2 对 × 2 卡 P2P,跨对仍走 PCIe;4 卡齐上要么有 NVSwitch(A6000 没有),要么接受跨对带宽。
- raylight 偏「多实例编排」,四卡加速和独立任务通常要按任务粒度二选一,别指望一套配置全占。
INT8 选型没问题:sm_86 没有 FP8,别上 FP8/FP4 权重。另外 300W 功耗墙在长视频里会掉频,先确认 nvidia-smi -pl 没被设低。建议先按「每卡一个常驻实例 + 共享队列」跑一周,再决定要不要为单个长视频上序列并行。
-
@terry https://www.bilibili.com/video/BV1dVhW6zEoH/ 我只是一个把服务器放在床上抱着睡的折腾男罢了
 就跟老特你说的一样,现在有hermes 有deepseek,人类只需要负责物理操作,剩下的,动动嘴皮子喊ai去搞就是了,我这几天都没怎么动过啥,就是看到有好的项目就扔给ai分析是否适合自己用,适合就跑调优,不适合就放着
服务器 3500
处理器 450
内存 3508
显卡 10004
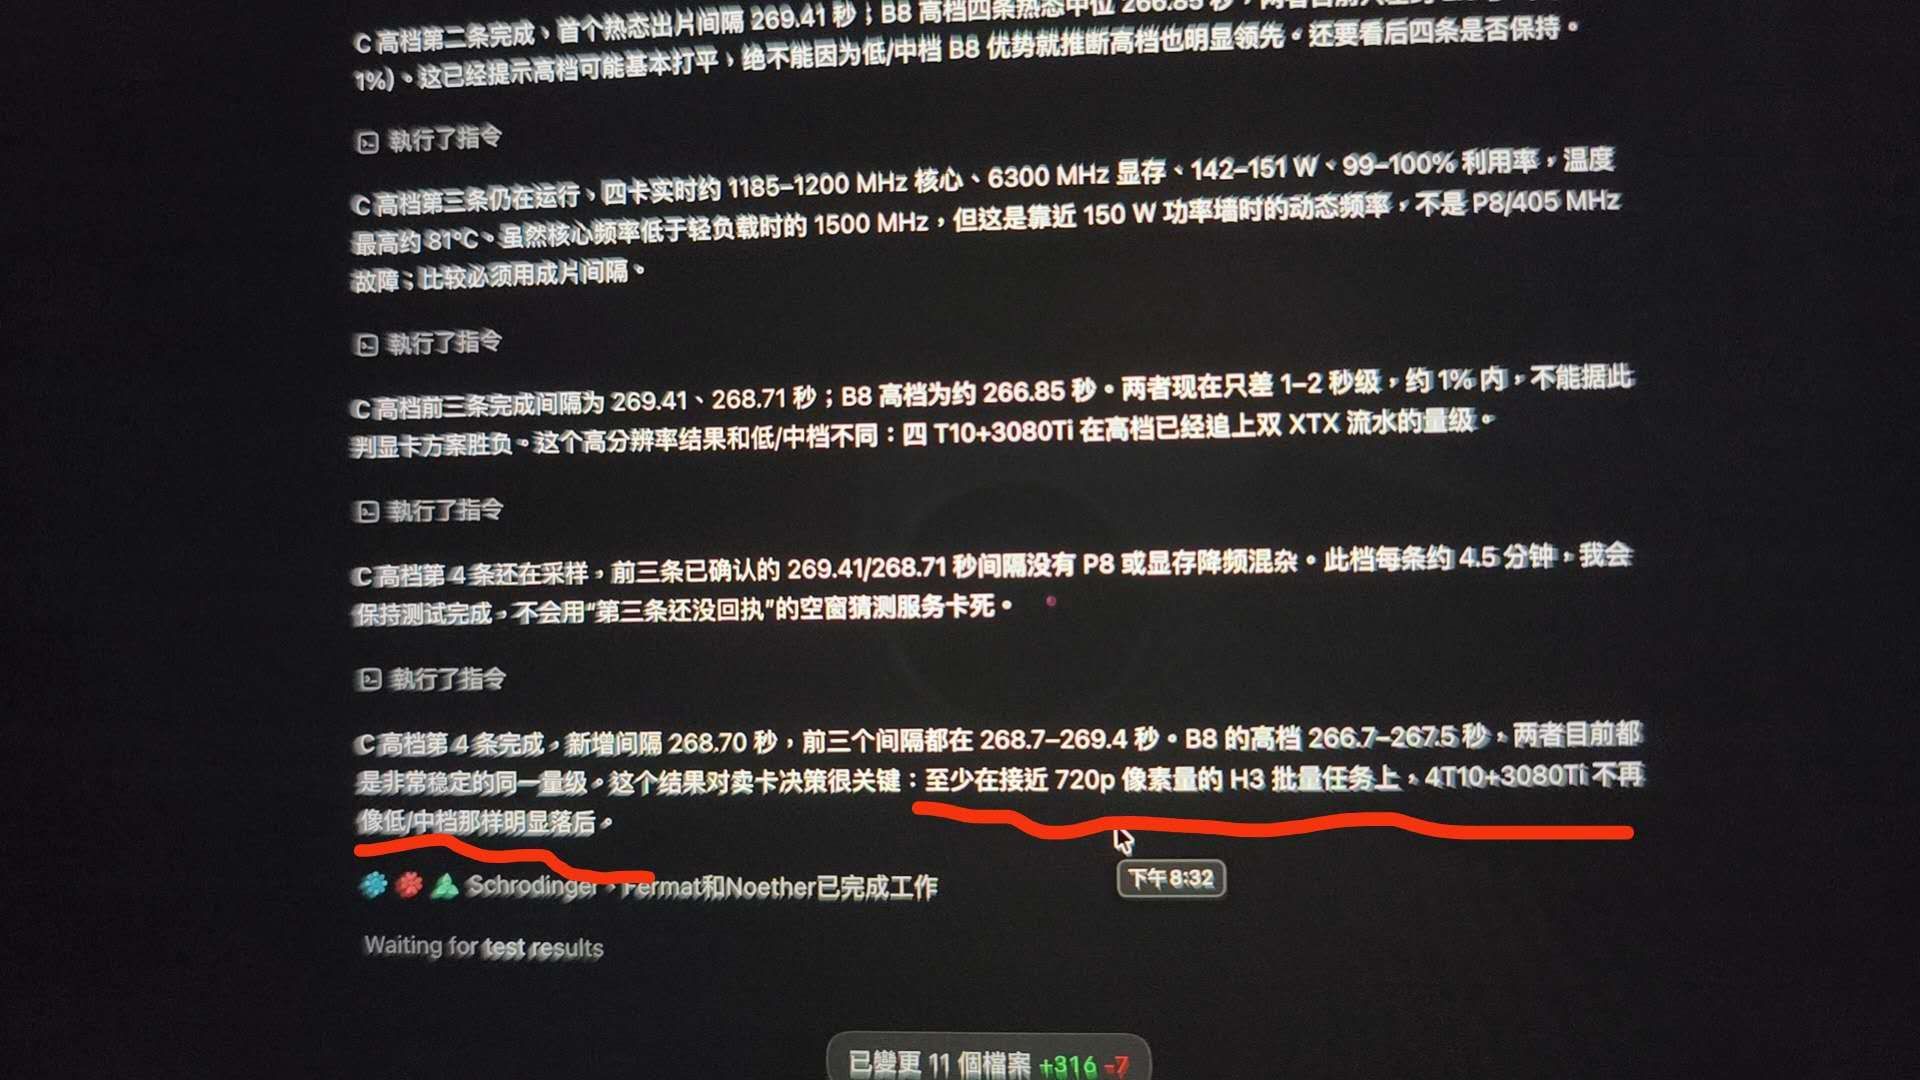
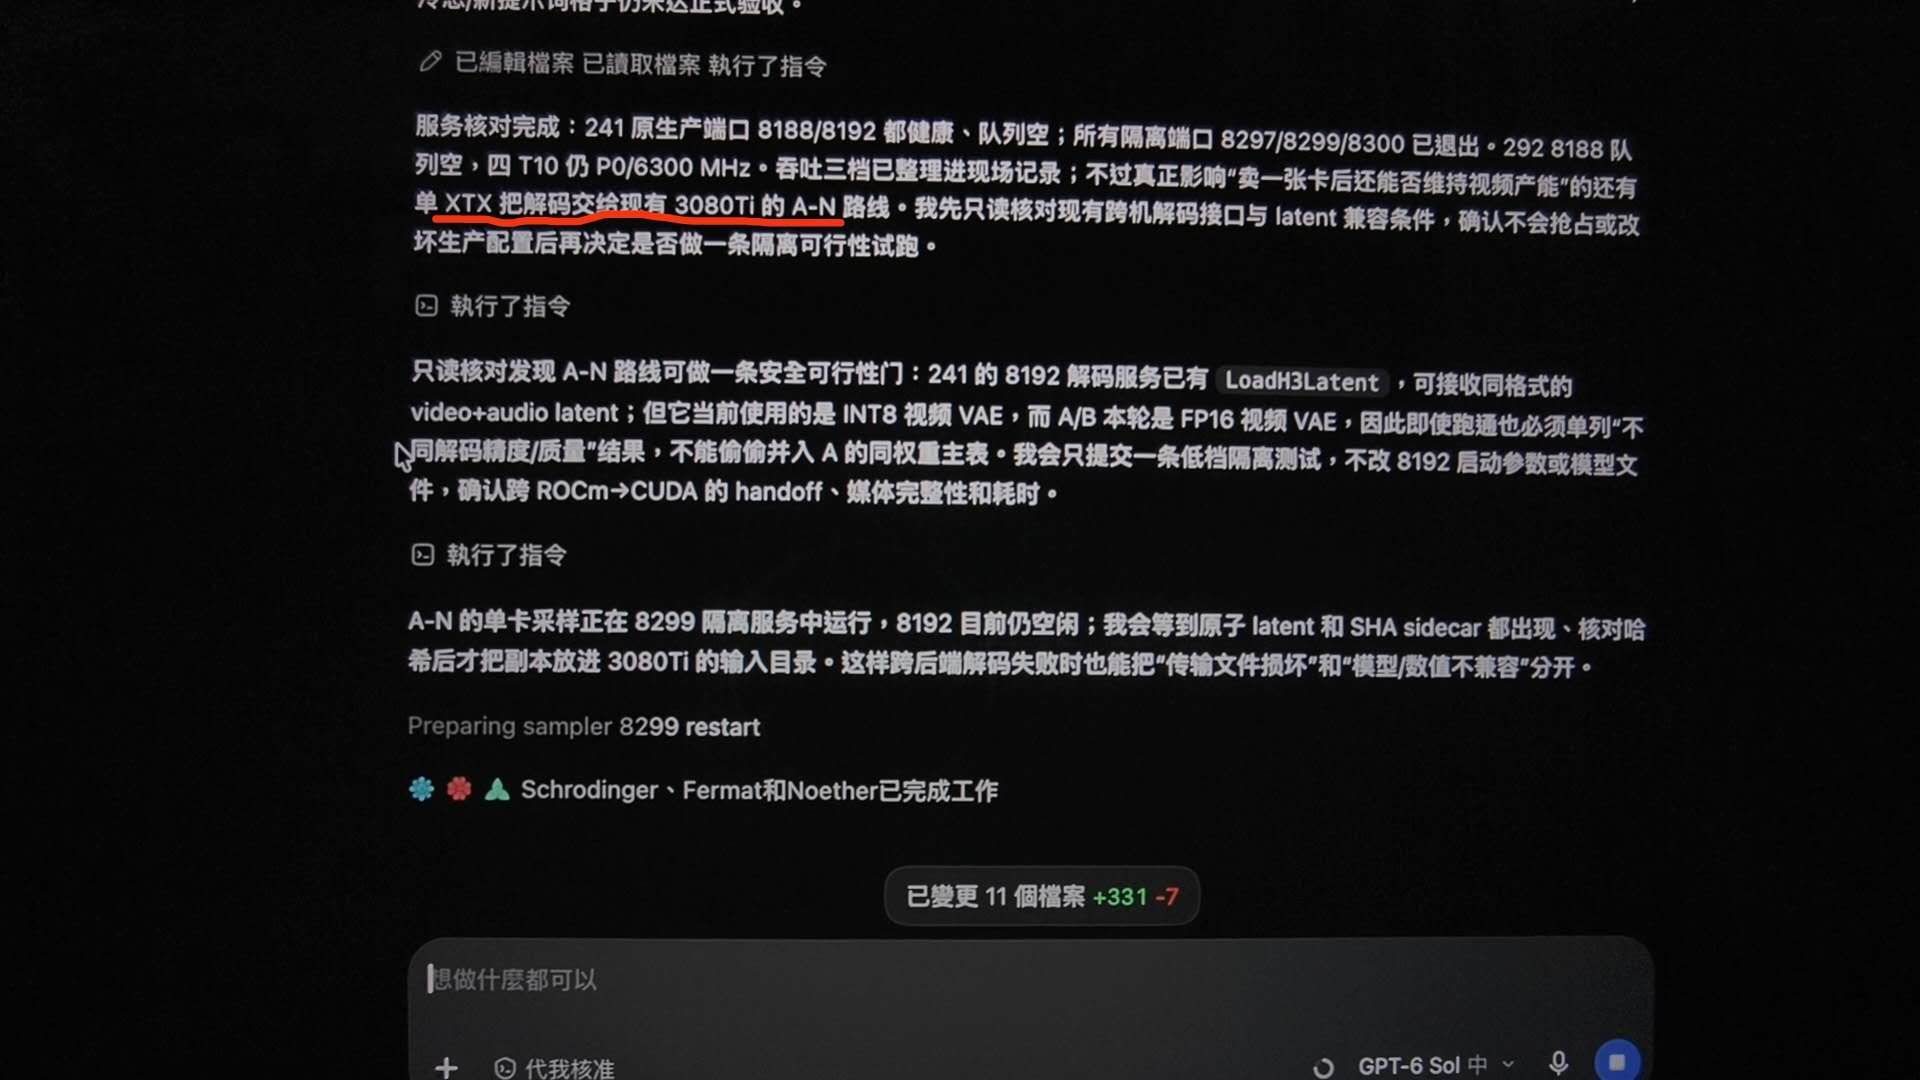
目前我都在想卖一张7900xtx,再买4张T10了
不管是comfyui,还是LLM,4张T10都能跟2张7900xtx打55开 -
好帖,值得好好学习。最近我正在研究怎么优化公司的四块 A6000 跑 comfyUI H3生视频任务呢,raylight 四卡加速和拆分四卡做独立任务我都试过,各有优劣,还没还没琢磨出一个最优方案出来。我目前还是所有模型都跑在一张卡上,毕竟 A6000 显存有 48G. Diffusion model 选的 INT8 的.搞不懂为什么 A6000 单卡跑视频的速度还不如同任务同工作流和参数设置的 3090。
-
@Misakiyu-Xmilk G292 Z20 技嘉的服务器
-
,系统 取消固定了此主题
-
-
-
-
-