2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s
-
@terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。
-
@farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧
-
@farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧
-
@farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧
但是他TTFT 很慢
-
-
-
-
-
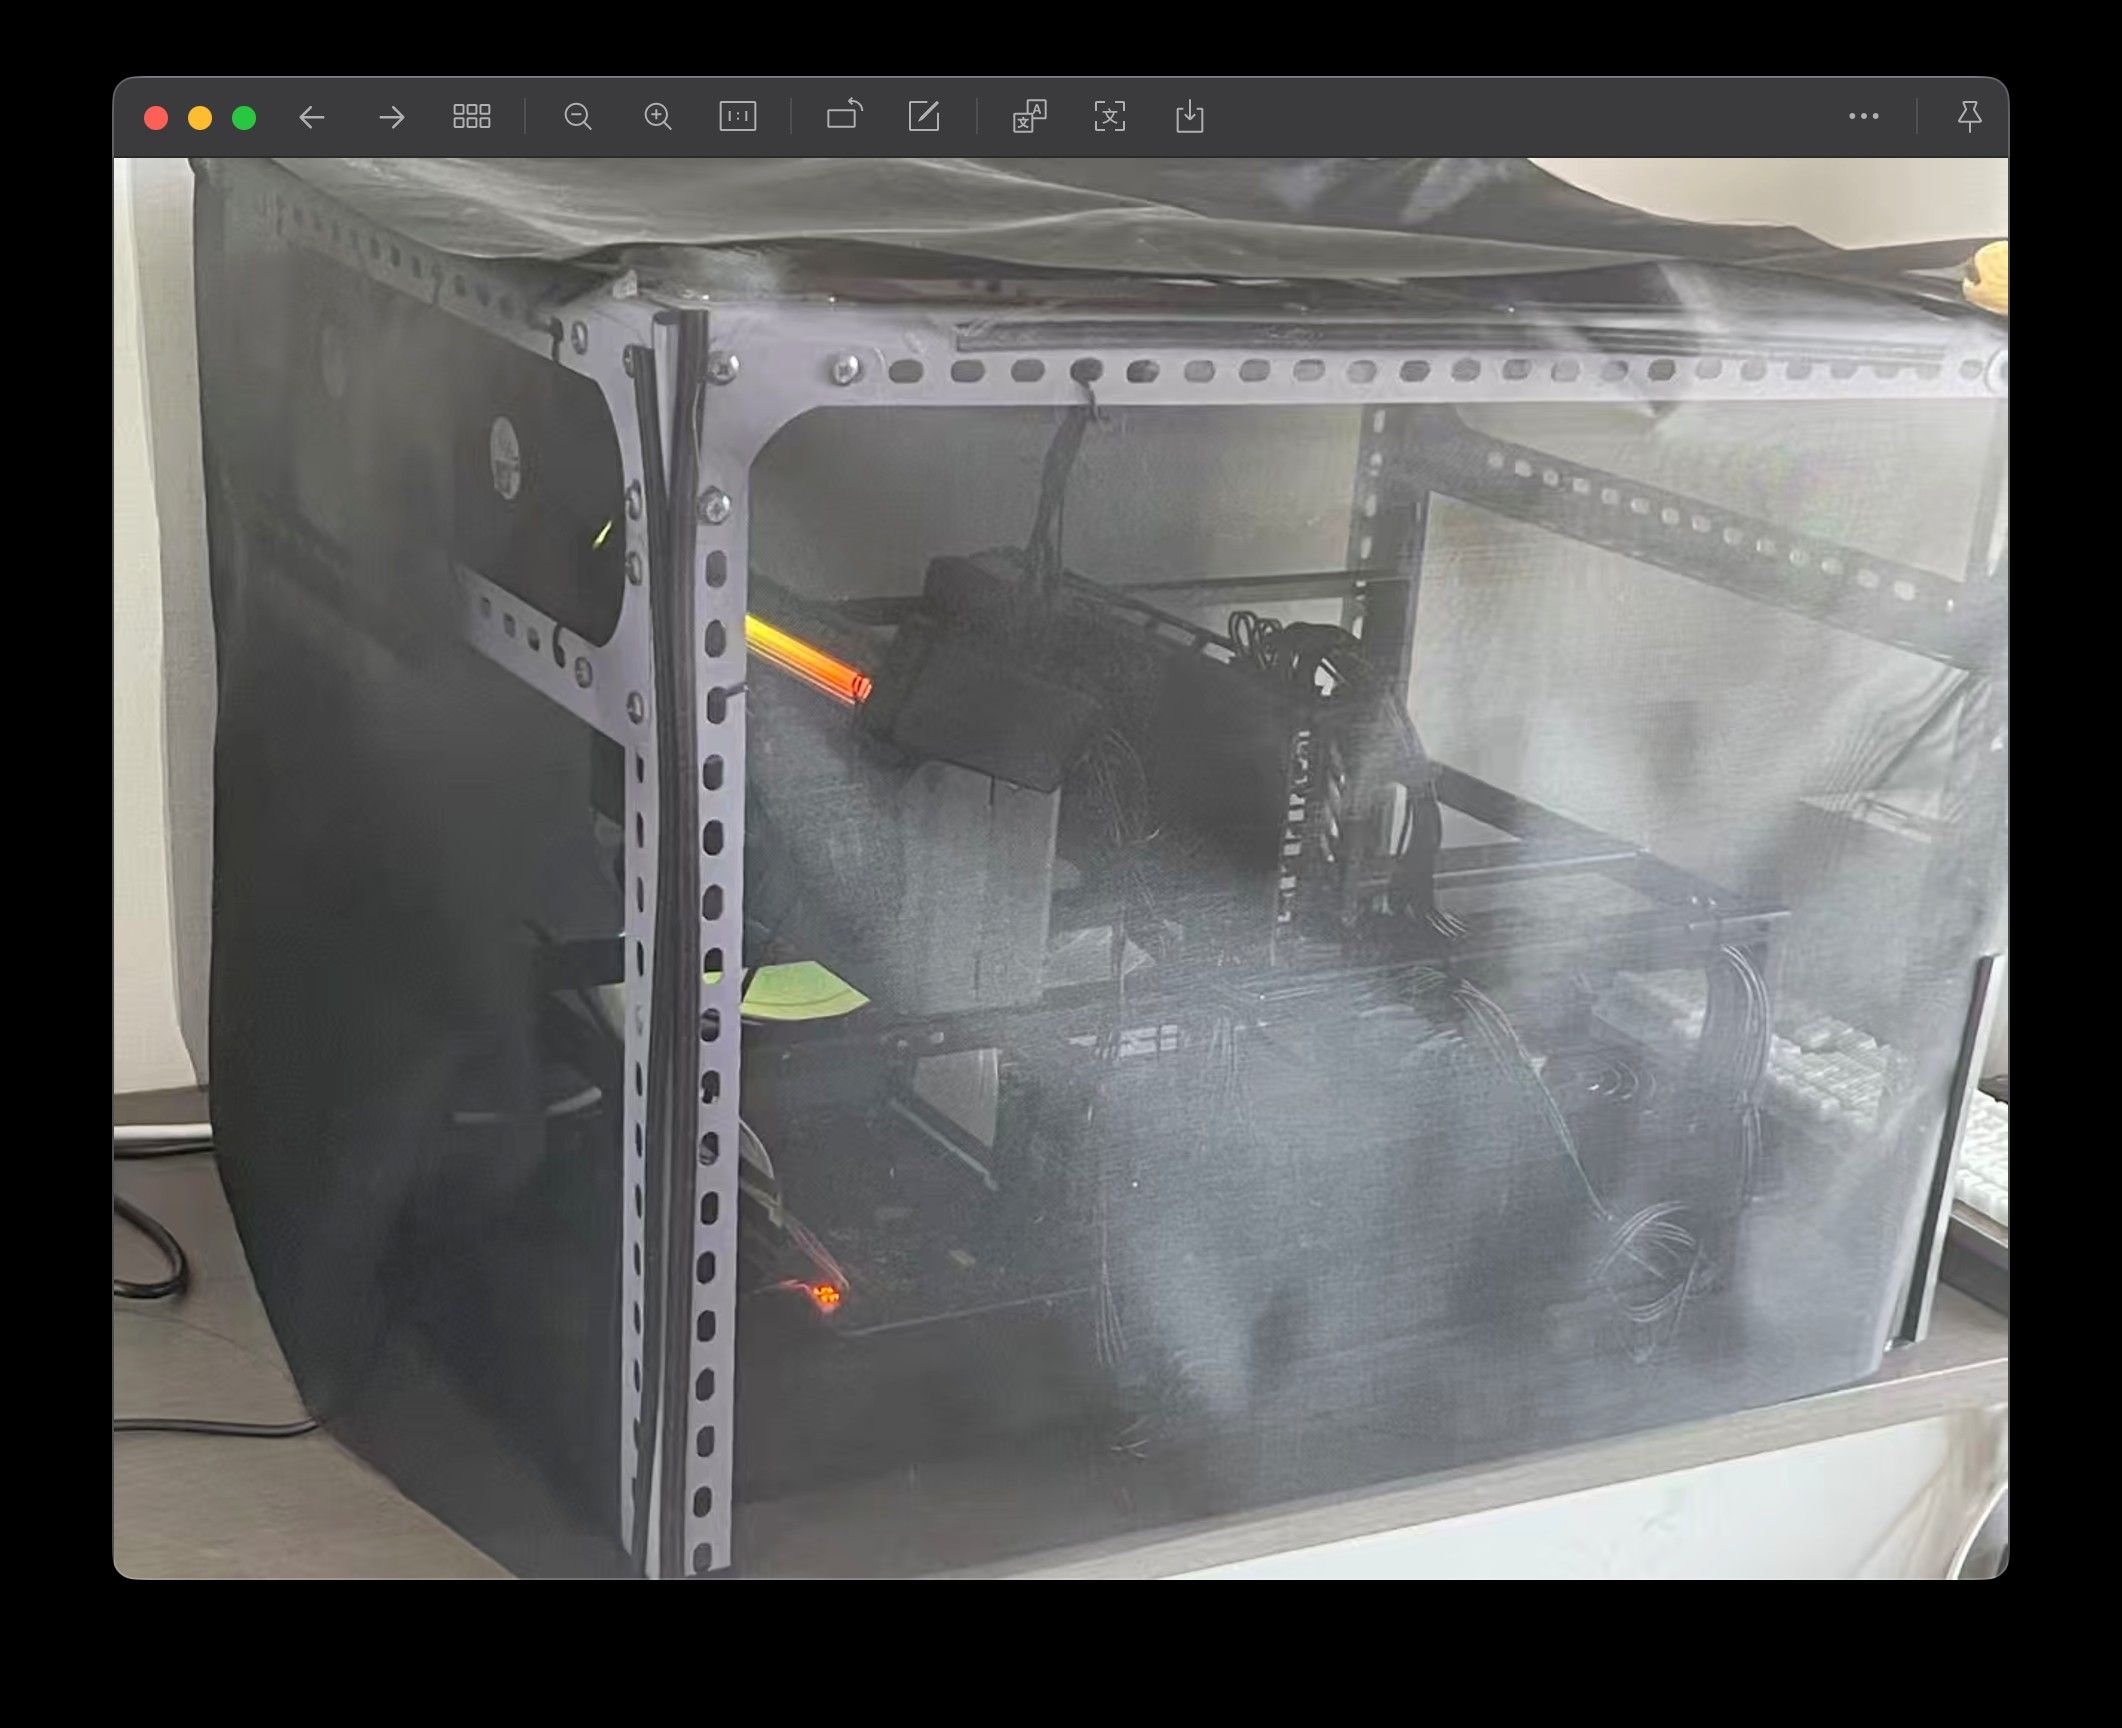
@terry 这个就是上次说有黑罩子的那个。这个是外面:
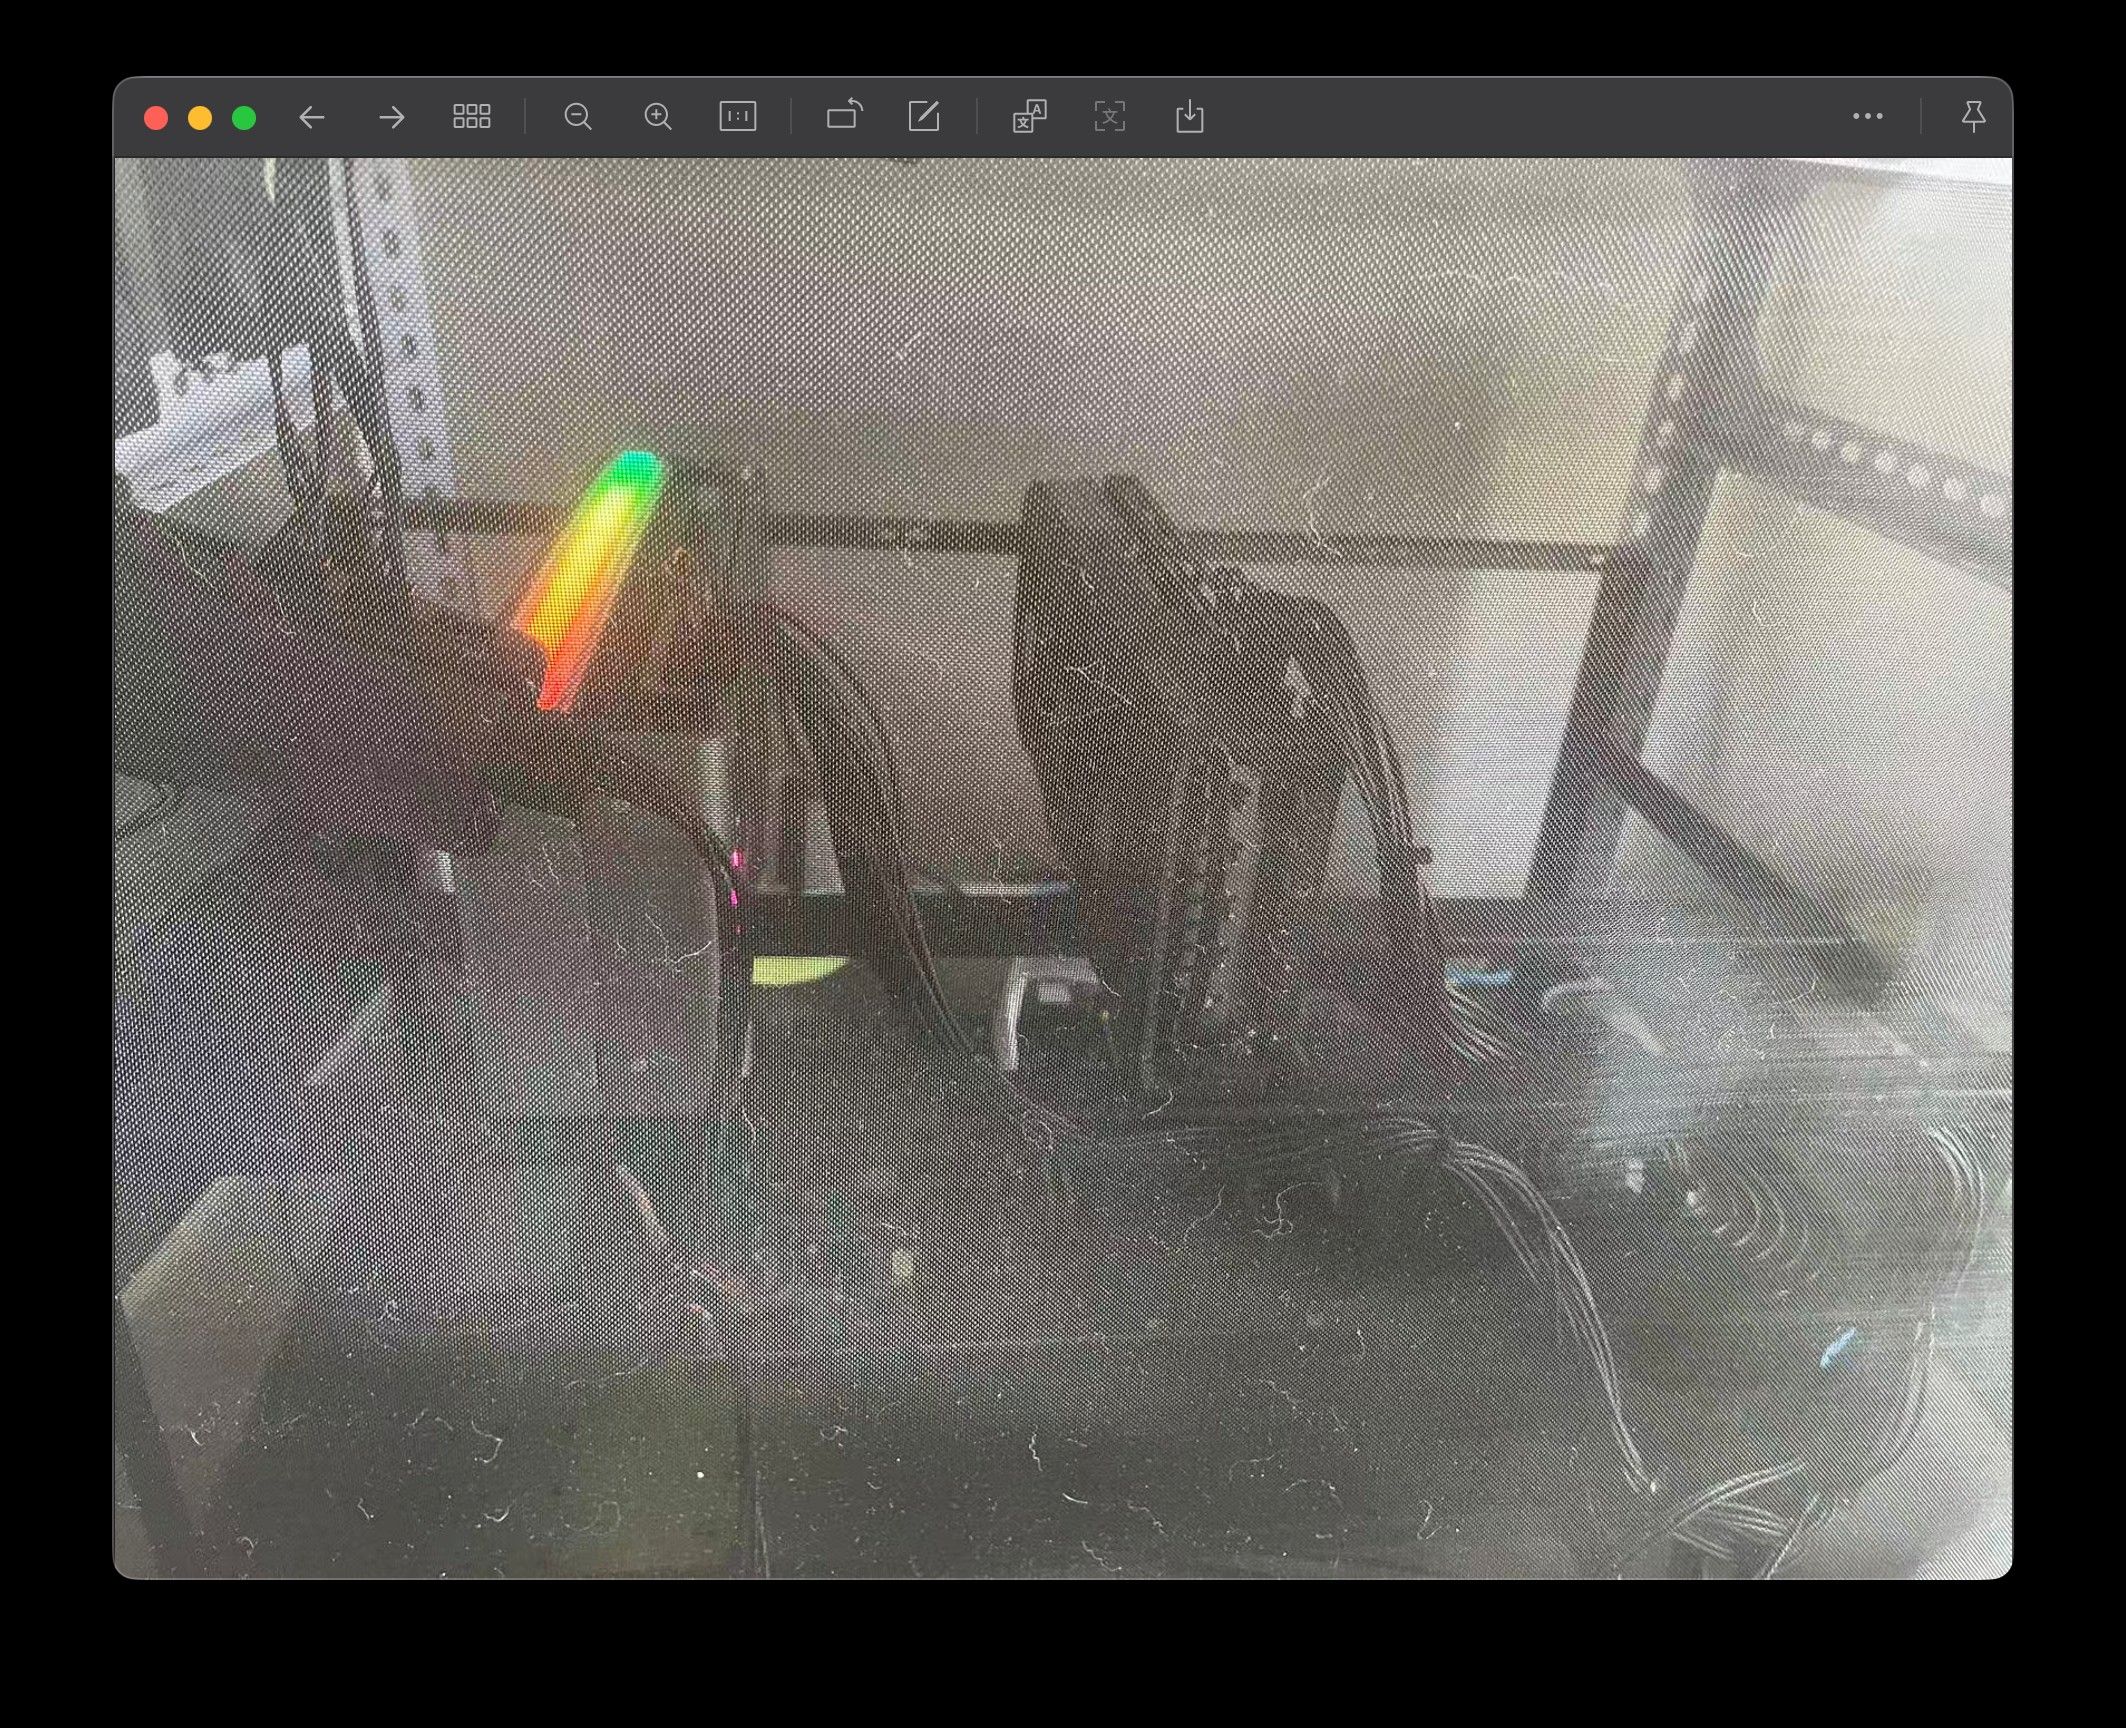
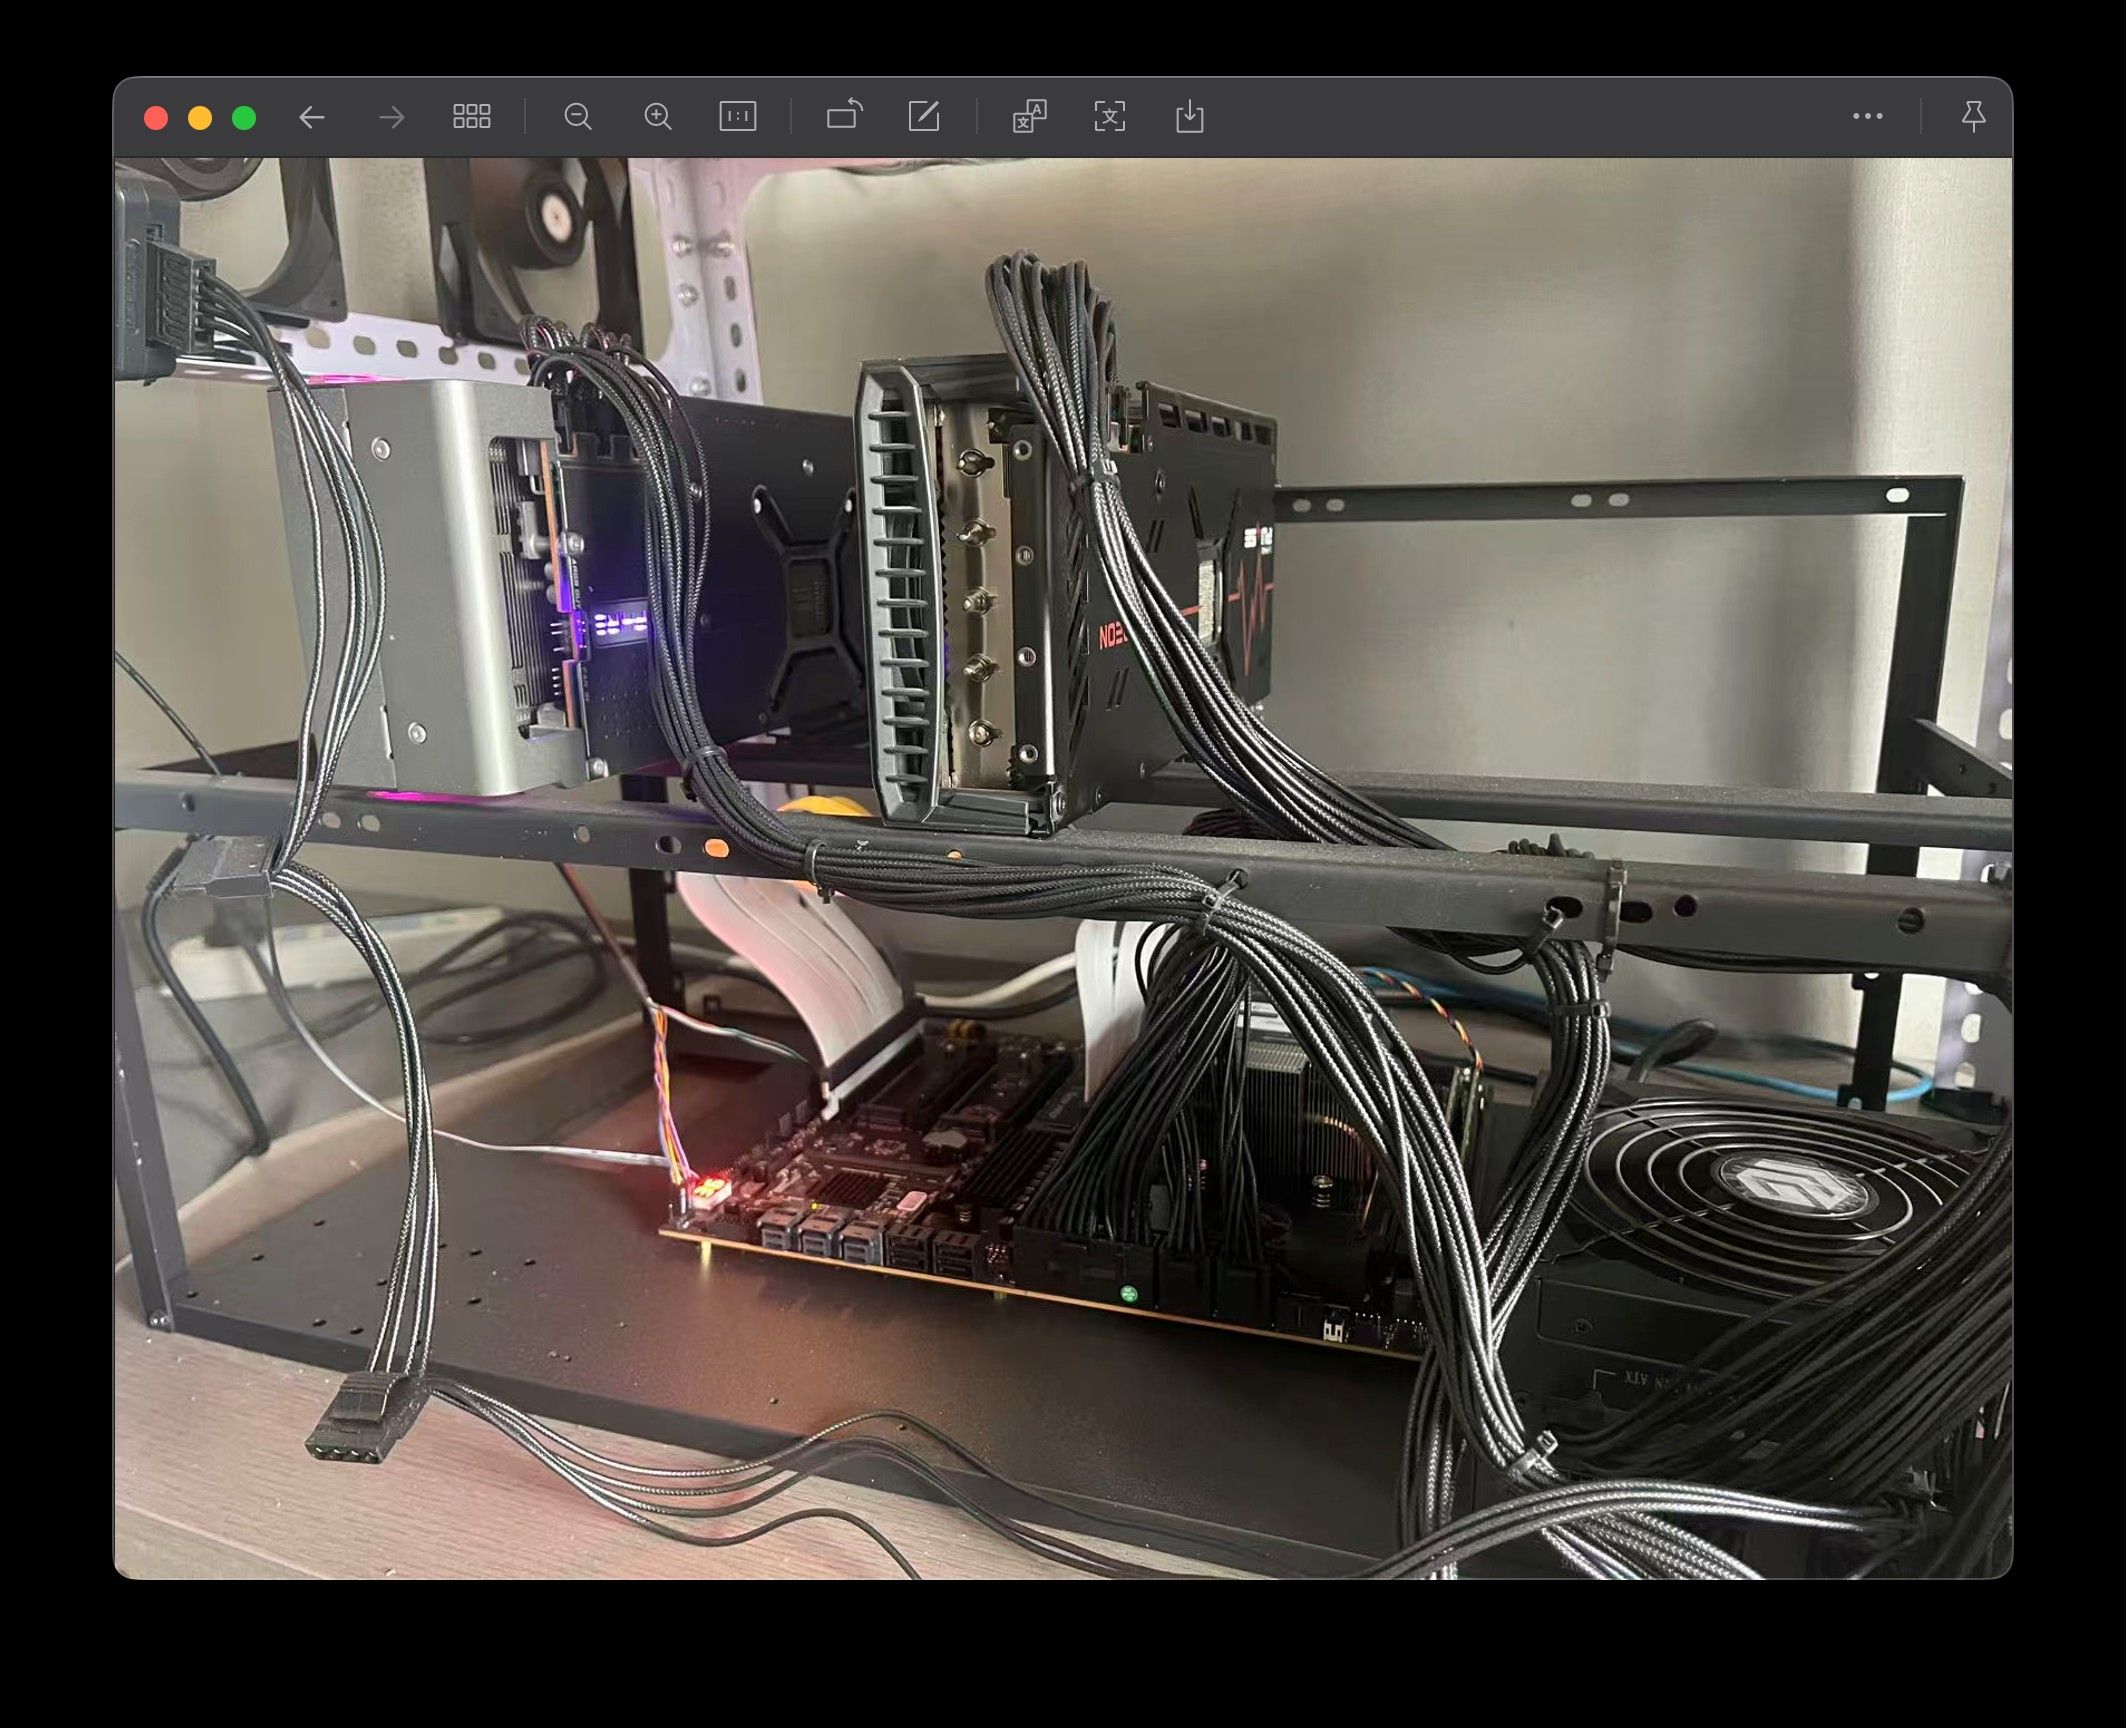
这个是里面: diding顶上和侧边加了几个风扇,温度最高是80,以前跑llama.cpp 负载高的时候会跑到80 , 现在换 vllm ,或是strata ,都是70左右:
-
@farmer-node
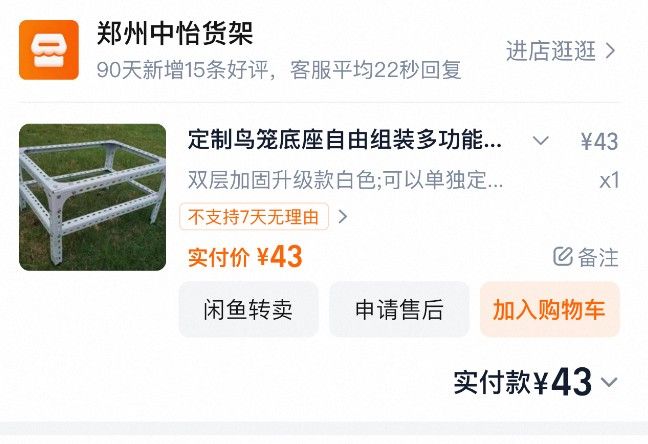
罩子链接分析一个,我俩机架一样