
单卡 R9700 32G 跑 Qwen3.8-27B:10 月版 vLLM 镜像实测,并发吞吐 +80%、8 个长对话同时保留、短问题延迟最高 43×
-
前段时间一直在用 Eliovp-BV/paiton-vllm-plugin 跑 Qwen3.8-27B,最近把它从 9 月底的镜像升到 10 月 5 日的镜像,并把运行模式换成了新的
--mode long-kv4。单卡 32G 显存放不下两个引擎,所以两个版本是同一天交替跑的:停一个、起一个、同一套客户端脚本、同一批 prompt。下面所有对比都是这样测出来的。
硬件
项 配置 显卡 单张 R9700 32G(ReBAR 开,PCIe 4.0 x8) CPU Intel Core i9-13900HK ES(14C/20T) 内存 32G DDR4 功耗上限 260W 两个版本的差异(配置层面)
项 9 月版 10 月版(long-kv4) 镜像 …20260929-r2…20261005-r1KV cache fp8,7.15 GiB 4-bit KV4,11.05 GiB --max-num-seqs1 8 --gpu-memory-utilization0.94 0.98 权重量化 3-bit(W3A4) 3-bit(W3A4,同左) 长 prefill 阈值 无 --long-prefill-token-threshold 2048一、单流 decode 和 TTFT —— 基本持平
n=40,每条 256 tokens:
指标 9 月版 10 月版 差异 decode 中位数 137.34 t/s 137.52 t/s 持平 decode 平均 151.74 t/s 155.89 t/s +2.7% TTFT 中位数 47.2 ms 43.2 ms −8.5% TTFT p90 53.3 ms 48.6 ms −8.8% 报错数 0/40 0/40 — 结论:单流没有任何回退,也没有明显提升。 TTFT 那 4 毫秒的差距,在实际使用里被网络往返盖掉了,可以忽略。
二、并发 —— 提升最大的一项
两个请求同时发,各 512 tokens:
指标 9 月版 10 月版 差异 第 2 个请求的 TTFT 4153 ms 142 ms 29× 整体耗时 8.31 s 4.63 s −44% 聚合吞吐 123.2 t/s 221.3 t/s +80% 9 月版是
--max-num-seqs 1,第二个请求只能排队等第一个跑完(所以 TTFT 4 秒多);10 月版两个请求真的并行,各自还有 116 t/s。三、长文档 prefill(pp)—— 也基本持平
用一份长文档做冷启动,pp 按「输入 tokens ÷ 首字延迟」折算:
文档长度 9 月版 10 月版 129K tokens 2577 t/s — 187K tokens 2225 t/s 2293 t/s 两边都在 2200–2600 t/s 量级,并且都随深度下降(129K → 187K 掉约 14%)。升级没有改变 prefill 性能。
四、长文档重复提问 —— 单文档两边都很好
同一份 187K tokens 的文档,连问三次:
指标 9 月版 10 月版 第一次(冷) 84.19 s 81.70 s 第二次(暖) 1.70 s 1.82 s 缓存命中 99.1% 99.1% 加速比 49.5× 44.8× 这一项 10 月版没有优势 —— 9 月版的 prefix caching 已经能把整份 187K 文档留在缓存里,暖启动 1.7 秒。
五、多个对话并存 —— 真正的差距在这里
同时开 N 个长约 61K tokens 的对话,轮流问(每个都问两轮,看第二轮的缓存命中):
同时打开的对话 总 tokens 9 月版 10 月版 2 × 61K 123K  全部保留
— 3 × 50K 150K  全部淘汰 全部保留
8 × 61K 492K 不可能(超出上下文) 全部保留9 × 61K 554K — 全部淘汰9 月版的 KV 只有 206K tokens,同时开 3 个约 5 万 token 的对话,缓存就整体失效,之后每次切回某个对话都要重新 prefill(约 15 秒)。10 月版可以稳定保留 8 个这样的对话,总共 492K tokens。
注意:两边的「淘汰点」都明显低于标称容量 —— 9 月版在 60%–73% 之间(60% 还能保留,73% 就全丢),10 月版在 82%–88% 之间。标称数字不能直接当可用容量看。
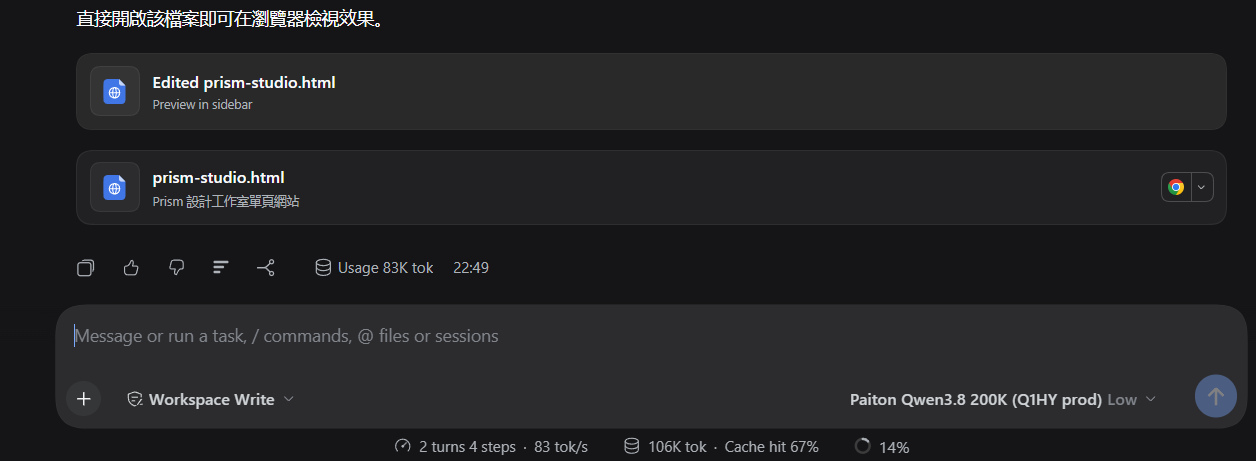
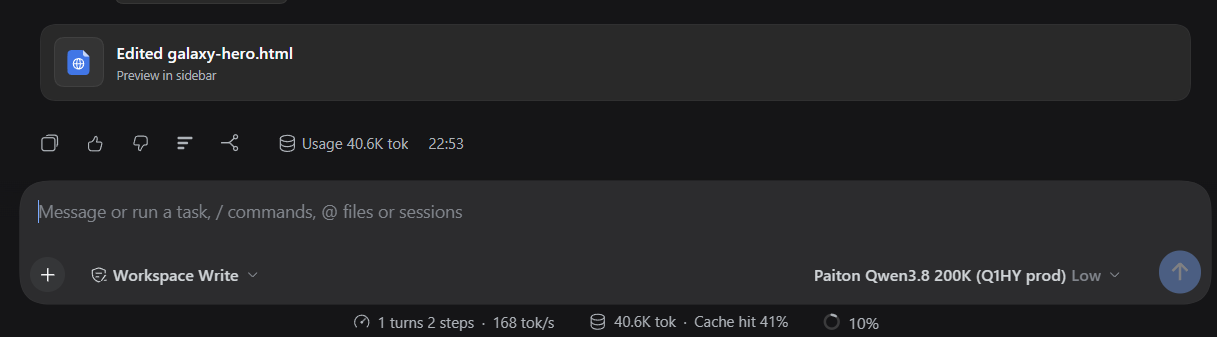
DSH 实测同时跑五个sessions,解码速度最低 83tok/s,单跑一个session 最高 168tok/s。 有兴趣可以到这连结看看跑过的 prompts。
One Prompt to a 3D Website in 30 Seconds (6 Tested)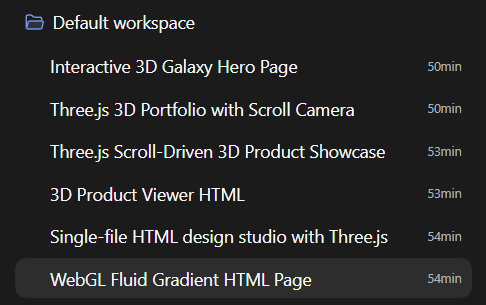
六、短问题插在长 prefill 后面 —— 感受最明显的一项
场景很日常:让 agent 读一份大文件(长 prefill 正在跑),这时你问一个 17 个 token 的短问题。
正在 prefill 的长度 9 月版 10 月版 差异 约 24K tokens 4.59 s 1.09 s 4.2× 约 48K tokens 10.93 s 0.61 s 17.9× 约 101K tokens 33.20 s 0.76 s 43.7× 9 月版的短问题延迟会随长上下文线性恶化;10 月版靠
--long-prefill-token-threshold 2048,短问题被插在 prefill 的分块之间执行,延迟稳定在 0.6–1.1 秒,与长文档大小无关。这一项是单用户、单对话就能遇到的,不需要并发。
七、更长的上下文
10 月版把上下文上限开到 262144(实测最大输入约 262K):
9 月版 10 月版 上下文上限 204800 262144 单次 231K tokens 输入 HTTP 400(超限) 冷 111.45 s → 暖 1.55 s(缓存 99.6%,72×)八、输出质量
档位 内容 回答什么 按题目自带预算 每题取题库给的值,120–900 tokens(实际用到 120/150/160/180/200/250/300/400/450/500/600/800/900) 在 benchmark 给的这点预算下,模型到底交不交得出答案(=日常真正会遇到:被上限截断,而不是不会) 统一 2048 两版都给足 2048 把「品质问题」和「被截断问题」分开,单看内容对不对 定义:预算是每题允许输出的
max_tokens。 我们故意跑两档,因为这两档回答的是不同问题:结果:
预算 9 月版 10 月版 按题目自带预算(120–900) 0.875 0.879 统一 2048 1.000 1.000 结论:在我们这 29 条题上,4-bit KV 没有量到任何质量损失。 需要说明的是题库不大、
类别也有限,这只是一个方向性的检查,不等于全面的质量保证。九、显存表现
满 KV 持续压测(10 分钟持续请求 + 4×90K 长上下文占住缓存):
9 月版 10 月版 显存峰值 93.96% 96.22% 最低剩余 1970 MiB 1234 MiB 完成请求 76/76 452/452 中位 TTFT 0.24 s 0.29 s 10 月版跑得更靠近上限(余量约为 9 月版的 63%),但全程没有出现卡顿。我们用 10 月版新增的
PAITON_VRAM_HEADROOM_MIB=1024来替代 9 月版手动下调--gpu-memory-utilization的做法。我们最终用的参数
镜像:
ghcr.io/eliovp/paiton-vllm-plugin:qwen38-rocm10-vllm029-20261005-r1# 关键参数 --mode long-kv4 --max-model-len 204800 --max-num-seqs 8 --max-num-batched-tokens 4096 --kv-cache-dtype fp8 --kv-cache-memory-bytes 11870208000 --gpu-memory-utilization 0.98 --enable-prefix-caching --enable-chunked-prefill --prefix-cache-retention-interval 32000 --long-prefill-token-threshold 2048 --attention-backend R4D --speculative-config '{"method":"dflash","num_speculative_tokens":7,…}' # 视觉输入 --limit-mm-per-prompt '{"image":10}' --mm-processor-kwargs '{"min_pixels":1048576,"max_pixels":4194304}' --mm-processor-cache-gb 1 # 环境变量 PAITON_KV4=1 PAITON_KV4_CAPACITY=1 PAITON_VRAM_HEADROOM_MIB=1024 PAITON_LMHEAD_W8=1 PAITON_HOST_EMBED=1 PAITON_PC_EAGLE_TAIL=1 PAITON_PC_SPARSE_ALIGN=1 PAITON_NGRAM_CODRAFT=1几个我们改过、和官方 launcher 默认值不一样的地方:
PAITON_VRAM_HEADROOM_MIB=1024:官方的--vision组合会把它去掉,我们手动加回来(这是控制显存不顶到 100% 的机制)。--long-prefill-token-threshold 2048:官方的--vision组合也会去掉,我们加回来 —— 上面第六节的 43.7× 就是靠它。- 图片像素上限:官方默认
max_pixels是 8294400(4K),我们压到 4194304(2K)并加了min_pixels1048576。实测 10 张 4K 图时显存峰值到 97.6%(只剩约 0.76 GiB),压到 2K 后峰值约 95.7%(剩约 1.36 GiB)—— 我们选后者是为了留出余量。 PAITON_LMHEAD_W8=1省下的 1.18 GiB 会变成 KV 缓存块:在 262144 上下文下我们量到 KV 从 569878 → 628877 tokens(+10.4%)。它是加缓存,不是提速度。
小结
维度 结果 单流 decode 持平 prefill (pp) 持平 单文档 prefix cache 持平(两边都很好) TTFT(短问题) −8.5%(可忽略) 并发吞吐 +80% 多对话缓存 2 个 → 8 个 短问题插长 prefill 最高 43.7× 上下文上限 204800 → 262144 输出质量 29 题无差异 对我们这种会同时开几个长对话、并且经常在 agent 读大文件时追问的场景,第三到第五行的收益是实打实的。如果你只是单对话串行使用,升级主要拿到的是短问题延迟那一项。
以上都是我们在一张卡上的实测,不是标准 benchmark,客户端脚本和 prompt 集是我们自己写的。镜像来自上游仓库,参数已经列在上面。
加上详细测试数据(接主楼)
一、单流 decode 和 TTFT —— 基本持平
n=40,每条 256 tokens:
指标 9 月版 10 月版 差异 decode 中位数 137.34 t/s 137.52 t/s 持平 decode 平均 151.74 t/s 155.89 t/s +2.7% TTFT 中位数 47.2 ms 43.2 ms −8.5% TTFT p90 53.3 ms 48.6 ms −8.8% 报错数 0/40 0/40 — 结论:单流没有任何回退,也没有明显提升。 TTFT 那 4 毫秒的差距,在实际使用里被网络往返盖掉了,可以忽略。
二、并发 —— 提升最大的一项
两个请求同时发,各 512 tokens:
指标 9 月版 10 月版 差异 第 2 个请求的 TTFT 4153 ms 142 ms 29× 整体耗时 8.31 s 4.63 s −44% 聚合吞吐 123.2 t/s 221.3 t/s +80% 9 月版是
--max-num-seqs 1,第二个请求只能排队等第一个跑完(所以 TTFT 4 秒多);10 月版两个请求真的并行,各自还有 116 t/s。三、长文档 prefill(pp)—— 也基本持平
用一份长文档做冷启动,pp 按「输入 tokens ÷ 首字延迟」折算:
文档长度 9 月版 10 月版 129K tokens 2577 t/s — 187K tokens 2225 t/s 2293 t/s 两边都在 2200–2600 t/s 量级,并且都随深度下降(129K → 187K 掉约 14%)。升级没有改变 prefill 性能。
四、长文档重复提问 —— 单文档两边都很好
同一份 187K tokens 的文档,连问三次:
指标 9 月版 10 月版 第一次(冷) 84.19 s 81.70 s 第二次(暖) 1.70 s 1.82 s 缓存命中 99.1% 99.1% 加速比 49.5× 44.8× 这一项 10 月版没有优势 —— 9 月版的 prefix caching 已经能把整份 187K 文档留在缓存里,暖启动 1.7 秒。
五、多个对话并存 —— 真正的差距在这里
同时开 N 个长约 61K tokens 的对话,轮流问(每个都问两轮,看第二轮的缓存命中):
同时打开的对话 总 tokens 9 月版 10 月版 2 × 61K 123K 全部保留— 3 × 50K 150K 全部淘汰 全部保留8 × 61K 492K 不可能(超出上下文) 全部保留9 × 61K 554K — 全部淘汰9 月版的 KV 只有 206K tokens,同时开 3 个约 5 万 token 的对话,缓存就整体失效,之后每次切回某个对话都要重新 prefill(约 15 秒)。10 月版可以稳定保留 8 个这样的对话,总共 492K tokens。
注意:两边的「淘汰点」都明显低于标称容量 —— 9 月版在 60%–73% 之间(60% 还能保留,73% 就全丢),10 月版在 82%–88% 之间。标称数字不能直接当可用容量看。
DSH 实测同时跑五个 sessions,解码速度最低 83 t/s,单跑一个 session 最高 168 t/s。有兴趣可以到这连结看看跑过的 prompts:One Prompt to a 3D Website in 30 Seconds (6 Tested)
六、短问题插在长 prefill 后面 —— 感受最明显的一项
场景很日常:让 agent 读一份大文件(长 prefill 正在跑),这时你问一个 17 个 token 的短问题。
正在 prefill 的长度 9 月版 10 月版 差异 约 24K tokens 4.59 s 1.09 s 4.2× 约 48K tokens 10.93 s 0.61 s 17.9× 约 101K tokens 33.20 s 0.76 s 43.7× 9 月版的短问题延迟会随长上下文线性恶化;10 月版靠
--long-prefill-token-threshold 2048,短问题被插在 prefill 的分块之间执行,延迟稳定在 0.6–1.1 秒,与长文档大小无关。这一项是单用户、单对话就能遇到的,不需要并发。
七、更长的上下文
10 月版把上下文上限开到 262144(实测最大输入约 262K):
9 月版 10 月版 上下文上限 204800 262144 单次 231K tokens 输入 HTTP 400(超限) 冷 111.45 s → 暖 1.55 s(缓存 99.6%,72×)八、输出质量
档位 内容 回答什么 按题目自带预算 每题取题库给的值,120–900 tokens(实际用到 120/150/160/180/200/250/300/400/450/500/600/800/900) 在 benchmark 给的这点预算下,模型到底交不交得出答案(= 日常真正会遇到:被上限截断,而不是不会) 统一 2048 两版都给足 2048 把「品质问题」和「被截断问题」分开,单看内容对不对 定义:预算是每题允许输出的
max_tokens。 我们故意跑两档,因为这两档回答的是不同问题。结果:
预算 9 月版 10 月版 按题目自带预算(120–900) 0.875 0.879 统一 2048 1.000 1.000 结论:在我们这 29 条题上,4-bit KV 没有量到任何质量损失。 需要说明的是题库不大、类别也有限,这只是一个方向性的检查,不等于全面的质量保证。
九、显存表现
满 KV 持续压测(10 分钟持续请求 + 4×90K 长上下文占住缓存):
9 月版 10 月版 显存峰值 93.96% 96.22% 最低剩余 1970 MiB 1234 MiB 完成请求 76/76 452/452 中位 TTFT 0.24 s 0.29 s 10 月版跑得更靠近上限(余量约为 9 月版的 63%),但全程没有出现卡顿。我们用 10 月版新增的
PAITON_VRAM_HEADROOM_MIB=1024来替代 9 月版手动下调--gpu-memory-utilization的做法。 -
-
我感觉r9700 用来跑vllm 27b 效率 好过strata 好多
-
我感觉r9700 用来跑vllm 27b 效率 好过strata 好多
@applejuice Strata 我们也在同一张 R9700 上测过(Qwen3.8-Flash-Next 125B MoE,IQ3_XXS):decode 约 88–91 t/s,长上下文 decode 开 mtp-window 65536 能 +29.7%。但注意模型不同(125B MoE vs 主楼的 27B dense),tok/s 不能直接比。首字延迟 vLLM 明显更好(中位 43ms vs Strata 387–737ms)。
实际使用体验上,27B dense 明显更顺:长 prefill 在跑的时候,短问题 0.6–1.1 秒就能出字;8 个长对话同时保留,切换不重新 prefill。Strata 单流首字就要几百毫秒,日常追问的体感差距很大。
-
@applejuice 所以实际最常用那个模型?
-
@applejuice 所以实际最常用那个模型?
@alan.lgv60 现在还在试用 strata q3_s 为主 27b 为副
-
试用R9700 跑 strata 一阵子,最后还是比较喜欢27B的速度及反应。
-
试用R9700 跑 strata 一阵子,最后还是比较喜欢27B的速度及反应。
我两个都差不多一样
3090x2 驱动的sglang 27b 快在decode
但是 长上下文 prefill strata 有优势
我个人觉得 prefill 比较重要
所以就继续用 -
-
没人讨论radiance 了?
我一直都在用 radiance 现在是 1.3.2 版本B0:0.4.0 R1:1.3.2 原参数 R2:1.3.2 推荐参数 打招呼 / 工具调用 / / / Decode 中文散文 42.3 t/s 63.1 63.2(+49%) Decode 中文对话 52.1 50.3 50.3(−3%) Decode 英文技术 81.1 86.0 86.0(+6%) Decode 代码 180.9 186.8 187.1(+3%) 草稿接受(token/步,中文散文) 1.84 2.24 2.24 Prefill 19K 2,405 t/s 2,353 2,405 Prefill 43K 2,101 2,049 2,155(+3%) KV 池(max-model-len 204800) 348,553 token 333,963 382,060 ~ 393,309 注意力后端 ROCM_AITER_UNIFIED_ATTN 同左 R4D_HYBRID -
没人讨论radiance 了?
我一直都在用 radiance 现在是 1.3.2 版本B0:0.4.0 R1:1.3.2 原参数 R2:1.3.2 推荐参数 打招呼 / 工具调用 / / / Decode 中文散文 42.3 t/s 63.1 63.2(+49%) Decode 中文对话 52.1 50.3 50.3(−3%) Decode 英文技术 81.1 86.0 86.0(+6%) Decode 代码 180.9 186.8 187.1(+3%) 草稿接受(token/步,中文散文) 1.84 2.24 2.24 Prefill 19K 2,405 t/s 2,353 2,405 Prefill 43K 2,101 2,049 2,155(+3%) KV 池(max-model-len 204800) 348,553 token 333,963 382,060 ~ 393,309 注意力后端 ROCM_AITER_UNIFIED_ATTN 同左 R4D_HYBRID @applejuice
是這個嗎?
https://github.com/magiccodingman/vllm-radiance
這個專注在TP=2,所以就沒怎麼關注他了。 -
@applejuice
是這個嗎?
https://github.com/magiccodingman/vllm-radiance
這個專注在TP=2,所以就沒怎麼關注他了。@paul-hou 这个是另一个分支 停留在9月22更新
我用的是 slybase / vllm-sly-radiance 还在更新
paiton 不开源
vllm-sly-radiance 开源Radiance 1.3.2 + R4D_HYBRID Paiton(10-04 测试;数据来自 10-02 构建) 是谁 / 是什么 SlyBase,基于官方 vLLM 0.31 的开源补丁集 Eliovp-BV(一家公司):vLLM 插件(vLLM 0.29),内核由其专有编译器生成 谱系 Radiance 系(StillDeadcode 的 libr4d + ggz14 的 MXFP4) 独立,自有内核 模型权重 AMD 官方 Quark MXFP4(4-bit) unsloth NVFP4(4-bit),或其自家的 3-bit W3A4(用于长上下文) 上下文 + 视觉 200K 含视觉(应可支持到约 262K) 4-bit:65K 含视觉,或 200K 不含视觉。3-bit + KV4:262K(视觉未测试) KV 缓存 fp8,393K token 池 fp8;长上下文模式下用 KV4(4-bit),8 个对话共约 492K token 解码:中文长文 / 中文对话 / 英文 / 代码 63.2 / 50.3 / 86.0 / 187.1 54.1 / 54.6 / 89.0 / 186.8 预填充 19K / 43K 2,405 / 2,155 3,044 / 2,855(+27–32%) 推理质量(12 题测试集) 12/12(在 0.4.0 上测得,权重相同) 11/12,另有 2 次运行卡在 32K 思考上限 工具调用 / 推理解析器 更新 开源,非常活跃 公司发布(最近一次见于 10-05) -
@paul-hou 这个是另一个分支 停留在9月22更新
我用的是 slybase / vllm-sly-radiance 还在更新
paiton 不开源
vllm-sly-radiance 开源Radiance 1.3.2 + R4D_HYBRID Paiton(10-04 测试;数据来自 10-02 构建) 是谁 / 是什么 SlyBase,基于官方 vLLM 0.31 的开源补丁集 Eliovp-BV(一家公司):vLLM 插件(vLLM 0.29),内核由其专有编译器生成 谱系 Radiance 系(StillDeadcode 的 libr4d + ggz14 的 MXFP4) 独立,自有内核 模型权重 AMD 官方 Quark MXFP4(4-bit) unsloth NVFP4(4-bit),或其自家的 3-bit W3A4(用于长上下文) 上下文 + 视觉 200K 含视觉(应可支持到约 262K) 4-bit:65K 含视觉,或 200K 不含视觉。3-bit + KV4:262K(视觉未测试) KV 缓存 fp8,393K token 池 fp8;长上下文模式下用 KV4(4-bit),8 个对话共约 492K token 解码:中文长文 / 中文对话 / 英文 / 代码 63.2 / 50.3 / 86.0 / 187.1 54.1 / 54.6 / 89.0 / 186.8 预填充 19K / 43K 2,405 / 2,155 3,044 / 2,855(+27–32%) 推理质量(12 题测试集) 12/12(在 0.4.0 上测得,权重相同) 11/12,另有 2 次运行卡在 32K 思考上限 工具调用 / 推理解析器 更新 开源,非常活跃 公司发布(最近一次见于 10-05)


