【求助】13700K + 4070Ti SUPER 16G + 5060Ti 16G,双卡跑 Strata 反而不如单卡,PCIe 3.0 x4 是瓶颈吗?有没有更好的优化方案?
-
标题
求助:13700K + 4070TiS 16G + 5060Ti 16G,双卡 Strata 反而比单卡慢,PCIe x4 是瓶颈吗?
正文
最近在折腾 Strata 跑 Qwen3.8-Flash-Next IQ3_S,遇到一个问题,想请教一下论坛里的高手。
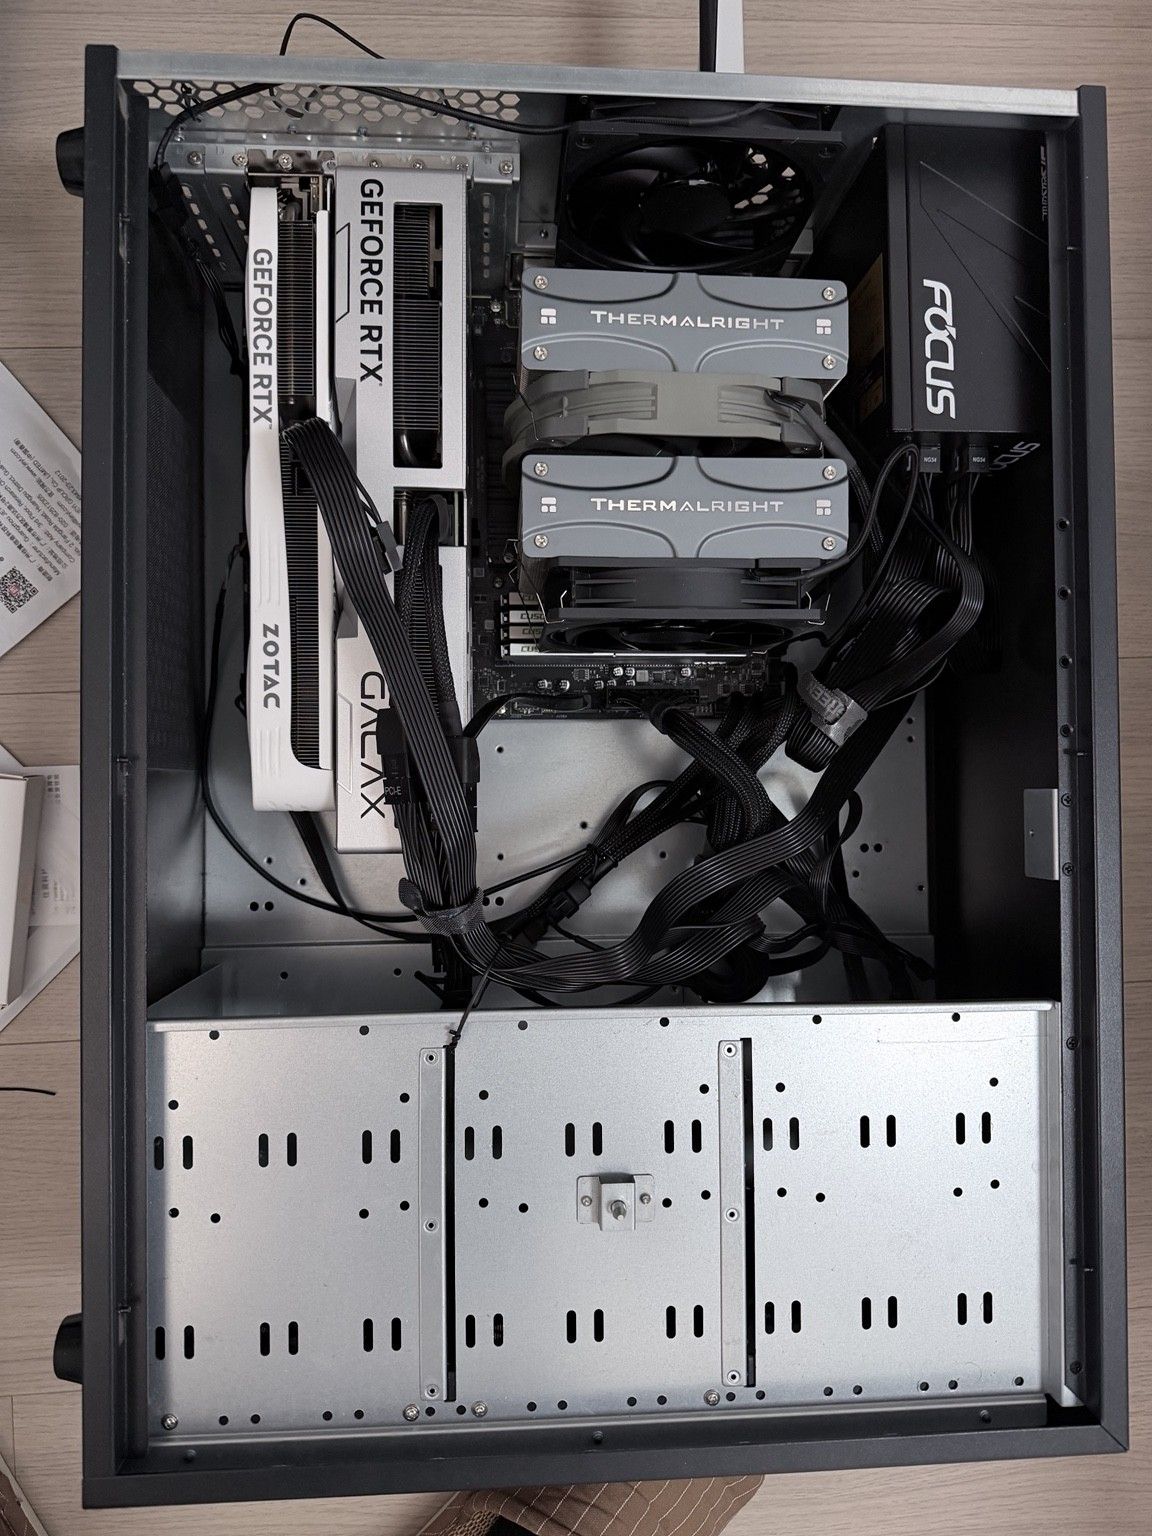
目前配置:- CPU:i7-13700K
- 主板:微星 Z690-A DDR4
- 显卡①:4070Ti SUPER 16G(CPU 直连 PCIe 4.0 x16)
- 显卡②:5060Ti 16G(芯片组 PCIe 3.0 x4)
- 内存:128GB DDR4-3200
- 硬盘:4 个 M.2 插槽全部占满
目前遇到的问题:
测试过 Strata 单卡、双卡 Layer Split、Helper 等模式,结果双卡虽然部分测试的 Decode 更快,但整体响应反而不如单卡。
目前只能使用 4070Ti SUPER 单卡 + 13700K CPU 专家计算,5060Ti 基本闲置。
之前固定输入测试:
模式 Prefill Decode
单卡 1777 tok/s 59.5 tok/s
双卡 Layer Split 397 tok/s 57 tok/s
双卡 Helper 1077 tok/s 68 tok/s
Helper + REO — 82.5 tok/s
现在比较纠结的是:
第二张 5060Ti 只有 PCIe 3.0 x4,实测传输带宽约 3.6GB/s,不知道是不是双卡效率低的主要原因。
考虑过换 X570 ACE / UNIFY,配手里闲置的 5800X,实现 CPU 直连 PCIe 4.0 x8/x8。
但这样又会损失 13700K 的 CPU 性能![替代文字]
想请教大家:- Strata 双卡性能差,PCIe 3.0 x4 是不是主要瓶颈?
- 换 X570 + 5800X,实现 CPU 直连 x8/x8,值得吗?会不会反而更慢?
- 不换主板的话,有没有办法更好地利用第二张 5060Ti?比如 Peer / Helper 优化,或者其他方案?
主要追求实际推理速度和稳定性,不是单纯跑分。
有没有类似配置的朋友分享一下经验?感谢!
-
应该是,我是双卡3090。 有时候我观察它的后台,PCIE4.0那里瞬时最高能冲到22G/S甚至40多G/S。
而我开机未加载模型的时候测试,单向P2P带宽是23G,双向35G。 它那个图表的数值不太准确,有虚高。 另外消费级CPU似乎只有20条PCIE通道,你如何分配? -
-
应该是,我是双卡3090。 有时候我观察它的后台,PCIE4.0那里瞬时最高能冲到22G/S甚至40多G/S。
而我开机未加载模型的时候测试,单向P2P带宽是23G,双向35G。 它那个图表的数值不太准确,有虚高。 另外消费级CPU似乎只有20条PCIE通道,你如何分配?@stxpnet 感谢回复!我用的是 13700K + 微星 Z690-A DDR4。
目前 4070Ti SUPER 走 CPU 直连 PCIe 4.0 x16,5060Ti 走 Z690 芯片组 PCIe 3.0 x4,实测副卡 H2D 带宽只有约 3.6GB/s。
13700K 的 20 条 CPU 直连通道是显卡 16 条 + NVMe 4 条,我这块主板不支持把显卡通道拆成 x8/x8,所以副卡只能走芯片组。
之前测试 Strata 双卡 Layer Split,Prefill 反而比单卡慢很多,Helper 模式 Decode 有提升,但整体耗时还是单卡更快。
想请教一下,你双 3090 用的是什么 CPU 和主板?Strata 是 Layer Split 还是 Peer/Helper 模式?
另外,你提到的 PCIe 40GB/s 是 Strata 后台统计值,还是实际测出来的 P2P 带宽?
我主要想判断副卡走芯片组 x4,是不是造成双卡性能下降的主要原因。 -
一、一句话结论
Layer Split 崩得难看,根因就是副卡 PCIe 3.0 x4(实测 3.6GB/s);而 Helper + REO 已经是你配置下的正确答案,只是没调到底。 换 X570 + 5800X 不值,理由见下。
二、你的数据说明了什么
模式 Prefill Decode 诊断 单卡 4070TiS 1777 59.5 基线:专家全在主卡+CPU,零跨链流量 双卡 Layer Split 397 57 两卡串行流水,每个 token 的激活都要跨链传一次,整条链被 3.6GB/s 钳死——典型木桶效应,prefill 掉 78% 双卡 Helper 1077 68 prefill 时冷专家权重经慢链路搬运,仍被拖;decode 已开始反超 Helper + REO — 82.5 专家权重驻留副卡,decode +39%,唯一正收益,方向对了 三、瓶颈判定(按权重排序)
- Layer Split 模式下:PCIe 3.0 x4 是致命瓶颈。Layer Split 要求卡间激活逐层接力,等效带宽 = 慢的那条链,3.6GB/s 对比 Gen4 x16(我双 3090 实测单向 P2P ~23GB/s)差了近 7 倍。
- Helper 模式下:次要瓶颈变成 13700K + DDR4 双通道。冷专家 CPU 计算吃的是内存带宽,DDR4-3200 双通道 ~50GB/s,这是你 decode 的天花板。
- 副卡 5060Ti 本身算力不弱,16G 也够,问题全在"路窄"。
四、换 X570 + 5800X 值不值?——不值
对比项 13700K + Z690 5800X + X570 x8/x8 双卡卡间带宽 3.6GB/s(芯片组) ~16GB/s(Gen4 x8 直连) 
内存带宽 ~50GB/s ~50GB/s(同为双通道 DDR4) 单核/prefill 更强 更弱 你的 decode 下限由CPU 内存带宽决定,两者打平;prefill 反而 13700K 更强。为了修一个已经能绕开的模式(Layer Split),牺牲整体 CPU 性能,不划算。
五、不换主板的改善建议
优先级 措施 预期收益 1 现役模式固定 Helper + REO,弃用 Layer Split decode 已到 82.5 2 加大热专家数量、用 -ot把 attention/共享层锁死在 4070TiS,让 CPU 只算最冷的专家decode 继续↑ 3 把尽量多的冷专家权重放进 5060Ti 的 16G(借副卡显存替 CPU 挡专家),REO 保证命中率 释放 CPU 内存带宽 4 按输入长度切模式:短输入聊天/代码用双卡 Helper+REO(decode 快 39%),长文档重 prefill 场景切单卡(prefill 快 65%),写个一键切换脚本 总响应时间最优 5 内存条件允许时量化升档 IQ3_S→IQ4_XS:专家计算量不变、质量更好;若 CPU 侧放不下则维持现状 质量↑ 六、 补充说明
我双 3090 走的是 Gen4 x16/x16 直连,后台那个瞬时 22~40GB/s 确实虚高(仪表统计含重复计数),实测单向 P2P 23GB/s、双向 35GB/s 才是真实值。
楼主副卡 3.6GB/s 只有这套链路的 1/7,所以我的 Layer Split 能跑、他的跑不动——同引擎,链路带宽决定模式选择:链路差就坚定走 Helper + REO,别恋战 Layer Split。我让GLM 5.1 flash分析的。
双卡3090 PCIE 4.0 16X/16X
白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s 夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s -
一、一句话结论
Layer Split 崩得难看,根因就是副卡 PCIe 3.0 x4(实测 3.6GB/s);而 Helper + REO 已经是你配置下的正确答案,只是没调到底。 换 X570 + 5800X 不值,理由见下。
二、你的数据说明了什么
模式 Prefill Decode 诊断 单卡 4070TiS 1777 59.5 基线:专家全在主卡+CPU,零跨链流量 双卡 Layer Split 397 57 两卡串行流水,每个 token 的激活都要跨链传一次,整条链被 3.6GB/s 钳死——典型木桶效应,prefill 掉 78% 双卡 Helper 1077 68 prefill 时冷专家权重经慢链路搬运,仍被拖;decode 已开始反超 Helper + REO — 82.5 专家权重驻留副卡,decode +39%,唯一正收益,方向对了 三、瓶颈判定(按权重排序)
- Layer Split 模式下:PCIe 3.0 x4 是致命瓶颈。Layer Split 要求卡间激活逐层接力,等效带宽 = 慢的那条链,3.6GB/s 对比 Gen4 x16(我双 3090 实测单向 P2P ~23GB/s)差了近 7 倍。
- Helper 模式下:次要瓶颈变成 13700K + DDR4 双通道。冷专家 CPU 计算吃的是内存带宽,DDR4-3200 双通道 ~50GB/s,这是你 decode 的天花板。
- 副卡 5060Ti 本身算力不弱,16G 也够,问题全在"路窄"。
四、换 X570 + 5800X 值不值?——不值
对比项 13700K + Z690 5800X + X570 x8/x8 双卡卡间带宽 3.6GB/s(芯片组) ~16GB/s(Gen4 x8 直连) 内存带宽 ~50GB/s ~50GB/s(同为双通道 DDR4) 单核/prefill 更强 更弱 你的 decode 下限由CPU 内存带宽决定,两者打平;prefill 反而 13700K 更强。为了修一个已经能绕开的模式(Layer Split),牺牲整体 CPU 性能,不划算。
五、不换主板的改善建议
优先级 措施 预期收益 1 现役模式固定 Helper + REO,弃用 Layer Split decode 已到 82.5 2 加大热专家数量、用 -ot把 attention/共享层锁死在 4070TiS,让 CPU 只算最冷的专家decode 继续↑ 3 把尽量多的冷专家权重放进 5060Ti 的 16G(借副卡显存替 CPU 挡专家),REO 保证命中率 释放 CPU 内存带宽 4 按输入长度切模式:短输入聊天/代码用双卡 Helper+REO(decode 快 39%),长文档重 prefill 场景切单卡(prefill 快 65%),写个一键切换脚本 总响应时间最优 5 内存条件允许时量化升档 IQ3_S→IQ4_XS:专家计算量不变、质量更好;若 CPU 侧放不下则维持现状 质量↑ 六、 补充说明
我双 3090 走的是 Gen4 x16/x16 直连,后台那个瞬时 22~40GB/s 确实虚高(仪表统计含重复计数),实测单向 P2P 23GB/s、双向 35GB/s 才是真实值。
楼主副卡 3.6GB/s 只有这套链路的 1/7,所以我的 Layer Split 能跑、他的跑不动——同引擎,链路带宽决定模式选择:链路差就坚定走 Helper + REO,别恋战 Layer Split。我让GLM 5.1 flash分析的。
-
-
补充几点,跟 @stxpnet 上面的结论互补:
-
Layer Split 在你这套配置下基本没救:每个 token 的激活都要逐层过那条 3.6GB/s 的芯片组链路,等效带宽被最慢一环钳死,prefill 掉 78% 就是木桶效应。Helper + REO 的 82.5 t/s 已经是这套硬件的高点了,方向对了。
-
换 X570 + 5800X 不值:x8/x8(~16GB/s)确实能救 Layer Split,但 Helper 模式下 decode 的天花板是 CPU 内存带宽(DDR4 双通道 ~50GB/s),两者打平;同时你拿 13700K 的 prefill 单核优势换成 5800X,反而更弱。
-
别只把 5060Ti 当「第二段层」。它是 Blackwell、原生 NVFP4;4070TiS 是 Ada,没有。更划算的用法是当专用副卡:独立跑一个 NVFP4 量化模型 / 视觉 OCR·mmproj / 或当 MTP draft 卡,主卡专心 dense 推理。这些负载对芯片组 x4 不敏感,闲置就浪费了。
-
对比用端到端 wall-clock,别信 Strata 后台那个 PCIe 读数(瞬时虚高)。固定同 prompt、同 ctx、同 batch,单卡 vs Helper+REO 各跑几轮取中位。
-