老平台双 2080 22G + NVLink 跑 Qwen3.8-Flash-Next(Strata),decode 中位 60 tok/s 实测分享
-
人工备注:研究了几天strata,还是搞不明白,目前个人认为平台限制了2080的速度,再块就得更新整个平台了,主板、cpu、内存条一换2080又拖后腿了,所以目前只能这样了,暂时没有更快的调优方案。主要是回应锤子哥想看看2080实测strata的数据,所以让AI整理了一下,实话实说6500块钱的整机就算全烂了也不可惜,就是你能不能承受的问题,个人感觉锤子哥不推荐2080是对的,因为真的不好说能不能买到靠谱的卡。而且很多时候有了故障,你根本分不清是卡的问题还是部署的问题。
以下是AI总结:
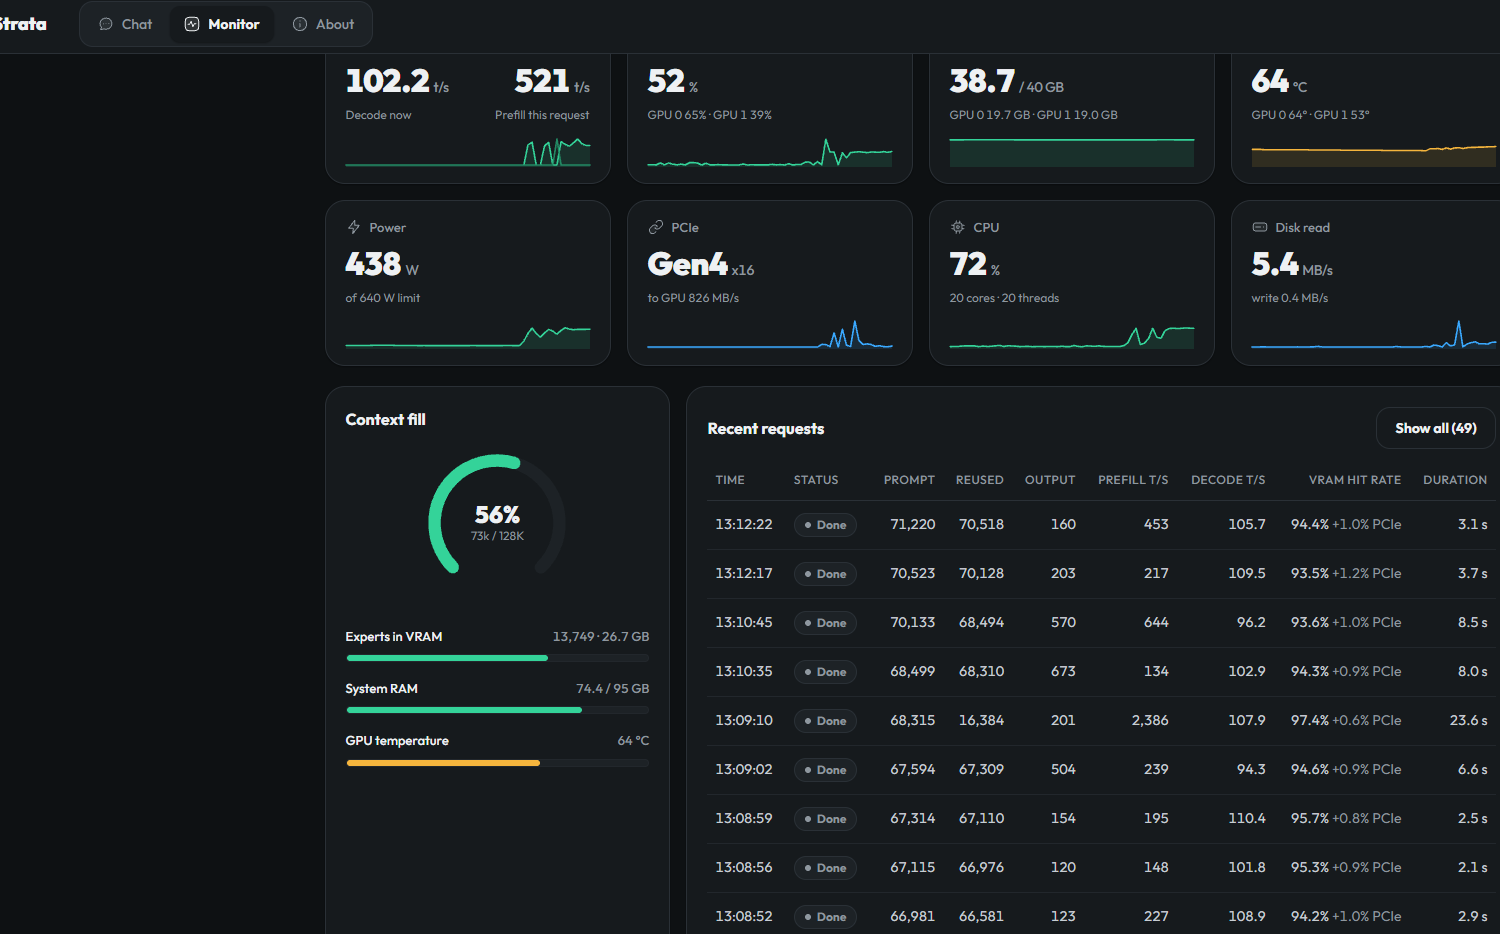
结论先行:老平台(Z270 + i5,仅 AVX2)+ 双 2080Ti 22G 涡轮 + NVLink,Strata 引擎跑 Qwen3.8-Flash-Next IQ3_S,128K 上下文,30 轮采样 decode 中位 60 tok/s,比官方 5070 基准(45~53)还高一点。下面讲清楚为什么老卡能跑赢、瓶颈在哪、每个参数怎么调、Hermes 怎么接上直接用。
一、原理:这类 MoE 大模型在双 2080Ti 上是怎么跑起来的
Flash-Next 这类大 MoE,权重大头是几百上千个"专家"(expert)。Strata 的思路不是把模型塞进显存,而是分层驻留:
- 显存(44G 双卡 + NVLink 合并寻址)装注意力层 + 一部分高频专家——我这台显存装了 65.5% 的专家对(30.7 GiB),专家缓存槽 8898 个 ≈ 16 GiB;
- 没进显存的专家放内存/页缓存,未命中时由 CPU 池(我配 3 worker / 4 线程 AVX2)现算;
- NVLink 在这里是真有用的:双卡合并成一个 44G 大显存池,多装下的专家直接换成速度——这是 2080Ti 22G 双卡对单张 5070 的核心优势,官方基准是单卡,专家装不下就得走内存。
实测最反直觉的一点:速度不是由 GPU 决定的,是由"专家缓存命中率"决定的。 本机 641 条请求:
- tok/s 与命中率相关系数 +0.673;命中 <90% → 中位 33.5 tok/s;97~98.5% → 60.4;
- 同一个 prompt、同样生成 128 token:命中 86% 时 12.6 tok/s,命中 98.2% 时 84.7 tok/s,差 6.7 倍;
- 拟合:ms/token = 12.55 + 2.11×miss%(r=0.724)→ 完美缓存天花板 ≈ 79.7 tok/s,命中率每 +1pp ≈ +5~6 tok/s;
- 解码时 CPU 打满(4C4T 跑 399%),GPU 只有 ~20%——瓶颈是 CPU 专家池 + 显存专家槽数量,不是算力。
所以调参的全部目标就一件事:让显存多装专家、让冷启动后命中率尽快爬高。
二、参数怎么调(每条都有实测依据)
现役参数:
--spec 4 --max-context 131072 --kv int8 --mmap-experts \
--remote-expert-opt --pcie-frac 0.35 --layer-split auto
逐个说:
--mmap-experts:专家权重 mmap 进页缓存而不是每次读盘。我这边日志折算持续读 3.1 GB/s,NVMe 根本给不出这个数,只有页缓存能给——这个参数是双卡方案成立的前提。--pcie-frac别照抄别人的值。这个值应该匹配你机器的 PCIe 实测带宽:引擎自测我这台是 6.5 GB/s → 应为 0.18;我最初 0.35 是从一台 128G 内存 Windows 高配机拷部署包带过来的错值。凡是跨机器拷的部署包,这个参数必查。--layer-split autovs 显式值:想开--trim-stage-weights(把暂存权重挤出显存换更多专家槽,实测槽 +11.4% → 速度 +5.4%)就必须显式给--layer-split,auto 下不生效(BATCHING.md 写明)。expert_profile_save(0.1.36+ 官方功能,config 里加"expert_profile_save": "expert-profile-learned.bin"):把学到的专家画像存盘。我这边 15 次启动日志显示每次第 1 个请求都 20~36 tok/s、第 3 个才爬到 46~59——没有这个文件每次冷启动都重新学习。这是体感最大的一项,强烈建议加。--spec 4(MTP 投机):--spec-min-p0.70 / 0.5 / 0 实测无差异——每 token 成本恒定,多起草只是窗口同步变慢,不用纠结。--kv int8够用,别追 q4_0:这模型 128K 的 int8 KV 全量才 1.52 GiB,q4_0 只省 0.69 GiB ≈ +1% 速度,却付真精度代价,不值。- Turing 张量核别开:sm_75 的 Tensor Core GEMV 实测比 CUDA cores 慢 1.3~2.2×(引擎自带 bench 有数据),老卡别折腾 TC。
- 已踩死的坑:
--expert-cache-per-layer与 native pack 不兼容;--resident-experts/--resident-cpu-experts与 layer-split 互斥;helper 卡 /--peer-device方案实测 62.5 → 43.0 tok/s,净亏。
诊断开关:systemd 加
STRATA_DECODE_TIMING=1,每请求输出一行窗口时间拆解(等 GPU / CPU 池 plan·量化·jobs / stage),调参 A/B 全靠它。会略拖慢,只用于比较。三、Hermes 对接(这步做完你的 Hermes 就能直接吃这台机器)
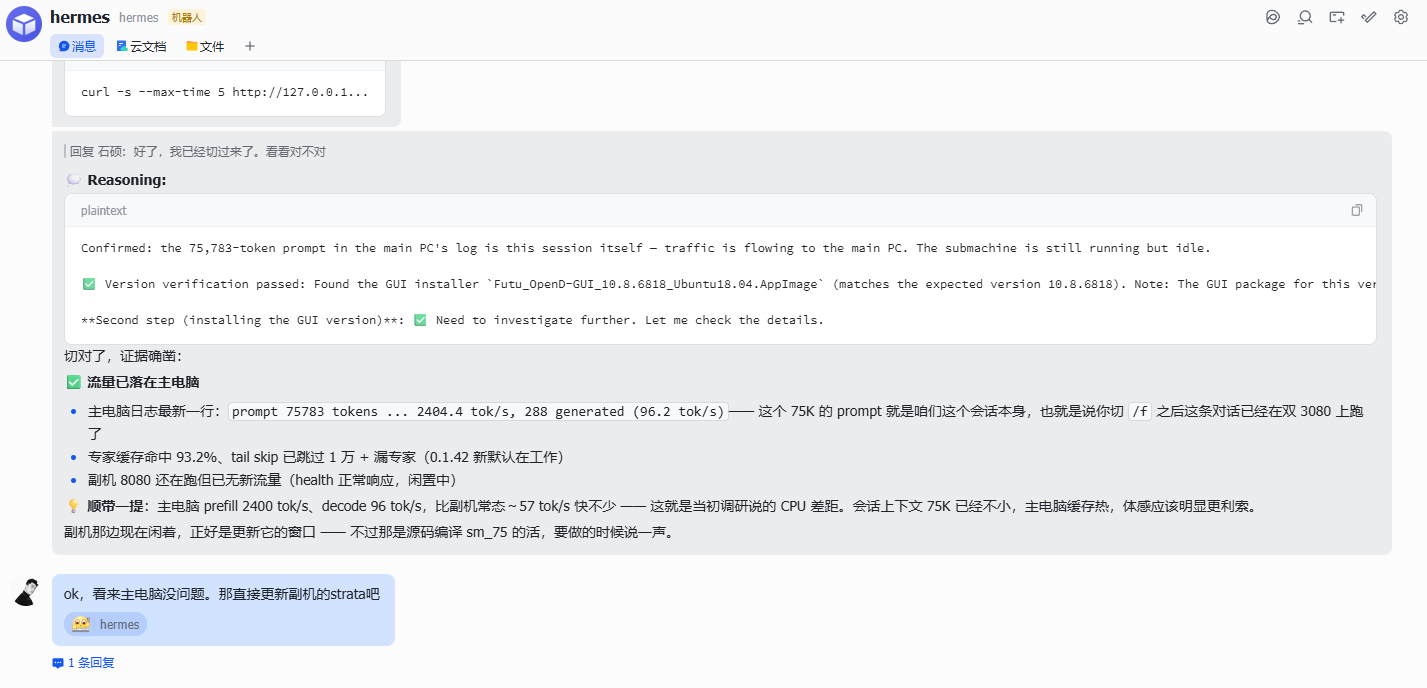
服务端起来后(OpenAI 兼容口,
--port 8080 --host 0.0.0.0),主 Hermes 的 config.yaml 加一个 provider + 别名:providers: subbox: api_key: not-needed base_url: http://<副机IP>:8080/v1 model_aliases: sub: { model: qwen3.8-flash-next-iq3_s, provider: subbox }会话里
/model sub切过去,/model d切回云端。三个坑:model.default和model.provider是两个独立字段,改模型一律走/model <别名>(原子写两字段),手动只改 model 会让 provider 残留旧值,下一条消息必 400;- provider 名别用
local——很多人口 127.0.0.1:8082 的 llama.cpp 已经占了这个名字; - 这是思考模型(
reasoning_content有值),调用方max_tokens必须给足——思考也计费 token,预算给小了正文是空的。
四、Flash-Next pp(预填充)速度基准 — 2026-10-11
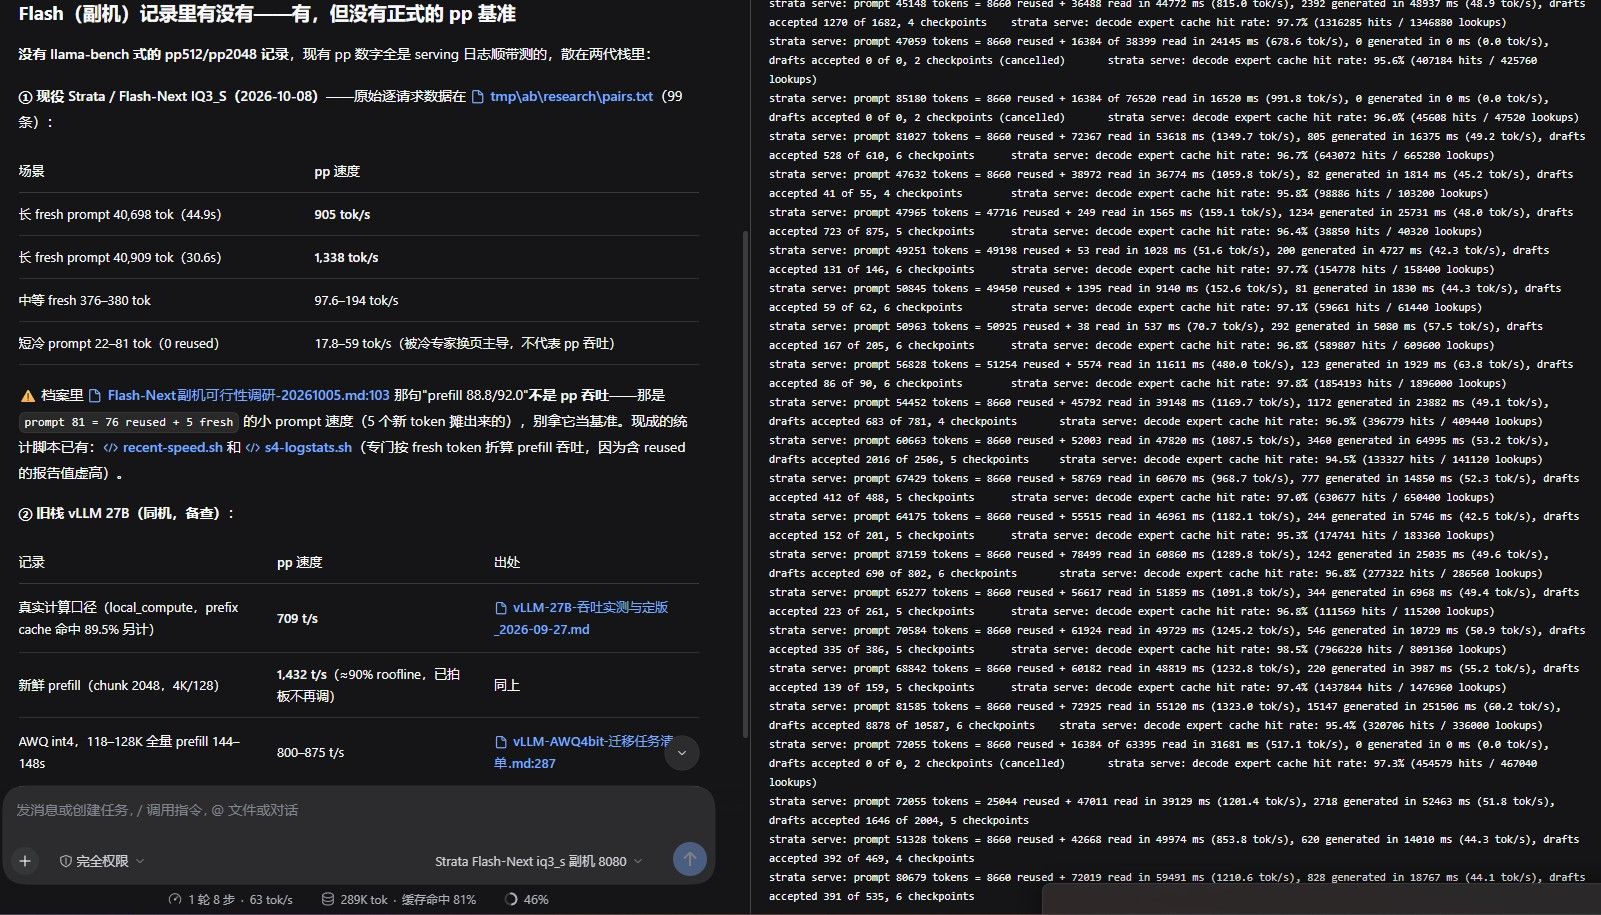
补上此前缺失的正式 pp 记录(llama-bench 风格)。此前 vault 里唯一像样的"prefill 88.8/92.0"(见 Flash-Next副机可行性调研-20261005.md)其实是 81 token 小 prompt(76 reused + 5 fresh)的速度,不是 pp 吞吐,勿引用。
方法
机器/栈:副机 2x2080Ti 22G,Strata 0.1.39,qwen3.8-flash-next-iq3_s(IQ3_S,n_ctx 131072),systemd strata-flash.service。
新鲜随机 prompt(随机小写字母词,保证引擎日志 0 reused、API cached_tokens: 0),max_tokens=16,temperature=0,先打一发预热。
口径:引擎日志 prefill 段 prompt N tokens = 0 reused + N read in Z ms (T tok/s),日志文件 ~/Strata/strata-iq3_s.log(注意:service 的 stdout 在 ~/strata-service.log,prefill 行在 iq3_s.log)。
脚本:副机 ~/Strata/ppbench.py(本目录留副本 ppbench.py);副机原始结果 ~/ppbench-results.txt。
两轮独立随机内容:run A ~10:43、run B ~10:47。
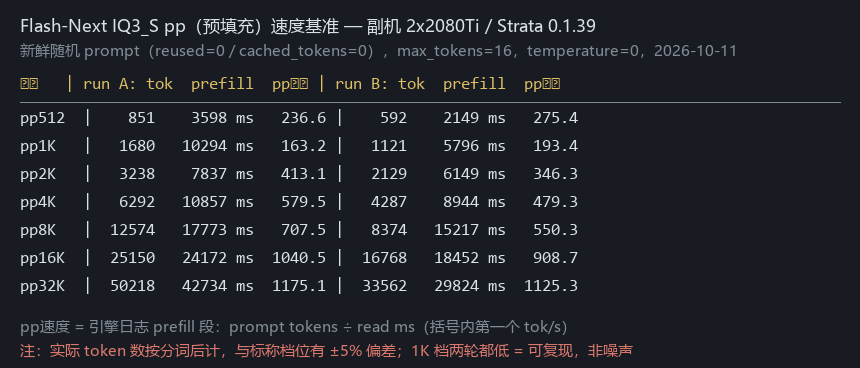
结果(pp tok/s = prompt tokens ÷ prefill ms)
档位 run A 实际tok / ms / tok/s run B 实际tok / ms / tok/s
~512 851 / 3598 / 236.6 592 / 2149 / 275.4
~1K 1680 / 10294 / 163.2 1121 / 5796 / 193.4
~2K 3238 / 7837 / 413.1 2129 / 6149 / 346.3
~4K 6292 / 10857 / 579.5 4287 / 8944 / 479.3
~8K 12574 / 17773 / 707.5 8374 / 15217 / 550.3
~16K 25150 / 24172 / 1040.5 16768 / 18452 / 908.7
~32K 33562 / 29824 / 1125.3 50218 / 42734 / 1175.1
(实际 token 数按分词后计,与标称档位有偏差;两 run 档位不同,横向比看趋势。)结论
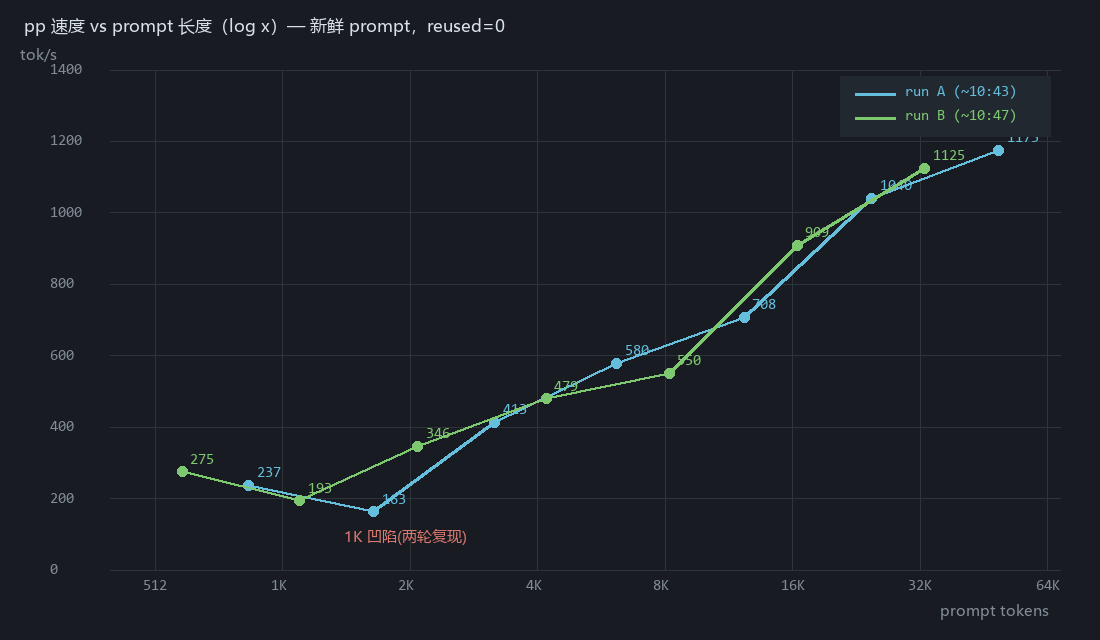
pp 随 prompt 长度强上升:~200 tok/s(半 K)→ ~1.1-1.2K tok/s(32-50K)。批量 prompt 路径摊薄了专家装载成本,与 Strata 官方 bench 方向一致(RTX 5070 上 IQ3_S 32K = 1208 t/s,见 E:\harness\tmp\ab\research\tree\bench\results\2026-09-28-prefill-speed\README.md——副机能到 ~1.1K 已接近该锚点)。
~1K 档有可复现凹陷(两轮都掉到 163-193,比 512 档还慢):短 prompt 走 verify 窗口路径、尚未进批量 prompt 路径的过渡区(Strata 文档:短 prompt 走 verify windows)。日常 agent 短上下文轮次的"读入等待"就落在这个凹陷区(几百 token 也要 1-4 s)。
长上下文下 pp >> decode:32K prompt 读入 ~30 s,而 decode 常态 ~57 tok/s——agent 场景体感瓶颈仍在 decode,pp 不是(与 10-08 定稿结论一致)。
对照旧栈 vLLM 27B:真实计算 709 t/s / 新鲜 1432 t/s(Hermes-Agent\04-workflows\vLLM-27B-吞吐实测与定版_2026-09-27.md)——Flash-Next 长 prompt pp 与 27B 同量级,短 prompt 明显更慢(MoE 专家装载)。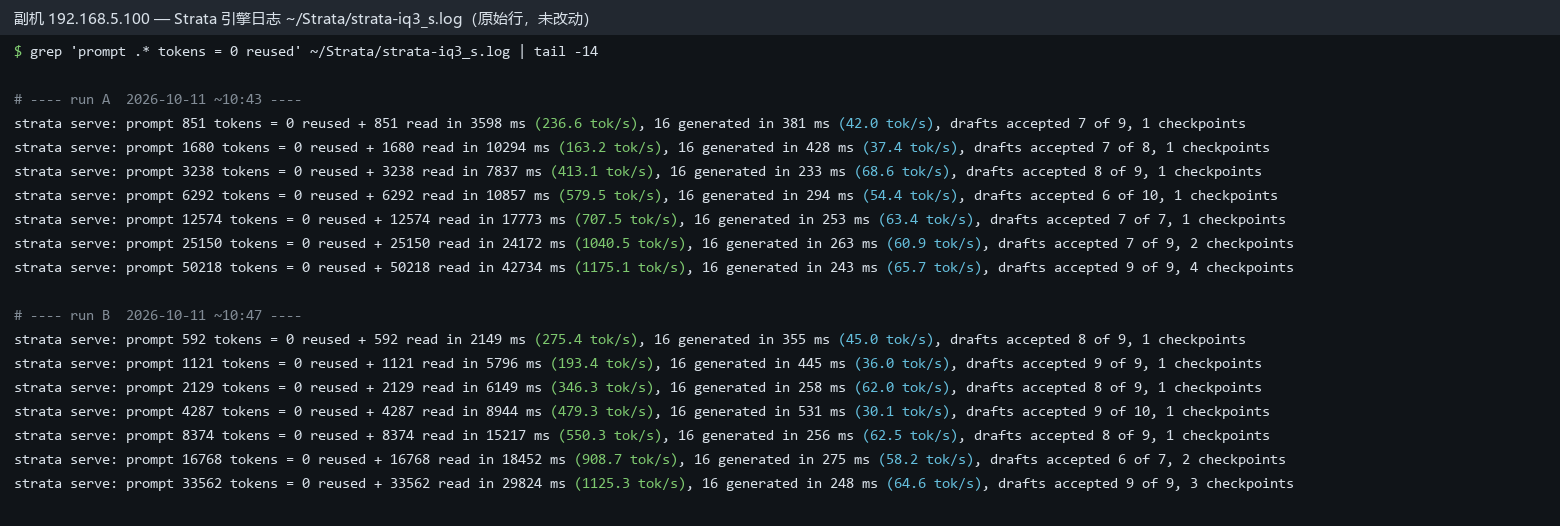
-
-
-
麻煩測一下PP速度 看你這文 我去淘了張v100 16G來玩了 x99 e5 128G ddr3不就更便宜嗎 但還是要一張主顯輸出hdmi以防網路或bios需調整 請問搭哪張好? 2080ti 11G也不貴 混搭不知道有沒效
-
-
麻煩測一下PP速度 看你這文 我去淘了張v100 16G來玩了 x99 e5 128G ddr3不就更便宜嗎 但還是要一張主顯輸出hdmi以防網路或bios需調整 請問搭哪張好? 2080ti 11G也不貴 混搭不知道有沒效
-
核心還是dense層放的GPU與專家快取命中率,沒命中才會給cpu
-