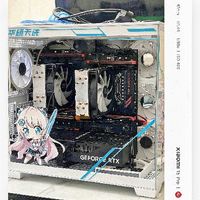
3080魔改版20G,昨天解锁成功
-
-
-
-
-
-
-
-
-
-
-
有测试过单卡3080跑qwfn么?
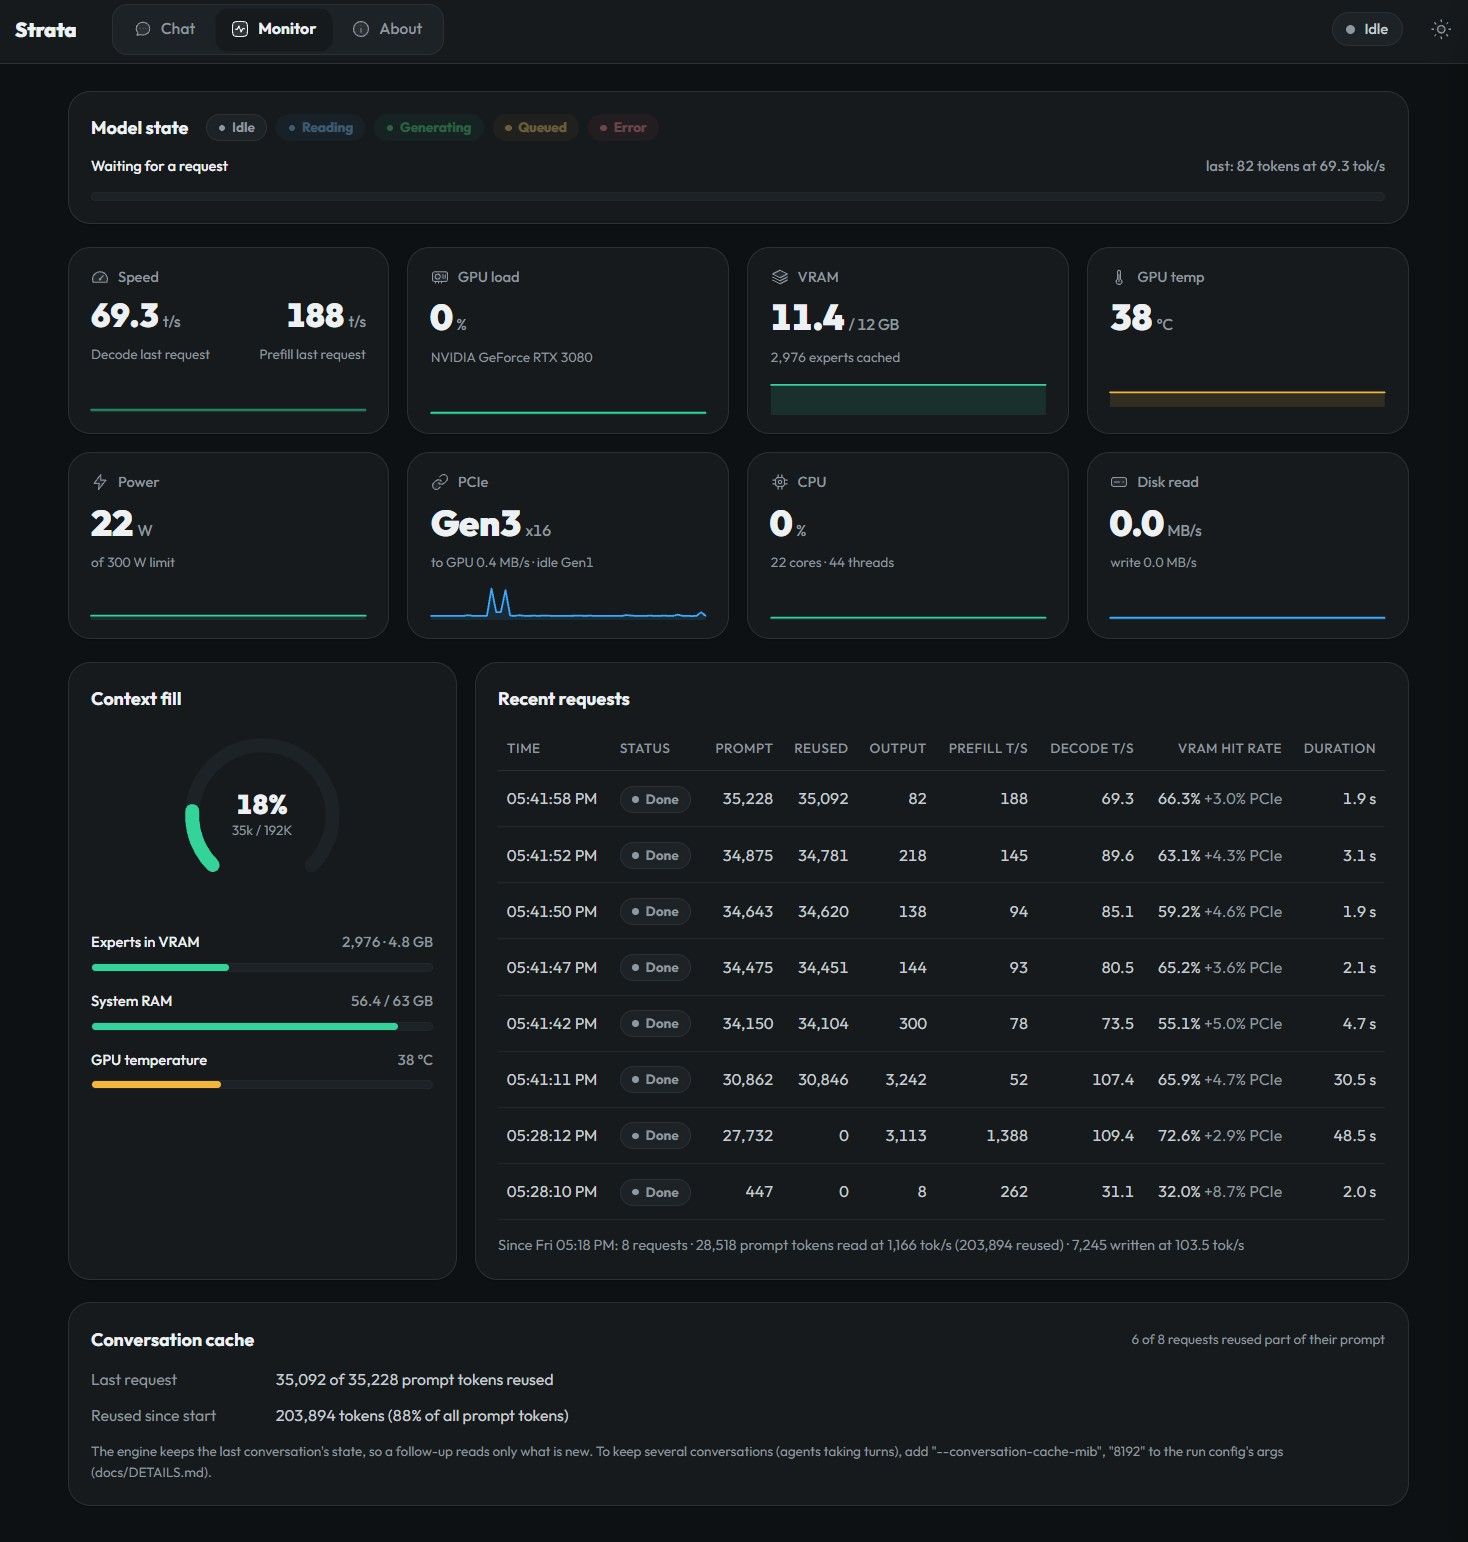
@Hackner-Weinland 我的是 3080 12GB 跑 qwen3.8-flash-next-iq3_xxs
-
-
-
这是解锁之后的么?魔改20g的3080 长上下文prefill有多少?
@Hackner-Weinland
我的卡是 RTX 3080 12GB(不是魔改 20G),所以魔改 20G 的长上下文 prefill 我没有直接数据。不过同型 3080(12GB)解锁前后的 A/B 我跑过(X99-TF,Strata iq3_xxs 0.1.46,CUDA engine,ctx 196608,k8v4,spec 4,pcie-frac 0.2):
prompt 长度 未解锁 prefill (tok/s) 解锁后 prefill (tok/s) 差异 ~3.9K 884 879 -0.6% ~14.7K 1472 1495 +1.6% ~43K 1446 1471 +1.7% 解锁对 prefill 影响很小(±2% 以内),原因可能是 3080 12GB 跑 iq3_xxs 是 expert streaming / VRAM-bound,不是 tensor-compute-bound——解锁放开的是 tensor 算力,但瓶颈不在那里。
长上下文(43K prompt)cold prefill 大约 1470 tok/s,decode 约 98–112 tok/s。
魔改 20G 的话,VRAM 多 8GB,expert cache 能多放一些,decode 可能略好,但 prefill 应该跟 12GB 差不多(同样 GPU-bound)。如果楼主有魔改 20G 的 prefill 数据,会很有参考价值。
-
GPU 为什么会被锁算力?
类型 原因 能否解锁
制造缺陷屏蔽 某些 SM 或缓存单元不合格,关闭后其余部分仍可正常工作 通常不应解锁
产品分级限制 同一芯片用于不同价位产品,主动限制部分功能或吞吐 部分可以
固件或驱动限制 通过寄存器、固件、驱动实施速率或功能限制 取决于机制
显存容量限制 物理显存存在,但只有一部分被启用 部分可以,但不保证稳定你看到的 RTX 3080/3090 这次解锁,主要属于第三类,背后的商业动机则与第二类有关。
它不是把坏掉的 CUDA 核心修好,也不是凭空增加晶体管,而是让已有的计算单元以更高的许可速率执行特定运算。
RTX 3080/3090 解锁到底发生了什么?
社区使用的是 Zagitta/gpu-unlock 项目。
它通过 Linux 内核模块,在 NVIDIA 驱动接管 GPU 前修改部分计算速率选择器,使原本被限制的 FP16/BF16 张量运算获得更高吞吐。






 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!