
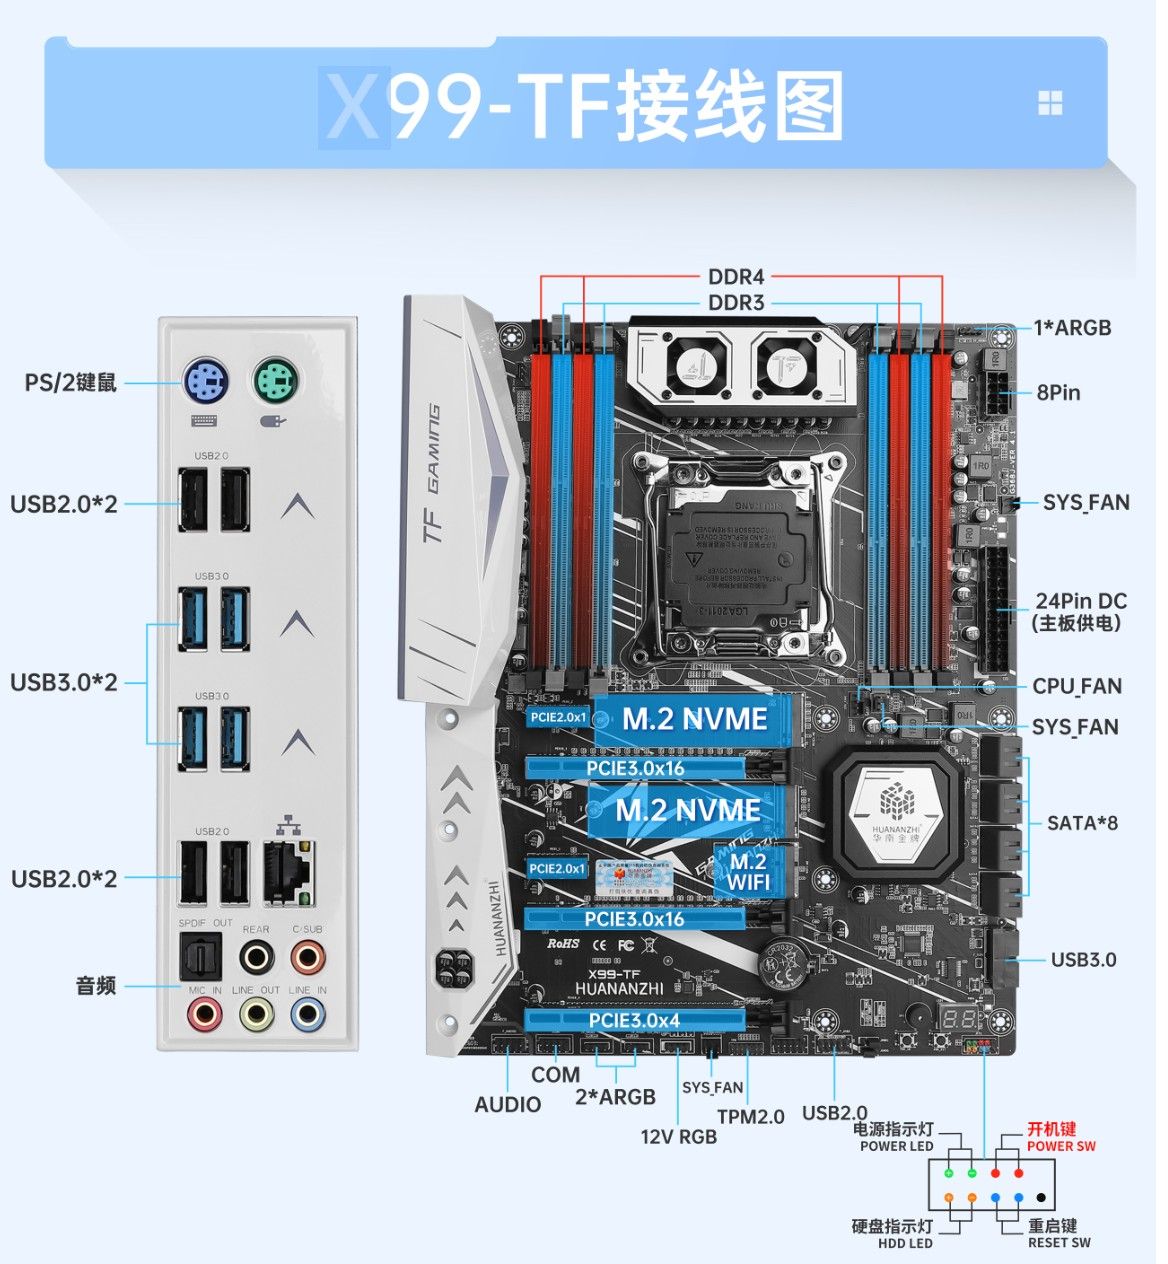
给想要配X99+ddr3内存的兄弟们一点经验!
-
-
-
@gao-Gao我目前看服务器上面的~/stratamon.sh -w 会在40-80之间。
DSH里面对话的速度基本就是55-65之间,
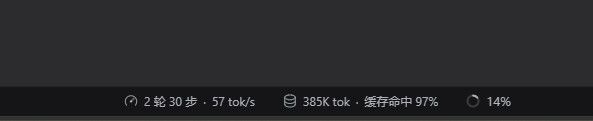
这个我就让DSH配置的,然后让他自己看有没有什么加速的方法,让它自己找,然后测试,一觉醒来就这样了。
具体怎么配置我也不知道,全给它,你就看速度就行了。速度不够先去网页问,然后有方法就给本地API告诉他,贴给他,他去给你配置。我给你贴最后两个DSH的回答,你参考一下。
对,MTP 就是加速用的,而且你下载它下载对了。
MTP 是什么
MTP = Multi-Token Prediction(多 token 预测),是一种“投机解码”加速技术。
原理很直观:
普通推理:每生成 1 个 token,就要跑一次完整的模型
           ▮▮▮▮ → ▮▮▮▮ → ▮▮▮▮   (慢,一次一个)

MTP 加速:先用一个"小模型"快速猜后面 4 个 token
           ▮▮▮▮(跑一次大模型,一次验证 4 个猜测)
           ↓
           猜对了就全收,猜错了就退回到正确的位置重来
那个
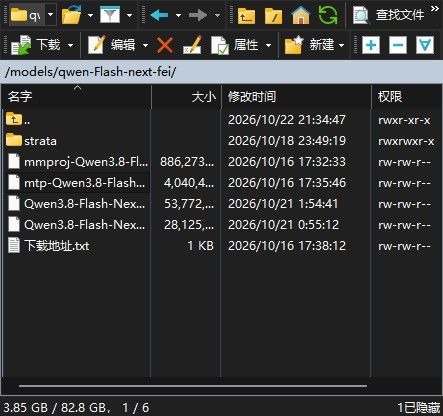
mtp-Qwen3.8-Flash-Next-Q8_0.gguf(4.1GB)就是“猜下一个 token 的小助手”。它是一个轻量的推测头(draft head),只有基础模型的一部分,但猜得相当准。你的 MTP 正在生效
draft layer loaded, 835 MiB of VRAM
draft head over 106,299 tokens
drafts accepted 149/254, 157/252, 143/242 ...  接受率 55-62%
每 100 个推测的 token,有 55-62 个被采纳,这是很好的成绩。速度实测 57.6 tok/s。
实测:
--spec 4已是最优我测试了不同推测深度:
配置 速度 草稿接受率 --spec 4(当前)57.6 tok/s 59% --spec 654.8 tok/s 48% --spec 851.6 tok/s 44% 推测得越远,接受率越低,反而更慢。 这很符合直觉:猜 1 步容易,猜 8 步不容易,猜错还要付出验证代价。你现在的 4 已经是调好的最佳值。
你下载的文件被“加工”过了
有个细节可能你没注意到:
mtp-...Q8_0.gguf是原始文件,但实际加载的是转换后的版本:/models/Strata-data/mtp/rt/ ├── dense.bin 116 MB ├── experts.bin 707 MB ├── draft_vocab.bin 425 KB └── dense.txt引擎不能直接读
.gguf,必须转成自己的格式。这个转换之前已经做好了,所以能正常用。你下载的那 4.1GB 原始文件现在是“母版”,如果以后重装系统、重建数据,还需要它。一个额外收益
你的
draft_vocab.bin是中文特化版:它包含 106,299 个 token,覆盖了全部中日韩字符。文档实测:
“Since 0.1.27 the subset includes every Chinese, Japanese and Korean token, so answers in those languages are 15-38% faster”
所以你用中文对话,比英文还快 15-38%。这是个意外的好处。
关于那 4.1GB 文件
既然转换后的版本只占 807MB,那 4.1GB 原始文件占着模型盘空间。你有两个选择:
选项 说明 保留(推荐) 重建/迁移时必需,你的盘还有 104G 空闲,不差这点 删掉 能省 4.1GB,但以后重建要重新下载 我的建议是留着:模型盘还有 104G 空闲,而重建所有 pack 数据很麻烦。
当前状态
上下文    : 262144 (256K)
MTP 加速  : ✅ 运行中,接受率 55-62%
速度      : 57.6 tok/s
显存      : 1680 MiB 空闲 / MTP 占 835 MiB
服务      : active / enabled / 开机自启
失败单元  : 0
你可以放心使用 MTP,这部分配置是调好的,不需要再调整。
顺便说一句,测试过程中我有个操作失误:关掉 MTP 想测试对比,结果引擎拒绝启动,因为
--mtp和--spec是绑定的。现在已完整恢复,配置和之前一致,没有遗留问题。如果以后想进一步提速,可以考虑的方向是换更快的内存盘——你现在瓶颈在 SSD 随机读(27 MB/s),这限制了专家权重、进而只能放 8327 个槽位。要我评估一下换盘能带来多少提升吗?
好,等你的任务跑完再配置。我先把方案和代价讲清楚,让你可以提前判断。
你要的功能:引擎原生支持
Strata 有一个配置项
"parallel": 2,就是你要的效果:默认(现在):一次只处理一个请求,其他的排队 请求A ████████████ 请求B 排队等待… 开启 parallel: 2:两个对话同时推进,第三个开始排队 请求A ████████████ 请求B ████████████ 请求C 排队…两个对话完全隔离,文档明确说明:
每个 slot 有自己的状态(GDN 循环状态、QSA 的 K/V 和索引器、PLE 历史),
提示词的 K/V 归各自所有,互不触碰对方的状态。但有一个必须告诉你的代价
文档明确警告:只有“专家大部分在显存里”时才推荐开启并行,否则每个请求会慢 10-25%。
你的情况是:
指标 你的实际值 文档建议 显存 24.5 GB(已用 23.6 GB) IQ3_S 需要 32GB+ 专家槽位 8,327 个(15.8 GiB) 需“大半个模型”在显存 结论 专家大部分在内存,不在显存  ️ 属于会变慢的场景
原因很实际:两个对话路由到不同的专家,需要读取的专家总数几乎翻倍,而你的瓶颈正是从内存或 SSD 读取专家。
能得到的和要付出的
单个请求速度 两人同时用时 关闭并行(现在) 57-67 tok/s 一个快,另一个完全干等 开启并行 2 可能降到 45-55 tok/s 两人都在推进,没人空等 关键点:你要的是“两个对话互不影响”,也就是没有人被卡住,而不只是速度更快。从这个角度看,即使单请求略慢,你想要的体验仍然是改善。
我打算这样做
配置
"parallel": 2并重启,然后实测三个数字告诉你真实代价:- 单请求速度:对比现在的 57.6 tok/s
- 两个并发请求各自的延迟:这是你最关心的
- 第三个请求的排队行为:确认排队机制生效
如果实测发现单请求掉得太狠(比如掉到 40 以下),我会把数据摆给你,让你选择保留还是回滚。
回滚很简单
配置里删掉一行
"parallel": 2,重启即可,随时可返回。备份已经在:/models/ai/Strata/strata-iq3_s.json.before-256k
你现在可以继续用完手头的任务。 用完后告诉我一声“可以了”,我就开始配置和实测。
另外想确认两个细节,好让我一次配到位:
- 你的两个“通道”是指两个不同的程序或客户端吗?(比如两个浏览器窗口、两个 IDE 插件、或者 OpenWebUI 两个账号)—— 这会影响我要不要顺带调整对话缓存策略。
- 如果单请求速度从 57 掉到 45,你能接受吗? 换来的是两人同时用谁都不用等。
全部完成并验证。
文档位置
主文档(这是唯一权威版本)
/data/AI-SERVER-README.md ← 就在你说的机械硬盘上709 行,35 KB,位于
/data(机械盘 sdb1),已确认写入正确、内容完整。重启后依然存在,因为/data是独立挂载的分区。另外我放了两个“路标”文件,让人和 AI 从常见位置都能找到它:
文件 位置 作用 README-先看这里.md/home/song/登录后一眼就能看到的入口 HOST-README.md/models/ai/Strata/在引擎目录里工作时的提示 备份副本:
/data/backup/AI-SERVER-README.md.v1-20261022(校验一致)文档里有什么
章节 内容 第 0 节 给未来 AI 的 8 条强制规则 1–3 节 机器用途、硬件参数、磁盘分工(含实测速度) 4 节 当前生效配置全文(服务单元、JSON 配置、调优脚本、内核参数、防火墙、SSH) 5 节 11 条已知陷阱 6 节 全部实测性能数据 7 节 常用操作手册(查状态、重启、看日志、调 API) 8 节 回滚方式对照表 9 节 变更日志(8 条历史记录) 10 节 待办(双通道那个需求也在里面) 11 节 文档自身怎么维护 11 条陷阱(这是最有价值的部分)
都是我在这台机器上实际遇到过的问题:
# 陷阱 教训 1 performance调速器反而更慢65.8 vs 63.6 tok/s,别被直觉骗 2 read_ahead_kb调大毁掉读取349 → 22 MB/s,只能设 128 3 不要开 swap 慢盘换页会让请求卡几秒 4 迁移目录后 venv 报废 66 个脚本硬编码路径 5 风扇在 Linux 里根本控制不了 真正病因是插错线 6 主板温度传感器有假读数 AUXTIN 恒报 110°C 7 改 cpufreq 要逐核,sudo 要带 -p ''否则静默失败 8 冷启动第一次测速不可信 要预热 5-8 轮 9 PLE 表需要 LimitMEMLOCK=infinity否则 mlock 失败 10 --mtp和--spec必须成对单删一个直接拒启动 11 PowerShell 拼远程命令会破坏引号 写成文件再执行 第 11 条我刚刚又踩了一次,正好印证了它的价值。
怎么引导未来的 AI
最省事的方式:直接复制这句话给你的 AI
这台服务器是本地大模型推理机。请你先完整阅读
/data/AI-SERVER-README.md(在服务器的机械硬盘 /data 上),
里面记录了这台机器的全部配置、改动历史、已知陷阱和操作规则。
严格遵守文档第 0 节的 8 条规则:先读后动、先备份再改、必须实测、
必须留痕。改完之后必须把改动追加到第 9 节「变更日志」。
如果你不确定某个改动会不会破坏现有配置,先问我再动手。
这段话我也写进了文档第 11 节,随时可以回来复制。
如果 AI 能直接执行 SSH,也可以只给这一句:
ssh [email protected] "cat /data/AI-SERVER-README.md"核心规则(8 条,AI 必须遵守)
- 先读后动:改任何东西前,读完第 4、5、8 节。
- 先备份再改:按
<原文件>.before-<主题>命名,不覆盖旧备份。 - 必须留痕:改完必须在第 9 节追加记录;没记录就等于没完成。
- 必须实测:不许凭“一般认为”覆盖文档里的实测数字。
- 不要打断用户任务:重启前先查
in_flight。 - sudo 用
-S -p '':并用id -u验证是否真提权。 - 只改该改的:这机器只跑推理。
- 保留回滚路径:做不到就先问。
变更日志格式
每条都是这个结构,8 条历史已填好:
### 2026-10-22 | 上下文从 128K 提升到 256K
- 改动内容:--max-context 131072 → 262144
- 改动文件:/models/ai/Strata/strata-iq3_s.json
- 原因:发现模型元数据里 context_length = 262144
- 实测结果:KV 1.55 → 3.09 GiB,速度 65.8 → 62.8 tok/s
- 回滚方式:cp ...before-256k 后重启
- 操作者:AI 助手
另外:你那个耗时五千秒的任务还在运行中,我会按你说的不动服务。双通道的配置方案已经完整写进文档第 10 节,连预期代价和需要实测的项目都记好了;等你说“可以了”,我就执行。
要不要我把文档也下载一份到你的 Windows 电脑
C:\test\上?这样不上服务器也能看。 -
我给你贴最后两个DSH的回答,你参考一下。
对,MTP 就是加速用的,而且你下载它下载对了。
MTP 是什么
MTP = Multi-Token Prediction(多 token 预测),是一种“投机解码”加速技术。
原理很直观:
普通推理:每生成 1 个 token,就要跑一次完整的模型
           ▮▮▮▮ → ▮▮▮▮ → ▮▮▮▮   (慢,一次一个)

MTP 加速:先用一个"小模型"快速猜后面 4 个 token
           ▮▮▮▮(跑一次大模型,一次验证 4 个猜测)
           ↓
           猜对了就全收,猜错了就退回到正确的位置重来
那个
mtp-Qwen3.8-Flash-Next-Q8_0.gguf(4.1GB)就是“猜下一个 token 的小助手”。它是一个轻量的推测头(draft head),只有基础模型的一部分,但猜得相当准。你的 MTP 正在生效
draft layer loaded, 835 MiB of VRAM
draft head over 106,299 tokens
drafts accepted 149/254, 157/252, 143/242 ...  接受率 55-62%
每 100 个推测的 token,有 55-62 个被采纳,这是很好的成绩。速度实测 57.6 tok/s。
实测:
--spec 4已是最优我测试了不同推测深度:
配置 速度 草稿接受率 --spec 4(当前)57.6 tok/s 59% --spec 654.8 tok/s 48% --spec 851.6 tok/s 44% 推测得越远,接受率越低,反而更慢。 这很符合直觉:猜 1 步容易,猜 8 步不容易,猜错还要付出验证代价。你现在的 4 已经是调好的最佳值。
你下载的文件被“加工”过了
有个细节可能你没注意到:
mtp-...Q8_0.gguf是原始文件,但实际加载的是转换后的版本:/models/Strata-data/mtp/rt/ ├── dense.bin 116 MB ├── experts.bin 707 MB ├── draft_vocab.bin 425 KB └── dense.txt引擎不能直接读
.gguf,必须转成自己的格式。这个转换之前已经做好了,所以能正常用。你下载的那 4.1GB 原始文件现在是“母版”,如果以后重装系统、重建数据,还需要它。一个额外收益
你的
draft_vocab.bin是中文特化版:它包含 106,299 个 token,覆盖了全部中日韩字符。文档实测:
“Since 0.1.27 the subset includes every Chinese, Japanese and Korean token, so answers in those languages are 15-38% faster”
所以你用中文对话,比英文还快 15-38%。这是个意外的好处。
关于那 4.1GB 文件
既然转换后的版本只占 807MB,那 4.1GB 原始文件占着模型盘空间。你有两个选择:
选项 说明 保留(推荐) 重建/迁移时必需,你的盘还有 104G 空闲,不差这点 删掉 能省 4.1GB,但以后重建要重新下载 我的建议是留着:模型盘还有 104G 空闲,而重建所有 pack 数据很麻烦。
当前状态
上下文    : 262144 (256K)
MTP 加速  : ✅ 运行中,接受率 55-62%
速度      : 57.6 tok/s
显存      : 1680 MiB 空闲 / MTP 占 835 MiB
服务      : active / enabled / 开机自启
失败单元  : 0
你可以放心使用 MTP,这部分配置是调好的,不需要再调整。
顺便说一句,测试过程中我有个操作失误:关掉 MTP 想测试对比,结果引擎拒绝启动,因为
--mtp和--spec是绑定的。现在已完整恢复,配置和之前一致,没有遗留问题。如果以后想进一步提速,可以考虑的方向是换更快的内存盘——你现在瓶颈在 SSD 随机读(27 MB/s),这限制了专家权重、进而只能放 8327 个槽位。要我评估一下换盘能带来多少提升吗?
好,等你的任务跑完再配置。我先把方案和代价讲清楚,让你可以提前判断。
你要的功能:引擎原生支持
Strata 有一个配置项
"parallel": 2,就是你要的效果:默认(现在):一次只处理一个请求,其他的排队 请求A ████████████ 请求B 排队等待… 开启 parallel: 2:两个对话同时推进,第三个开始排队 请求A ████████████ 请求B ████████████ 请求C 排队…两个对话完全隔离,文档明确说明:
每个 slot 有自己的状态(GDN 循环状态、QSA 的 K/V 和索引器、PLE 历史),
提示词的 K/V 归各自所有,互不触碰对方的状态。但有一个必须告诉你的代价
文档明确警告:只有“专家大部分在显存里”时才推荐开启并行,否则每个请求会慢 10-25%。
你的情况是:
指标 你的实际值 文档建议 显存 24.5 GB(已用 23.6 GB) IQ3_S 需要 32GB+ 专家槽位 8,327 个(15.8 GiB) 需“大半个模型”在显存 结论 专家大部分在内存,不在显存 ️ 属于会变慢的场景原因很实际:两个对话路由到不同的专家,需要读取的专家总数几乎翻倍,而你的瓶颈正是从内存或 SSD 读取专家。
能得到的和要付出的
单个请求速度 两人同时用时 关闭并行(现在) 57-67 tok/s 一个快,另一个完全干等 开启并行 2 可能降到 45-55 tok/s 两人都在推进,没人空等 关键点:你要的是“两个对话互不影响”,也就是没有人被卡住,而不只是速度更快。从这个角度看,即使单请求略慢,你想要的体验仍然是改善。
我打算这样做
配置
"parallel": 2并重启,然后实测三个数字告诉你真实代价:- 单请求速度:对比现在的 57.6 tok/s
- 两个并发请求各自的延迟:这是你最关心的
- 第三个请求的排队行为:确认排队机制生效
如果实测发现单请求掉得太狠(比如掉到 40 以下),我会把数据摆给你,让你选择保留还是回滚。
回滚很简单
配置里删掉一行
"parallel": 2,重启即可,随时可返回。备份已经在:/models/ai/Strata/strata-iq3_s.json.before-256k
你现在可以继续用完手头的任务。 用完后告诉我一声“可以了”,我就开始配置和实测。
另外想确认两个细节,好让我一次配到位:
- 你的两个“通道”是指两个不同的程序或客户端吗?(比如两个浏览器窗口、两个 IDE 插件、或者 OpenWebUI 两个账号)—— 这会影响我要不要顺带调整对话缓存策略。
- 如果单请求速度从 57 掉到 45,你能接受吗? 换来的是两人同时用谁都不用等。
全部完成并验证。
文档位置
主文档(这是唯一权威版本)
/data/AI-SERVER-README.md ← 就在你说的机械硬盘上709 行,35 KB,位于
/data(机械盘 sdb1),已确认写入正确、内容完整。重启后依然存在,因为/data是独立挂载的分区。另外我放了两个“路标”文件,让人和 AI 从常见位置都能找到它:
文件 位置 作用 README-先看这里.md/home/song/登录后一眼就能看到的入口 HOST-README.md/models/ai/Strata/在引擎目录里工作时的提示 备份副本:
/data/backup/AI-SERVER-README.md.v1-20261022(校验一致)文档里有什么
章节 内容 第 0 节 给未来 AI 的 8 条强制规则 1–3 节 机器用途、硬件参数、磁盘分工(含实测速度) 4 节 当前生效配置全文(服务单元、JSON 配置、调优脚本、内核参数、防火墙、SSH) 5 节 11 条已知陷阱 6 节 全部实测性能数据 7 节 常用操作手册(查状态、重启、看日志、调 API) 8 节 回滚方式对照表 9 节 变更日志(8 条历史记录) 10 节 待办(双通道那个需求也在里面) 11 节 文档自身怎么维护 11 条陷阱(这是最有价值的部分)
都是我在这台机器上实际遇到过的问题:
# 陷阱 教训 1 performance调速器反而更慢65.8 vs 63.6 tok/s,别被直觉骗 2 read_ahead_kb调大毁掉读取349 → 22 MB/s,只能设 128 3 不要开 swap 慢盘换页会让请求卡几秒 4 迁移目录后 venv 报废 66 个脚本硬编码路径 5 风扇在 Linux 里根本控制不了 真正病因是插错线 6 主板温度传感器有假读数 AUXTIN 恒报 110°C 7 改 cpufreq 要逐核,sudo 要带 -p ''否则静默失败 8 冷启动第一次测速不可信 要预热 5-8 轮 9 PLE 表需要 LimitMEMLOCK=infinity否则 mlock 失败 10 --mtp和--spec必须成对单删一个直接拒启动 11 PowerShell 拼远程命令会破坏引号 写成文件再执行 第 11 条我刚刚又踩了一次,正好印证了它的价值。
怎么引导未来的 AI
最省事的方式:直接复制这句话给你的 AI
这台服务器是本地大模型推理机。请你先完整阅读
/data/AI-SERVER-README.md(在服务器的机械硬盘 /data 上),
里面记录了这台机器的全部配置、改动历史、已知陷阱和操作规则。
严格遵守文档第 0 节的 8 条规则:先读后动、先备份再改、必须实测、
必须留痕。改完之后必须把改动追加到第 9 节「变更日志」。
如果你不确定某个改动会不会破坏现有配置,先问我再动手。
这段话我也写进了文档第 11 节,随时可以回来复制。
如果 AI 能直接执行 SSH,也可以只给这一句:
ssh [email protected] "cat /data/AI-SERVER-README.md"核心规则(8 条,AI 必须遵守)
- 先读后动:改任何东西前,读完第 4、5、8 节。
- 先备份再改:按
<原文件>.before-<主题>命名,不覆盖旧备份。 - 必须留痕:改完必须在第 9 节追加记录;没记录就等于没完成。
- 必须实测:不许凭“一般认为”覆盖文档里的实测数字。
- 不要打断用户任务:重启前先查
in_flight。 - sudo 用
-S -p '':并用id -u验证是否真提权。 - 只改该改的:这机器只跑推理。
- 保留回滚路径:做不到就先问。
变更日志格式
每条都是这个结构,8 条历史已填好:
### 2026-10-22 | 上下文从 128K 提升到 256K
- 改动内容:--max-context 131072 → 262144
- 改动文件:/models/ai/Strata/strata-iq3_s.json
- 原因:发现模型元数据里 context_length = 262144
- 实测结果:KV 1.55 → 3.09 GiB,速度 65.8 → 62.8 tok/s
- 回滚方式:cp ...before-256k 后重启
- 操作者:AI 助手
另外:你那个耗时五千秒的任务还在运行中,我会按你说的不动服务。双通道的配置方案已经完整写进文档第 10 节,连预期代价和需要实测的项目都记好了;等你说“可以了”,我就执行。
要不要我把文档也下载一份到你的 Windows 电脑
C:\test\上?这样不上服务器也能看。 -
-
,
 T terry 固定了此主题
-
-
我给你贴最后两个DSH的回答,你参考一下。
对,MTP 就是加速用的,而且你下载它下载对了。
MTP 是什么
MTP = Multi-Token Prediction(多 token 预测),是一种“投机解码”加速技术。
原理很直观:
普通推理:每生成 1 个 token,就要跑一次完整的模型
           ▮▮▮▮ → ▮▮▮▮ → ▮▮▮▮   (慢,一次一个)

MTP 加速:先用一个"小模型"快速猜后面 4 个 token
           ▮▮▮▮(跑一次大模型,一次验证 4 个猜测)
           ↓
           猜对了就全收,猜错了就退回到正确的位置重来
那个
mtp-Qwen3.8-Flash-Next-Q8_0.gguf(4.1GB)就是“猜下一个 token 的小助手”。它是一个轻量的推测头(draft head),只有基础模型的一部分,但猜得相当准。你的 MTP 正在生效
draft layer loaded, 835 MiB of VRAM
draft head over 106,299 tokens
drafts accepted 149/254, 157/252, 143/242 ...  接受率 55-62%
每 100 个推测的 token,有 55-62 个被采纳,这是很好的成绩。速度实测 57.6 tok/s。
实测:
--spec 4已是最优我测试了不同推测深度:
配置 速度 草稿接受率 --spec 4(当前)57.6 tok/s 59% --spec 654.8 tok/s 48% --spec 851.6 tok/s 44% 推测得越远,接受率越低,反而更慢。 这很符合直觉:猜 1 步容易,猜 8 步不容易,猜错还要付出验证代价。你现在的 4 已经是调好的最佳值。
你下载的文件被“加工”过了
有个细节可能你没注意到:
mtp-...Q8_0.gguf是原始文件,但实际加载的是转换后的版本:/models/Strata-data/mtp/rt/ ├── dense.bin 116 MB ├── experts.bin 707 MB ├── draft_vocab.bin 425 KB └── dense.txt引擎不能直接读
.gguf,必须转成自己的格式。这个转换之前已经做好了,所以能正常用。你下载的那 4.1GB 原始文件现在是“母版”,如果以后重装系统、重建数据,还需要它。一个额外收益
你的
draft_vocab.bin是中文特化版:它包含 106,299 个 token,覆盖了全部中日韩字符。文档实测:
“Since 0.1.27 the subset includes every Chinese, Japanese and Korean token, so answers in those languages are 15-38% faster”
所以你用中文对话,比英文还快 15-38%。这是个意外的好处。
关于那 4.1GB 文件
既然转换后的版本只占 807MB,那 4.1GB 原始文件占着模型盘空间。你有两个选择:
选项 说明 保留(推荐) 重建/迁移时必需,你的盘还有 104G 空闲,不差这点 删掉 能省 4.1GB,但以后重建要重新下载 我的建议是留着:模型盘还有 104G 空闲,而重建所有 pack 数据很麻烦。
当前状态
上下文    : 262144 (256K)
MTP 加速  : ✅ 运行中,接受率 55-62%
速度      : 57.6 tok/s
显存      : 1680 MiB 空闲 / MTP 占 835 MiB
服务      : active / enabled / 开机自启
失败单元  : 0
你可以放心使用 MTP,这部分配置是调好的,不需要再调整。
顺便说一句,测试过程中我有个操作失误:关掉 MTP 想测试对比,结果引擎拒绝启动,因为
--mtp和--spec是绑定的。现在已完整恢复,配置和之前一致,没有遗留问题。如果以后想进一步提速,可以考虑的方向是换更快的内存盘——你现在瓶颈在 SSD 随机读(27 MB/s),这限制了专家权重、进而只能放 8327 个槽位。要我评估一下换盘能带来多少提升吗?
好,等你的任务跑完再配置。我先把方案和代价讲清楚,让你可以提前判断。
你要的功能:引擎原生支持
Strata 有一个配置项
"parallel": 2,就是你要的效果:默认(现在):一次只处理一个请求,其他的排队 请求A ████████████ 请求B 排队等待… 开启 parallel: 2:两个对话同时推进,第三个开始排队 请求A ████████████ 请求B ████████████ 请求C 排队…两个对话完全隔离,文档明确说明:
每个 slot 有自己的状态(GDN 循环状态、QSA 的 K/V 和索引器、PLE 历史),
提示词的 K/V 归各自所有,互不触碰对方的状态。但有一个必须告诉你的代价
文档明确警告:只有“专家大部分在显存里”时才推荐开启并行,否则每个请求会慢 10-25%。
你的情况是:
指标 你的实际值 文档建议 显存 24.5 GB(已用 23.6 GB) IQ3_S 需要 32GB+ 专家槽位 8,327 个(15.8 GiB) 需“大半个模型”在显存 结论 专家大部分在内存,不在显存 ️ 属于会变慢的场景原因很实际:两个对话路由到不同的专家,需要读取的专家总数几乎翻倍,而你的瓶颈正是从内存或 SSD 读取专家。
能得到的和要付出的
单个请求速度 两人同时用时 关闭并行(现在) 57-67 tok/s 一个快,另一个完全干等 开启并行 2 可能降到 45-55 tok/s 两人都在推进,没人空等 关键点:你要的是“两个对话互不影响”,也就是没有人被卡住,而不只是速度更快。从这个角度看,即使单请求略慢,你想要的体验仍然是改善。
我打算这样做
配置
"parallel": 2并重启,然后实测三个数字告诉你真实代价:- 单请求速度:对比现在的 57.6 tok/s
- 两个并发请求各自的延迟:这是你最关心的
- 第三个请求的排队行为:确认排队机制生效
如果实测发现单请求掉得太狠(比如掉到 40 以下),我会把数据摆给你,让你选择保留还是回滚。
回滚很简单
配置里删掉一行
"parallel": 2,重启即可,随时可返回。备份已经在:/models/ai/Strata/strata-iq3_s.json.before-256k
你现在可以继续用完手头的任务。 用完后告诉我一声“可以了”,我就开始配置和实测。
另外想确认两个细节,好让我一次配到位:
- 你的两个“通道”是指两个不同的程序或客户端吗?(比如两个浏览器窗口、两个 IDE 插件、或者 OpenWebUI 两个账号)—— 这会影响我要不要顺带调整对话缓存策略。
- 如果单请求速度从 57 掉到 45,你能接受吗? 换来的是两人同时用谁都不用等。
全部完成并验证。
文档位置
主文档(这是唯一权威版本)
/data/AI-SERVER-README.md ← 就在你说的机械硬盘上709 行,35 KB,位于
/data(机械盘 sdb1),已确认写入正确、内容完整。重启后依然存在,因为/data是独立挂载的分区。另外我放了两个“路标”文件,让人和 AI 从常见位置都能找到它:
文件 位置 作用 README-先看这里.md/home/song/登录后一眼就能看到的入口 HOST-README.md/models/ai/Strata/在引擎目录里工作时的提示 备份副本:
/data/backup/AI-SERVER-README.md.v1-20261022(校验一致)文档里有什么
章节 内容 第 0 节 给未来 AI 的 8 条强制规则 1–3 节 机器用途、硬件参数、磁盘分工(含实测速度) 4 节 当前生效配置全文(服务单元、JSON 配置、调优脚本、内核参数、防火墙、SSH) 5 节 11 条已知陷阱 6 节 全部实测性能数据 7 节 常用操作手册(查状态、重启、看日志、调 API) 8 节 回滚方式对照表 9 节 变更日志(8 条历史记录) 10 节 待办(双通道那个需求也在里面) 11 节 文档自身怎么维护 11 条陷阱(这是最有价值的部分)
都是我在这台机器上实际遇到过的问题:
# 陷阱 教训 1 performance调速器反而更慢65.8 vs 63.6 tok/s,别被直觉骗 2 read_ahead_kb调大毁掉读取349 → 22 MB/s,只能设 128 3 不要开 swap 慢盘换页会让请求卡几秒 4 迁移目录后 venv 报废 66 个脚本硬编码路径 5 风扇在 Linux 里根本控制不了 真正病因是插错线 6 主板温度传感器有假读数 AUXTIN 恒报 110°C 7 改 cpufreq 要逐核,sudo 要带 -p ''否则静默失败 8 冷启动第一次测速不可信 要预热 5-8 轮 9 PLE 表需要 LimitMEMLOCK=infinity否则 mlock 失败 10 --mtp和--spec必须成对单删一个直接拒启动 11 PowerShell 拼远程命令会破坏引号 写成文件再执行 第 11 条我刚刚又踩了一次,正好印证了它的价值。
怎么引导未来的 AI
最省事的方式:直接复制这句话给你的 AI
这台服务器是本地大模型推理机。请你先完整阅读
/data/AI-SERVER-README.md(在服务器的机械硬盘 /data 上),
里面记录了这台机器的全部配置、改动历史、已知陷阱和操作规则。
严格遵守文档第 0 节的 8 条规则:先读后动、先备份再改、必须实测、
必须留痕。改完之后必须把改动追加到第 9 节「变更日志」。
如果你不确定某个改动会不会破坏现有配置,先问我再动手。
这段话我也写进了文档第 11 节,随时可以回来复制。
如果 AI 能直接执行 SSH,也可以只给这一句:
ssh [email protected] "cat /data/AI-SERVER-README.md"核心规则(8 条,AI 必须遵守)
- 先读后动:改任何东西前,读完第 4、5、8 节。
- 先备份再改:按
<原文件>.before-<主题>命名,不覆盖旧备份。 - 必须留痕:改完必须在第 9 节追加记录;没记录就等于没完成。
- 必须实测:不许凭“一般认为”覆盖文档里的实测数字。
- 不要打断用户任务:重启前先查
in_flight。 - sudo 用
-S -p '':并用id -u验证是否真提权。 - 只改该改的:这机器只跑推理。
- 保留回滚路径:做不到就先问。
变更日志格式
每条都是这个结构,8 条历史已填好:
### 2026-10-22 | 上下文从 128K 提升到 256K
- 改动内容:--max-context 131072 → 262144
- 改动文件:/models/ai/Strata/strata-iq3_s.json
- 原因:发现模型元数据里 context_length = 262144
- 实测结果:KV 1.55 → 3.09 GiB,速度 65.8 → 62.8 tok/s
- 回滚方式:cp ...before-256k 后重启
- 操作者:AI 助手
另外:你那个耗时五千秒的任务还在运行中,我会按你说的不动服务。双通道的配置方案已经完整写进文档第 10 节,连预期代价和需要实测的项目都记好了;等你说“可以了”,我就执行。
要不要我把文档也下载一份到你的 Windows 电脑
C:\test\上?这样不上服务器也能看。 -
-
-
-
兄弟辛苦,帮我踩了不少坑
-




 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!

