跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 本地AI硬件焦虑个锤子!看看好消息吧

本地AI硬件焦虑个锤子!看看好消息吧

已定时 已固定 已锁定 已移动 热议 LLM讨论区
本地模型
28 帖子 15 发布者 590 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • fcmeF
    fcmeF
    fcme
    王侯将相
    编写于 最后由 fcme 编辑
    #1

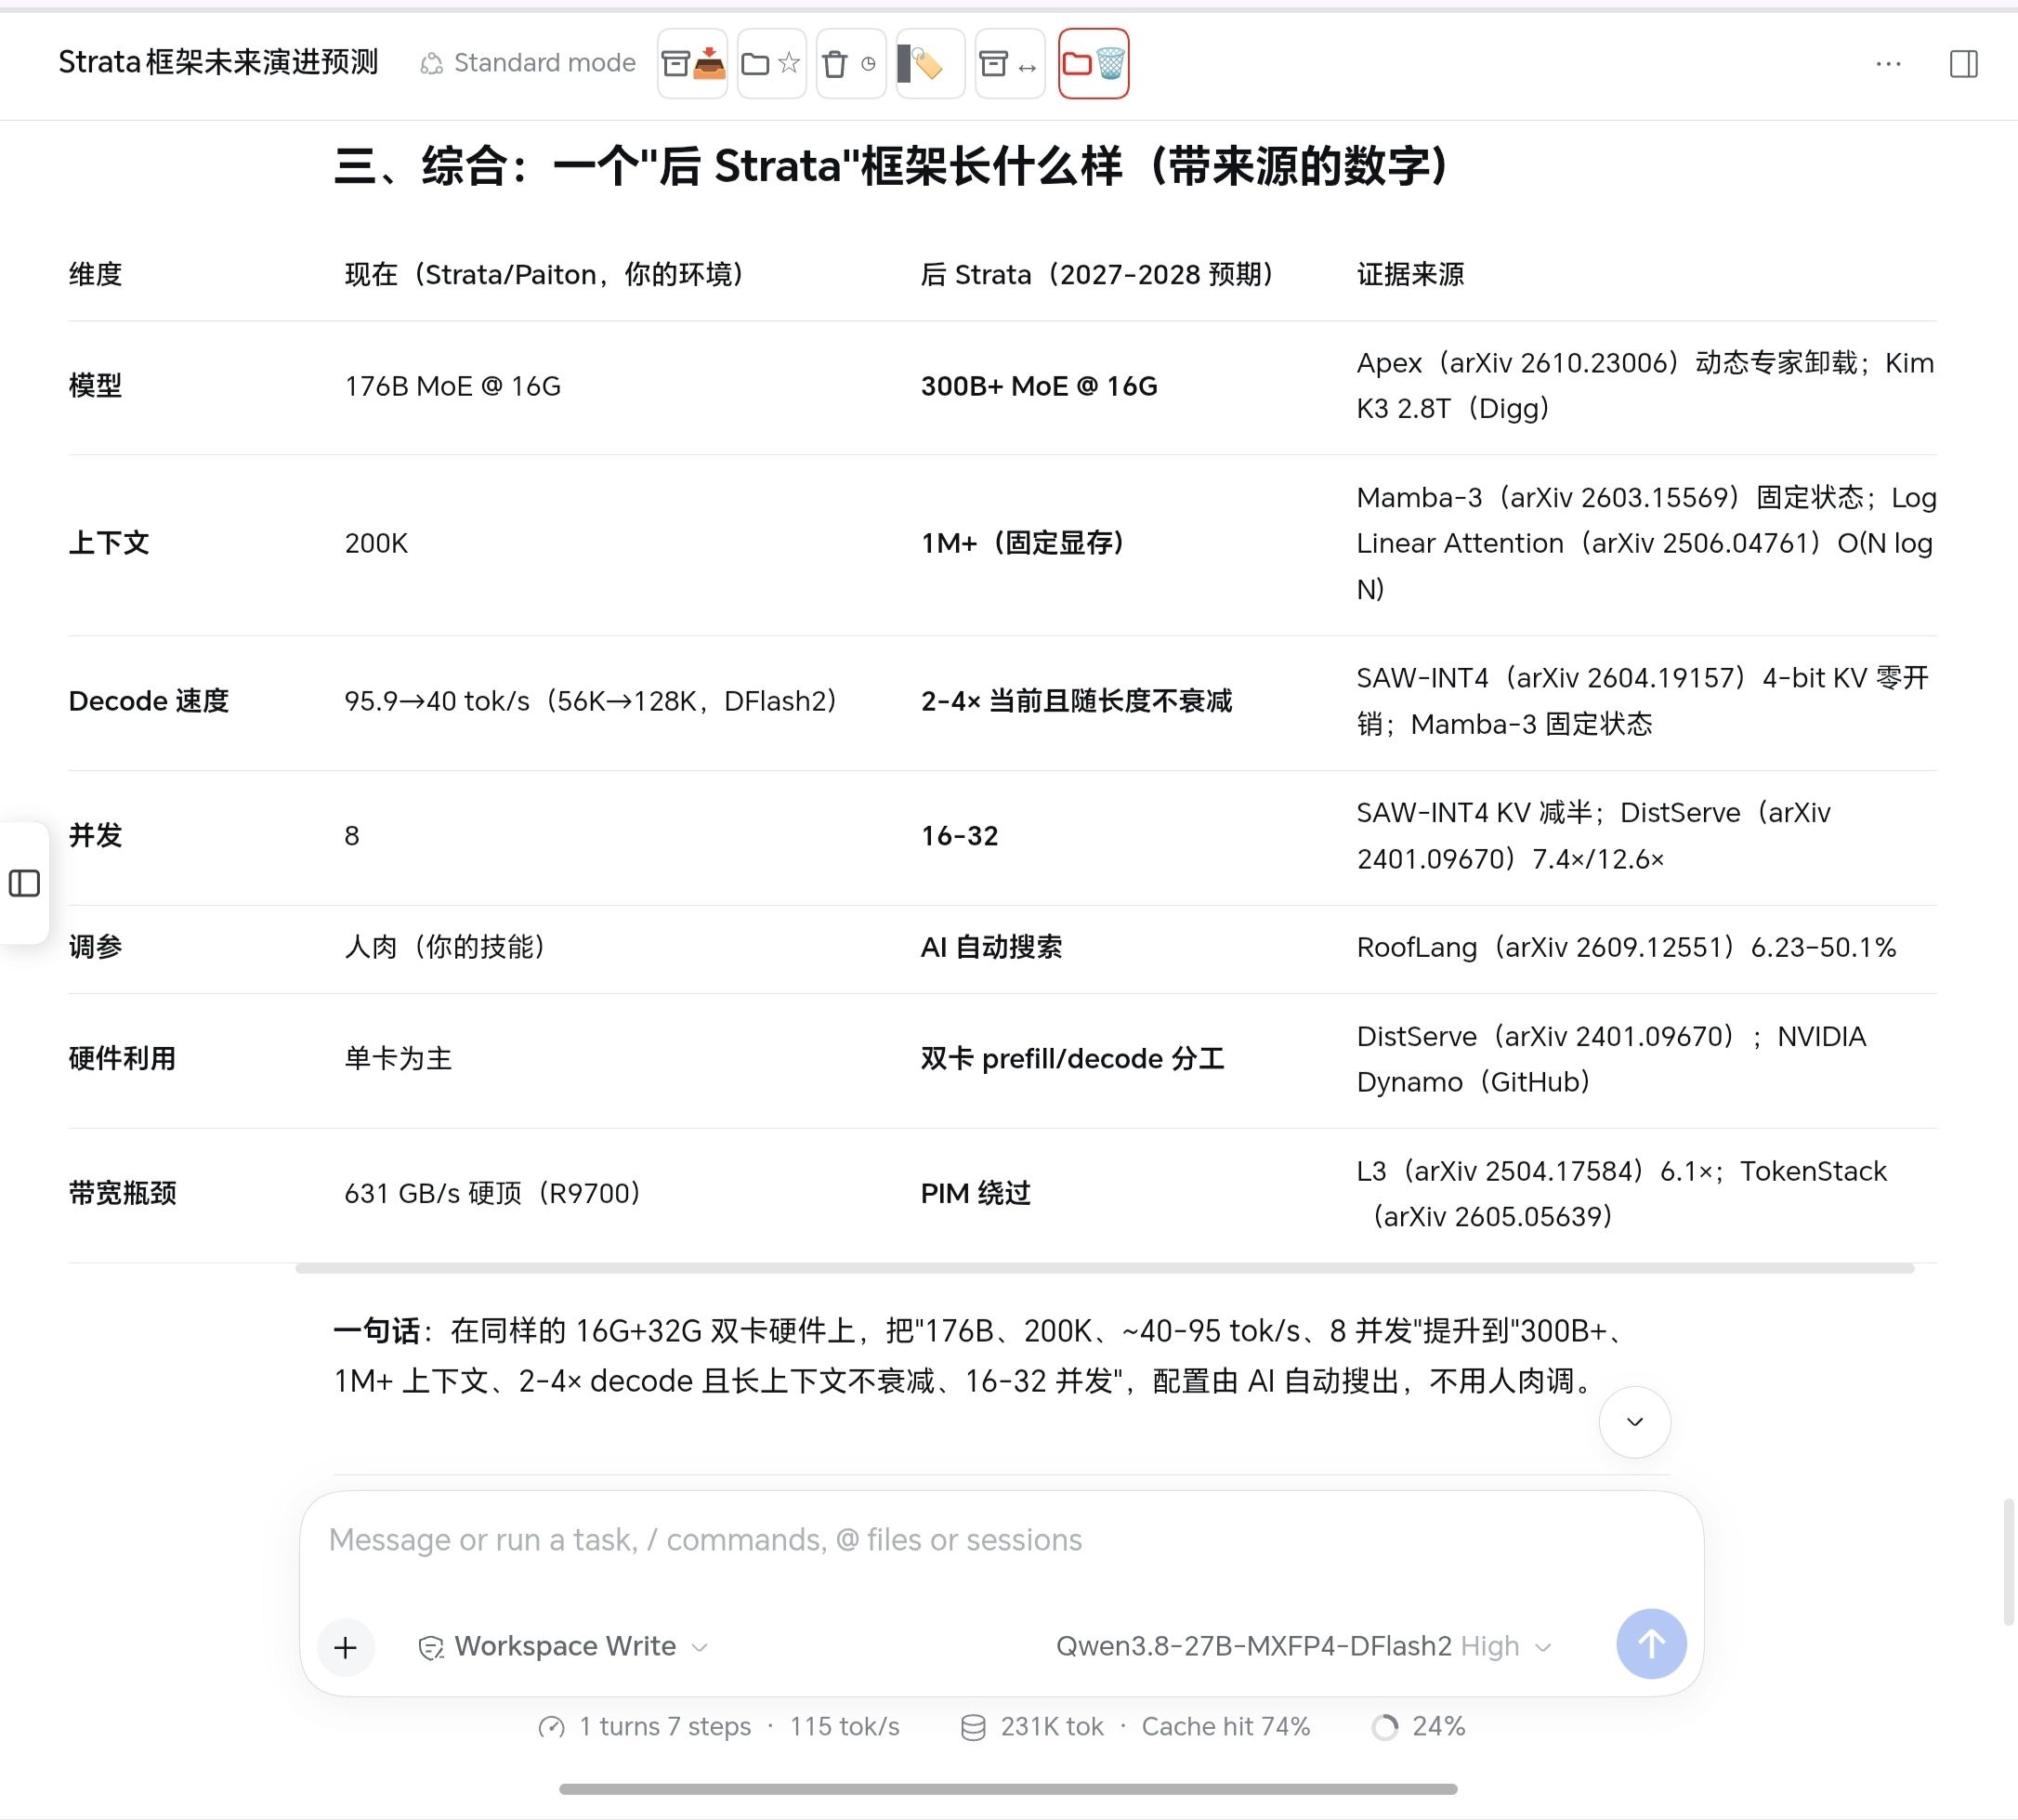
    突然感慨,在过去的一年当中,本地AI已经从抠抠搜搜的8K/16K这样的上下文窗口,到现在可以毫不顾忌的开到256甚至更长。模型能力也是一代更比一代强,难以想象接下来一两年会发生什么,所以就问了一下27b做了很多的研究,总结如下,大家拿去参考吧,焦虑个锤锤!

    Screenshot_20261023_172330.jpg

    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

    1 条回复 最后回复
    2
    • zeus177169Z
      zeus177169Z
      zeus177169
      编写于 最后由 编辑
      #2

      太夸张了吧。。。

      fcmeF 1 条回复 最后回复
      0
      • zeus177169Z zeus177169

        太夸张了吧。。。

        fcmeF
        fcmeF
        fcme
        王侯将相
        编写于 最后由 编辑
        #3

        @zeus177169
        一点不夸张,现在paiton的W3A4的27B模型已经基本接近无损了。

        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

        1 条回复 最后回复
        1
        • stxpnetS
          stxpnetS
          stxpnet
          王侯将相
          编写于 最后由 stxpnet 编辑
          #4

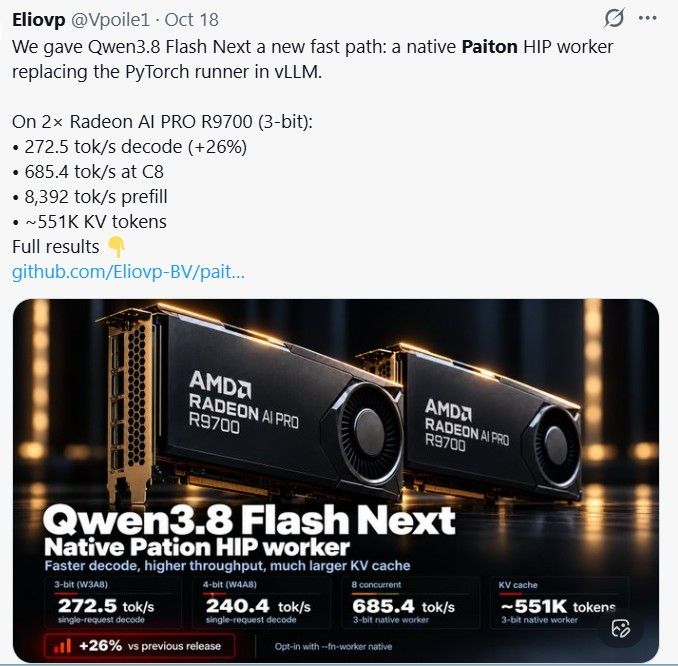
          {A4A8DCF1-A929-42B8-B493-35C14F1C9A3C}.jpeg

          刚搜了一下paiton. 你们这R9700 也吃得太好了吧。。。。 羡慕嫉妒+后悔。

          双卡3090 PCIE 4.0 16X/16X

          白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
          夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
          fcmeF johnnybegoodJ shawn shenS 3 条回复 最后回复
          0
          • kos orK
            kos orK
            kos or
            至尊皇帝
            编写于 最后由 kos or 编辑
            #5

            Paiton 這麼香喔 哇~~~ @@

            現在一堆大神推出新的推論引擎 競爭激烈

            QFN 可以開1M上下文,
            測過開512K ctx, 480K tokens prompt 丟進去可以找到needles 大海撈針 撈得到

            fcmeF 1 条回复 最后回复
            0
            • rock shiR
              rock shiR
              rock shi
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #6

              我也是昨天开了256k上下文,好像是有一个什么流式kv,省出来的显存还又给了专家

              主机:GPU0-3080 20g(H3),GPU1-3080 20g(Zimage)
              副机:2x2080ti 22g,strata qwen3.8 next Flash iq3_s

              fcmeF Tzung-Ru TsaiT 2 条回复 最后回复
              0
              • stxpnetS stxpnet

                {A4A8DCF1-A929-42B8-B493-35C14F1C9A3C}.jpeg

                刚搜了一下paiton. 你们这R9700 也吃得太好了吧。。。。 羡慕嫉妒+后悔。

                fcmeF
                fcmeF
                fcme
                王侯将相
                编写于 最后由 编辑
                #7

                @stxpnet
                对啊,所以我大概是7月份2170刀(澳元)左右买的,现在看这边已经涨到了2700左右了,NND。
                按这个速度下去,我感觉这个卡的生态地位要爆发了。毕竟新卡里能买到32g的,也没有其他选项了。

                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                1 条回复 最后回复
                0
                • kos orK kos or

                  Paiton 這麼香喔 哇~~~ @@

                  現在一堆大神推出新的推論引擎 競爭激烈

                  QFN 可以開1M上下文,
                  測過開512K ctx, 480K tokens prompt 丟進去可以找到needles 大海撈針 撈得到

                  fcmeF
                  fcmeF
                  fcme
                  王侯将相
                  编写于 最后由 编辑
                  #8

                  @kos-or
                  是啊,所以说现在不要着急入硬件。

                  https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                  1 条回复 最后回复
                  0
                  • rock shiR rock shi

                    我也是昨天开了256k上下文,好像是有一个什么流式kv,省出来的显存还又给了专家

                    fcmeF
                    fcmeF
                    fcme
                    王侯将相
                    编写于 最后由 编辑
                    #9

                    @rock-shi
                    什么框架?

                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                    1 条回复 最后回复
                    0
                    • rock shiR rock shi

                      我也是昨天开了256k上下文,好像是有一个什么流式kv,省出来的显存还又给了专家

                      Tzung-Ru TsaiT
                      Tzung-Ru TsaiT
                      Tzung-Ru Tsai
                      编写于 最后由 编辑
                      #10

                      @rock-shi
                      沒記錯的話是KV-resident這個參數,可以把大部分的KV cache塞到RAM裡去,多擠一些VRAM出來放專家權重。

                      fcmeF 1 条回复 最后回复
                      1
                      • Tzung-Ru TsaiT Tzung-Ru Tsai

                        @rock-shi
                        沒記錯的話是KV-resident這個參數,可以把大部分的KV cache塞到RAM裡去,多擠一些VRAM出來放專家權重。

                        fcmeF
                        fcmeF
                        fcme
                        王侯将相
                        编写于 最后由 编辑
                        #11

                        @Tzung-Ru-Tsai
                        哦,那个我也试了一下,貌似默认的32开就挺好

                        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                        rock shiR 1 条回复 最后回复
                        0
                        • terryT
                          terryT
                          terry
                          易有太极
                          编写于 最后由 编辑
                          #12

                          合理想象,人总要有点希望,才有动力继续折腾。

                          油管:https://www.youtube.com/@抡锤者

                          fcmeF 1 条回复 最后回复
                          0
                          • terryT terry

                            合理想象,人总要有点希望,才有动力继续折腾。

                            fcmeF
                            fcmeF
                            fcme
                            王侯将相
                            编写于 最后由 编辑
                            #13

                            @terry
                            想象一下就是明年5070ti的能顺跑GLM6 flash级别的模型就够了😂😂😂

                            https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                            1 条回复 最后回复
                            1
                            • fcmeF fcme

                              @Tzung-Ru-Tsai
                              哦,那个我也试了一下,貌似默认的32开就挺好

                              rock shiR
                              rock shiR
                              rock shi
                              体面乡绅 硕果累累
                              编写于 最后由 rock shi 编辑
                              #14

                              @fcme 对,32k放显存,其余的放内存,pcie搬运。个人体验速度几乎没啥影响,似乎还快了一点。显存压力啥的小了很多

                              主机:GPU0-3080 20g(H3),GPU1-3080 20g(Zimage)
                              副机:2x2080ti 22g,strata qwen3.8 next Flash iq3_s

                              Tzung-Ru TsaiT 1 条回复 最后回复
                              0
                              • Lei GaoL
                                Lei GaoL
                                Lei Gao
                                编写于 最后由 编辑
                                #15

                                为什么这些框架都是老外的? 有咱们自己的吗?

                                fcmeF 1 条回复 最后回复
                                0
                                • David ChenD
                                  David ChenD
                                  David Chen
                                  贵族大夫 硕果累累
                                  编写于 最后由 编辑
                                  #16

                                  從2022 2023 gpt出世
                                  考慮智能,所需記憶容量
                                  基本上每年是以十倍的速度增加
                                  也就是這三年
                                  我們已經改善1000倍了

                                  fcmeF 1 条回复 最后回复
                                  0
                                  • 懒人烘培懒
                                    懒人烘培懒
                                    懒人烘培
                                    体面乡绅 硕果累累
                                    编写于 最后由 编辑
                                    #17

                                    感觉可以,慢慢好好起来了

                                    双 7900 XTX:模型本地跑,Token 随便烧!

                                    fcmeF 1 条回复 最后回复
                                    0
                                    • XiaoteX
                                      XiaoteX
                                      Xiaote
                                      编写于 最后由 编辑
                                      #18

                                      🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                                      奖励凭证:热议 +3 分 · 编号 h2524-1686-1(系统自动发放,显示稍有延迟)

                                      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                                      1 条回复 最后回复
                                      0
                                      • rock shiR rock shi

                                        @fcme 对,32k放显存,其余的放内存,pcie搬运。个人体验速度几乎没啥影响,似乎还快了一点。显存压力啥的小了很多

                                        Tzung-Ru TsaiT
                                        Tzung-Ru TsaiT
                                        Tzung-Ru Tsai
                                        编写于 最后由 Tzung-Ru Tsai 编辑
                                        #19
                                        此主題已被删除!
                                        1 条回复 最后回复
                                        0
                                        • stxpnetS stxpnet

                                          {A4A8DCF1-A929-42B8-B493-35C14F1C9A3C}.jpeg

                                          刚搜了一下paiton. 你们这R9700 也吃得太好了吧。。。。 羡慕嫉妒+后悔。

                                          johnnybegoodJ
                                          johnnybegoodJ
                                          johnnybegood
                                          王侯将相
                                          编写于 最后由 编辑
                                          #20

                                          @stxpnet 确实, 当年考虑过, 不过那个时候是单卡路线, 而且也是考虑cuda环境, 所以从 3090 开始入门, 现在看 R9700越来越接近神卡了。

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组