DDR3内存条太便宜,上256G 512G跑本地大模型?完全没有必要,120B模型足够处理隐私和抗审查,要求高上在线AI,先赚钱!
-
本期讲一讲当下我们要在本地部署什么样的模型。因为最近由于Strata的流行,导致大模型的部署门槛下来很多,是吧?大家一开始是用64G的DDR3洋垃圾,加上24G的7900 XTX,去跑IQ3版本的、由Strata驱动的千问3.8 Flash Next。这样子性价比就非常高,是吧?你内存加显存96G,官方认为这样单会话长上下文跑得还不错。后来大家又觉得多会话的时候体验可能不好,长上下文下多个slot之间切换KV缓存,可能内存不够,那就升级到96G。96G之后搞到128G,诶,这个时候就完美了。你如果上到96G、128G,再搭配一个24G的显卡,甚至搭配两张12G的,或者搭配性能还不错的16G显卡,或者两张16G的V100这种垃圾卡,或者两张4070、两张5080,这些奇奇怪怪的配置都有,那体验就相当不错。
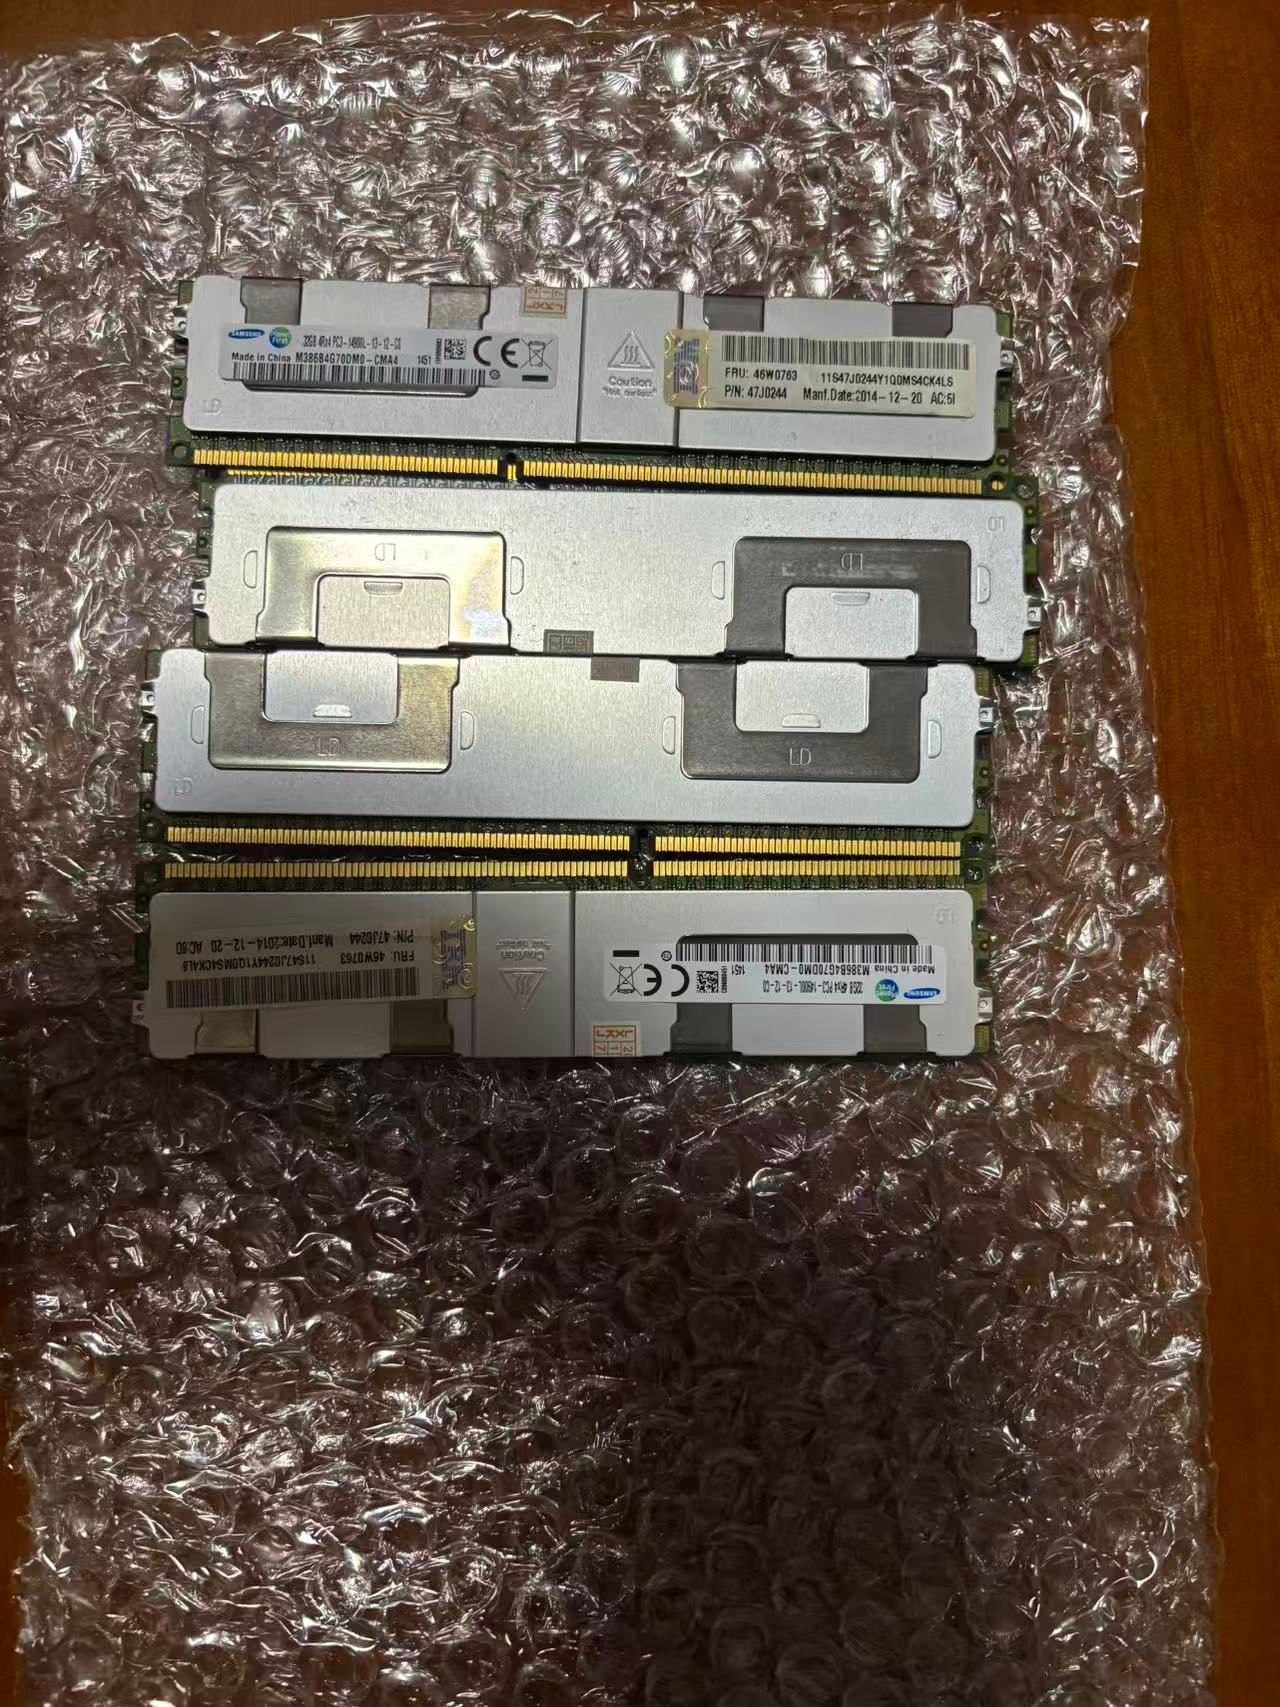
这个时候就有人问了:诶,DDR3平台好便宜啊,是吧?这个32G的条子,然后我不是在视频中给大家展示了吗?我说我买到的条子质量还非常不错,好吧,玩游戏、跑AI还都不错,我都已经测过了。我有64G、128G两个配置方案,64G的是四根16G,还有四根32G的128G方案,都挺不错的。是不是有点小瑕疵,但是不妨碍,它们都能用。那大家说,既然便宜的话,我是不是去买那种服务器的双路服务器,然后8个通道给它上32G的条子?甚至有这种淘宝卖家好像在卖64G单条,价格好像也不是很贵。如果说你是8通道加上64G单条,那就能凑成512G了。我靠,512G你再给它配个4090 48G,或者RTX Pro 4500,或者再配一个其他的32G、48G显卡,那你是不是能够部署DeepSeek V4.1 Flash了?
然后又有人讲了,啊,DDR3不好,其实DDR4也不怎么贵,是吧?我们再往上加一加,咬咬牙,上个512G的DDR4。后来一想,我都上到DDR4了,是吧?咱这个怎么说,再努把力,再上个DDR5的。本来是买一辆奥拓,然后变成奥迪,最后变成了布加迪。我靠,这个预算发现还挺贵的,算了,不如不买。就这样其实挺没有意思的啊。我讲实话,我们要讲一讲本地部署什么样的模型才有意义。首先毫无疑问是千问27B,它现在是3.8,以后很快了,就是这个月月底,应该就这几天,4.0的27B就会发布,一定会有大的提升。
到时候,呃,其实现在3.8的27B在很多测评上,并不比DeepSeek V4.1 Flash评分低多少,只是实际干活的时候可能确实比不上它,尤其是长上下文复杂任务可能干不过它。但是在很多评分上,它其实并不比DeepSeek差多少,它的评分非常顶级。你如果会用它的话,在特定场景中它相当有生产力。是吧?然后就是千问Flash,这个模型现在是3.8 Flash Next,它的4.0应该是在4.0 27B发布之后,我估计个把月吧,等这个热度过了之后应该就会发布,它的提升应当也会很大。它是125B A6B的模型,我估计变来变去就是在120B左右,因为这是一个非常经典的尺寸。就是它的知识库大小、尺寸是够了,然后MOE模型又不用像DeepSeek一样激活十几B、二十几B,它的算力要求、带宽要求、硬件要求可能低很多。然后它对于内存、显存的要求,可能就没有DeepSeek V4.1 Flash这样500B的模型那么夸张。
它就是一个比较甜点的配置。无论是干活还是跑分,它都没有被DeepSeek V4.1 Flash这样500B左右的模型,甚至一些1T左右的模型拉开明显差距,那它就够了呀。是吧?你就把这个甜点模型的上限搞到100B左右就差不多了,MOE再往上搞、搞军备竞赛没有意义。在线API并不贵,你说你本地部署是为了什么呢?不就是为了数据隐私,不就是为了抗审查吗?你把这一块单独划出来,让它用本地模型来做。是吧?其他的如果说你需要特别牛逼、特别智能的模型,比如说负责调度的,你就让在线的DeepSeek V4.1 Flash来调度不就行了吗?你只要把Hermes、DeepSeek Harness、Codex这些agent用好,在本地模型和在线模型之间从容切换、协同作战,这比你无休止地追求军备竞赛、跑特别大的模型要好得多。
再说了,我为什么给大家推荐不要上256G这么夸张的内存?就是你双路耗电量比较高。然后双路在调度的时候,其实软件包括框架都没有那么智能,很多时候达不到翻倍的效果。然后你说上512G,哪怕上洋垃圾,成本也不低。就如果说你上256G,你也跑不了几个会话,就是你也不会多跑几个会话,没有必要。大家把128G的DDR3洋垃圾配起来,现在它的成本非常低,是吧?几千块钱买回来之后,你跑大模型就直接给它上V100 16G,或者说你手里有3080 12G、3080 10G、3080 20G、3060 12G,你可以上两张,是吧?能够把千问Flash这个模型跑起来,稍微支撑几个会话,哪怕排队也不用多并发。把它跑流畅了,它就具备生产力了,你就干活去挣钱,吭哧吭哧地去挣钱,就不要再花时间往上面堆了。你跟我又不一样,又不是做视频的,是吧?我都不用自己买回来堆,我就看论坛有哪些土豪,他们又买了什么洋垃圾也好,还是RTX Pro 6000也好,还是苹果M5 Ultra也好,他们把测试数据发出来,我自己对着镜头云一下,我本身做视频就能挣钱了。你说你们是为了什么呢?
是吧?本地部署模型,我跟你讲,你就算在本地部署了DeepSeek V4.1 Flash,也不可能有官方的效果好。人家只是把模型权重开放给你了,你用SGLang也好,Strata也好,还是其他东西也好,Strata不是专门为了DeepSeek V4 inference发布了一个叫Maya的新推理框架吗?是吧?你部署不出官方的效果来。人家官方给你看的是什么,叫DeepInfer,给你开源的而且只开源了一部分。你看看那个要求,是吧?你觉得你的硬件能达标吗?是不是?或者说你是土豪,人家买4个DGX Spark,用SGLang跑DeepSeek V4.0 Flash,可能跟官方的差距微乎其微,人家的体验就很好。你愿意花20万左右、20万出头来搞这个东西,那你可以去买。那我们普通屌丝就把120B左右的千问Flash模型,或者把27B模型跑好就行了,我们就不要贪心不足了。你每天在这上面折腾的时间,不如多用来折腾一下本地工作流。
下一段时间呢,我会把重心从大模型、AI硬件评论向ComfyUI迁移。有很多人问是什么时候,得等我把家里的这些琐事处理完了,是吧?然后还有一些其他规划,因为我在规划做一些其他的事情,等我把这些事情都落地了,我估计12月份吧,开始到春节。本来我是打算在春节之前把APP开发完成就行了,现在国庆就把它完成了,这属于大大提前,是吧?那么咱这段时间就是每天对着镜头吹吹牛逼,水一下,跟大家保持热度、保持联络。后面我会上一个ComfyUI实际生产的项目,通过一个新的频道给大家演示如何从零部署大模型、部署ComfyUI,生产视频、音频、图片,是吧?然后通过什么样的方式获利,给你们展示一个完整的、再一次从零开始到赚到钱的过程。是吧?我们不吹牛逼,我们以实践说话。到时候那个频道的所有数据完全公开。有人问我为什么英文频道的分享只分享一部分后台数据,我不分享那些很敏感的信息,原因很简单,我不能拿自己的饭碗开玩笑。那么后面我开的这个新频道,一定是所有信息都能对你们公开,你们想看什么数据就看什么数据。好吧,到时候我们以实践来检验真理、检验理论。
-
-
-
-
-
-
-
我的运气是早早听老特的话,买得早,早期大部分显卡都还没疯狂的时候,他已经叫大家哪里一个方便就买哪里一个,大家都买nvidia pro 4000,4500,5000,6000.。。。那个时候大家也顺便升级ram, 64g,96g,128g....后来大部分gpu开始贵了,不得已就7900xtx, r9700pro...
那个时候大家最顶的模型大概都是27b,35b 至多70之类的。。。。就算用着dram 128b 都是过剩的,现在strata 爆出来,才拉到标配128g dram .... -
會不會Qwen4不出125B A6B flash
反而又把35B A3B復活?
如果是這樣各位兄弟會崩潰嗎? -
-
128g多少有点捉襟见肘,别的基座不知道,ollama跑一个30b大概吃40几g内存,同步跑俩以上容易因为内存不够卡顿几分钟倒内存,不很频繁,但会有,所以我很后悔没上8根32,有条件就256吧,要跑单卡异步就无所谓了。后期我打算把16个槽怼满,但据说16槽怼满会出问题。。。后悔中
-
不用洋垃圾,上128G DDR4也就是一般平台极限了,这个用3.8nf能开256K上下文吗
-
128g多少有点捉襟见肘,别的基座不知道,ollama跑一个30b大概吃40几g内存,同步跑俩以上容易因为内存不够卡顿几分钟倒内存,不很频繁,但会有,所以我很后悔没上8根32,有条件就256吧,要跑单卡异步就无所谓了。后期我打算把16个槽怼满,但据说16槽怼满会出问题。。。后悔中
-
-
之前的視頻聽捶哥說買ddr3的內存來跑QFN,期待捶哥內存擴充好之後,聊聊這件事的後續,哈哈。
@Charly-Cheng 我的帖子都已經示範過了 最低預算跑QFN 還能魔改成跑NVFP4版了
測試數據都有 -
对于做工程的系统来讲,速度不是第一追求,稳定和完成规范才是真正需求,一个工程系统的基座只要不是目标达成崩坏的根源就不会频繁升级,一种基座能够持续存活就有意义和价值,至少生态成熟,可以把学习成本用在开发和结果达成。科技大跃进和投机的风险就是一切还要回到开头重新来做,这很可怕。用来学习当然苟日新,干活总换个屁,工业追求的是标准化稳定产出,快那么10个8个token对于基座稳定性风险来说不值一提,目前ollama不差什么,人家也在持续稳定进步,这不是站队,是实打实很好用的结论。128够吗,就像32g能跑llm 8g能跑comfyui一样,一个vm里再跑个llm环境的系统消耗是多少?128g还够用吗
-
-
-
其實美超微的老E5主板有些是能單CPU上8條DDR3 RDIMM的,湊個256GB難度不算高,麻煩的是這些老板子大多沒M.2插槽,只能試著用PCIE轉M.2的轉卡硬上,還得先確認BIOS有支援NVME開機,挺麻煩的