Your browser does not seem to support JavaScript. As a result, your viewing experience will be diminished, and you have been placed in read-only mode.
Please download a browser that supports JavaScript, or enable it if it's disabled (i.e. NoScript).
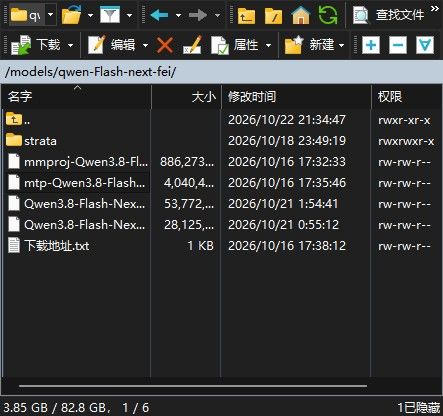
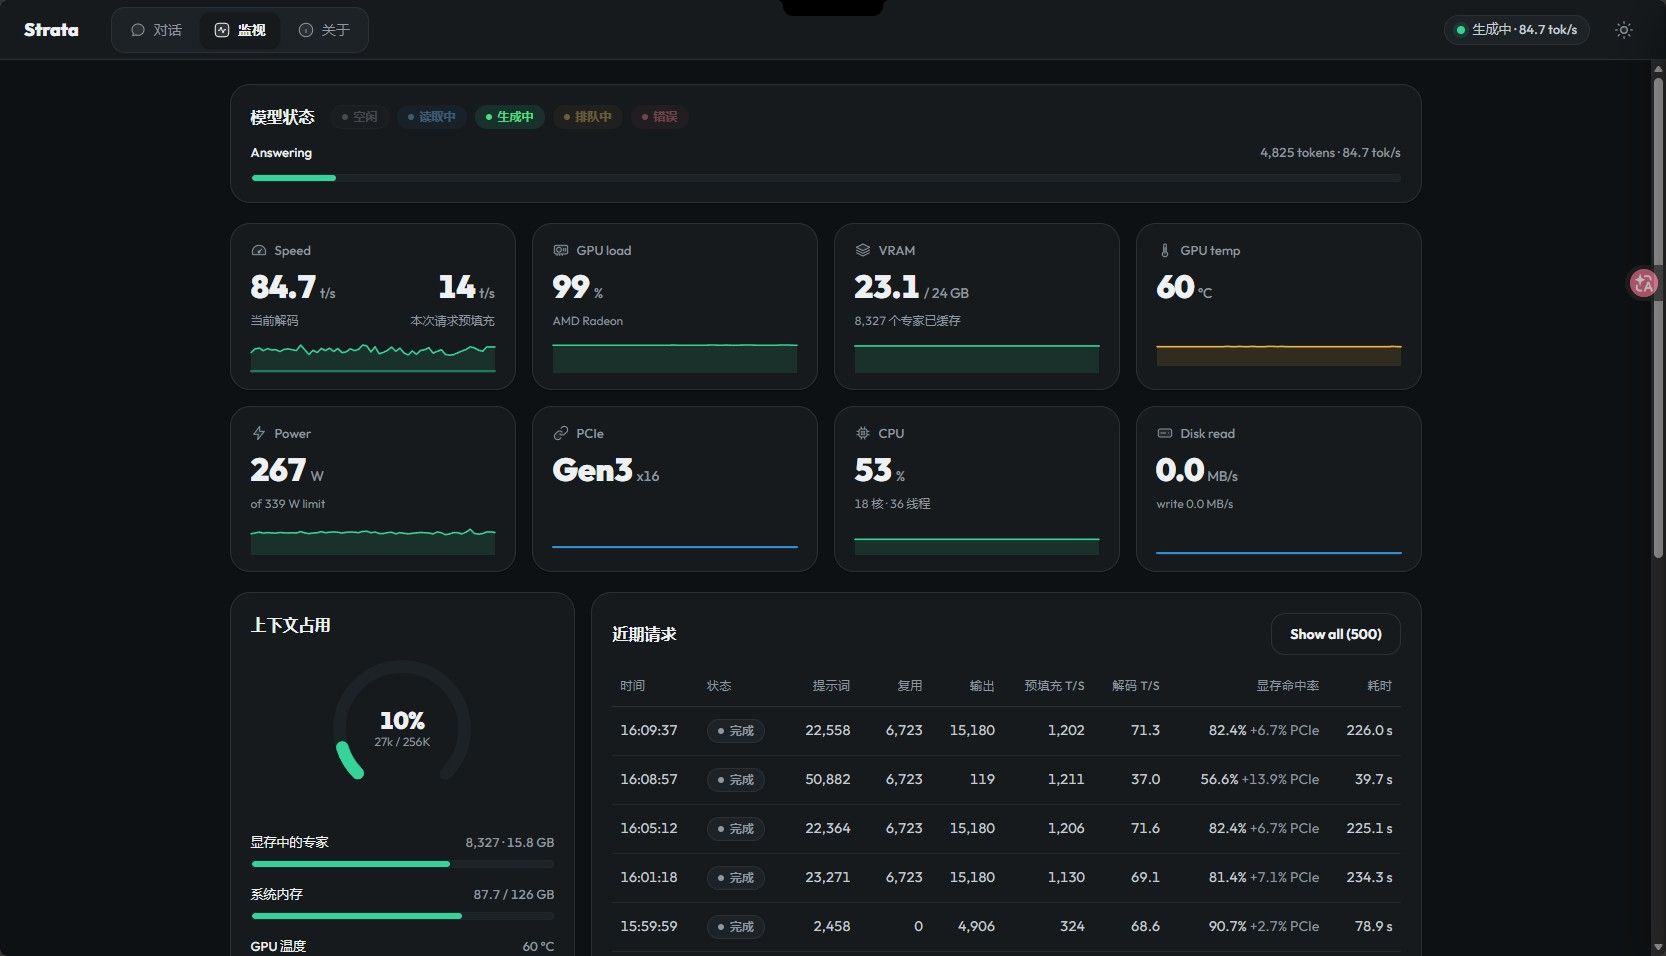
之前配了一台服务器专门跑strata。用了几天效果和大家分享一下。 我测试了很多方法,现在的使用是1槽其他对话排队的方式。256K上下文,非审查模型,带图片识别和加速模块。
稳定跑了好几天了,可以说一直在跑,我都是长任务,一跑跑一宿的,能用,但是很慢(对比DeepSeek)
如果两个对话同时开,速度会慢,不知道为什么。 往上搜索了,2个对话同时运行的经验贴我都没试出来更好的效果。所以我贴一下我的经验,大家看看有没有提升到空间了。
@yi-song 说: 如果两个对话同时开,速度会慢,不知道为什么。 往上搜索了,2个对话同时运行的经验贴我都没试出来更好的效果。所以我贴一下我的经验,大家看看有没有提升到空间了。
@yi-song 说:
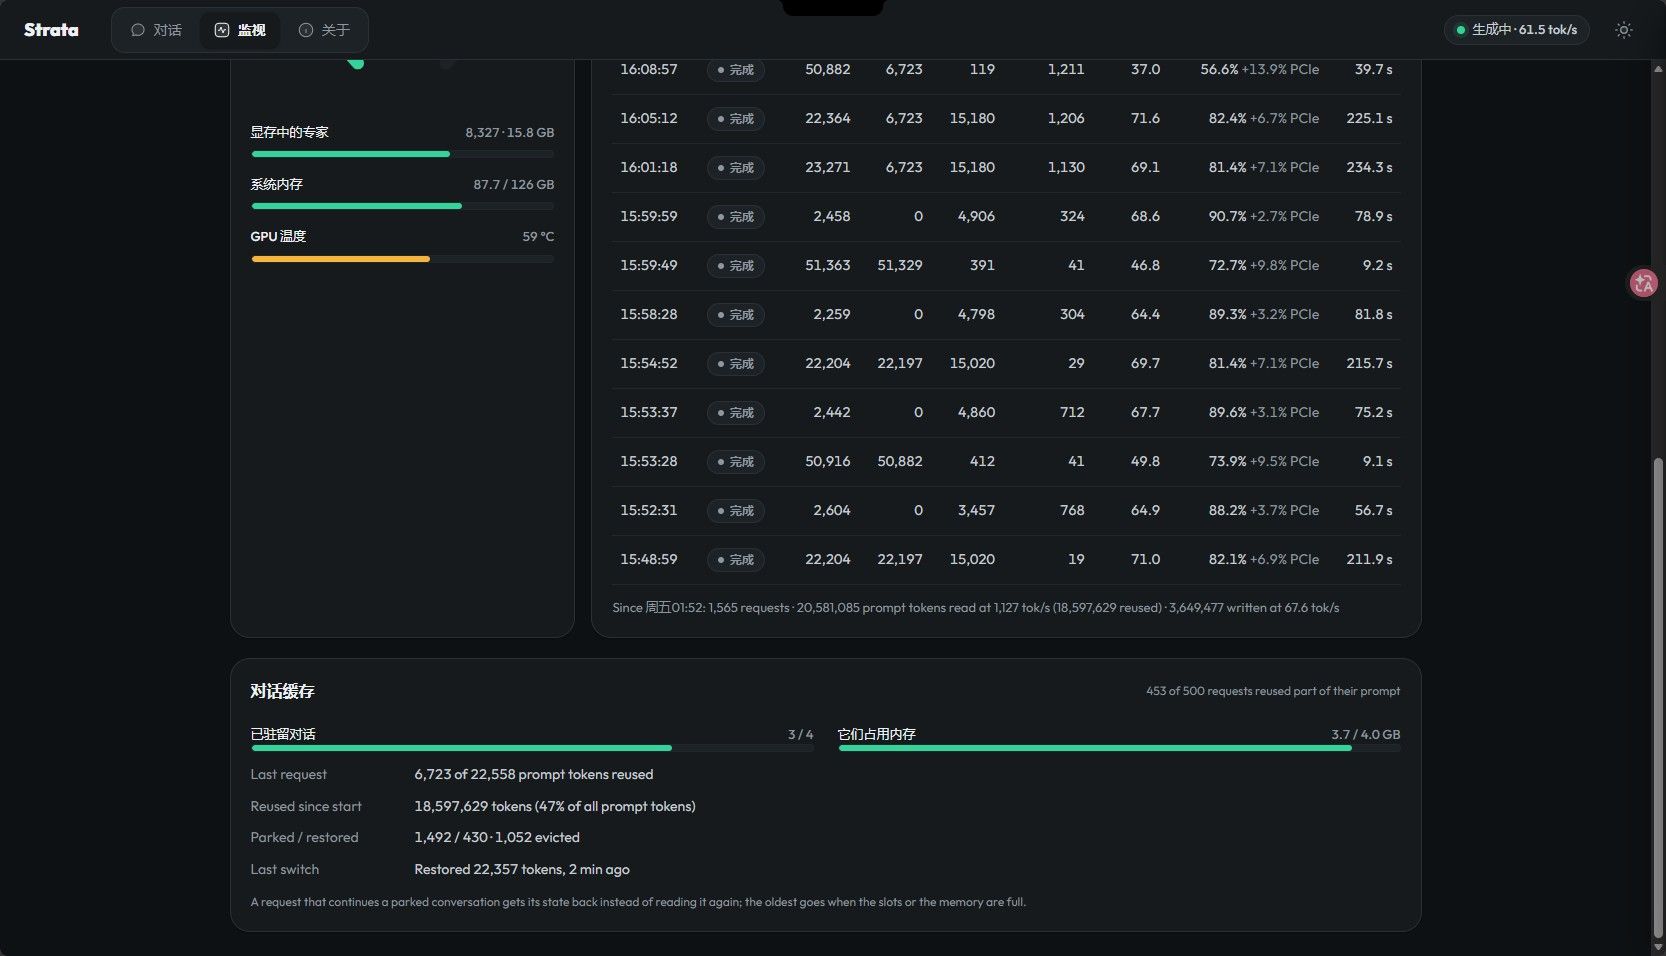
你要开2个以上对话必须设定并发数,不然只能排队。 "parallel": X (X 是并发会话数,最大 8 ) "--conversation-cache-mib", "8192" 这个参数会让 strata 使用 RAM 来缓存历史对话,从而不让 LLM 反复重新 prefill 老的 session 。增加会话切换时的速度,对于 agent 、harness 场景有奇效。
你好!看起来您对这段对话很感兴趣,但您还没有一个账号。
厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。
有了你的建议,这篇帖子会更精彩哦 💗